
Retrieval avanzado: contexto largo, contextual retrieval y late chunking
Long context frente a RAG, contextual retrieval y late chunking: arreglar lo que significa cada chunk.
Todo lo visto hasta aquí iba de hacer funcionar un pipeline convencional: dividir bien, generar embeddings de forma coherente, recuperar en amplitud, hacer reranking, observar, cachear, desplegar. En esta parte el curso se vuelve hacia la frontera de 2026, y arranca atacando la premisa de toda la guía.
Tres técnicas, tres cajas distintas del modelo mental:
- El contexto largo (long context) se pregunta si la Phase A (index) tiene siquiera que existir. Si el modelo puede
leer un millón de tokens, ¿para qué dividir, generar embeddings y almacenar nada? La respuesta es aritmética, no ideología.
- El contextual retrieval modifica el paso
[Contextualize]de la Phase A, la única caja del
diagrama que hasta ahora estaba vacía. Cambia el texto del que generas el embedding.
- El late chunking modifica el orden
Split → Embedde la Phase A. Cambia **cuándo se
calcula el embedding**.
Las tres se rigen por el invariante 3: el coste en tiempo de indexación es único y se amortiza; el coste en tiempo de query se repite en cada request. El contextual retrieval y el late chunking son apuestas puras sobre ese invariante: gastan mucho en el camino de escritura y nada en el de lectura. El contexto largo es la apuesta contraria: te saltas por completo el camino de escritura y pagas para siempre en el de lectura. Ese es todo el argumento de esta parte en tres frases.
El código está en el segundo repo, fcc-production-rag-part-6 (las lecciones 6.1–6.3 de «Advanced RAG 2026»): 01_long_context_vs_rag.py, 02_contextual_retrieval.py, 03_late_chunking.py. Los capítulos 24, 25 y 26 de la fuente los cubren de 06:06:09 → 06:42:04. Tres filas de la tabla de seis filas de la Part 6 del README del repo pertenecen a esta parte:
| Técnica | Qué resuelve | Mejora declarada |
|---|---|---|
| Contexto largo frente a RAG | Cuándo usar ventanas de 1M de tokens y cuándo retrieval | Optimización de costes |
| Contextual Retrieval | Chunks que pierden el contexto del documento | 67% menos fallos de retrieval |
| Late Chunking | Contexto entre chunks que se pierde en los embeddings | 10–12% más de precisión |
No te aferres a esos dos porcentajes. Al final de esta parte sabrás de dónde sale cada uno, qué configuración mide en realidad y por qué el propio instructor del curso te dice dos veces que los ignores y midas los tuyos.
1. ¿Ha muerto RAG? La cuestión del contexto largo
1.1 La pregunta y el cambio de enfoque
06:06:15 El capítulo empieza a mitad de frase con la pregunta que el instructor recibe con más frecuencia: con modelos como Gemini que ya ofrecen ventanas de un millón de tokens, ¿seguimos necesitando RAG? Su respuesta es negarse a responder la pregunta tal como se plantea, y lo repite tres veces en ocho minutos:
«No descartes una en favor de la otra. Simplemente averigua cuándo usar cada una». 06:11:20
El propio script imprime el cambio de enfoque como un banner antes de hacer nada más:
# fcc-production-rag-part-6/01_long_context_vs_rag.py — __main__ banner
print("\nThe question isn't 'Is RAG dead?'")
print("It's 'When should I use RAG vs Long Context?'")
Define los términos con precisión, porque si no la comparación no significa nada. Contexto largo, tal como se usa aquí, significa meter el corpus entero en la ventana del prompt en cada query, sin ningún paso de retrieval: sin splitter, sin embeddings, sin vector store. RAG significa recuperar de cuatro a ocho chunks (~2K tokens) y enviar solo esos. Es una comparación entre dos arquitecturas, no entre dos modelos.
1.2 La tabla comparativa tal como se dice en el vídeo
| Dimensión | RAG | Contexto largo |
|---|---|---|
| Coste por query | no se dice ninguna cifra: «muy insignificante por query» | ~$0.10 |
| Latencia | ~1 segundo | ~45 segundos |
| Escalado | «ilimitado, de verdad» | límite de ~1M de tokens |
| Titular | «RAG es más de 1,200 veces más barato» 06:06:15 | — |
No hay captura de pantalla del capítulo 24 (INDEX.md lo incluye explícitamente en «capítulos sin captura»), así que todas las cifras de arriba salen de la transcripción automática, y la celda de coste de RAG nunca se lee en voz alta. Ese número, sencillamente, se pierde. El par 1 s frente a 45 s y la proporción de 1,200× proceden de la transcripción y no tienen fuente; tómalos como orientativos.
«Es la diferencia entre tener un producto viable y la bancarrota». 06:07:16
1.3 La aritmética de costes, y por qué imprime 25× y no 1,200×
calculate_costs() es aritmética pura. No hace ninguna llamada a la API. Eso importa: puedes ejecutarla, cambiar sus constantes y razonar sobre tus propias cifras sin gastar un céntimo.
# fcc-production-rag-part-6/01_long_context_vs_rag.py — calculate_costs(), abridged:
# the print() calls that only echo these values are omitted.
# Docstring pricing: GPT-4o (April 2026) — input $2.50 / 1M, output $10.00 / 1M.

# Scenario: Query against 100K tokens of documentation
doc_tokens = 100_000
query_tokens = 100
output_tokens = 500

# Long Context approach - stuff everything
long_context_input = doc_tokens + query_tokens
long_context_cost = (long_context_input * 2.50 / 1_000_000) + (
    output_tokens * 10.00 / 1_000_000
)

# RAG approach - retrieve 4 chunks of ~500 tokens each
rag_chunks = 4
tokens_per_chunk = 500
rag_input = (rag_chunks * tokens_per_chunk) + query_tokens
rag_cost = (rag_input * 2.50 / 1_000_000) + (output_tokens * 10.00 / 1_000_000)

print(f"RAG is {long_context_cost / rag_cost:.0f}x cheaper per query!")

queries_per_day = 10_000
print(
    f"  Monthly savings with RAG: ${(long_context_cost - rag_cost) * queries_per_day * 30:.2f}"
)
Hazla a mano, porque la aritmética es la lección:
| Magnitud | Contexto largo | RAG (4 × 500) |
|---|---|---|
| Tokens de entrada | 100,100 | 2,100 |
| Coste de entrada @ $2.50/1M | $0.25025 | $0.00525 |
| Coste de salida (500 tok @ $10/1M) | $0.00500 | $0.00500 |
| Coste por query | $0.25525 | $0.01025 |
| Con 10,000 queries/día | $2,552.50/día | $102.50/día |
| Diferencia mensual (×30) | — | $73,500.00 ahorrados |
06:11:20 Lee en pantalla la línea impresa: «RAG is 25x cheaper per query» (0.25525 / 0.01025 = 24.9, formateado con :.0f). Pero la diapositiva que enseñó cinco minutos antes decía más de 1,200×. Las dos cifras se dan en los mismos ocho minutos y nunca se concilian.
Dos trampas más de esta función con las que te toparás al minuto de ejecutarla:
1.4 La demo de latencia, y por qué no deberías citarla
compare_latency() es la única función del archivo que hace llamadas reales a la API. Cronometra dos llamadas a llm.invoke(), una con un contexto de una frase y otra con la misma frase repetida 50 veces.
# fcc-production-rag-part-6/01_long_context_vs_rag.py — compare_latency()
small_context = (
    "The company's return policy allows returns within 30 days with receipt."
)
large_context = (small_context + "\n\n") * 50  # ~2500 tokens

query = "What is the return policy?"

start = time.time()
response_small = llm.invoke(f"Context: {small_context}\n\nQuestion: {query}")
small_time = time.time() - start

start = time.time()
response_large = llm.invoke(f"Context: {large_context}\n\nQuestion: {query}")
large_time = time.time() - start

print(f"\nSmall context (~50 tokens): {small_time:.2f}s")
print(f"Large context (~2500 tokens): {large_time:.2f}s")
print(
    f"Difference: {large_time - small_time:.2f}s ({large_time/small_time:.1f}x slower)"
)
print("\nNote: At 100K+ tokens, latency difference is much more dramatic!")
La ejecución en directo 06:12:23 dio 1.45 s en pequeño y 1.16 s en grande: una diferencia de −0.29 s y un «0.8x slower» impreso. Las propias cifras de la demo dicen que el contexto largo fue más rápido.
1.5 El techo de fiabilidad: una ventana de 1M no son 1M de tokens utilizables
06:07:16 La afirmación no monetaria más importante del capítulo:
«estos modelos se vuelven poco fiables en torno al 60 a 70% de ese límite». 06:07:16
La capacidad efectiva y fiable es aproximadamente el 60–70% de la ventana anunciada: unos 600K–700K tokens en un modelo de 1M de tokens. Más allá, el retrieval dentro del contexto se degrada: la familia de fallos «lost in the middle» / context rot, en la que el modelo deja de forma demostrable de prestar atención al material que se le dio. Su planteamiento: «esto no va solo de dinero o de economía»; aunque tuvieras presupuesto infinito, la precisión por sí sola ya es un argumento contra meterlo todo a lo bruto.
Lo afirma como «un hecho conocido» y no cita ningún paper ni ningún benchmark. Es coherente con la literatura publicada sobre contexto largo, pero tal como se presenta en este curso es una afirmación sin fuente. Trata el 60–70% como una heurística de planificación, no como una especificación: una ventana de un millón de tokens te da 600–700K tokens de atención fiable, así que presupuesta contra el límite efectivo, no contra el de marketing.
Las listas habladas: dónde gana de verdad cada enfoque
Antes del framework impreso, narra dos listas informales. En algunos puntos difieren del recuadro que imprime el script, y merece la pena tener las dos.
Dónde gana de verdad el contexto largo 06:07:16: «seamos justos, hay casos en los que los modelos de contexto largo son realmente buenos»:
- Documentos pequeños: documentos más pequeños en general.
- Menos de 100K tokens: *«si tienes menos de 100k tokens, esa será una buena forma de
abordarlo»*. (El recuadro impreso dice <50K. Las dos cifras están en la lección).
- Tareas estáticas y acotadas: una tarea cuya entrada no crece y cuyo alcance es fijo.
- Necesitas todo el contexto a la vez: razonamiento sobre el documento entero, donde cualquier frontera
de chunk destruiría la respuesta: resume este contrato, encuentra contradicciones en todo el documento.
Dónde gana RAG 06:08:17:
- Base de conocimiento grande: *«muchos documentos, mucha información que estás metiendo
en una base de datos vectorial»*.
- Contenido dinámico y actualizado con frecuencia: «RAG es muy bueno en eso». (Contradice el
recuadro impreso; mira el callout de abajo).
- Rentabilidad: «si tu sistema es sensible al coste, RAG es el camino».
- Precisión: *«si quieres un sistema muy preciso y muy específico, entonces
RAG gana la carrera sin duda», con el condicional crucial «si todo se monta correctamente»*.
1.6 El framework de decisión
print_decision_framework() imprime un recuadro ASCII (es una sentencia print del script, no una diapositiva) y es el artefacto reutilizable de todo el capítulo. Reproducido fielmente, con las variantes habladas anotadas:
| Usa contexto largo cuando | Usa RAG cuando |
|---|---|
| El corpus es pequeño (<50K tokens); en voz alta dice <100K en 06:07:16 | El corpus es grande (>100K tokens) |
| El volumen de queries es bajo (<100 queries/día) | El volumen de queries es alto (miles/día); en voz alta dice «cientos» 06:13:23 |
| Necesitas analizar el documento ENTERO | Los usuarios preguntan por temas concretos, no por un análisis del documento entero |
| Los documentos cambian a menudo (sin overhead de embeddings) | Los documentos son relativamente estables |
| Simplicidad > optimización de costes | El coste y la latencia importan |
| — | Necesitas citas / trazabilidad de fuentes |
Overhead de embeddings, definido: el coste, la latencia y la carga operativa de generar embeddings e indexar cada versión de cada documento en el vector store, y de repetirlo cada vez que un documento cambia. Es justo lo que el contexto largo te permite saltarte por completo.
Dos asimetrías más que conviene decir claramente, porque el recuadro impreso solo las insinúa:
- Las citas salen gratis por estructura en RAG y son difíciles por estructura en contexto largo. En RAG
sabes qué chunk produjo la respuesta porque lo pusiste tú. Mete 100K tokens en un solo bloque y la atribución se convierte en una segunda tarea del LLM, poco fiable.
- La precisión de RAG es condicional. *«RAG aporta mucha precisión **si todo se monta
correctamente**»* 06:08:17. Esa cláusula condicional son las Partes 3 a 9 de esta guía. RAG no gana en precisión por defecto; gana en precisión cuando su pipeline está bien construido.
1.7 El enfoque híbrido: RAG selecciona, el contexto largo lee
La síntesis, en la frontera entre capítulos 06:14:29:
«No separes las dos cosas, RAG frente a contexto largo. Di RAG Y contexto largo».
Y la frase con la que cierra: «En resumen, RAG no ha muerto». El mecanismo tiene dos pasos y es la forma hacia la que deberían converger la mayoría de los sistemas reales:
- RAG recupera documentos candidatos: no chunks con los que responder, sino documentos que leer.
- Carga esos documentos completos en la context window para la respuesta detallada.
La forma de query que necesita ambas cosas: «háblame de X, Y y Z, y luego analiza a fondo esta parte del corpus». RAG reduce el corpus de diez mil documentos a uno; después, el contexto largo hace la lectura minuciosa de lo que ha sobrevivido.
demo_hybrid_approach() es la cuarta llamada de __main__, así que sí se ejecuta, pero la narración se detiene tras el framework de decisión y nunca la comenta, de modo que este es el único sitio donde el lector la verá explicada. El detalle clave es k=1:
# fcc-production-rag-part-6/01_long_context_vs_rag.py — demo_hybrid_approach()
# Step 1: Create vector store for RAG retrieval
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vectorstore = Chroma.from_documents(
    documents=documents, embedding=embeddings, collection_name="hybrid_demo"
)

query = "What's the policy on working from home and what equipment do I get?"

# Step 3: RAG retrieves relevant document
retriever = vectorstore.as_retriever(search_kwargs={"k": 1})
relevant_docs = retriever.invoke(query)
print(f"Retrieved: {relevant_docs[0].metadata['source']}")

# Step 4: Load FULL document into context (hybrid part)
full_doc = relevant_docs[0].page_content

prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            """You are a helpful HR assistant. Use the full policy document
        below to give a comprehensive answer. Include all relevant details from
        the document.

        Policy Document:
        {document}""",
        ),
        ("human", "{query}"),
    ]
)

chain = prompt | llm
response = chain.invoke({"document": full_doc, "query": query})

# Cleanup
vectorstore.delete_collection()
k=1 hace algo inusual y deliberado: aquí el retrieval elige el documento, no la respuesta. Los tres documentos de la demo están escritos como políticas completas con Secciones 1–4 (remote_work_policy.pdf, expense_policy.pdf, pto_policy.pdf), todos etiquetados con doc_type: "policy", así que «cargar el documento completo» es un acto con sentido. La query (*teletrabajo y qué equipo me dan*) abarca a propósito la Sección 2 y la Sección 3 de un mismo documento, que es exactamente la pregunta que un retrieval top-k de chunks responde mal y una lectura del documento entero responde a la perfección.
El corpus sintético de RR. HH., por si quieres reproducir la ejecución
Son valores de fixture, no parámetros de RAG, pero reprodúcelos exactamente si quieres el mismo comportamiento del retrieval.
- Remote Work Policy: elegibilidad tras un periodo de prueba de 90 días (tiempo parcial, caso por
caso); teletrabajo hasta 3 días/semana; horario núcleo de 10am–3pm hora local; se proporcionan portátil + monitor, el empleado paga internet, $500 anuales de ayuda para la oficina en casa; localizable en Slack durante el horario núcleo, cámara encendida en las reuniones de equipo, expectativa de respuesta en 30 minutos.
- Expense Reimbursement Policy: los gastos de más de $500 necesitan aprobación previa del manager,
los viajes de más de $2,000 necesitan aprobación de un VP; recibos obligatorios a partir de $25 (se aceptan digitales, los extractos de tarjeta por sí solos no); presentar en 30 días, fuera de plazo requiere aprobación de un director; reembolso en 10 días laborables por transferencia.
- PTO and Leave Policy: 15 días de PTO/año, +1 día por año de antigüedad hasta
25; 10 días de baja por enfermedad, no acumulables, justificante médico a partir de 3 días; 10 festivos pagados; excedencia no retribuida de hasta 12 semanas por motivos familiares/médicos, se aplican las reglas de la FMLA.
Fíjate en vectorstore.delete_collection() al final. Cada demo de esta parte destruye su colección de Chroma, y es un hábito que conviene copiar: estos scripts tienen los collection_names fijados en el código, y un fallo a mitad de ejecución deja una colección poblada a la que la siguiente ejecución añade datos, corrompiendo la comparación en silencio.
Los beneficios impresos: 1. RAG encuentra rápido el documento CORRECTO. 2. El contexto del documento completo garantiza que no se pierde nada. 3. Sigue siendo más barato que meter TODOS los documentos. 4. Ideal para: «Encuentra el documento relevante y luego analízalo a fondo».
1.8 La lección de fondo: piensa a escala, no a tamaño de prototipo
06:12:23 es el párrafo del que dice que es «exactamente lo que quiero enseñarte»: cuando empiezas a construir RAG, los volúmenes de datos son minúsculos y todas las cifras parecen ridículamente pequeñas, así que nunca te das cuenta de la arquitectura con la que te estás comprometiendo.
«Así que piensa siempre en escala, no en números pequeños». 06:12:23
Se aplica dos veces en este capítulo y merece la pena interiorizar las dos:
- Coste. $0.255 frente a $0.010 por query parece nada. Multiplícalo por 10,000 queries/día
y 30 días y son $73,500/mes de gasto evitable.
- Latencia. Una demo de 2,500 tokens no muestra ninguna diferencia (incluso una negativa). Con 100K+
tokens se convierte en el 1 s frente a 45 s de la tabla inicial.
Conclusiones clave, tal como las imprime el script:
- RAG NO ha muerto: es una cuestión de coste y latencia a escala.
- El contexto largo gana con documentos pequeños, poco volumen y análisis del documento entero.
- RAG gana con corpus grandes, mucho volumen y queries concretas.
- Enfoque híbrido: RAG para encontrar documentos, contexto largo para analizarlos.
- El futuro es usar AMBOS de forma estratégica.
2. Contextual retrieval: arregla el chunk antes de generar su embedding
2.1 La enfermedad
La Parte 3 estableció que el chunking es arquitectura. Esto es la secuela: incluso un chunk dividido correctamente puede ser irrecuperable, porque dividir separa al chunk del documento que le daba sentido.
«cuando haces chunking, cada uno de estos chunks pierde su contexto». 06:15:33
Su ejemplo canónico: un chunk que dice «la política de la empresa establece…»: ¿qué empresa? ¿qué política? El docstring del archivo lo plantea como «La empresa se fundó en 1994»: ¿qué empresa? ¿De qué documento sale esto? El chunk es cierto en los hechos y completamente imposible de atribuir.
El fallo es mecánico, no misterioso. 06:20:42 Un usuario pregunta «¿Cuáles son los ingresos de ACME?» El chunk que contiene la respuesta dice:
«Los ingresos del ejercicio fiscal 2025 alcanzaron los $4.2 mil millones, lo que supone un aumento del 15% respecto al año anterior».
El token ACME no aparece nunca. Ni el matching léxico ni el semántico tienen nada a lo que agarrarse. Los pronombres y las descripciones definidas («la empresa», «ellos», «lo») son la forma general de este bug, y están por todas partes en los corpus reales: informes anuales, manuales de políticas, documentación técnica, cualquier cosa con un título que el cuerpo del texto nunca repite.
demonstrate_context_loss() imprime la enfermedad sin ninguna llamada a la API: un ACME Corporation Annual Report 2025 con tres secciones (Company Overview / Financial Highlights / Future Outlook), reducido a tres chunks huérfanos a propósito:
- «La empresa está especializada en fabricar equipos industriales para el sector minero».
→ ¿qué empresa?
- *«Los ingresos del ejercicio fiscal 2025 alcanzaron los $4.2 mil millones, lo que supone un aumento del 15% respecto al
año anterior».* → ¿de qué empresa?
- «La empresa planea expandirse a equipos de energías renovables en 2026». → ¿los planes de qué
empresa?
Los dos documentos de la demo, completos: reprodúcelos para obtener las mismas cifras
Documento 1: el ACME Corporation Annual Report 2025 (lo usan demonstrate_context_loss(), demonstrate_contextual_retrieval() y compare_retrieval()):
ACME Corporation Annual Report 2025

Company Overview:
ACME Corporation was founded in 1994 in San Francisco. The company
specializes in manufacturing industrial equipment for the mining sector.

Financial Highlights:
Revenue for fiscal year 2025 reached $4.2 billion, representing a 15%
increase from the previous year. The company's profit margin improved
to 18%, up from 14% in 2024.

Future Outlook:
The company plans to expand into renewable energy equipment in 2026.
A new manufacturing facility will open in Austin, Texas. The company
expects revenue growth of 20% in the coming fiscal year.
(El «revenue for fiscal year 2005» de la transcripción es un error de audición de 2025).
Documento 2: la nota de prensa de la Series B de TechStartup Inc. (la usa demo_production_pipeline(), metadata={"title": "TechStartup Inc. Series B Announcement", "source": "press_release.pdf"}): una empresa de infraestructura de IA con sede en Seattle cierra una Series B de $45 millones liderada por Sequoia Capital con participación de Andreessen Horowitz; la CEO Jane Smith prevé duplicar la plantilla antes de que acabe 2026; el producto estrella, AIFlow, ayuda a las empresas a desplegar y gestionar LLMs en producción y da servicio a más de 200 clientes enterprise.
Fíjate en cómo están escritos los dos documentos: el nombre de la entidad aparece una vez, en el primer párrafo, y todas las frases siguientes dicen «la empresa». No es un artificio: así es como se escriben de verdad los informes anuales, las notas de prensa y los manuales de políticas.
2.2 El mecanismo, y las dos palabras que importan
El contextual retrieval lo publicó Anthropic a finales de 2024 06:17:36. La técnica cabe en una frase:
«usa un LLM para anteponer contexto a cada uno de estos chunks antes de generar el embedding. La clave aquí es antes de generar el embedding». 06:16:35
Ese es todo el detalle clave de la lección. El contexto añadido:
- lo genera un LLM, no sale de una plantilla de metadatos: el modelo lee el documento entero
y escribe una frase que sitúa el chunk;
- se concatena al texto del chunk antes de la llamada de embedding, de modo que el propio vector
codifica los hechos a nivel de documento.
Lo que lleva el prefijo: información a nivel de documento (título, nombre del informe, año, organización) e información a nivel de sección (en qué parte del documento está este chunk), además de resolver las entidades a las que apuntan los pronombres del chunk. La unidad recuperable ya responde por sí sola a «¿qué empresa?».
2.3 La función principal, completa
Esta es la técnica entera. Es un prompt template y una chain LCEL de dos nodos: aquí no hay ningún subsistema a medida.
# fcc-production-rag-part-6/02_contextual_retrieval.py — add_contextual_prefix()
def add_contextual_prefix(
    chunk: str, full_document: str, document_title: str, llm: ChatOpenAI
) -> str:
    """
    Use LLM to generate a contextual prefix for a chunk.

    This is the core of Contextual Retrieval:
    - Give the LLM the full document and the specific chunk
    - Ask it to write a brief context that situates the chunk
    - Prepend this context to the chunk before embedding
    """

    prompt = ChatPromptTemplate.from_messages(
        [
            (
                "system",
                """You are an expert at adding context to document chunks.

Given a document and a specific chunk from that document, write a SHORT
context (1-2 sentences) that helps situate the chunk within the document.

The context should include:
- The document title/source if relevant
- Key entities mentioned earlier in the document
- Any important context that helps understand this chunk

Keep it brief - just enough to disambiguate the chunk.
Output ONLY the contextual prefix, nothing else.""",
            ),
            (
                "human",
                """Document Title: {title}

Full Document:
{document}

Chunk to contextualize:
{chunk}

Write a brief contextual prefix for this chunk:""",
            ),
        ]
    )

    chain = prompt | llm
    response = chain.invoke(
        {"title": document_title, "document": full_document, "chunk": chunk}
    )

    return response.content
Tres cosas de ese prompt son clave y merece la pena copiarlas literalmente:
- «1-2 sentences» y «Keep it brief»: el prefijo infla cada chunk, así que su
longitud es un coste que pagas para siempre (mira el §2.7).
- «Key entities mentioned earlier in the document»: esta es la instrucción que
resuelve la correferencia. Es la razón por la que «the company» se convierte en «ACME Corporation».
- «Output ONLY the contextual prefix, nothing else.»: sin ella, un modelo charlatán
devuelve «Sure! Here's a context for that chunk:» y ese preámbulo se queda embebido como ruido, para siempre, en tu índice.
Las dos instancias de ChatOpenAI del archivo usan model="gpt-4o-mini", temperature=0. Aquí el determinismo importa: generar el contexto es una tarea de extracción, no creativa, y temperature=0 significa que reindexar el mismo corpus produce prefijos casi idénticos en lugar de un conjunto de vectores nuevo cada vez.
Y la única línea que es la técnica; aparece dos veces en el archivo, una en la demo (línea 201, como contextualized) y otra en la función de producción (línea 330, como contextualized_content):
# fcc-production-rag-part-6/02_contextual_retrieval.py:201
contextualized = f"{context_prefix} {chunk}"
La frase original nunca se reescribe ni se destruye. El prefijo es puramente aditivo, y eso es lo que hace que todo sea auditable.
Ejecutarlo sobre los chunks de ACME produce prefijos como estos 06:20:42:
- Chunk 1 → *«En la sección Company Overview del ACME Corporation Annual Report 2025,
el documento presenta a ACME…»* + texto original
- Chunk 2 → «…sección Financial Highlights del ACME Corporation…» + texto original
- Chunk 3 → «En la sección Future Outlook del ACME Corporation Annual Report…» + original
texto
2.4 La función de producción
create_contextual_chunks() sustituye directamente a tu paso de splitter. Es lo que de verdad pones en producción.
# fcc-production-rag-part-6/02_contextual_retrieval.py — create_contextual_chunks()
def create_contextual_chunks(
    documents: list[Document],
    llm: ChatOpenAI,
    chunk_size: int = 500,
    chunk_overlap: int = 100,
) -> list[Document]:
    """
    Production-ready function to create contextualized chunks.

    This is the function you'd use in a real RAG pipeline.
    Note: This adds latency and cost during indexing, but it's a one-time cost.
    """

    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=chunk_size,
        chunk_overlap=chunk_overlap,
        separators=["\n\n", "\n", ". ", " ", ""],
    )

    contextualized_docs = []

    for doc in documents:
        full_content = doc.page_content
        doc_title = doc.metadata.get(
            "title", doc.metadata.get("source", "Unknown Document")
        )

        chunks = text_splitter.split_text(full_content)

        for i, chunk in enumerate(chunks):
            context_prefix = add_contextual_prefix(
                chunk=chunk,
                full_document=full_content,
                document_title=doc_title,
                llm=llm,
            )

            contextualized_content = f"{context_prefix} {chunk}"

            contextualized_docs.append(
                Document(
                    page_content=contextualized_content,
                    metadata={
                        **doc.metadata,
                        "chunk_index": i,
                        "original_chunk": chunk,
                        "context_prefix": context_prefix,
                    },
                )
            )

    return contextualized_docs
Lee con atención el dict metadata: es la buena idea menos explicada del capítulo:
| Clave | Por qué existe |
|---|---|
**doc.metadata | el source, la page y el title del padre se conservan en cada chunk (invariante de la Parte 2: semántica de split_documents, hecha aquí a mano) |
chunk_index | posición dentro del padre, para ordenar y expandir a los vecinos |
original_chunk | el texto sin prefijo, para que puedas generar el embedding de la versión contextualizada pero mostrar y citar la original |
context_prefix | la cadena exacta que se inventó el LLM, para que puedas auditarla, compararla entre reindexaciones y detectar un modelo que haya empezado a alucinar la procedencia |
Fíjate en la cadena de fallback del título: metadata["title"] → metadata["source"] → "Unknown Document". Si tu loader no rellena ninguna de las dos claves, todos los prefijos de tu índice se generarán contra la cadena «Unknown Document»: una regresión de calidad silenciosa sin ningún error asociado.
Los valores por defecto son chunk_size=500, chunk_overlap=100 (un overlap limpio del 20%, en línea con la regla del 10–20% de la Parte 3). La demo de producción la llama con chunk_size=200, chunk_overlap=50 sobre una única nota de prensa de la Series B de TechStartup Inc. y produce 7 chunks 06:23:45. Fíjate en la jerarquía del splitter ["\n\n", "\n", ". ", " ", ""] (párrafos, líneas, frases, palabras, caracteres): el valor por defecto recursivo de la Parte 3.
La parte de retrieval no cambia en absoluto:
# fcc-production-rag-part-6/02_contextual_retrieval.py — demo_production_pipeline()
contextualized_docs = create_contextual_chunks(
    documents=documents, llm=llm, chunk_size=200, chunk_overlap=50
)
print(f"Created {len(contextualized_docs)} contextualized chunks")

vectorstore = Chroma.from_documents(
    documents=contextualized_docs,
    embedding=embeddings,
    collection_name="contextual_demo",
)

query = "How much funding did the Seattle AI company raise?"
results = vectorstore.similarity_search(query, k=2)
Esa query está bien elegida: «the Seattle AI company» no nombra ni a la empresa ni la ronda. Solo un chunk contextualizado puede salvar ese hueco.
El contextual retrieval es un cambio en tu job de indexación, no en tu camino de query. Todos los retrievers, rerankers, chains y prompts posteriores quedan intactos.
2.5 El A/B medido, y cómo leer los scores
compare_retrieval() construye dos colecciones de Chroma a partir de los mismos tres chunks de ACME (una en bruto y otra contextualizada) y lanza las mismas tres queries contra ambas con k=1.
# fcc-production-rag-part-6/02_contextual_retrieval.py — compare_retrieval()
orig_results = vs_original.similarity_search_with_score(query, k=1)
orig_doc, orig_score = orig_results[0]

ctx_results = vs_contextual.similarity_search_with_score(query, k=1)
ctx_doc, ctx_score = ctx_results[0]

# Lower score = better match in Chroma
if ctx_score < orig_score:
    improvement = ((orig_score - ctx_score) / orig_score) * 100
    print(f"\n  -> Contextual retrieval {improvement:.1f}% better match!")
| Query | Score original | Score contextual | Mejora |
|---|---|---|---|
| «What is ACME's revenue?» | ≈1.14 (dicho en voz alta: «algo más de uno») | 0.5 | 56% |
| «What does ACME Corporation manufacture?» | 1.33 | ≈0.51 (deducido) | 61.4% |
| «What are ACME's expansion plans?» | ≈1.42 (deducido) | 0.7 | 50.6% |
Dos de las seis celdas de score nunca se leyeron en voz alta y se han despejado a partir de los porcentajes impresos: están marcadas como deducidas, no leídas en pantalla. Vuelve a ejecutar el script si necesitas los valores exactos.
El patrón que quiere que recuerdes no es un rescate espectacular: las tres queries mejoraron entre un 50 y un 61%, incluidas las dos cuyos chunks objetivo ya compartían vocabulario con la query («manufacture»/«manufacturing», «expansion plans»/«plans to expand»). Añadir los nombres del documento y de la sección ayuda incluso cuando el solapamiento léxico ya existía.
2.6 Las cifras del benchmark, y la corrección que el curso no hace
06:17:36 Dos cifras, atribuidas a la propia investigación de Anthropic:
- Contextual retrieval solo: 49% menos de fallos de retrieval en el top-20.
- Contextual retrieval + reranking: 67% menos.
Fallo de retrieval en el top-20, definido: el pasaje correcto no aparece en ninguno de los 20 primeros resultados recuperados. Los porcentajes son reducciones de la tasa de ese evento, no scores de precisión.
Matiza las cifras dos veces, a propósito, y el matiz es la lección más valiosa:
«Recuerda que estas cifras son benchmarks que se sacaron ellos. Podría ser más, podría ser menos». 06:19:40
«Son solo benchmarks. Así que tienes que probarlo por tu cuenta». 06:24:26
2.7 Consideraciones de producción: el camino de escritura lo paga todo
El script imprime cuatro, y son la contabilidad honesta de costes de la técnica:
| Consideración | Cifra | Dónde recae |
|---|---|---|
| Coste | $0.01–$0.05 por documento para generar el contexto | único, en la indexación |
| Latencia | 1–2 s por chunk durante la indexación | único, en la indexación: procesa en batch offline |
| Latencia de query | ningún impacto | el camino de lectura no se toca |
| Almacenamiento | los chunks son ~20–30% más grandes | «impacto mínimo en los costes de la base de datos vectorial» |
«Es un coste único en tiempo de indexación, que sale mucho más barato que los fallos de retrieval». 06:23:45
El argumento económico es el correcto: pagas una vez por documento, para siempre, frente a pagar una y otra vez en respuestas erróneas, escalados a soporte y confianza erosionada. Y la asimetría es total: todo el coste y toda la latencia recaen en el camino de escritura.
Sobre el crecimiento del 20–30% 06:24:26: el LLM añade texto literalmente, así que los chunks crecen. El almacenamiento crece; la dimensión del embedding, que es lo que domina el coste de la base de datos vectorial, no. Por eso dice que el impacto en almacenamiento es mínimo. Lo que no menciona es el coste del lado del prompt: un retrieval top-5 mete ahora ~25% más de texto en cada prompt de respuesta, en cada request, para siempre. Ese sí que recae, al final, en el camino de lectura.
2.8 Cuándo activarlo
Tres disparadores 06:24:26. Si se cumple cualquiera de ellos, probablemente el contextual retrieval compensa su llamada al LLM por chunk; si no se cumple ninguno, probablemente no.
- El contexto importante vive en cabeceras/títulos (nombres de informes, encabezados de sección, fechas)
que el cuerpo del chunk nunca repite.
- Se hace referencia a las entidades con pronombres o descripciones definidas: «la empresa»,
«ellos», «lo».
- Los documentos vienen de varias fuentes, así que un chunk por sí solo no puede identificar su propia
procedencia y los resultados de corpus distintos se mezclan.
Las seis conclusiones clave impresas (te dice que pares el vídeo y las leas):
- Los chunks pierden el contexto al separarlos de los documentos.
- El Contextual Retrieval añade contexto ANTES de generar el embedding.
- Usa un LLM para generar un prefijo de contexto de 1–2 frases.
- Coste único en la indexación, mejora permanente del retrieval.
- Anthropic reporta 67% menos fallos de retrieval.
- Combínalo con búsqueda híbrida BM25 para obtener los mejores resultados.
La conclusión 6 remite directamente a la Parte 6. En el diseño original de Anthropic, la técnica es «Contextual Embeddings + Contextual BM25»: indexas el texto contextualizado tanto de forma léxica como vectorial. Si construiste el retriever híbrido de la Parte 6, aliméntalo con el texto contextualizado en las dos ramas; eso es lo que mide realmente la cifra del 49%.
3. Late chunking: primero el embedding, después la división
3.1 El giro
«El late chunking es una técnica más reciente que le da la vuelta al chunking tradicional». 06:25:30
Esa es toda la idea, y merece la pena apreciar lo pequeña que es:
- Chunking temprano / tradicional: divides el texto → generas el embedding de cada chunk de forma independiente.
- Late chunking: generas el embedding del documento entero en un solo forward pass → después divides los
token embeddings resultantes por posición → haces pooling de cada tramo en un único vector de chunk.
No cambia nada más. El mismo vector store, el mismo retriever, el mismo k, el mismo reranker, los mismos prompts. El índice incluso parece idéntico: el mismo número de vectores, las mismas dimensiones. Solo cambian los números dentro de los vectores.
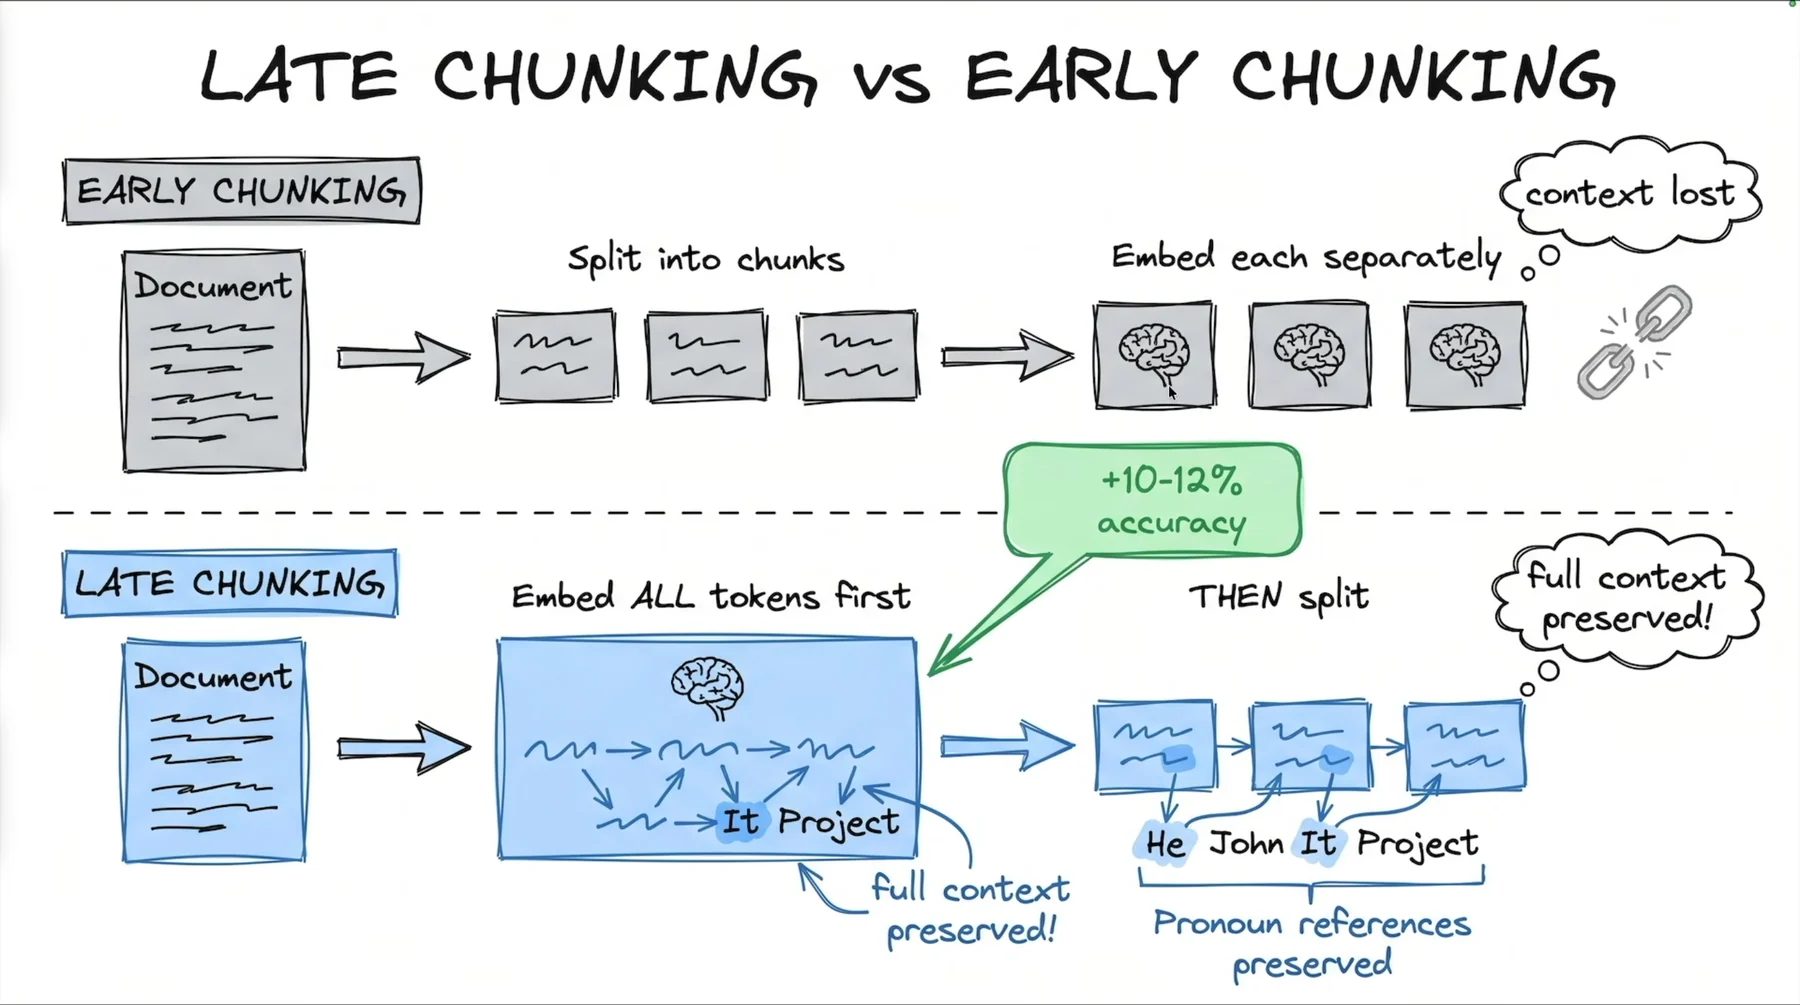
He / John / It / Project bajo los chunks divididos es la recompensa: la correferencia se resuelve antes de la división, así que sobrevive a ella.Por qué funciona se explica con una frase de mecánica de transformers. Cuando el modelo hace un forward pass sobre el documento entero, la atención permite que cada token vea a todos los demás. El token «He» del párrafo tres se calcula en presencia de «Steve Jobs» del párrafo uno, así que su vector ya lleva esa asociación. Divide esos vectores de token después y el vector agregado de cada chunk hereda un contexto de todo el documento que un embedding independiente del mismo texto nunca podría tener.
«cada uno de estos chunks o vectores, porque ahora son embeddings, conoce el documento entero». 06:33:38
Hacen falta dos términos, porque el curso los usa sin definirlos. Los token embeddings (embeddings a nivel de token) son los vectores por token que un transformer produce internamente, antes de que el modelo los agregue en el único vector que te devuelve una API de embeddings. El pooling es esa reducción: promediar (o combinar de otro modo) los vectores de token que caen dentro del tramo de un chunk en un único vector de chunk. En el diagrama ASCII del script, los late chunks se etiquetan como Vector 1 (pooled), Vector 2 (pooled), Vector 3 (pooled): la división produce embeddings, y cada grupo se agrega mediante pooling en un vector de chunk, que es lo que acaba en la base de datos.
La mejora declarada: +10–12% de precisión en tareas de retrieval. Esa cifra aparece en el recuadro verde de la diapositiva, en el docstring del módulo, en la tabla comparativa y en la conclusión n.º 4. En 06:27:31 dice «del 10 al 20%» una vez: un lapsus verbal que contradice todos los materiales escritos, probablemente mezclado con el +15–20% del contextual retrieval. Usa 10–12%.
3.2 El fallo que corrige, hecho contable
Lo mejor de este capítulo es una demo que demuestra el fallo con una comprobación de subcadena y sin ninguna llamada a la API. El documento de prueba es una biografía de Steve Jobs diseñada para que el párrafo 1 lo nombre y los párrafos 2–4 empiecen todos por «He».
# fcc-production-rag-part-6/03_late_chunking.py — demonstrate_early_chunking_problem()
# (the document literal keeps the source file's 4-space indentation — those spaces are
#  part of the text and they count toward chunk_size)
document = """
    Steve Jobs was born in San Francisco in 1955. He was adopted
    by Paul and Clara Jobs shortly after birth.

    He co-founded Apple Computer in 1976 with Steve Wozniak.
    The company started in his parents' garage. He served as CEO
    until 1985 when he was ousted from the company he created.

    He then founded NeXT Computer and acquired Pixar Animation Studios.
    These ventures would later prove instrumental in his return to Apple.

    He returned to Apple in 1997 and transformed it into one of the
    most valuable companies in the world. He introduced the iPod, iPhone,
    and iPad, revolutionizing multiple industries.
    """

# Simulate early chunking
splitter = RecursiveCharacterTextSplitter(
    chunk_size=200,
    chunk_overlap=0,  # No overlap to show the problem clearly
    separators=["\n\n", "\n", ". ", " "],
)

chunks = splitter.split_text(document)

for i, chunk in enumerate(chunks, 1):
    # Check if "Steve Jobs" appears in this chunk
    has_name = "Steve Jobs" in chunk
    pronoun_count = chunk.lower().count(" he ")

    print(f"\nChunk {i}:")
    print(f'  "{chunk.strip()[:80]}..."')
    print(
        f"  Contains 'Steve Jobs': {'Yes' if has_name else 'NO - Just pronouns!'}"
    )
    print(f"  Pronoun 'he' count: {pronoun_count}")
La ejecución produce cuatro chunks 06:30:34–06:31:35:
| Chunk | Texto inicial | Contiene «Steve Jobs» | Recuento de " he " |
|---|---|---|---|
| 1 | «Steve Jobs was born in San Francisco in 1955…» | Sí | 1 |
| 2 | «He co-founded Apple Computer in 1976 with Steve Wozniak…» | NO – ¡Solo pronombres! | 3 |
| 3 | «He then founded NeXT Computer and acquired Pixar…» | NO | 0 |
| 4 | «He returned to Apple in 1997…» | NO | 1 |
Tres de cada cuatro chunks no se pueden encontrar por el nombre. El argumento impreso:
Chunks 2, 3, 4 only contain "he" - no "Steve Jobs"!

When embedding these chunks separately:
- Query: "What companies did Steve Jobs found?"
- Chunk 2 mentions "co-founded Apple" but says "He co-founded"
- Embedding of "He co-founded" won't match "Steve Jobs founded"

The pronoun "he" loses its referent when chunked separately.
La información está en el corpus y aun así no se puede recuperar. Es el fallo silencioso del invariante 4 en su forma más pura: nada da error, nada queda en los logs, el usuario simplemente recibe una respuesta peor. La versión genérica que narra en 06:26:31 (solo hablada, sin ningún material detrás) es un comunicado corporativo cortado de modo que un chunk empieza por «Dijo que entraría en vigor de inmediato» mientras el CEO que lo dijo está en el chunk anterior. Es el mismo bug, y es la forma que producen la mayoría de los corpus reales.
3.3 Los dos flujos, uno al lado del otro
visualize_chunking_approaches() imprime la diapositiva como un par de diagramas de flujo ASCII. Aquí se condensa en una línea por etapa: las etiquetas son literales del script, el dibujo de las cajas no:
ASCII original
EARLY CHUNKING (Traditional):
Full Document ─► [Split Text] ─► Chunk 1 | Chunk 2 | Chunk 3
                                    │        │        │
                                 [Embed]  [Embed]  [Embed]
                                    ▼        ▼        ▼
                                Vector 1 | Vector 2 | Vector 3

"Each chunk embedded INDEPENDENTLY - no cross-chunk context!"

LATE CHUNKING (Context-Preserving):
Full Document ─► [Embed FULL Document]
                      ▼
        Full Document Token Embeddings
        [tok1] [tok2] [tok3] ... [tok_n]
        "Each token has FULL document context via attention"
                      ▼
        [Split Embeddings by Position]
                      ▼
          Vector 1  |  Vector 2  |  Vector 3
          (pooled)     (pooled)     (pooled)

"Each chunk vector KNOWS about the whole document!"
"'He' in chunk 2 is embedded with knowledge that 'He' = 'Steve Jobs'"
«Cada chunk, como digo aquí, es su propia entidad. Su embedding se genera de forma independiente. Así que no hay contexto entre chunks». 06:32:36
El aislamiento es la causa raíz y es estructural. Ninguna mejora del retrieval (ni un reranker, ni reescribir la query, ni k=50) arregla un embedding que se calculó a ciegas. Es otra vez el invariante 1: la calidad se hereda hacia delante y nunca se recupera aguas abajo.
La ley general que extrae de ello, en dos citas cortas 06:27:31:
«todo está ligado al contexto, porque los modelos de lenguaje grandes necesitan contexto».
«da igual lo superior que sea el modelo, siempre acabarás con resultados subóptimos».
La calidad del modelo no sustituye a la calidad del contexto. Y el modelo mental con el que quedarte: «piensa en ello como tener las ideas correctas, los pensamientos completos, en cada uno de los chunks».
3.4 La simulación, y lo que demuestra y no demuestra
Aquí el curso choca con una limitación dura y, hay que reconocérselo, lo dice en voz alta. La API de embeddings de OpenAI no expone los token embeddings. Obtienes un único vector agregado por cada cadena de entrada. Por tanto, el late chunking de verdad es imposible con ella. Así que el script simula el efecto anteponiendo una cadena de contexto y volviendo a generar el embedding:
# fcc-production-rag-part-6/03_late_chunking.py — simulate_late_chunking()
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

chunk1 = "Steve Jobs was born in San Francisco in 1955. He was adopted by Paul and Clara Jobs shortly after birth."
chunk2 = "He co-founded Apple Computer in 1976 with Steve Wozniak. The company started in his parents' garage."

query = "What company did Steve Jobs found?"

# Early chunking: embed chunks separately
chunk2_embedding_early = embeddings.embed_query(chunk2)
query_embedding = embeddings.embed_query(query)
similarity_early = np.dot(chunk2_embedding_early, query_embedding)

# Late chunking simulation: embed chunk WITH context prepended
chunk2_with_context = (
    f"[Context: This is about Steve Jobs, founder of Apple] {chunk2}"
)
chunk2_embedding_late = embeddings.embed_query(chunk2_with_context)
similarity_late = np.dot(chunk2_embedding_late, query_embedding)

improvement = ((similarity_late - similarity_early) / similarity_early) * 100
print(f"\nImprovement: {improvement:.1f}%")

print("NOTE: This is a SIMULATION using context prepending.")
print("True late chunking uses token-level embeddings from")
print("models like Jina that support this natively.")
El resultado 06:34:39: 0.6857 → 0.6871, impreso como Improvement: 0.2%.
«Hay una pequeña mejora. Aun así, sigue siendo una mejora del 0.2%». 06:34:39
(La función también define una cadena document y un chunk1 y no usa ninguno de los dos: son decorado. Solo se generan embeddings de chunk2 y de query).
Su explicación de en qué consiste realmente la mejora, en 06:33:38: la query decía «Steve Jobs», no «he», y aun así el retrieval encontró el match, porque el vector del chunk sabe que «he» se refiere a Steve Jobs.
3.5 Implementarlo de verdad
show_implementation_options() imprime cuatro opciones. Dos de ellas tienen problemas reales con las versiones actuales de las librerías y una ni siquiera es late chunking, así que lee el código y después lee las correcciones.
Opción 1: embeddings de Jina, late chunking nativo. Tal como lo imprime el script:
# fcc-production-rag-part-6/03_late_chunking.py — OPTION 1, AS PRINTED (see warning below)
from langchain_community.embeddings import JinaEmbeddings

embeddings = JinaEmbeddings(
    model_name="jina-embeddings-v3",
    late_chunking=True  # Enable late chunking
)
Pros: soporte nativo, la mejor calidad. Contras: otro modelo, puede requerir una API key.
Fíjate también en la restricción que el capítulo nunca menciona:
Opción 2: contextual retrieval (§2 de esta parte), reproducida aquí como alternativa agnóstica del modelo: context = generate_context(chunk, full_document), contextualized_chunk = f"{context} {chunk}", y generas el embedding de eso. Pros: funciona con cualquier embedding model. Contras: coste de LLM añadido en tiempo de indexación.
Opción 3: Parent Document Retriever. El fragmento impreso tiene un import obsoleto:
# fcc-production-rag-part-6/03_late_chunking.py — OPTION 3, AS PRINTED. Import is WRONG for LangChain 1.x
from langchain.retrievers import ParentDocumentRetriever
En LangChain 1.2.7, el paquete langchain solo expone agents, chat_models, embeddings, messages, rate_limiters y tools: no existe langchain.retrievers. El import que funciona, y una construcción que funciona, vienen del otro repo:
# production-course-main-code/advanced_rag.py — the CORRECT import and a real working setup
from langchain_classic.retrievers import ParentDocumentRetriever
from langchain_classic.storage import InMemoryStore

parent_splitter = RecursiveCharacterTextSplitter(chunk_size=800, chunk_overlap=100)
child_splitter = RecursiveCharacterTextSplitter(chunk_size=200, chunk_overlap=20)

vectorstore = Chroma(
    collection_name="parent_child_demo",
    embedding_function=OpenAIEmbeddings(model="text-embedding-3-small"),
)
store = InMemoryStore()

retriever = ParentDocumentRetriever(
    vectorstore=vectorstore,
    docstore=store,
    child_splitter=child_splitter,
    parent_splitter=parent_splitter,
)

retriever.add_documents([long_doc])

# Search finds a SMALL child chunk...
child_docs = vectorstore.similarity_search(query, k=1)
# ...but the retriever returns the LARGE parent
parent_docs = retriever.invoke(query)
Los hijos pequeños dan un matching preciso; el padre grande le da al LLM espacio para razonar. Su descripción 06:37:42: el retriever recorre la jerarquía padre→hijo y devuelve el padre, que lleva el contexto más completo. (Él lo llama «árbol»; la implementación de LangChain es en realidad un docstore indexado por el id del padre, no una estructura de árbol).
Opción 4: overlap + cabeceras de resumen. La versión de andar por casa, y la que ya deberías estar haciendo:
# fcc-production-rag-part-6/03_late_chunking.py — OPTION 4
splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=100  # Overlap captures some context
)

# Add document summary to each chunk
for chunk in chunks:
    chunk.page_content = f"[From: {doc_title}] {chunk.page_content}"
Pros: sencilla, sin coste extra. Contras: preservación del contexto limitada. Fíjate en que esto es contextual retrieval con una plantilla en lugar de un LLM: mete gratis el título del documento en el vector, y nada más. Merece la pena hacerlo el primer día de cualquier proyecto, porque cuesta un formateo de cadena y te resuelve la mitad «¿qué documento?» del problema.
4. El marcador: cinco enfoques, y por qué apilarlos
4.1 La tabla comparativa
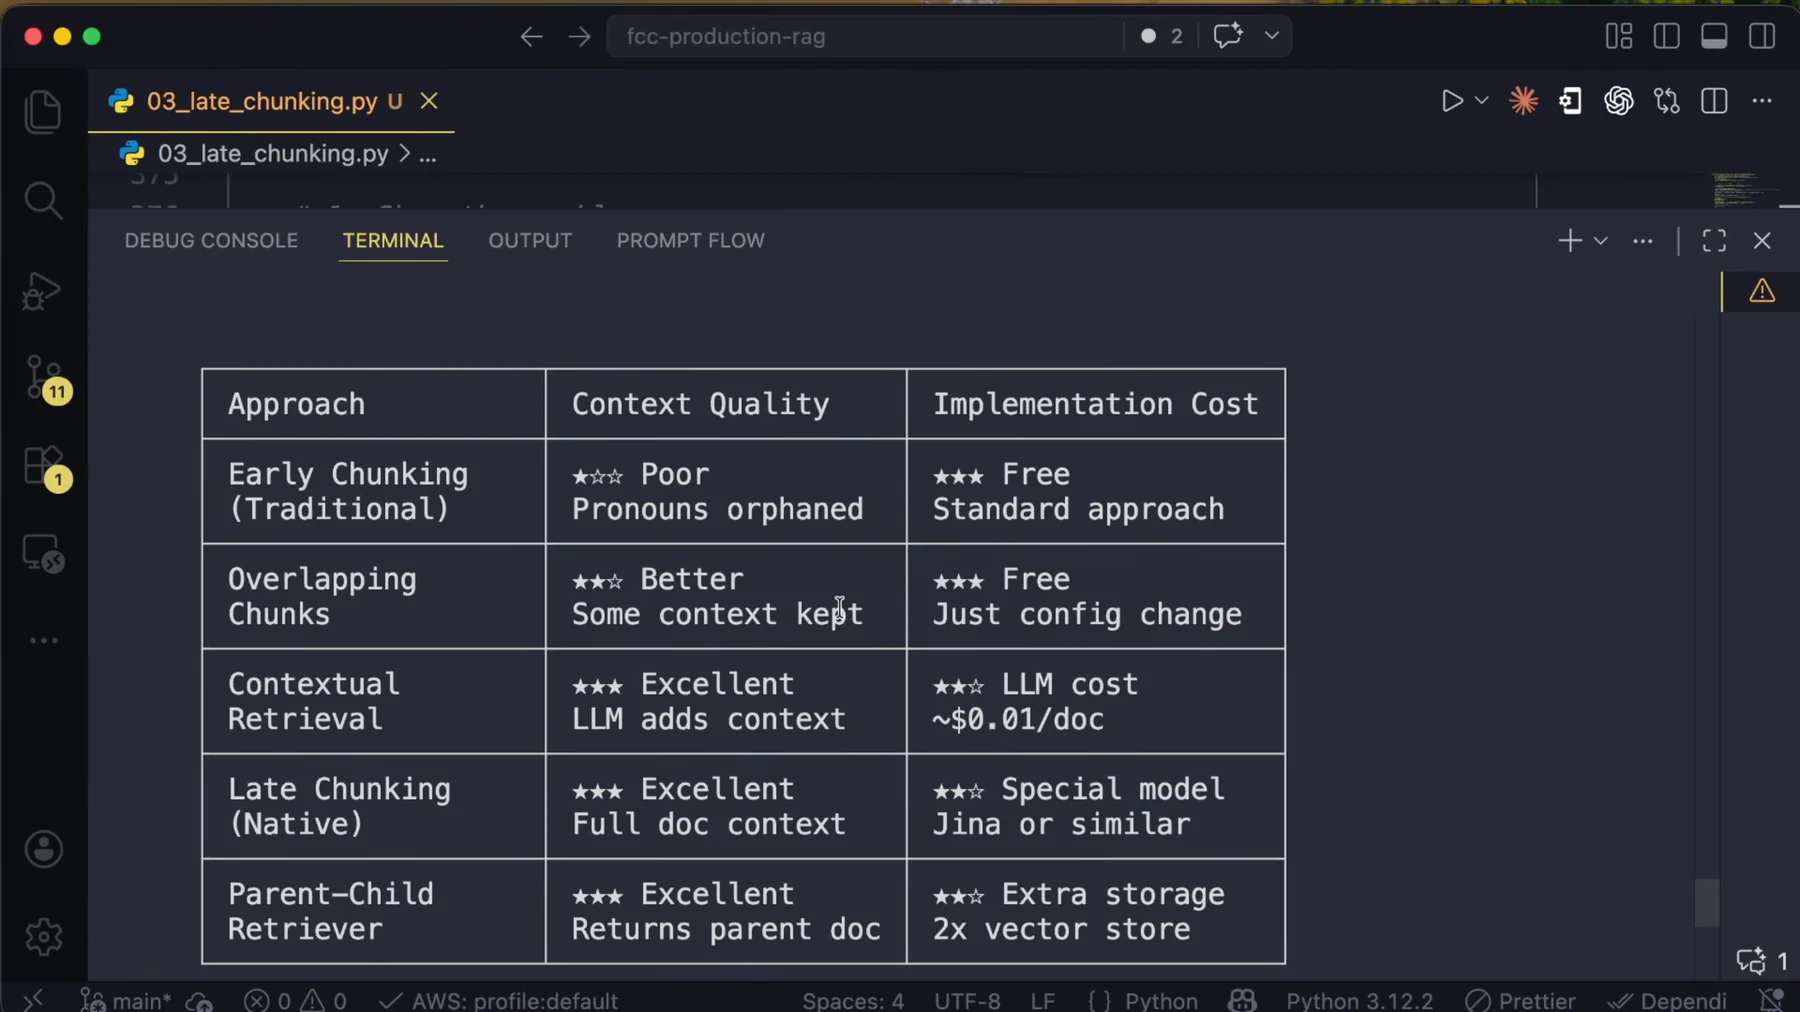
print_comparison() muestra en el terminal, no una diapositiva; por eso puedes reproducirla en local con uv run python 03_late_chunking.py. Lee las dos columnas como calidad frente a qué tipo de coste: las tres últimas filas tienen tres estrellas en calidad, y solo se diferencian en la moneda con la que te cobran: dólares por documento, dependencia de un modelo o almacenamiento.| Enfoque | Calidad del contexto | Coste de implementación |
|---|---|---|
| Chunking temprano (tradicional) | ★☆☆ Mala: pronombres huérfanos | ★★★ Gratis: enfoque estándar |
| Chunks con overlap | ★★☆ Mejor: se conserva algo de contexto | ★★★ Gratis: solo un cambio de configuración |
| Contextual retrieval | ★★★ Excelente: el LLM añade contexto | ★★☆ Coste de LLM ~$0.01/doc |
| Late chunking (nativo) | ★★★ Excelente: contexto del documento entero | ★★☆ Modelo especial: Jina o similar |
| Retriever padre-hijo | ★★★ Excelente: devuelve el documento padre | ★★☆ Almacenamiento extra: 2× vector store |
Su explicación de huérfano 06:36:42: «no están vinculados a un padre… no tienen ninguna correlación que apunte al otro fragmento de datos con el que están conectados por contexto». Sobre los chunks con overlap: «Es mejor porque conservamos algo de contexto. El coste de implementación también es gratis: solo tienes que configurar un par de cosas». Sobre la columna de coste del late chunking: el precio es la dependencia del modelo (vendor lock-in), no dólares.
4.2 El marcador de precisión
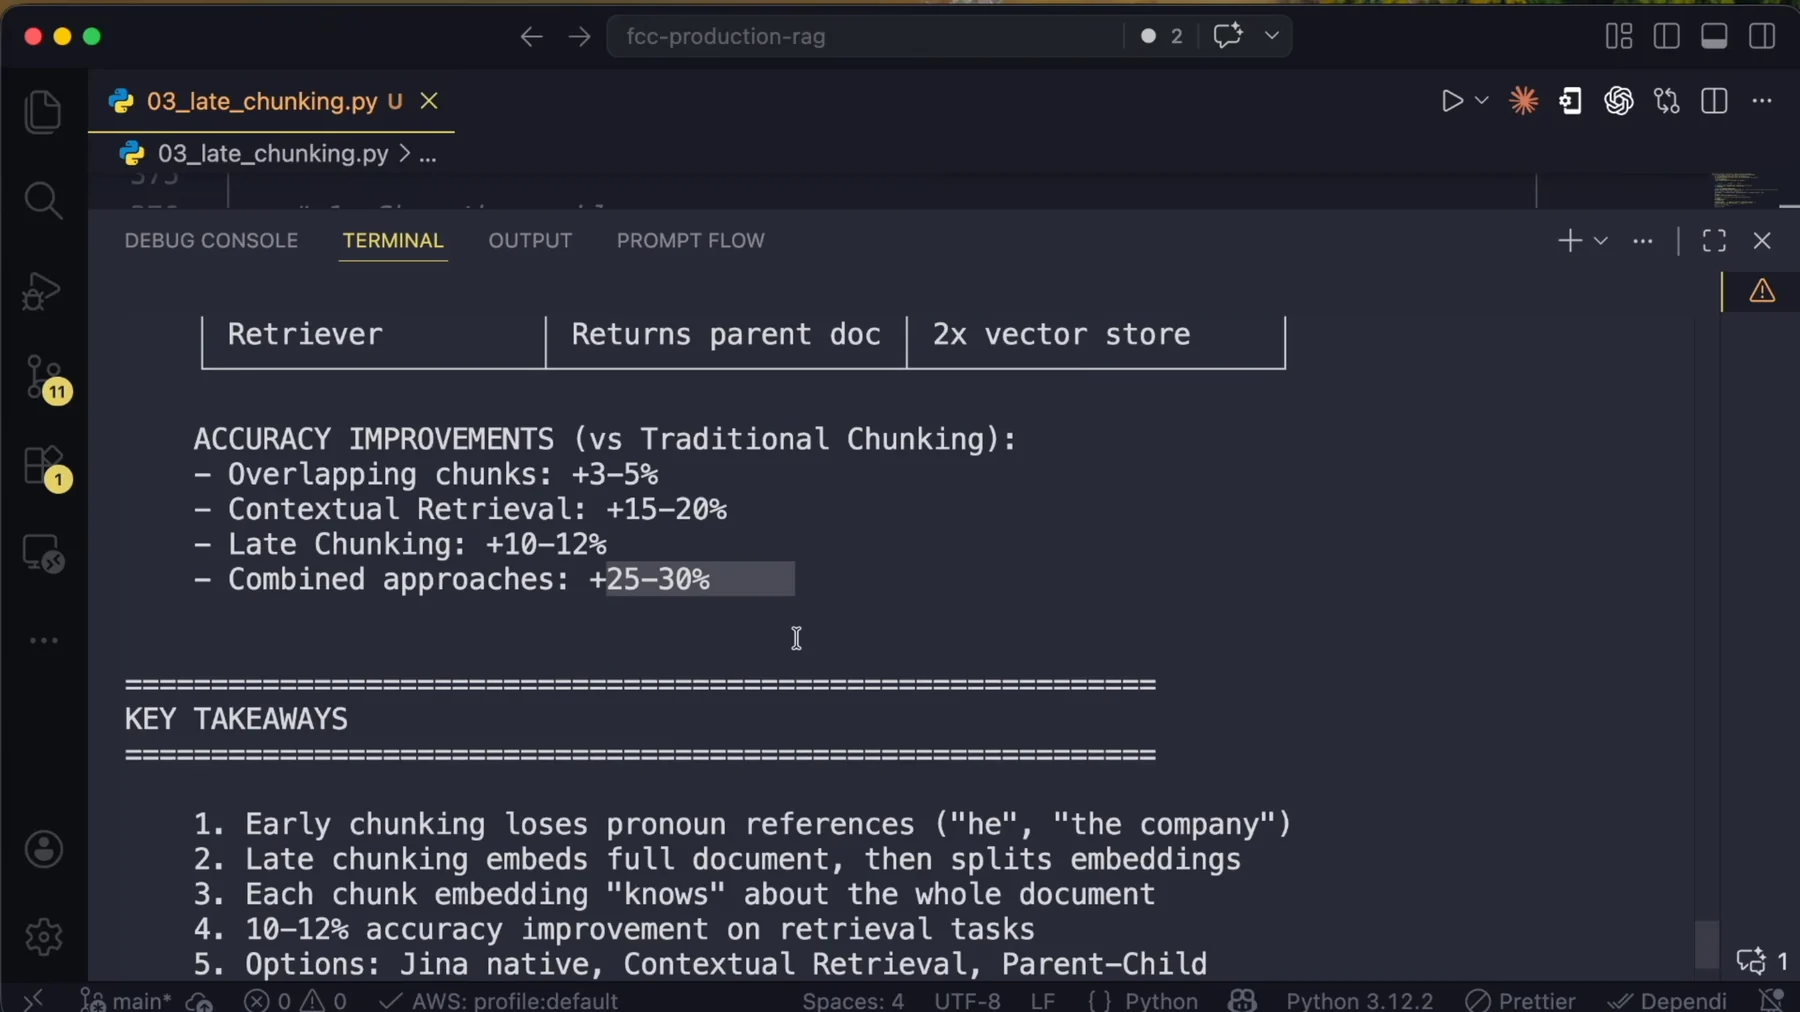
| Técnica | Mejora de precisión frente al chunking tradicional |
|---|---|
| Chunks con overlap | +3–5% |
| Contextual retrieval | +15–20% |
| Late chunking | +10–12% |
| Enfoques combinados | +25–30% |
Fíjate en que el +15–20% de aquí es más alto que nada de lo que el capítulo 25 narró sobre el contextual retrieval: las dos lecciones citan métricas distintas (reducción de fallos de retrieval allí, ganancia de precisión aquí) y nunca las concilian. Dos observaciones que el curso no hace de forma explícita, y las dos cambian lo que deberías construir:
4.3 Apila, no elijas
«No se trata de elegir una sola estrategia o enfoque y tirar con eso». 06:38:42
06:38:42 Su planteamiento estratégico: a nivel de producción quieres elegir todas estas estrategias, para acabar con un sistema híbrido que las use todas. La fila del +25–30% es el argumento.
El orden de recomendación del propio código, que es el material más accionable del capítulo:
- Empieza por el Contextual Retrieval (lección 6.2): funciona con cualquier embedding model.
- Si usas Jina, activa el late chunking nativo.
- Combínalo con el Parent Document Retriever para obtener los mejores resultados.
- Usa siempre un chunk overlap significativo (10–20%).
Léelo como un orden de construcción, no como un menú. El paso 4 es gratis y ya deberías tenerlo desde la Parte 3. El paso 1 es un cambio en tu job de indexación. El paso 3 es un cambio en tu retriever. El paso 2 es un cambio de proveedor de embeddings, el cambio más invasivo de la lista, y por eso es condicional y está en penúltimo lugar.
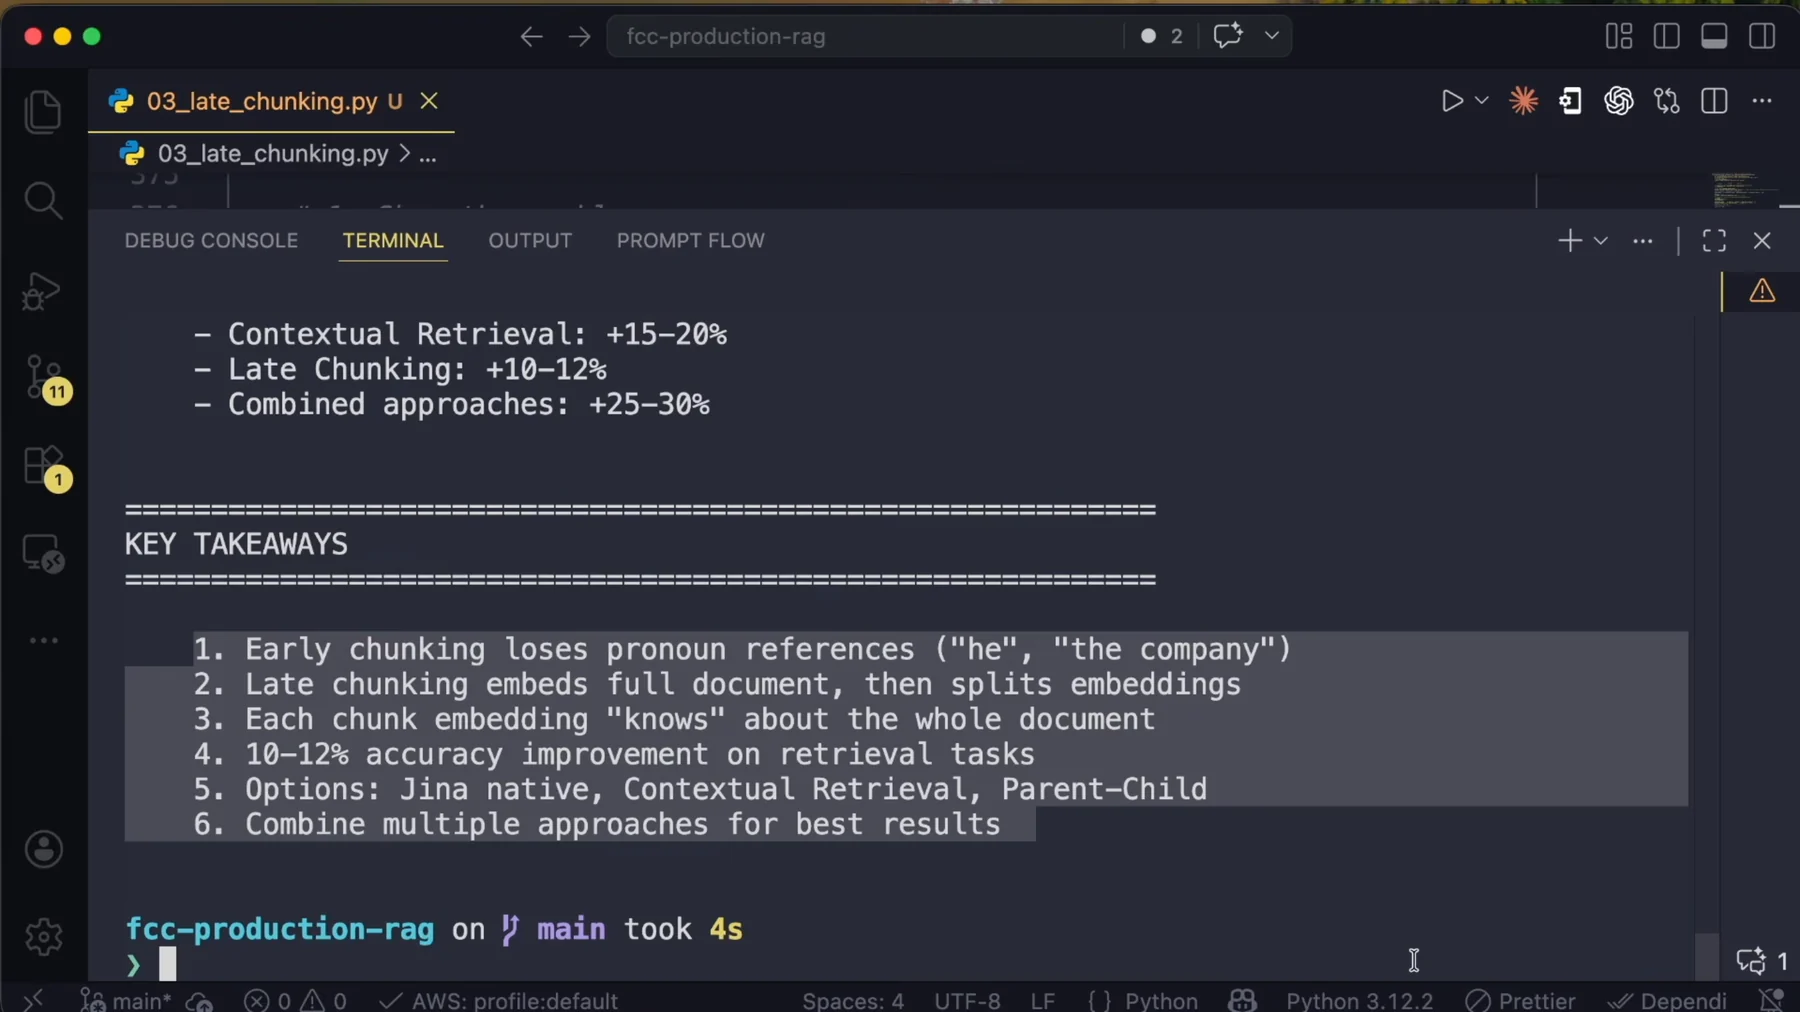
fcc-production-rag on main took 4s; toda esta lección se ejecuta en cuatro segundos porque solo simulate_late_chunking() toca una API. La lección de contextual retrieval anterior tardó 19s, y esa diferencia es el perfil de costes de la técnica en miniatura.Las seis conclusiones clave, literales de la pantalla:
- El chunking temprano pierde las referencias de los pronombres («he», «the company»).
- El late chunking genera el embedding del documento completo y después divide los embeddings.
- El embedding de cada chunk «conoce» el documento entero.
- 10–12% de mejora de precisión en tareas de retrieval.
- Opciones: Jina nativo, Contextual Retrieval, padre-hijo.
- Combina varios enfoques para obtener los mejores resultados.
4.4 Dónde pasa el testigo
El capítulo de la fuente se sale de su propio tema: los últimos dos minutos y medio del capítulo 26 (06:39:44–06:42:04) ya son la diapositiva conceptual de Agentic RAG, y se corta a mitad de frase («Cuando llega la query, el…»), que retoma el capítulo siguiente. Ese material pertenece a las partes agénticas de esta guía, no a esta, pero merece la pena llevarse el adelanto de una línea:
«Hoy en día el RAG en producción no es solo un pipeline fijo que va A, B, C… ahora en el centro de todo tienes un agente». 06:39:44
Todo lo de la Parte 14 sigue siendo un pipeline fijo: decides en tiempo de indexación qué técnica aplicar, y el camino de query ejecuta los mismos pasos cada vez. La siguiente frontera es un bucle de retrieval que evalúa sus propios resultados y vuelve a lanzar la query cuando son malos, que es hacia donde va esta guía a continuación.
5. Diagnósticos que puedes ejecutar esta semana
Dos procedimientos, ambos baratos, ambos te dan pruebas en lugar de intuiciones.
5.1 Cuenta los huérfanos de tu propio corpus
Generalizado a partir de la demo de Steve Jobs. No cuesta nada: ninguna llamada a la API.
- Divide un documento representativo con la configuración de splitter de producción (no con el
chunk_overlap=0 de la demo).
- Para cada chunk, comprueba si aparece en él el nombre canónico de la entidad.
- Cuenta los pronombres y las referencias definidas en columnas separadas:
he,him,his,she,
her, they, them, it, the company, the report. Usa una regex con límites de palabra, no count(" he "): mira el bug del §3.2.
- Cualquier chunk con pronombres pero sin el nombre es un chunk que tus embeddings no pueden encontrar por el nombre.
En la demo son 3 de 4. Si es una fracción significativa de tu corpus, el contextual retrieval se pagará solo.
5.2 Simula el beneficio antes de comprar un embedding model nuevo
- Elige un chunk que empiece por un pronombre y una query que nombre a la entidad.
- Genera el embedding de la query y del chunk aislado; calcula el producto escalar → línea base.
- Antepón una cadena de contexto de una línea, vuelve a generar el embedding y calcula otra vez el producto escalar.
improvement = ((late - early) / early) * 100.- Espera una cifra pequeña (0.2% en la ejecución del curso). Esto solo demuestra la dirección. Si
quieres la magnitud, ejecuta un eval de retrieval real sobre un conjunto etiquetado de queries/pasajes (la disciplina de medición de la Parte 7), no un producto escalar de un solo par.
5.3 Reproduce las tres lecciones
cd fcc-production-rag-part-6           # requires OPENAI_API_KEY in .env
uv run python 01_long_context_vs_rag.py   # cost math, latency, framework, hybrid demo
uv run python 02_contextual_retrieval.py  # ~19s, real LLM + embedding calls
uv run python 03_late_chunking.py         # ~4s, three embed_query calls in the simulation
Entorno, sacado de los metadatos del repo y no del README (que dice Python 3.10+ y se equivoca): .python-version = 3.13 y pyproject.toml requires-python >= 3.13, que fija langchain>=1.2.0,<2.0.0, langchain-openai>=1.1.0, langchain-chroma>=1.1.0, langchain-text-splitters>=1.1.2, openai>=2.32.0, tiktoken>=0.12.0, networkx, python-dotenv. requirements.txt añade lo que pyproject.toml omite (chromadb>=1.5.0, langchain-classic>=1.0.0, langgraph>=1.1.0) e incluye en la cabecera la regla «use langchain-chroma, NOT langchain-community» para el vector store. La grabación de pantalla muestra Python 3.12.2 en VS Code, así que el README, pyproject.toml y el entorno grabado no coinciden entre sí. Fíate de pyproject.toml.
6. Decisiones que tomar
Recorre esta lista en orden. Cada fila es una decisión con un valor por defecto, no una sugerencia.
| # | Decisión | Por defecto / disparador |
|---|---|---|
| 1 | ¿RAG o contexto largo para este corpus? | Corpus de <50K tokens y <100 queries/día y preguntas sobre el documento entero → contexto largo. Si no, RAG. Ante cualquier ambigüedad → RAG, porque se degrada con elegancia a medida que crece el corpus. |
| 2 | Haz la aritmética de escala antes de comprometerte. | Calcula el coste/query y luego ×volumen×30. Si la diferencia mensual es menor que una hora de ingeniero, cualquiera de los dos diseños vale; en cuanto deja de serlo, la arquitectura es una decisión financiera, no de gustos. |
| 3 | Presupuesta contra el límite de contexto *efectivo*. | 60–70% de la ventana anunciada. Con un modelo de 1M, planifica para 600–700K. |
| 4 | Añade el patrón de selector híbrido. | Si los usuarios hacen preguntas sobre el documento entero acerca de uno entre muchos documentos: retrieval con k=1 → carga el documento completo → responde. La gran mejora más barata de esta parte. |
| 5 | Haz el recuento de huérfanos (§5.1). | Si una minoría importante de chunks lleva pronombres sin su referente, activa el contextual retrieval. Mide la fracción; no la adivines. |
| 6 | Activa el contextual retrieval si salta cualquier disparador. | Contexto en cabeceras/títulos · entidades referidas con pronombres · corpus de varias fuentes. |
| 7 | Presupuesta la contextualización con honestidad. | $0.01–$0.05/doc es un suelo. Coste real ≈ chunks × longitud del documento en tokens de entrada. Añade prompt caching y batch APIs antes de ejecutarlo sobre un corpus grande: el curso no cubre ninguna de las dos cosas. |
| 8 | Haz la contextualización asíncrona. | 1–2 s/chunk. Mételo en una cola. Nunca lo hagas en línea dentro de una request de subida. |
| 9 | Guarda original_chunk y context_prefix en los metadatos. | Genera el embedding del texto contextualizado, cita el original, audita el prefijo. Innegociable. |
| 10 | Rellena title o source en cada documento cargado. | create_contextual_chunks() recurre a la cadena literal «Unknown Document» y genera todos los prefijos contra ella. Es silencioso y envenena el índice entero. |
| 11 | Indexa también el texto contextualizado en BM25. | Conclusión n.º 6. La cifra del 49% de Anthropic corresponde a embeddings + BM25 contextual, no a embeddings solos. |
| 12 | Prevé un crecimiento del 20–30% de los chunks. | El impacto en almacenamiento es mínimo; en el prompt, no. Un retrieval top-5 mete ahora ~25% más de texto en cada prompt de respuesta. Revisa el presupuesto de tokens de la Parte 9. |
| 13 | Late chunking: solo con un modelo que lo soporte de verdad. | Comprueba que el cuerpo de la request lleva de verdad late_chunking. El wrapper comunitario de LangChain lo descarta en silencio. |
| 14 | Comprueba que tus documentos caben en la ventana del embedder. | El late chunking necesita el documento entero en un solo forward pass. Lee la model card para conocer el límite real; si lo superas, vuelves a estar segmentando y eligiendo fronteras de segmento. |
| 15 | Pon el padre-hijo encima de lo que hayas elegido. | Corrige otro eje (lo que se devuelve) y cuesta 2× de almacenamiento vectorial. Usa langchain_classic.retrievers, no langchain.retrievers. |
| 16 | Mantén siempre un chunk overlap del 10–20%. | +3–5% por un cambio de configuración. No hay ningún argumento en contra. |
| 17 | Mide tus propias cifras. | Todas las cifras de esta parte (1,200×, 25×, 49%, 67%, +10–12%, +15–20%, +25–30%) son orientativas. «Son solo benchmarks. Así que tienes que probarlo por tu cuenta». 06:24:26 |
Las tres técnicas de esta parte compran lo mismo: un chunk que se puede encontrar con una pregunta formulada como la formularía una persona. El contexto largo lo compra no dividiendo nunca. El contextual retrieval lo compra escribiendo las palabras que faltan. El late chunking lo compra generando el embedding antes de dividir. Elige por coste y por restricciones, no por novedad, y recuerda que la opción aburrida y gratuita, un overlap del 10–20%, ya está en el marcador.