
Agentic RAG: retrieval autocorrectivo con LangGraph
Retrieval que se autocorrige: evaluar, reescribir y reintentar con una máquina de estados de LangGraph.
Todos los pipelines que has construido hasta ahora en esta guía son una línea recta. Los documentos entran por un extremo, la respuesta sale por el otro y la línea se recorre exactamente una vez por pregunta. La Parte 3 mejoró lo que entra en el índice. La Parte 6 mejoró lo que sale del retriever. La Parte 14 mejoró lo que cada chunk significa antes de hacerle embedding. Todos siguen siendo de una pasada: tienes un único retrieval, y lo que te dé es con lo que tiene que trabajar el generador.
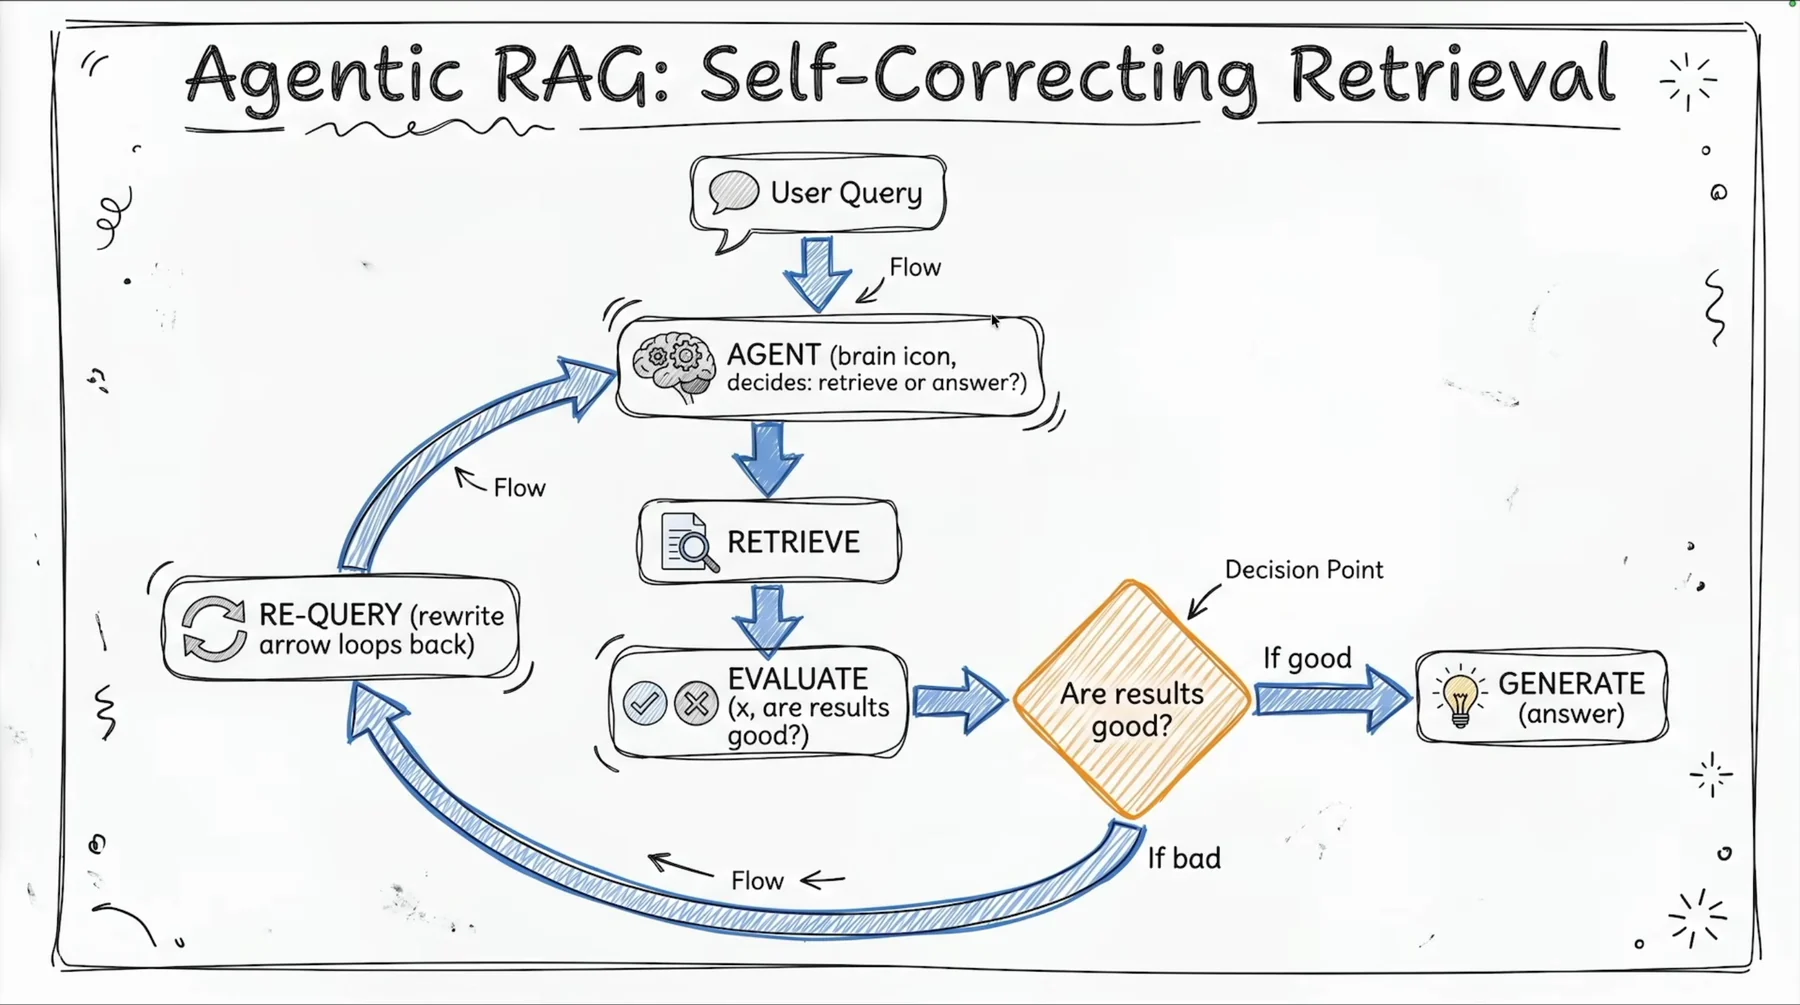
Esta parte cambia otra cosa. Cambia el flujo de control de la Phase B. En lugar de retrieve → generate, tienes retrieve → grade → {generate | rewrite → retrieve | give up} — un grafo con un ciclo dentro, en el que el sistema lee sus propios resultados de retrieval, decide que no son lo bastante buenos y lo vuelve a intentar con una query mejor.
Esa es toda la idea, y ataca directamente el invariante 4 del modelo mental: los fallos son silenciosos. El RAG de una pasada no puede decirte que ha fallado, porque nada en él mira nunca la salida del retrieval y se pregunta «¿esto trata realmente de la pregunta?». El agentic RAG inserta exactamente esa pregunta en el pipeline y le da al sistema un sitio al que ir cuando la respuesta es que no.
También es, por query, lo más caro de esta guía, y el capítulo que lo enseña nunca le pone cifra a la factura. Esta parte sí.
El problema: un resultado no es lo mismo que un buen resultado
El instructor plantea el RAG tradicional en 06:39:44 — query, retrieval, pasar al LLM — con una frase que merece la pena masticar:
«Después de eso tienes un resultado; sea un buen resultado o no, es un resultado».
Ahí está toda la acusación. Un pipeline de RAG de una pasada no tiene noción de éxito. Si el retriever devuelve tres documentos sobre la historia de las versiones de Python cuando el usuario ha preguntado cómo hacer una pizza, el pipeline no se da cuenta. Formatea esos tres documentos en un bloque de contexto, se los pasa al modelo con una instrucción educada y produce prosa. Según lo estricto que sea tu prompt, obtienes o una alucinación o una negativa confusa — y en ambos casos tu tasa de errores es del 0%, porque nada ha lanzado una excepción.
Es la misma enfermedad que la Parte 1 identificó al separar fluidez de corrección, ahora con un mecanismo. El pipeline no está roto; está sin supervisión. No hay ninguna etapa cuyo trabajo sea juzgar a la etapa anterior.
La aportación del agentic RAG es una palabra insertada en el pipeline: evaluar. Todo lo demás — el grafo, el objeto de estado, el presupuesto de retries — es la fontanería necesaria para actuar en función de lo que diga la evaluación.
La definición conductual del retrieval autocorrectivo, en palabras del instructor en 06:43:05:
«Vale, esto no ha funcionado. Volvamos atrás y barajemos hasta llegar al resultado correcto».
La versión formal, en 07:01:26: el sistema evalúa lo que ha devuelto el retriever y comprueba si es «realmente congruente con la query que ha entrado» — y si no, incrementa el contador de retries y reescribe.
El contraste en una línea del instructor, en 06:43:05:
«RAG tradicional: query, retrieval y generación — o sea, una sola pasada. Con agentic RAG… evaluamos y decidimos si hay que volver a hacer el retrieval».
Qué significa realmente «agéntico» aquí
Antes del grafo, el vocabulario. El curso define un agente en 06:39:44 como algo «más listo que un simple modelo de lenguaje grande» — algo que usa un LLM como base pero que puede llamar a herramientas y, sobre todo, tomar decisiones.
De esa definición se derivan cuatro patrones, y el capítulo los nombra todos:
| # | Patrón | Qué significa | ¿En el código de este capítulo? |
|---|---|---|---|
| 1 | Enrutamiento | «Si esto está bien, ve por aquí. Si no, vuelve por aquí». 06:40:44 | Sí — la arista condicional |
| 2 | Autocorrección | Detectar malos resultados, reescribir la query, reintentar 06:41:44 | Sí — el ciclo rewrite → retrieve |
| 3 | Varios pasos | Partir una query compleja en subqueries 06:41:44 | No — se afirma, nunca se implementa |
| 4 | Uso de herramientas | Llamar a herramientas y decidir cuándo 06:42:04 | No — un único retriever cableado |
El patrón 4 es donde el instructor pone el énfasis, y el énfasis está en la segunda mitad:
06:42:04 *«Los agentes también pueden ir y llamar a herramientas y decidir cuándo llamar a esas herramientas».*
Decidir cuándo es la parte que sostiene todo. Una chain que siempre llama a la misma herramienta en el mismo orden no es un agente; es una chain con sintaxis extra. Sé honesto contigo mismo sobre cuál de las dos has construido.
La extensión natural que el capítulo describe pero no programa (06:42:04) son varias herramientas de retrieval, cada una con una estrategia distinta — búsqueda vectorial densa, BM25, híbrida, parent-child, una colección completamente distinta. Cuando la herramienta 1 devuelve resultados subóptimos, el agente viene a decir «vale, tú no funcionas bien porque los resultados son subóptimos» y escala a la herramienta 2. Es el hermano, a nivel de estrategia, de la reescritura de queries:
Reescribe la query o cambia de retriever. Esas son las dos palancas que tiene un bucle de retrieval autocorrectivo. La lección solo implementa la primera; los retrievers para la segunda ya están en tu caja de herramientas desde la Parte 6.
Por qué LangGraph — la razón técnica, no la de marketing
En 06:43:05 se presenta LangGraph como la parte de LangChain «que te permite crear agentes de IA fácilmente» y, lo que es más útil, una que «te deja construir estos bucles de decisión fácilmente».
La razón real es más estrecha y vale la pena enunciarla con precisión, porque es lo único que obliga a meter un framework nuevo en tu stack:
Las chains de LCEL son acíclicas.
prompt | llm | parseres una tubería dirigida; no hay forma de expresar en ella «vuelve al paso 2». Un bucle de retry es un ciclo.StateGraphes lo que añade los ciclos.
Todo lo demás que te da aquí LangGraph — nodos, aristas, un objeto de estado tipado — lo podrías aproximar con un bucle while y un diccionario. Lo que no podrías aproximar de forma barata es la maquinaria que viene gratis en cuanto tu flujo de control es un objeto grafo: checkpointing, streaming por nodo, interrupciones human-in-the-loop y tracing por nodo. Esta lección no usa ninguna de ellas, pero son la razón por la que construyes el bucle como un grafo y no como un bucle while.
El propio docstring del archivo es tajante: «LangGraph 1.x es el estándar de producción para construir estos workflows». Toma lo de «estándar de producción» como la opinión del instructor en abril de 2026, no como un hecho — él mismo le pone fecha en 07:02:28: «este es el patrón de producción que tienes que usar en 2026 y en adelante. Las cosas pueden cambiar más tarde».
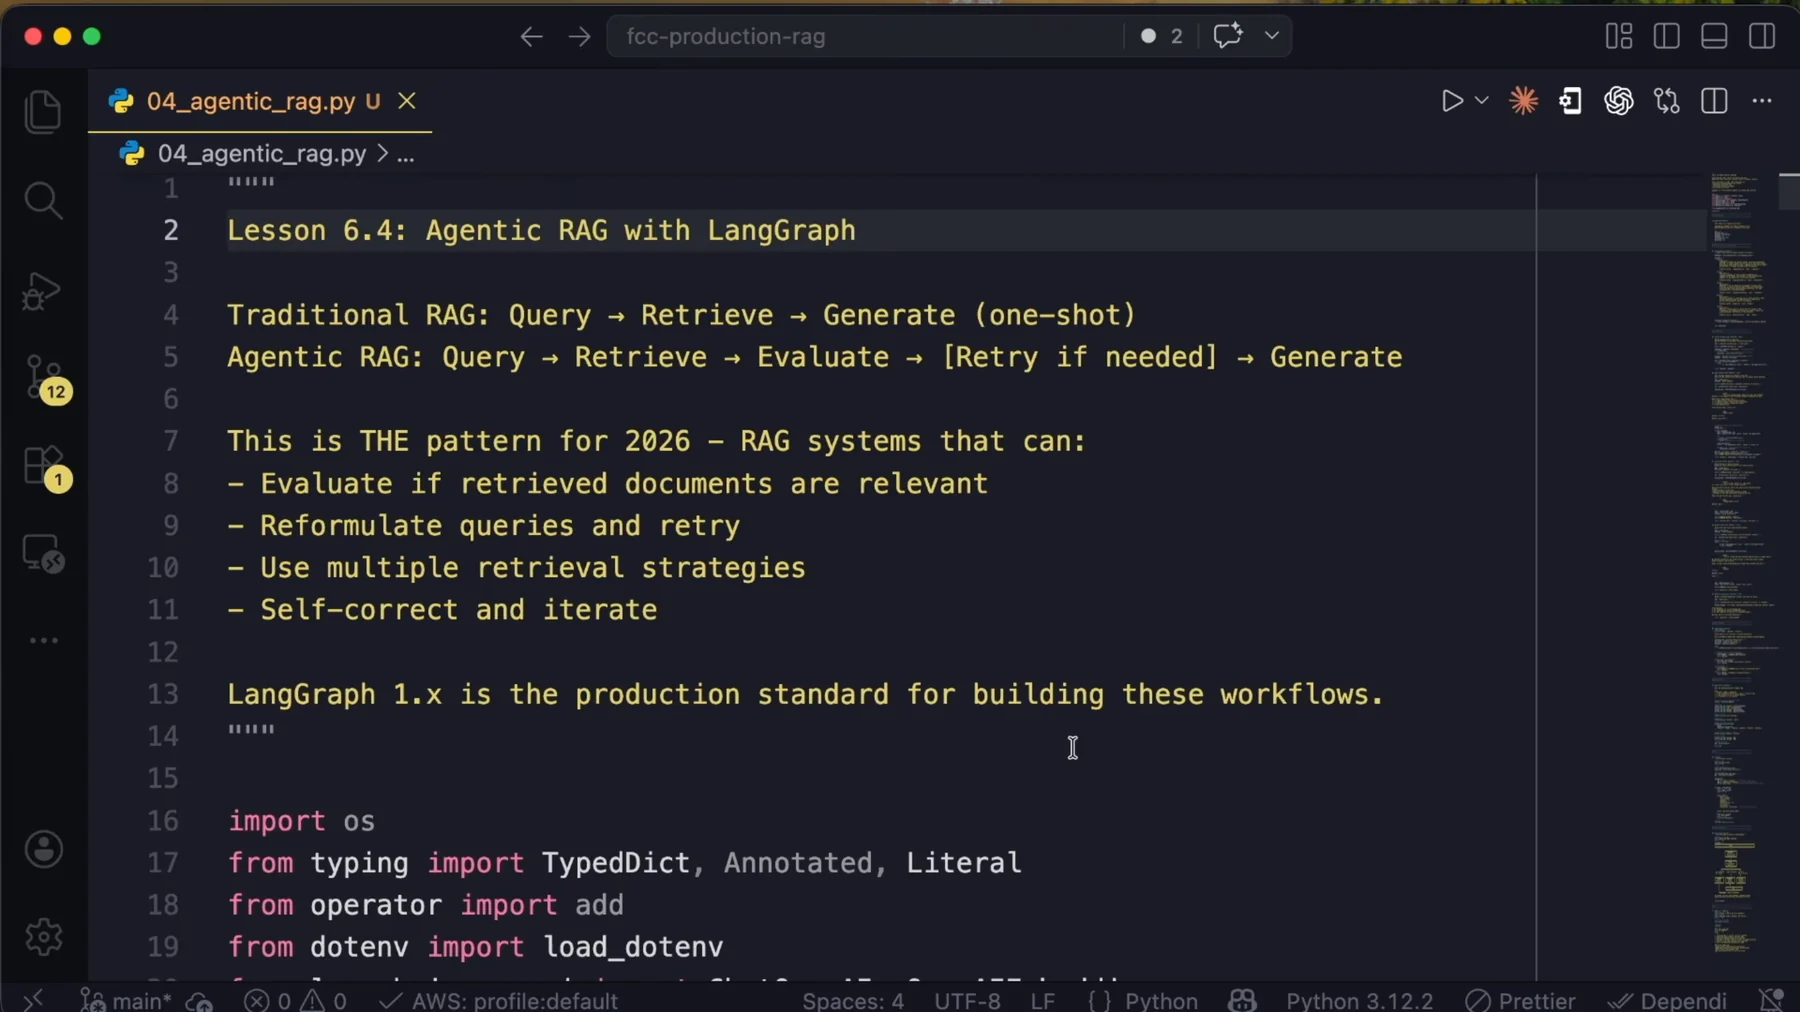
04_agentic_rag.py («Lesson 6.4: Agentic RAG with LangGraph»), Python 3.12.2 en la ejecución grabada. Los cuatro puntos son el contrato del capítulo: evaluar la relevancia, reformular y reintentar, usar varias estrategias de retrieval, autocorregirse e iterar. El código publicado cumple el primero, el segundo y el cuarto; lo de «varias estrategias de retrieval» es una aspiración.Entorno, imports y pins de versiones — incluida una contradicción que conviene conocer
El archivo es 04_agentic_rag.py en el repo del curso de la Parte 6 (fcc-production-rag en pantalla, clonado localmente como fcc-production-rag-part-6). Su requirements.txt lleva la cabecera «Part 6: Advanced RAG - Dependencies (April 2026)»; los pins que importan aquí:
langchain>=1.2.0,<2.0.0
langchain-core>=1.3.0,<2.0.0
langchain-openai>=1.1.0,<2.0.0
langchain-chroma>=1.1.0,<2.0.0
chromadb>=1.5.0,<2.0.0
langgraph>=1.1.0,<2.0.0
langchain-classic>=1.0.0
El bloque de imports del archivo de la lección, tal cual — fíjate en las líneas 21–22:
import os
from typing import TypedDict, Annotated, Literal
from operator import add
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_chroma import Chroma
from langchain_chroma import Chroma
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.documents import Document

from langgraph.graph import StateGraph, END

load_dotenv()
os, Annotated y add se importan y nunca se usan, y Chroma se importa dos veces. También vale la pena fijarse en que este archivo toma TypedDict de typing, mientras que todos los archivos LangGraph del repo hermano (langgraph_core.py, conditional_edges.py, cycles_loops.py) lo toman de typing_extensions. Dos repos del mismo curso, dos convenciones; elige una a conciencia.
El código fuente se contradice con la versión de Python. pyproject.toml exige Python >= 3.13, .python-version dice 3.13 y la barra de estado de VS Code en la ejecución grabada dice Python 3.12.2. La grabación es anterior a la subida del pin. Fíate del pin, no del vídeo. (La línea «requires Python 3.10 or higher» que verás en el corpus de la demo es texto de un documento de ejemplo escrito para que el grader lo puntúe, no un pin del repo — no lo leas como tal.)
Trampa de los subtítulos. Los subtítulos autogenerados de este capítulo convierten agentic_rag_demo en «a gent demo», ChatOpenAI en «shadow openi», StateGraph en «site graph» y «grader» en «greater». Comprueba siempre el código antes de citar un identificador de este curso.
El objeto de estado es la memoria del agente
Todo en un workflow de LangGraph fluye a través de un único diccionario compartido. Los nodos no se llaman entre sí ni se pasan argumentos; cada nodo lee del estado y devuelve un dict parcial que LangGraph fusiona de vuelta en el estado.
06:44:06 «Piensa en el estado como la memoria» — «una memoria persistente en la que todos estos nodos… van a poder escribir y de la que van a poder leer».
Más adelante, en 06:47:09, la misma idea otra vez: el estado es «la fuente de verdad per se donde todas las piezas encajan». No es decoración — es la razón por la que el router del final del grafo no necesita argumentos. Todo lo que debe saber ya lo han escrito en el estado los nodos que se ejecutaron antes que él.
El esquema es un simple TypedDict, y el archivo explica por qué:
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 35-49)
class RAGState(TypedDict):
    """
    State schema for our agentic RAG workflow.

    LangGraph uses TypedDict for state (not Pydantic in 1.x).
    The Annotated[list, add] tells LangGraph to merge lists.
    """

    query: str
    rewritten_query: str
    documents: list[Document]
    generation: str
    relevance_score: float
    retry_count: int
    max_retries: int
Siete campos, cada uno con una función distinta:
| Campo | Lo escribe | Lo lee | Por qué existe |
|---|---|---|---|
query | quien llama (nunca se sobrescribe) | grade, rewrite, generate, fallback | La intención real del usuario, conservada a lo largo de cada retry |
rewritten_query | rewrite | retrieve | Lo que el retrieval usa de verdad una vez que ha habido una reescritura |
documents | retrieve, y luego sobrescrito por grade | grade, router, generate | El conjunto de trabajo; filtrado hasta los supervivientes |
generation | generate o fallback | quien llama | La respuesta, real o un fallo honesto |
relevance_score | grade | router | Media de las notas por documento |
retry_count | rewrite (incrementa) | router, fallback | Cuántas vueltas hemos dado |
max_retries | quien llama | router | La correa |
Los dos últimos son los que más importan en producción, y el capítulo insiste en ellos sin descanso:
Semántica de fusión, y el reducer que el archivo documenta pero nunca usa
Un nodo devuelve {"documents": [...]} y LangGraph fusiona esa clave en el estado, sin tocar las otras seis. Por defecto la fusión es reemplazar. Si en cambio quieres que un campo se acumule entre iteraciones del bucle — un registro de auditoría de cada intento, por ejemplo — lo anotas con una función reducer. A eso se refiere Annotated[list, add] en el docstring. El archivo de la lección importa tanto Annotated como add y luego no usa ninguno; ningún campo de RAGState lleva reducer, así que cada escritura es un reemplazo.
El ejemplo que funciona está en el repo hermano:
# production-course-main-code/langgraph_core.py  (lines 64-67)
class AccumulatingState(TypedDict):
    messages: Annotated[list[str], operator.add]  # lists concatenate when merged
    count: Annotated[int, operator.add]  # counts sum when merged
Y en el generador de código autocorrectivo se usa el mismo patrón exactamente para lo que un bucle de agentic RAG debería copiar — conservar cada error de cada intento:
# production-course-main-code/cycles_loops.py  (lines 19-26)
class CodeGenState(TypedDict):
    task: str
    code: str
    errors: Annotated[list[str], operator.add]
    iteration: int
    max_iterations: int
    success: bool
Los cinco nodos
Todos los nodos tienen la misma firma: f(state: RAGState) -> dict, y todos devuelven solo los campos que han cambiado. Dos de los cinco (retrieve, fallback) no hacen ninguna llamada al LLM; los otros tres construyen cada uno su propio cliente ChatOpenAI en línea — cómodo para una lección, un despilfarro en un servidor, donde lo subirías a nivel de módulo o lo inyectarías.
| Nodo | Llamadas al LLM | Lee del estado | Escribe en el estado |
|---|---|---|---|
retrieve | 0 (1 embedding) | rewritten_query, query | documents |
grade | una por documento | query, documents | documents (filtrado), relevance_score |
rewrite | 1 | query, retry_count | rewritten_query, retry_count |
generate | 1 | query, documents | generation |
fallback | 0 | query, retry_count | generation |
1. retrieve — el único nodo que toca el vector store
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 119-142)
def retrieve_documents(state: RAGState) -> dict:
    """
    Retrieve documents based on the query.
    Uses rewritten_query if available, otherwise original query.
    """
    query = state.get("rewritten_query") or state["query"]

    print(f"\n[RETRIEVE] Searching for: '{query}'")

    vectorstore = state.get("_vectorstore")  # Injected at runtime
    if not vectorstore:
        # Fallback - create new (in production, pass via config)
        vectorstore = create_sample_vectorstore()

    retriever = vectorstore.as_retriever(search_kwargs={"k": 3})
    documents = retriever.invoke(query)

    print(f"[RETRIEVE] Found {len(documents)} documents")
    for i, doc in enumerate(documents, 1):
        print(
            f"  {i}. {doc.metadata.get('source', 'unknown')}: {doc.page_content[:50]}..."
        )

    return {"documents": documents}
Tres cosas en las que fijarse.
La primera línea es todo el mecanismo del bucle. state.get("rewritten_query") or state["query"] significa: usa la reescritura si existe y, si no, la original. En la primera pasada rewritten_query es "" (falsy), así que se usa la query original. Tras una reescritura, el retrieval cambia en silencio a la nueva formulación. Una sola expresión, y el nodo funciona igual en el intento 0 que en el intento 3.
k=3 está hardcodeado y es el multiplicador de coste. El grader hará una llamada al LLM por cada documento que se devuelva aquí. k ya no es solo un ajuste del retrieval; es un multiplicador directo de tu factura de evaluación.
El logging no es decoración. Imprimir metadata["source"] más los primeros 50 caracteres de cada resultado, en cada intento, es lo que hace que el bucle se pueda depurar — y es el mismo hábito que la Parte 4 te pidió adoptar. En producción sustituye print por el logger JSON estructurado de la Parte 7, indexado por un request id, para poder reconstruir una ejecución de cinco nodos y tres intentos solo a partir de los logs.
2. grade — el nodo que lo hace agéntico
Esta es la etapa nueva. Lo dice el propio comentario del archivo: «Esta es la diferencia CLAVE respecto al RAG tradicional: evaluamos antes de generar».
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 145-206)
def grade_documents(state: RAGState) -> dict:
    """
    Grade retrieved documents for relevance to the query.
    This is the KEY difference from traditional RAG - we evaluate before generating.
    """
    query = state["query"]
    documents = state["documents"]

    print(f"\n[GRADE] Evaluating {len(documents)} documents for relevance...")

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    grading_prompt = ChatPromptTemplate.from_messages(
        [
            (
                "system",
                """You are a relevance grader. Given a user query and a document,
determine if the document contains information relevant to answering the query.

Output ONLY a number between 0 and 1:
- 1.0 = Highly relevant, directly answers the query
- 0.7 = Somewhat relevant, contains related information
- 0.3 = Marginally relevant, tangentially related
- 0.0 = Not relevant at all

Output ONLY the number, nothing else.""",
            ),
            (
                "human",
                """Query: {query}

Document: {document}

Relevance score (0-1):""",
            ),
        ]
    )

    # Grade each document and calculate average
    scores = []
    relevant_docs = []

    for doc in documents:
        chain = grading_prompt | llm
        result = chain.invoke({"query": query, "document": doc.page_content})

        try:
            score = float(result.content.strip())
        except ValueError:
            score = 0.5  # Default if parsing fails

        scores.append(score)
        print(f"  - {doc.metadata.get('source', 'unknown')}: {score:.2f}")

        if score >= 0.5:  # Keep documents with score >= 0.5
            relevant_docs.append(doc)

    avg_score = sum(scores) / len(scores) if scores else 0
    print(f"[GRADE] Average relevance: {avg_score:.2f}")
    print(f"[GRADE] Keeping {len(relevant_docs)}/{len(documents)} documents")

    return {"documents": relevant_docs, "relevance_score": avg_score}
06:47:09 «La evaluación no es más que hacer un prompt a nuestro modelo de lenguaje para que se convierta en un grader».
Esa es la desmitificación que merece la pena conservar. No hay clasificador, ni fine-tuning, ni modelo cross-encoder. Es un system prompt con una rúbrica de cuatro niveles — 1.0 / 0.7 / 0.3 / 0.0 —, la instrucción de no emitir nada más que un número y float() sobre el resultado. temperature=0, porque un grader que da respuestas distintas al mismo par no es un grader.
Un score, dos trabajos distintos. El float que vuelve se usa dos veces con el mismo umbral de 0.5 pero con una semántica completamente distinta, y confundirlas es un error habitual:
- Filtrado (por documento):
if score >= 0.5: relevant_docs.append(doc). El contexto a partir del cual
acabas generando contiene solo a los supervivientes. Es un filtro de precision — el modo de fallo #3 de la Parte 6, el ruido del retrieval, resuelto en tiempo de query en lugar de en tiempo de indexación.
- Enrutamiento (agregado):
avg_scoresobre todos los documentos se convierte enrelevance_score, y el
router compara ese valor con 0.5. Es una señal de salud del intento de retrieval en su conjunto.
El instructor narra el filtro en directo en 06:56:20: «estos dos están muy altos, este es cero, así que no me voy a quedar con los tres».
3. rewrite — «el cerebro»
06:47:09 «Este es el cerebro… vale, algo no va bien. Volvamos atrás y reescribamos las cosas».
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 209-252)
def rewrite_query(state: RAGState) -> dict:
    """
    Rewrite the query to improve retrieval.
    Called when initial retrieval doesn't find relevant documents.
    """
    query = state["query"]
    retry_count = state.get("retry_count", 0)

    print(f"\n[REWRITE] Attempt {retry_count + 1}: Improving query...")

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.3)

    rewrite_prompt = ChatPromptTemplate.from_messages(
        [
            (
                "system",
                """You are a query rewriter for a RAG system.
The original query didn't retrieve relevant documents.

Rewrite the query to be more specific and likely to match relevant documents.
Consider:
- Adding synonyms or related terms
- Being more specific about what information is needed
- Rephrasing to match how documentation is typically written

Output ONLY the rewritten query, nothing else.""",
            ),
            (
                "human",
                """Original query: {query}

Rewritten query:""",
            ),
        ]
    )

    chain = rewrite_prompt | llm
    result = chain.invoke({"query": query})
    rewritten = result.content.strip()

    print(f"[REWRITE] Original: '{query}'")
    print(f"[REWRITE] Rewritten: '{rewritten}'")

    return {"rewritten_query": rewritten, "retry_count": retry_count + 1}
temperature=0.3 — la única temperatura distinta de cero en todo el archivo. La evaluación y la generación son deterministas; la reescritura, a propósito, no, porque una reescritura idéntica cada vez es un retry que no puede encontrar nada nuevo.
La rúbrica tiene tres cláusulas, y la tercera es la interesante: «Reformular para que encaje con cómo suele estar escrita la documentación». Es un ataque directo y deliberado al modo de fallo de desajuste de embeddings — el modo de fallo #2 de la Parte 1, diseccionado en la Parte 5: el usuario escribe «cómo cancelo», el documento dice «política de rescisión» y los vectores nunca se encuentran. Reescribir es un intento de traducir del lenguaje de las preguntas al lenguaje de los documentos.
Este nodo también es dueño de la condición de terminación: retry_count + 1. Si olvidas ese incremento, tu grafo entra en un bucle infinito — hasta que el propio límite de recursión de LangGraph aborta la ejecución con un error que tendrás que ir a leer en el traceback para entenderlo.
4. generate — generación RAG corriente, al final de un bucle
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 255-302, prints elided)
def generate_answer(state: RAGState) -> dict:
    """
    Generate the final answer using retrieved documents.
    """
    query = state["query"]
    documents = state["documents"]

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    # Format documents
    context = "\n\n".join(
        [
            f"Source: {doc.metadata.get('source', 'unknown')}\n{doc.page_content}"
            for doc in documents
        ]
    )

    generate_prompt = ChatPromptTemplate.from_messages(
        [
            (
                "system",
                """You are a helpful assistant answering questions based on provided context.

Use ONLY the information in the context to answer. If the context doesn't contain
enough information, say so clearly.

Always cite your sources by mentioning which document the information came from.""",
            ),
            (
                "human",
                """Context:
{context}

Question: {query}

Answer:""",
            ),
        ]
    )

    chain = generate_prompt | llm
    result = chain.invoke({"context": context, "query": query})

    return {"generation": result.content}
Aquí no hay nada agéntico — es el patrón de prompt anti-alucinaciones de la Parte 1 haciendo su trabajo al final de un pipeline más largo. Hay dos detalles que sostienen todo:
Source: <source>se antepone a cada bloque de contexto. Citar solo es posible si
los nombres de las fuentes están físicamente dentro del texto que lee el modelo. Las fuentes viajan dentro de la cadena de contexto, nunca por un canal aparte — la misma regla que en la Parte 1.
- «Use ONLY the information in the context» + «Always cite your sources». La cláusula
de restricción y la instrucción de citar. En la ejecución grabada funcionan: la respuesta final de la query 1 termina con (source: langgraph_install.md).
Fíjate en que este nodo genera a partir de state["documents"] — que el grader ya ha sustituido por los supervivientes filtrados. generate nunca ve los documentos rechazados.
5. fallback — un fallo deliberado y elegante
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 305-322)
def generate_fallback(state: RAGState) -> dict:
    """
    Generate a fallback response when retrieval fails after all retries.
    """
    query = state["query"]

    print(f"\n[FALLBACK] Retrieval failed after {state.get('retry_count', 0)} attempts")

    fallback_message = f"""I couldn't find relevant information to answer your question: "{query}"

This could mean:
1. The information isn't in my knowledge base
2. Try rephrasing your question with different terms
3. The topic might not be covered in the available documents

Would you like to try a different question?"""

    return {"generation": fallback_message}
06:55:20 «Estamos fallando con elegancia. Esto es muy importante».
La propiedad más importante de este nodo: no es una llamada al LLM. Es un f-string. Eso significa que no cuesta nada, no añade latencia y — algo crucial — no puede alucinar. El único camino en el que has establecido de forma definitiva que no tienes base documental es el último sitio donde quieres a un modelo de lenguaje improvisando.
Además, como UX hace bien dos cosas: dice por qué (no está en la base de conocimiento) y qué hacer (reformular). Compáralo con la alternativa que la demo de la pizza habría producido si no — una respuesta sobre pizza sintetizada a partir de tres documentos sobre Guido van Rossum.
El router: la encrucijada
06:49:13 «Ah, esta es la encrucijada».
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 330-363)
def should_retry_or_generate(
    state: RAGState,
) -> Literal["rewrite", "generate", "fallback"]:
    """
    Decide whether to retry retrieval or proceed to generation.

    This is the BRAIN of agentic RAG - making decisions based on retrieval quality.
    """
    relevance_score = state.get("relevance_score", 0)
    retry_count = state.get("retry_count", 0)
    max_retries = state.get("max_retries", 2)
    documents = state.get("documents", [])

    print(
        f"\n[ROUTER] Evaluating: score={relevance_score:.2f}, retries={retry_count}/{max_retries}, docs={len(documents)}"
    )

    # If we have relevant documents, generate
    if relevance_score >= 0.5 and len(documents) > 0:
        print("[ROUTER] -> GENERATE (good relevance)")
        return "generate"

    # If we can retry, rewrite query
    if retry_count < max_retries:
        print("[ROUTER] -> REWRITE (low relevance, retrying)")
        return "rewrite"

    # Out of retries
    if len(documents) > 0:
        print("[ROUTER] -> GENERATE (out of retries, using available docs)")
        return "generate"
    else:
        print("[ROUTER] -> FALLBACK (no relevant documents)")
        return "fallback"
Las cuatro ramas, por orden de prioridad:
| # | Condición | Destino | Razonamiento |
|---|---|---|---|
| 1 | relevance_score >= 0.5 y len(documents) > 0 | generate | Buen retrieval — responde |
| 2 | retry_count < max_retries | rewrite | Mal retrieval, queda presupuesto — prueba con una query mejor |
| 3 | len(documents) > 0 | generate | Sin presupuesto, pero algo ha sobrevivido al filtro |
| 4 | en otro caso | fallback | Sin presupuesto y sin nada — dilo con honestidad |
La rama 3 es la sutil, y el instructor la señala en 06:50:13: «sin retries, vamos directos a generate porque no podemos volver a reintentar».
Degrada antes de rendirte. Una respuesta mediocre a partir de documentos mediocres pero supervivientes es mejor que ninguna respuesta — pero solo después de haber gastado el presupuesto de retries, nunca antes. La rama 3 está por debajo de la rama 2 en prioridad justo por eso.
Dos observaciones que el capítulo no hace explícitamente pero que importan muchísimo en producción:
El router es Python puro, no un LLM. El capítulo no deja de llamarlo «el cerebro», y el comentario del código dice «Este es el CEREBRO del agentic RAG». Pero el juicio vive en grade (un LLM); la decisión es lógica if determinista sobre el estado. Esa separación es precisamente lo que hace que este bucle sea depurable, testeable y acotado. Puedes hacer tests unitarios de should_retry_or_generate con un diccionario y sin API key. Mantenlo así — en el momento en que un modelo decide tu flujo de control, tu flujo de control deja de ser reproducible.
Todo lo que necesita el router ya está en el estado. 06:50:13 «todo esto se ha guardado en este cerebro que sigue ahí y al que todos estos nodos pueden… conectarse directamente». El router no recibe más argumento que el estado y no llama a nada. Esa es la recompensa del diseño del estado como memoria.
Cablear el grafo
Los nodos existen aislados hasta que los conectas. 06:51:14 «Una vez que tenemos esos nodos, en este punto no están conectados. Tenemos que conectarlos».
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 371-415)
def build_agentic_rag_graph():
    """
    Build the LangGraph workflow for agentic RAG.

    Flow:
    1. retrieve -> grade -> [decision]
    2. If low relevance and retries left: rewrite -> retrieve (loop)
    3. If good relevance or out of retries: generate
    4. If no documents at all: fallback
    """

    # Create the graph with our state schema
    workflow = StateGraph(RAGState)

    # Add nodes
    workflow.add_node("retrieve", retrieve_documents)
    workflow.add_node("grade", grade_documents)
    workflow.add_node("rewrite", rewrite_query)
    workflow.add_node("generate", generate_answer)
    workflow.add_node("fallback", generate_fallback)

    # Set entry point
    workflow.set_entry_point("retrieve")

    # Add edges
    workflow.add_edge("retrieve", "grade")

    # Conditional edge from grade
    workflow.add_conditional_edges(
        "grade",
        should_retry_or_generate,
        {"rewrite": "rewrite", "generate": "generate", "fallback": "fallback"},
    )

    # After rewrite, go back to retrieve
    workflow.add_edge("rewrite", "retrieve")

    # Terminal nodes
    workflow.add_edge("generate", END)
    workflow.add_edge("fallback", END)

    # Compile the graph
    app = workflow.compile()

    return app
Los once pasos, como un procedimiento que puedes trasplantar a cualquier grafo autocorrectivo:
- Define el esquema del estado como un
TypedDictcon todos los campos que cualquier nodo vaya a leer o escribir. - Escribe cada nodo como
f(state) -> dict, devolviendo solo lo que ha cambiado. - Escribe el router como una función normal que devuelve un
Literal[...]de claves de destino. workflow = StateGraph(RAGState)— pasa la clase, no una instancia.add_node(name, fn)para cada nodo. Todavía no hay nada conectado.set_entry_point("retrieve")— el grafo no tiene un inicio por defecto.add_edge("retrieve", "grade")— un salto incondicional.add_conditional_edges(source, router_fn, {returned_string: destination_node}).add_edge("rewrite", "retrieve")— esta única línea crea el ciclo.add_edge("generate", END)yadd_edge("fallback", END).app = workflow.compile()y luegoapp.invoke(initial_state).
El paso 9 es toda la lección comprimida en una línea:
El ciclo es una arista corriente. No hay ninguna construcción especial de «bucle».
add_edge("rewrite", "retrieve")convierte un DAG en un grafo con un ciclo, y todo lo demás — el estado, los contadores, el router — es la contabilidad necesaria para que ese ciclo termine.
compile() devuelve un Runnable con la misma interfaz que cualquier chain de LCEL, lo que significa que el grafo compilado encaja en el resto de tu stack (handler de FastAPI, wrapper de retry, callbacks de tracing) sin casos especiales.
El grafo ASCII que imprime el script (líneas 485-525) — vale la pena tenerlo en tus propios grafos
ASCII original
    ┌─────────────────────────────────────────────────────────────┐
    │                      START                                  │
    └─────────────────────────┬───────────────────────────────────┘
                              │
                              ▼
                    ┌─────────────────┐
                    │    RETRIEVE     │
                    │  (get docs from │
                    │   vectorstore)  │
                    └────────┬────────┘
                             │
                             ▼
                    ┌─────────────────┐
                    │     GRADE       │
                    │ (LLM evaluates  │
                    │   relevance)    │
                    └────────┬────────┘
                             │
              ┌──────────────┼──────────────┐
              │              │              │
     (low relevance,   (good relevance)  (no docs,
      can retry)                         out of retries)
              │              │              │
              ▼              ▼              ▼
    ┌─────────────┐  ┌─────────────┐  ┌─────────────┐
    │   REWRITE   │  │  GENERATE   │  │  FALLBACK   │
    │ (improve    │  │  (create    │  │  (graceful  │
    │   query)    │  │   answer)   │  │   failure)  │
    └──────┬──────┘  └──────┬──────┘  └──────┬──────┘
           │                │                │
           │                ▼                ▼
           │         ┌─────────────────────────┐
           │         │          END            │
           │         └─────────────────────────┘
           │
           └──────────► (back to RETRIEVE)

    KEY INSIGHT: The loop between REWRITE → RETRIEVE → GRADE
    allows the system to self-correct and improve retrieval!
LangGraph también te lo puede generar: app.get_graph().draw_mermaid() imprime el código Mermaid y app.get_graph().draw_mermaid_png() devuelve los bytes de un PNG — ambos se usan a lo largo de langgraph_core.py, conditional_edges.py y cycles_loops.py. Renderiza el grafo real en CI y compara el diff; un diagrama dibujado a mano se queda desfasado, uno generado no puede.
El resumen del instructor sobre ese recuadro, en 06:56:20:
«Entre rewrite, retrieve y grade — esto es lo que realmente hace que el sistema sea un sistema autocorrectivo».
Ejecutarlo
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 445-467)
    for query in test_queries:
        print("\n" + "=" * 60)
        print(f"QUERY: {query}")
        print("=" * 60)

        # Run the graph
        initial_state = {
            "query": query,
            "rewritten_query": "",
            "documents": [],
            "generation": "",
            "relevance_score": 0.0,
            "retry_count": 0,
            "max_retries": 2,
            "_vectorstore": vectorstore,  # Pass vectorstore via state
        }

        result = app.invoke(initial_state)

        print("\n" + "-" * 60)
        print("FINAL ANSWER:")
        print("-" * 60)
        print(result["generation"])
Inicializa todos los campos. rewritten_query: "", documents: [], generation: "", relevance_score: 0.0, retry_count: 0, max_retries: 2. Los nodos que usan state["x"] en lugar de state.get("x") lanzarán un KeyError con un estado parcialmente poblado, y TypedDict no obliga a que las claves estén presentes — las que faltan simplemente no existen en tiempo de ejecución. Construye el grafo una vez y reutilízalo entre queries; lo único que va por request es el estado.
El corpus de la demo son cinco documentos, elegidos de forma que tres son pertinentes y dos son puros distractores:
source | topic | Contenido |
|---|---|---|
langgraph_docs.md | langgraph | LangGraph = apps LLM multiactor con estado; extiende LangChain con grafos cíclicos; persistencia, streaming y human-in-the-loop integrados |
langgraph_install.md | installation | pip install langgraph>=1.1.0; requiere Python 3.10 o superior; funciona con LangChain 1.x; síncrono y asíncrono |
langgraph_concepts.md | stategraph | StateGraph = abstracción central; los nodos procesan el estado, las aristas son transiciones; las aristas condicionales bifurcan según los valores del estado; el grafo se compila en un workflow ejecutable |
weather.md | weather | Seattle: invierno lluvioso, verano suave; de 40°F en enero a 75°F en julio; unas 37 pulgadas de lluvia al año |
python_history.md | python | Python, creado por Guido van Rossum, publicado por primera vez en 1991 |
Embebidos con text-embedding-3-small en una colección de Chroma llamada agentic_rag_demo. Los tres roles de LLM usan gpt-4o-mini.
Tres queries de prueba, elegidas a propósito para recorrer las tres salidas:
    test_queries = [
        "How do I install LangGraph?",  # Should find relevant docs
        "What is StateGraph in LangGraph?",  # Should find relevant docs
        "How do I make pizza?",  # Should NOT find relevant docs (tests fallback)
    ]
06:57:22 «¿Cómo hago una pizza? Esto lo va a desbaratar todo, que es justo lo que necesitamos ver».
Query 1 — camino feliz con un filtrado parcial.
[RETRIEVE] Found 3 documents
  1. langgraph_install.md   2. langgraph_install.md   3. langgraph_docs.md
[GRADE] langgraph_install.md: 1.00 | langgraph_install.md: 1.00 | langgraph_docs.md: 0.00
[GRADE] Average relevance: 0.67
[GRADE] Keeping 2/3 documents
[ROUTER] Evaluating: score=0.67, retries=0/2, docs=2
[ROUTER] -> GENERATE (good relevance)
[GENERATE] Creating answer from 2 documents...
La respuesta final menciona pip install langgraph>=1.1.0, Python 3.10+, LangChain 1.x, y termina con (source: langgraph_install.md) — la instrucción de citar ha funcionado.
El número interesante es langgraph_docs.md: 0.00. Ese documento trata sobre LangGraph. Ha sacado cero en una pregunta de instalación porque el grader puntúa la relevancia para la respuesta, no la relevancia temática — se pregunta «¿contiene esto información que responda a esta query?», no «¿trata del mismo tema?». Es exactamente el comportamiento que quieres de un grader, y es una prueba más fina que la similitud coseno que recuperó el documento en primer lugar.
El grader es un segundo filtro, semánticamente más estricto, aplicado después del filtro laxo del vector store. Por eso atrapa el ruido que también atraparía el reranking — y por eso, si ya tienes un reranker cross-encoder de la Parte 6, deberías preguntarte si necesitas los dos.
Query 2 — todo relevante. Los tres resultados son langgraph_concepts.md, todos sacan 1.00, no se filtra nada y el router genera en la primera pasada:
[GRADE] langgraph_concepts.md: 1.00 ×3
[GRADE] Average relevance: 1.00 | Keeping 3/3 documents
[ROUTER] Evaluating: score=1.00, retries=0/2, docs=3  ->  GENERATE (good relevance)
La respuesta parafrasea ese documento con fidelidad — los nodos como funciones que procesan el estado, las aristas como transiciones, las aristas condicionales bifurcando según los valores del estado.
Query 3 — el camino de fallo completo.
attempt 0: [RETRIEVE] Found 3 documents → python_history.md ×3
           [GRADE] 0.00, 0.00, 0.00 | Average relevance: 0.00 | Keeping 0/3
           [ROUTER] score=0.00, retries=0/2, docs=0  ->  REWRITE (low relevance, retrying)
[REWRITE] Attempt 1: Original: 'How do I make pizza?'
          Rewritten: 'What are the step-by-step instructions for making homemade pizza,
                      including dough preparation, sauce recipes, and topping suggestions?'
attempt 1: same 3 docs, 0.00 each, Keeping 0/3
           [ROUTER] score=0.00, retries=1/2, docs=0  ->  REWRITE (low relevance, retrying)
[REWRITE] Attempt 2: Original: 'How do I make pizza?'
          Rewritten: 'What are the step-by-step instructions and essential ingredients for
                      making homemade pizza from scratch?'
attempt 2: same 3 docs, 0.00 each, Keeping 0/3
           [ROUTER] score=0.00, retries=2/2, docs=0  ->  FALLBACK (no relevant documents)
[FALLBACK] Retrieval failed after 2 attempts
FINAL ANSWER: I couldn't find relevant information to answer your question: "How do I make pizza?"
Lee esas reescrituras con atención. Son buenas queries. Si existiera un corpus sobre pizza, cualquiera de las dos recuperaría de él. El bucle funciona exactamente como se diseñó — y aun así falla, porque en la base de conocimiento no hay pizza. 06:59:23 «Esta es la autocorrección de la que hablamos».
Y nada de esa trace se orquestó a mano. 07:01:26 «Esto es automático, autónomo, porque el agente es capaz de gestionar todo eso». Tres retrievals, dos reescrituras, nueve evaluaciones y una salida elegante salieron de una sola llamada a app.invoke(initial_state).
El coste completo de esa única pregunta sin respuesta: 3 retrievals, 9 llamadas al LLM para evaluar, 2 llamadas al LLM para reescribir, 3 embeddings de query — para producir una cadena fija. Lo que nos lleva a la factura.
La factura: latencia y coste, contados con honestidad
El capítulo reconoce con franqueza que el bucle cuesta dinero — 07:01:26 «cada vez que se producen estas llamadas, recuerda que estás llamando al embedding, estás llamando a un modelo de lenguaje grande» — pero nunca lo cuantifica. Aquí tienes las cuentas, derivadas del código en lugar de afirmadas.
Sea k el k del retriever (3 aquí) y R el número de retries realmente efectuados (de 0 a max_retries, 2 por defecto).
| Tarea | RAG de una pasada | Este grafo agéntico |
|---|---|---|
| Embeddings de query | 1 | 1 + R |
| Búsquedas vectoriales | 1 | 1 + R |
| Llamadas al LLM para evaluar | 0 | k × (1 + R) |
| Llamadas al LLM para reescribir | 0 | R |
| Llamadas al LLM para generar | 1 | 1 (o 0 en el camino de fallback) |
| Total de llamadas al LLM | 1 | k(1+R) + R + 1 (una menos en el camino de fallback) |
Sustituyendo los valores por defecto k=3, max_retries=2:
| Escenario | Llamadas al LLM | Ida y vuelta secuenciales antes del primer token de respuesta |
|---|---|---|
Camino feliz (R=0) | 3 evaluaciones + 1 generación = 4 | 1 retrieval + 3 evaluaciones en serie (1 si haces batching) + generación |
Un retry (R=1) | 6 evaluaciones + 1 reescritura + 1 generación = 8 | 2 retrievals + 2 rondas de evaluación + 1 reescritura + generación |
Fallo completo (R=2) | 9 evaluaciones + 2 reescrituras + 0 generaciones = 11 | 3 retrievals + 3 rondas de evaluación + 2 reescrituras |
Tres consecuencias que deberías interiorizar:
- El camino feliz ya supone 4× las llamadas al LLM del RAG de una pasada, antes de que haya ningún retry.
Todas y cada una de las queries pagan la evaluación, incluido «hola».
- El camino de fallo es el camino más caro. Eso invierte la economía habitual: en un
sistema de una pasada, un retrieval fallido cuesta lo mismo que uno con éxito. Aquí, las queries que tu sistema no puede responder son las que más cuestan. Si una parte significativa de tu tráfico cae fuera del corpus, presupuéstalo.
- En esta implementación, las llamadas de evaluación son en serie. El bucle
for doc in documentshace
k idas y vueltas bloqueantes. Mete ahí tu propia latencia medida por llamada: cueste lo que te cueste una evaluación con gpt-4o-mini, el camino feliz la paga tres veces antes de que empiece la generación, y el camino de fallo acumula once idas y vueltas al LLM en serie antes de que el usuario vea una cadena fija. Mídelo en tu entorno antes de decidir si es tolerable.
El bug del código publicado
Es el defecto más instructivo de todo el repo fuente, así que tiene su propia sección.
Vuelve a mirar estas dos líneas, en retrieve_documents:
    vectorstore = state.get("_vectorstore")  # Injected at runtime
    if not vectorstore:
        # Fallback - create new (in production, pass via config)
        vectorstore = create_sample_vectorstore()
y el estado inicial:
"_vectorstore": vectorstore, # Pass vectorstore via state
_vectorstore no está declarado en el TypedDict RAGState. LangGraph construye sus canales de estado a partir del esquema, así que una clave que no está en el esquema se descarta. Por tanto, state.get("_vectorstore") devuelve None en cada llamada, la rama de «fallback» se dispara siempre y create_sample_vectorstore() vuelve a hacer embedding e insertar los cinco documentos de ejemplo. Como el cliente efímero en proceso de Chroma se cachea por configuración, cada una de esas inserciones acaba en la misma colección agentic_rag_demo, que crece de forma monótona durante toda la vida del proceso.
La ejecución grabada lo demuestra, y este es el detalle que hace que el diagnóstico sea irrebatible:
- Top-3 de la query 1:
langgraph_install.md,langgraph_install.md,langgraph_docs.md— el
documento de instalación dos veces.
- Top-3 de la query 2:
langgraph_concepts.mdtres veces. - Top-3 de la query 3:
python_history.mdtres veces.
El corpus contiene cada uno de esos archivos exactamente una vez. El número de duplicados crece en uno por cada llamada a retrieve, porque cada llamada inserta otra copia.
Consecuencias, de menor a mayor gravedad:
k=3está devolviendo un único documento disfrazado de tres.- Pagas por hacer embedding de cinco documentos en cada retrieval, un coste oculto por vuelta que la
tabla de costes de arriba ni siquiera incluye.
relevance_scorees una media sobre duplicados. Tres copias de un documento perfecto
dan una media de 1.00; un documento perfecto más dos distractores dan 0.33. El bug distorsiona el enrutamiento, lo que significa que distorsiona justo las decisiones que el capítulo está enseñando.
La solución es una de dos, y el comentario del código te dice cuál es la correcta:
# Option A (minimal): declare it, so LangGraph keeps it.
class RAGState(TypedDict):
    ...
    _vectorstore: object   # or a proper VectorStore type

# Option B (better, and what the comment "in production, pass via config" means):
# don't put a live client in state at all. Close over it, or pass it through
# RunnableConfig, and delete the create-new fallback so a missing store fails LOUDLY.
def make_retrieve_node(vectorstore, k: int = 3):
    def retrieve_documents(state: RAGState) -> dict:
        query = state.get("rewritten_query") or state["query"]
        retriever = vectorstore.as_retriever(search_kwargs={"k": k})
        return {"documents": retriever.invoke(query)}

    return retrieve_documents
El estado es para datos, no para handles. Los checkpointers serializan el estado, los tracers lo comparan y se copia entre nodos. Un cliente de base de datos vivo no pinta nada ahí. Inyecta los clientes mediante closure o config; deja en el estado solo cosas que te parecería bien ver en un log JSON.
Y la metalección, que es más grande que este bug: un fallback silencioso ocultó una inyección rota durante toda una lección grabada. if not vectorstore: build one es exactamente el tipo de rama defensiva que convierte un AttributeError ruidoso en una respuesta incorrecta silenciosa. Es otra vez el invariante 4, esta vez dentro de tu propio código de orquestación.
El resto de trampas
| # | Trampa | Por qué muerde | Qué hacer |
|---|---|---|---|
| G2 | rewrite siempre reescribe state["query"], nunca la reescritura anterior | El intento 2 es una nueva tirada independiente, no un refinamiento | Mete las reescrituras anteriores + sus scores en el prompt |
| G3 | Una llamada al LLM de evaluación por documento y por intento | k=3, R=2 → 9 llamadas de evaluación para un fallo | Agrupa en batch, paraleliza, corta antes o usa un reranker |
| G4 | except ValueError: score = 0.5 | Una nota mal formada cae justo en el umbral de conservación | Falla cerrado con 0.0; loguea la respuesta en bruto |
| G5 | grade sobrescribe documents con la lista filtrada | Los documentos rechazados desaparecen del estado para siempre | Escribe los supervivientes en una clave nueva; conserva el conjunto en bruto para depurar |
| G6 | La evaluación siempre usa la query original, incluso después de una reescritura | Una reescritura que encuentra documentos que encajan con la formulación nueva todavía puede sacar un 0 frente a la antigua | Defendible en ambos sentidos — decídelo a conciencia y coméntalo |
| G7 | set_entry_point("retrieve") significa que todas las queries hacen retrieval | «hola» cuesta un retrieval + k llamadas de evaluación | Añade un primer nodo de decisión de verdad, o un gate barato (Parte 11) delante del grafo |
| G12 | Código muerto en el archivo de la lección: import os sin usar, Annotated y from operator import add sin usar, from langchain_chroma import Chroma duplicado en las líneas 21–22 | Inofensivo, pero son restos de copiar y pegar | No lo copies a ciegas |
| G13 | vectorstore.delete_collection() solo se ejecuta si todo va bien | Una excepción a mitad de la demo deja la colección poblada para la siguiente ejecución | try/finally, o un persist_directory nuevo en cada ejecución |
Dos más que el capítulo no menciona pero con las que te vas a topar:
- El grafo no tiene timeout global.
max_retriesacota el número de vueltas, no el tiempo
real. Un LLM lento convierte un bucle acotado en una latencia sin cota. Pon un deadline a todo el app.invoke y degrada a la cadena de fallback cuando salte.
- Nadie evalúa al grader. Nada en este capítulo comprueba si los scores de
gpt-4o-mini
(0/0.3/0.7/1.0) están calibrados frente al juicio humano. Toda tu lógica de enrutamiento se apoya en la opinión de ese modelo. Toma una muestra de cincuenta pares (query, documento), etiquétalos tú mismo y mide el grado de acuerdo antes de confiarle a un umbral de 0.5 el tráfico de producción.
El mismo bucle, generalizado
La versión RAG es una instancia de un patrón que aparece por todas partes en cuanto tienes un StateGraph. El repo hermano tiene dos más, y compararlas enseña algo que la versión RAG por sí sola no puede.
Un bucle de refinamiento de calidad — misma forma, evaluador LLM, umbral de score más un tope de iteraciones:
# production-course-main-code/conditional_edges.py  (lines 131-152)
    def should_continue(state: QualityState) -> Literal["improve", "finalize"]:
        if state["quality_score"] >= 7:
            return "finalize"
        elif state["iteration"] >= 3:
            return "finalize"  # Max iterations
        else:
            return "improve"

    graph = StateGraph(QualityState)

    graph.add_node("evaluate", evaluate_quality)
    graph.add_node("improve", improve_content)
    graph.add_node("finalize", finalize_content)

    graph.add_edge(START, "evaluate")

    graph.add_conditional_edges(
        "evaluate", should_continue, {"improve": "improve", "finalize": "finalize"}
    )

    graph.add_edge("improve", "evaluate")  # Loop back!
    graph.add_edge("finalize", END)
Esqueleto idéntico: evaluar → enrutar → {mejorar y repetir | finalizar}. Fíjate en que tiene la misma vía de escape con dos condiciones — calidad alcanzada o presupuesto agotado — y fíjate también en que iteration solo se incrementa en improve, así que evaluate repite su llamada al LLM en cada pasada. El mismo perfil de coste que nuestro grader.
Un generador de código autocorrectivo — y este es más interesante, porque su evaluador no es un LLM:
# production-course-main-code/cycles_loops.py  (lines 54-93, abridged)
    def validate_code(state: CodeGenState) -> dict:
        code = state["code"]

        # Step 1: Does it compile?
        try:
            compile(code, "<string>", "exec")
        except SyntaxError as e:
            return {"errors": [f"SyntaxError: {e}"], "success": False}

        # Step 2: Does it RUN and produce correct results?
        test_cases = [
            ([3, 1, 4, 1, 5, 9], 5),  # normal case
            ([1, 1, 1], None),  # all same → no second largest
            ([7], None),  # single element
            ([3, -1, 3, 5, 5], 3),  # duplicates at top
        ]
        ...
        return {"success": True}
Y, algo crucial, su nodo generador lee el error anterior:
# production-course-main-code/cycles_loops.py  (lines 31-52, abridged)
    def generate_code(state: CodeGenState) -> dict:
        if state["iteration"] == 0:
            # First attempt
            prompt = f"Write Python code for: {state['task']}\nReturn only the code."
        else:
            # Correction attempt
            prompt = (
                f"Fix this Python code:\n{state['code']}\n\n"
                f"Errors:\n{state['errors'][-1]}\n\n"
                "Return only the corrected code."
            )
        ...
        return {"code": code, "iteration": state["iteration"] + 1}
Eso es lo que le falta al nodo rewrite del RAG (trampa G2). El retry del bucle de código está informado: sabe exactamente qué falló la última vez y se le pide que lo arregle. El retry del bucle RAG va a ciegas: vuelve a tirar la query original y cruza los dedos.
Una advertencia antes de copiar este archivo entero: sus fixtures se han desviado. La tarea que invoca es «una función que calcula el factorial de forma recursiva», mientras que validate_code busca una función llamada solve y comprueba el comportamiento de «segundo elemento más grande» — un arnés que no puede pasar nunca. demo_self_correcting_code() está comentada en __main__, así que nadie se dio cuenta. Un evaluador determinista solo es tan bueno como su concordancia con la tarea; y esa concordancia es en sí misma algo que tienes que testear.
De esta comparación salen dos reglas, y son lo más trasladable de esta parte: 1. Prefiere un evaluador determinista siempre que exista.
compile()más un puñado de casos de prueba no cuesta nada, nunca alucina y nunca necesita calibración. Un grader LLM es lo que usas cuando — como en el juicio de relevancia — no existe ninguna comprobación determinista barata. 2. Devuelve el fallo al retry. Un retry que no sabe por qué falló el intento anterior es una tragaperras con un contador de tokens enchufado.
Lo que esta lección deja fuera, y lo que necesita producción
El propio corpus de la demo anuncia tres funcionalidades de LangGraph que la lección luego nunca usa — persistencia, streaming y human-in-the-loop. No es casualidad de redacción; son justo las funcionalidades que convierten este grafo en un producto.
| Pieza que falta | Por qué la necesitas | Dónde está |
|---|---|---|
| Checkpointing | Reanudar un bucle largo tras un crash; memoria por conversación; depuración con viaje en el tiempo de un retry | graph.compile(checkpointer=MemorySaver()) o SqliteSaver.from_conn_string(db_path), con config={"configurable": {"thread_id": "user-123"}} — production-course-main-code/checkpointing.py |
| Human-in-the-loop | Interrumpir antes de un nodo caro o irreversible y preguntar a una persona | production-course-main-code/human_in_loop.py |
| Streaming por nodo | El usuario ve «buscando… evaluando… reescribiendo…» en lugar de un largo silencio — la mejor mitigación posible de la latencia que añade este patrón | APIs de streaming de LangGraph (no cubiertas en el curso) |
| Tracing del bucle | Ver qué rama tomó cada query, y cuántos retries | LangSmith, Parte 7 |
| Varias herramientas de retrieval | Patrón 4 — escalar la estrategia, no solo la formulación | production-course-main-code/advanced_rag.py: retrievers MultiQuery, ContextualCompression, Ensemble(BM25), ParentDocument |
| Descomposición en varios pasos | Patrón 3 — partir una pregunta compuesta en subqueries y hacer retrieval para cada una | Se afirma en 06:41:44, no se implementa en ningún sitio |
| Evals del grader | Nadie valida la calibración del grader | El pilar de evals, Parte 7 |
De todas ellas, el streaming por nodo merece un énfasis especial. El coste honesto del agentic RAG es la latencia, y la forma más barata de hacer tolerable una respuesta lenta es enseñarle al usuario el bucle trabajando. LangGraph te da streaming a nivel de nodo gratis en cuanto tu flujo de control es un grafo — lo cual es, de forma circular, una de las mejores razones para haberlo construido como un grafo.
Cuándo usarlo — y cuándo no
El script imprime sus propias seis conclusiones en 07:02:28, y son un resumen justo de todo lo anterior:
- El RAG tradicional es de una pasada: retrieve → generate
- El agentic RAG añade evaluación y bucles de retry
- El
StateGraphde LangGraph permite workflows cíclicos - Patrón clave: retrieve → grade → [rewrite si hace falta] → generate
- Fallback elegante cuando el retrieval falla por completo
- Este es EL patrón de RAG en producción para 2026
Sobre el #3, el comentario del propio instructor en 07:02:28: los workflows cíclicos significan que el grafo «puede ir y reintentar, ir y volver hasta que se cumpla algo — y entonces sale del bucle». El «hasta que se cumpla algo» es lo que sostiene toda esa frase, y es lo que garantiza max_retries.
Los cuatro criterios los imprime el propio script en 07:03:30, con el comentario del instructor:
| Criterio | Qué significa en la práctica |
|---|---|
| Queries complejas que pueden necesitar reformulación | Los usuarios escriben las preguntas con su propio vocabulario y tus documentos usan otro |
| Aplicaciones críticas en las que importa la calidad de la respuesta | «Pongamos que construyes sobre documentos legales o cosas que tienen que ser precisas» — legal, compliance, médico |
| Cuando tienes tipos de documentos diversos | «Documentos legales, guías de algún tipo, instrucciones — todos esos tipos distintos de documentos» — una única estrategia de retrieval no les va a servir a todos |
| Aplicaciones de cara al usuario (frente a procesamiento por batch) | Hay una persona esperando que juzgará la respuesta; en batch, nadie ve el fallo en tiempo real y puedes reintentar offline gratis |
Y el caso contrario, dicho con la misma claridad 07:03:30: «Si estás construyendo algo muy sencillo — obviamente aquí solo estamos probando cosas — no necesitas realmente agentic RAG».
Una matriz de decisión que junta las dos cosas:
| Tu situación | Veredicto |
|---|---|
| Corpus homogéneo, los usuarios comparten su vocabulario, calidad del retrieval ya medida como buena | Una pasada. El bucle casi nunca se disparará y pagarás la evaluación en cada query igualmente |
| Sensible a la latencia (chat con un p95 estricto, autocompletado, voz) | Una pasada, o agéntico con streaming por nodo y max_retries=1 |
| Pipelines batch / offline | Una pasada por ejecución; haz retry a nivel de job, donde los retries son baratos |
| Los fallos son huecos de cobertura (la respuesta de verdad no está en el corpus) | Arregla el corpus. El bucle hace esos fallos más caros, no menos frecuentes |
| Los fallos son huecos de vocabulario (la respuesta está, pero formulada de otra manera) | Agéntico — esto es exactamente lo que arregla |
| Crítico, de cara al usuario, tipos de documentos diversos | Agéntico, con un presupuesto estricto y un fallback |
| Necesitas que el «no lo sé» sea fiable | Agéntico — la pareja grade + fallback es la forma más limpia de construir una negativa fiable |
El capítulo cierra con la metalección que se repite durante todo el curso, y es la nota correcta para terminar:
07:03:30 «Siempre se trata de saber cuándo usarlo y cuándo no».
Lo repite una última vez en 07:04:31, justo antes de que el curso pase a GraphRAG (Parte 16): si estás en producción, mira tu caso de uso y decide si de verdad lo pide.
Checklist — decisiones que tomar antes de poner en producción un bucle autocorrectivo
Arquitectura
- ¿Tu modo de fallo es de vocabulario o de cobertura? Toma una muestra de 30 queries fallidas y etiquétalas. Si la mayoría son huecos de cobertura, ciérralos y sáltate esta parte entera.
- ¿De dónde sale la señal de evaluación — de un grader LLM, del score de un reranker cross-encoder o de una comprobación determinista? Prefiere lo determinista; prefiere lo barato; usa un LLM en último lugar.
- ¿Tu grafo hace retrieval de forma incondicional (
set_entry_point("retrieve")) o tiene una primera decisión de verdad? Como mínimo, filtra con un gate las entradas triviales antes del grafo. - ¿Enrutar según la media de los scores, el máximo o «al menos un documento ≥ X»? Decídelo y deja por escrito por qué. La media del curso es una elección, no una ley.
Presupuestos
- Fija
max_retriesde forma explícita, por request, en el estado. Por defecto2. Nunca sin límite. - Fija un deadline de tiempo real para todo el
app.invoke, independiente del número de retries. - Calcula tu número de llamadas en el peor caso:
k(1+max_retries) + max_retries + 1llamadas al LLM. Conk=3ymax_retries=2son 12. Multiplícalo por tu tráfico. Decide si puedes permitirte el camino de fallo, porque es tu camino más caro. - Agrupa en batch o paraleliza las llamadas de evaluación antes de salir a producción.
kidas y vueltas de evaluación en serie en cada query es el comportamiento por defecto, y es el comportamiento por defecto equivocado.
Corrección
- Declara todos los campos que metas en el estado — incluidos los handles inyectados — o, mejor, inyéctalos por closure/config. Elimina los fallbacks del tipo «créalo si falta»; falla de forma ruidosa.
- Haz que el parser de notas falle cerrado (
0.0), no abierto (0.5), y loguea cada respuesta que no se pueda parsear. - Conserva en el estado el conjunto de retrieval en bruto junto al filtrado, para poder depurar lo que se ha descartado.
- Mete la reescritura anterior y su score en el prompt de la siguiente reescritura. Un retry a ciegas es lanzar una moneda que has pagado.
- Decide si la evaluación usa la query original o la reescrita, y comenta la decisión en el código. Las dos son defendibles; el silencio no.
Operaciones
- Construye el grafo una sola vez al arrancar; lo único que va por request es el estado.
- Emite logs estructurados desde cada nodo con un request id, para que una ejecución de tres intentos se pueda reconstruir solo a partir de los logs. Sustituye los
print. - Sigue la tasa de retry, la tasa de fallback, las llamadas de evaluación por query y la latencia p95 de extremo a extremo. Si la tasa de retry está cerca de cero, estás pagando por un bucle que nunca se dispara — vuelve a una pasada.
- Haz streaming al usuario de las transiciones entre nodos. Es el arreglo más barato para la latencia que cuesta este patrón.
- Prueba el camino de fallo en CI: una query que tu corpus no puede responder tiene que llegar a
fallbacky no debe llegar nunca agenerate. - Calibra el grader frente a etiquetas humanas antes de fiarte del umbral de
0.5. - Renderiza el grafo (
app.get_graph().draw_mermaid()) en CI y compara el diff. Los diagramas generados no se pueden quedar desfasados.
La versión en una frase
Un bucle de retrieval autocorrectivo vale lo que cuesta exactamente cuando los fallos de tu sistema se pueden recuperar haciendo una pregunta mejor. Mide eso primero; construye el grafo después.