
Calidad del retrieval: búsqueda híbrida, reranking y citas
Búsqueda híbrida BM25 + vectorial fusionada con RRF, reranking, compresión y citas.
Las Partes 3 a 5 te dieron un sistema que recupera algo y responde con ello. Esta parte trata de la distancia entre algo y lo correcto. Todas las técnicas de aquí modifican exactamente dos cajas del pipeline de la Phase B de la Parte 1 —Retrieve → Fuse/Filter → Compress/Rerank— y ninguna toca el índice. Es deliberado: las mejoras de calidad más baratas que puedes publicar son las que no te obligan a hacer re-embed.
Dos de los cinco modos de fallo de la Parte 1 viven aquí:
- Modo de fallo n.º 2, desajuste de embeddings. El usuario escribe
SKU-7742XoE_CONN_REFUSED, y el embedding model, que solo entiende de significado, no tiene ningún significado con el que trabajar. Solución: búsqueda híbrida, es decir, añadir un retriever al que el significado no le importe en absoluto. - Modo de fallo n.º 3, ruido en el retrieval. Vuelven diez documentos, dos son relevantes, y los ocho distractores se comen tu context window y la atención de tu modelo. Soluciones: reranking, compresión y parent-document retrieval.
Ambos fallos son silenciosos (invariante 4). Nada lanza excepciones. Tu tasa de errores se queda en el 0% mientras tus respuestas empeoran en silencio, y por eso todas las técnicas de esta parte vienen con un arnés de medición y no con una corazonada.
Resumida en una frase, esta parte dice: recupera en amplitud y luego estrecha deliberadamente. Cada técnica de las que siguen es una forma distinta de ampliar o de estrechar, y la habilidad está en saber cuál pide un fallo concreto.
Dónde se hunde la búsqueda vectorial pura
El superpoder de la búsqueda vectorial es que compara significados en lugar de caracteres. Ese es también, precisamente, su punto ciego: los strings que no tienen significado no tienen posición en el espacio semántico 01:53:47. El instructor se cuida de presentarlos como fallos totales, no como degradaciones: el documento correcto sigue intacto en la base de datos mientras el retriever devuelve con total seguridad cuatro equivocados.
Hay cuatro clases, y merece la pena memorizarlas porque son la forma en que reconocerás la enfermedad en tus propios logs.
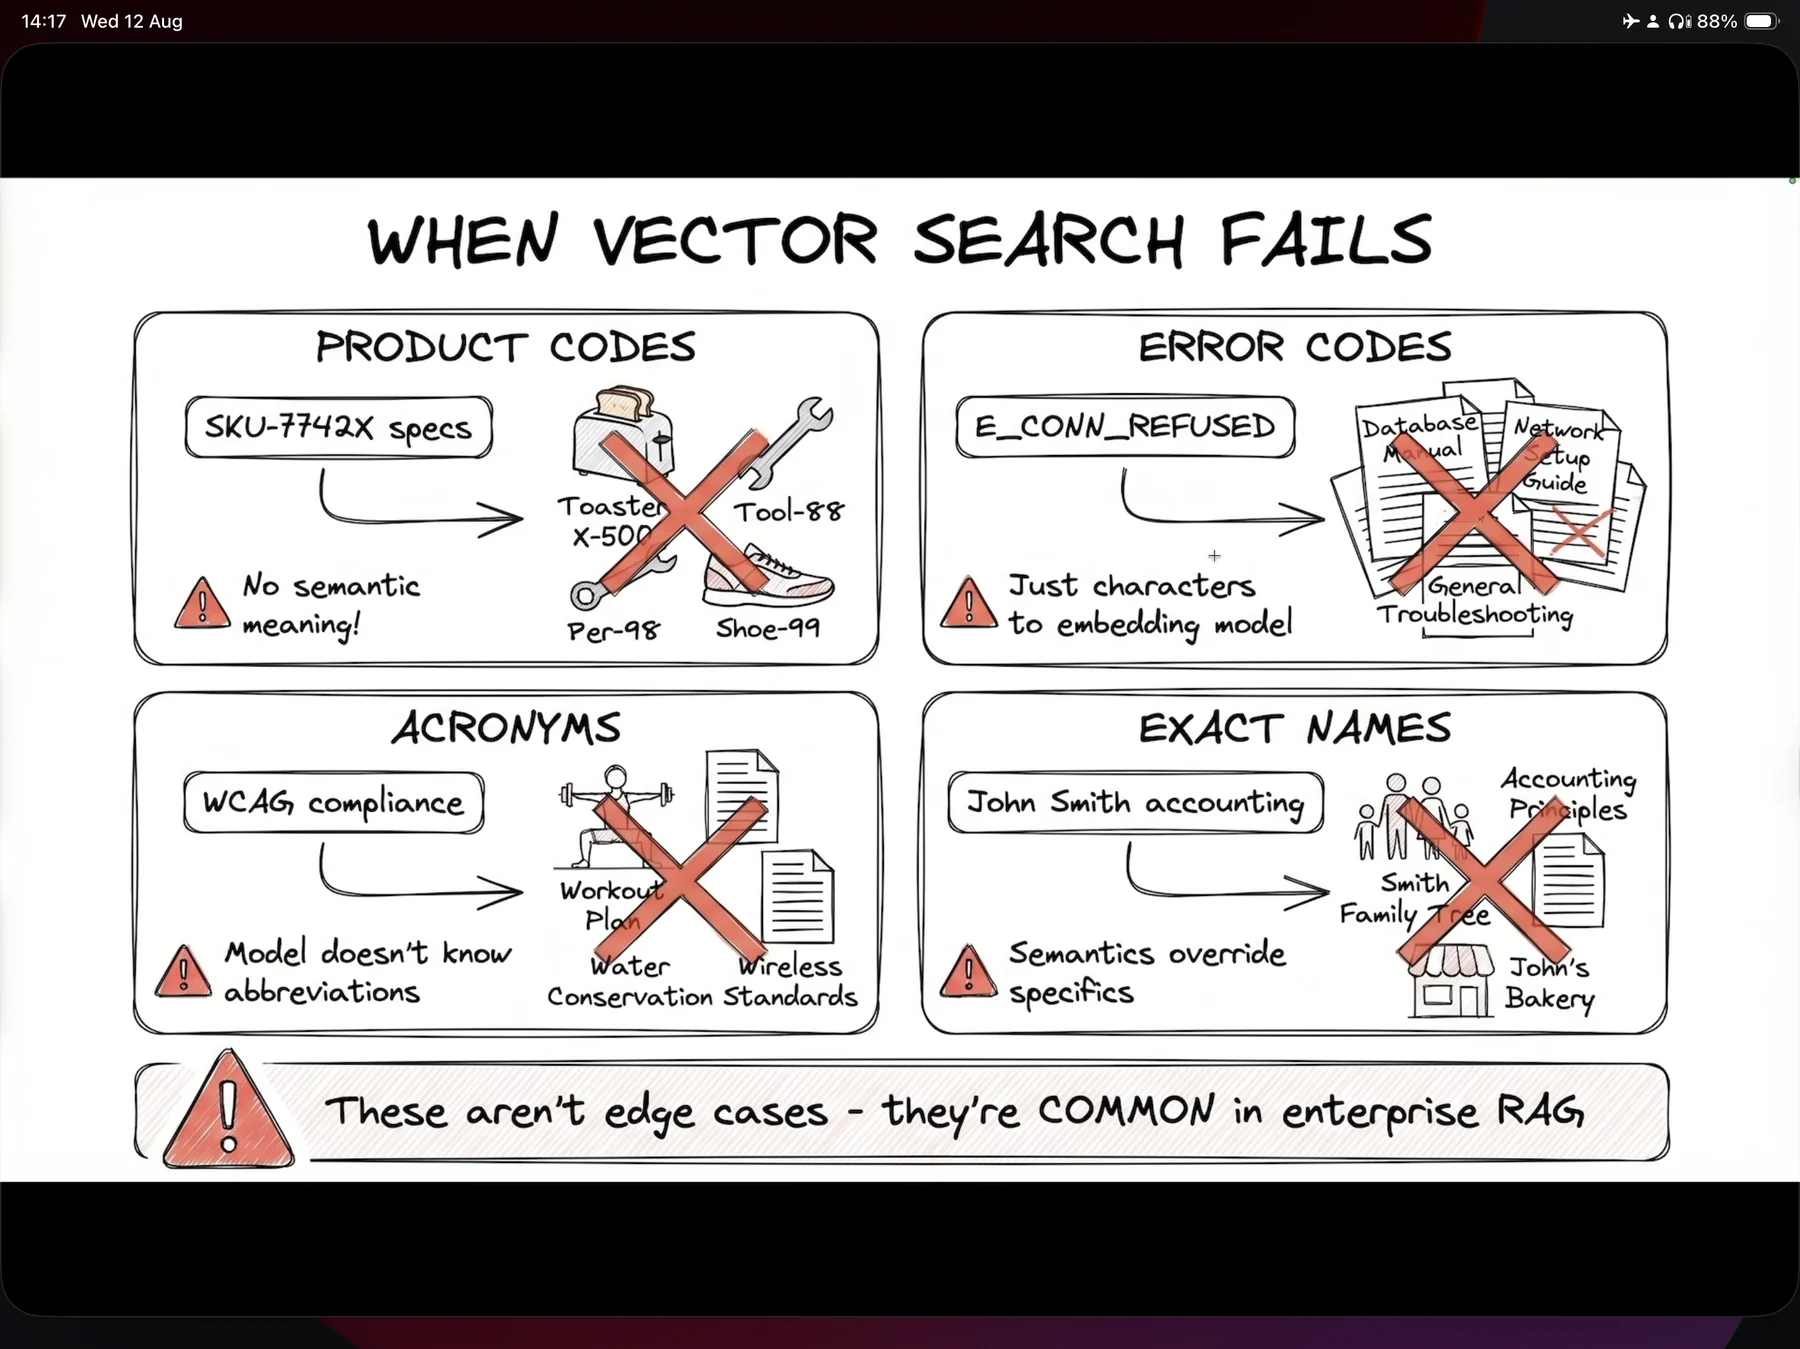
| Clase de fallo | Query de ejemplo | Lo que devuelve la búsqueda vectorial en su lugar | Causa raíz |
|---|---|---|---|
| Códigos de producto / SKU | SKU-7742X specs | Toaster X-500, Tool-88, Per-98, Shoe-99 | Sin significado semántico: solo caracteres |
| Códigos de error / identificadores | E_CONN_REFUSED | Database Manual, Network Setup Guide, General Troubleshooting | Para el embedding model son solo caracteres |
| Siglas / abreviaturas | WCAG compliance | Workout Plan, Water Conservation Standards, Wireless Standards | El modelo no sabe que la abreviatura significa Web Content Accessibility Guidelines |
| Nombres exactos | John Smith accounting | Smith Family Tree, Accounting Principles, John's Bakery | La semántica se impone a lo específico |
Mira con atención la fila de las siglas, porque es la más instructiva. El retriever no devolvió ruido aleatorio. Devolvió documentos cuyas iniciales o cuyo aire encajan: Workout, Water Conservation, Wireless. El embedding codificó «algo con W y con pinta de estándar» y encontró las cosas más cercanas a eso. Se comportó a la perfección. Simplemente no tenía nada sobre lo que comportarse a la perfección.
La fila de nombres exactos tiene el diagnóstico más nítido de toda la diapositiva: la semántica se impone a lo específico. La query «John Smith accounting» se descompone, en el espacio de embeddings, en una dirección de «persona» y una dirección de «contabilidad». Los documentos que son claramente una cosa o la otra ganan al documento que es un poco de ambas. La entidad concreta queda ahogada por el tema general.
Dos fallos relacionados pero distintos que no debes confundir con estos, porque sus soluciones están en otra parte:
- El chunk nunca fue coherente (la respuesta está repartida entre el chunk 47 y el chunk 48): eso es la Parte 3, y ningún retriever lo arregla.
- El nombre de la entidad puente ni siquiera aparece en la query («the CEO's assistant» frente a «Sarah Johnson works in the Executive department»): ni BM25, ni el reranking, ni ajustar k sirven de nada, porque ninguna de las dos ramas tiene un string o un concepto al que agarrarse. Ese es el problema multi-hop, y es la Parte 16.
BM25: el inverso exacto de la búsqueda vectorial
BM25 («Best Matching 25») es una función de ranking léxica: puntúa un documento según las estadísticas de los términos de la query que contiene —frecuencia del término, normalización por longitud del documento y frecuencia inversa de documento, para que los términos raros cuenten más que los comunes—. Sin embedding model, sin red neuronal, sin semántica.
«BM25 es lo contrario de la búsqueda vectorial. No entiende el significado en absoluto. Solo cuenta palabras». 01:56:52
Eso suena a limitación hasta que pones los dos frente a frente.
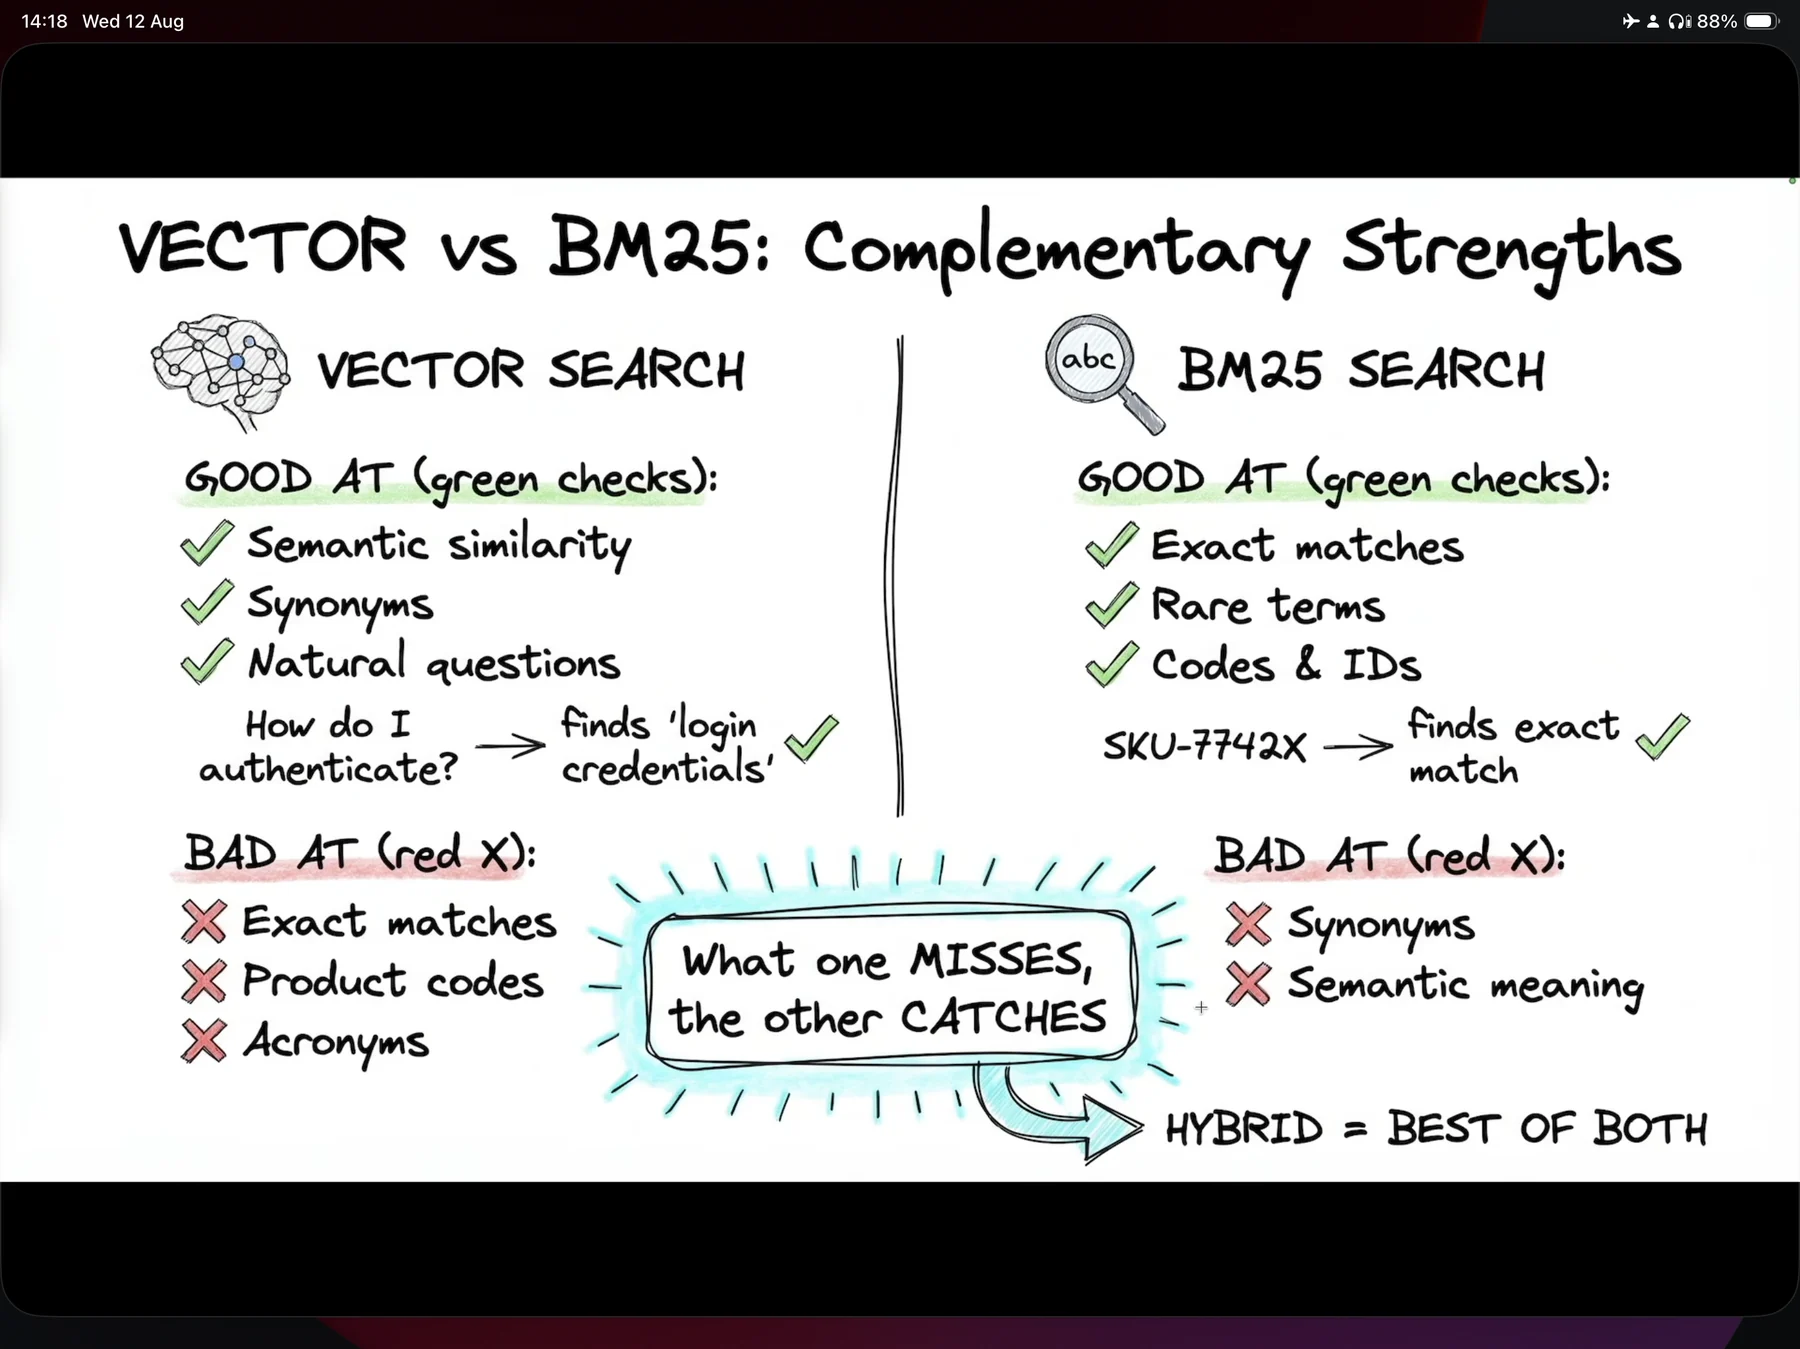
| Búsqueda vectorial | Búsqueda BM25 | |
|---|---|---|
| Bueno en | similitud semántica · sinónimos · preguntas naturales | coincidencias exactas · términos raros · códigos & ID |
| Ejemplo | «How do I authenticate?» → encuentra 'login credentials' | SKU-7742X → encuentra la coincidencia exacta |
| Malo en | coincidencias exactas · códigos de producto · siglas | sinónimos · significado semántico |
| Necesita un embedding model | Sí, en tiempo de indexación y de query | No |
| Coste de actualizar el índice | Incremental (upsert) | Reconstrucción completa |
| Dónde se ejecuta | Base de datos vectorial | En el propio proceso (rank_bm25) o en tu motor de búsqueda |
Las tres primeras filas son las de la diapositiva; las tres últimas son lo que añade el código publicado, y son las que deciden tu arquitectura. La frase sobre la que gira toda la lección es de la propia diapositiva: «Lo que uno PIERDE, el otro lo ATRAPA», que resuelve en «HÍBRIDO = LO MEJOR DE AMBOS» 01:57:53. Toma la primera mitad como la afirmación de ingeniería y la segunda como el marketing: los resultados medidos más adelante en esta parte respaldan «rara vez peor, a veces mucho mejor», que es una afirmación más débil y más útil que «lo mejor de ambos».
Qué hace realmente BM25Retriever
No trates BM25 como una caja negra. El wrapper de LangChain apenas tiene cien líneas, está instalado en el entorno fijado, y dos de sus valores por defecto te van a morder.
# .venv/.../langchain_community/retrievers/bm25.py — the shipped implementation (abridged)
def default_preprocessing_func(text: str) -> List[str]:
    return text.split()


class BM25Retriever(BaseRetriever):
    """`BM25` retriever without Elasticsearch."""

    vectorizer: Any = None
    docs: List[Document] = Field(repr=False)
    k: int = 4
    """ Number of documents to return."""
    preprocess_func: Callable[[str], List[str]] = default_preprocessing_func

    @classmethod
    def from_texts(cls, texts, metadatas=None, ids=None, bm25_params=None,
                   preprocess_func=default_preprocessing_func, **kwargs):
        from rank_bm25 import BM25Okapi

        texts_processed = [preprocess_func(t) for t in texts]
        vectorizer = BM25Okapi(texts_processed, **(bm25_params or {}))
        ...
        return cls(vectorizer=vectorizer, docs=docs,
                   preprocess_func=preprocess_func, **kwargs)

    def _get_relevant_documents(self, query, *, run_manager):
        processed_query = self.preprocess_func(query)
        return self.vectorizer.get_top_n(processed_query, self.docs, n=self.k)
De esas líneas se desprenden cuatro cosas:
- El tokenizador por defecto es
str.split(). Solo espacios en blanco. Sin pasar a minúsculas, sin quitar la puntuación, sin stemming. Así queE_CONN_REFUSED.al final de una frase es un token distinto deE_CONN_REFUSED, yWCAGno coincide conwcag. Una rama BM25 que rinde por debajo de lo esperado, en silencio, justo con los códigos para los que la añadiste suele ser esto y nada más. - Pasa
preprocess_funcen la construcción, nunca después. Mira dónde se usa:from_textslo aplica a todo el corpus antes de construir el vectorizador, y_get_relevant_documentslo aplica a la query. Asignarretriever.preprocess_func = my_funca posteriori solo cambia el lado de la query, así que la query y el índice se tokenizan con reglas distintas y tu recall se hunde sin hacer ruido. Pásalo como argumento con nombre afrom_documents(...)para que ambos lados coincidan. kvale 4 por defecto, no 3, lo que coincide con el consejo de producción de la diapositiva 06. La demo fijabm25_retriever.k = 3en la instancia después; funciona, pero también funcionaBM25Retriever.from_documents(docs, k=3), porquefrom_documentsreenvía**kwargsa través defrom_textshasta el constructor. Prefiere el argumento con nombre: mantiene la configuración del retriever en una sola expresión.docses todo el corpus, guardado en memoria, yget_top_npuntúa todos los documentos en cada query. ElBM25Okapiderank_bm25se instancia conk1=1.5, b=0.75, epsilon=0.25y hace un recorrido lineal connp.argsortsobre todos los scores: bien con miles de documentos, un problema real con millones. A esa escala, llevas la rama de palabras clave a la búsqueda de texto completo de Postgres, a OpenSearch/Elasticsearch o al modo híbrido nativo de tu base de datos vectorial (Parte 10).
Y la advertencia obligatoria en sentido contrario: nunca publiques BM25 solo. En el recorrido en directo, «How do I authenticate?» puso el documento de cumplimiento de WCAG 2.1 en la posición n.º 1: «falló por completo» 02:09:05. Incluso en queries en las que BM25 acertó la posición 1, las posiciones 2 y 3 eran documentos sin relación 02:07:04. Una buena precisión en el top-1 no implica una lista limpia.
Dividir y luego fusionar: el pipeline híbrido
La búsqueda híbrida no es «búsqueda vectorial con un filtro de palabras clave». La query baja por ambas ramas simultáneamente y las dos listas ordenadas se combinan con un algoritmo de fusión 01:58:56.
ASCII original
                    ┌──────────────────────┐
                    │  "SKU-7742X specs"   │
                    └──────────┬───────────┘
                               │  (the same query string, unmodified)
              ┌────────────────┴────────────────┐
              ▼                                 ▼
      ┌───────────────┐                 ┌───────────────┐
      │ VECTOR branch │                 │  BM25 branch  │
      │ embed → ANN   │                 │  term stats   │
      └───────┬───────┘                 └───────┬───────┘
              │ doc3, doc7, doc1                │ doc1, doc9, doc3
              └────────────────┬────────────────┘
                               ▼
                 ┌──────────────────────────┐
                 │  Reciprocal Rank Fusion  │   weights=[w_bm25, w_vector]
                 │  score += w / (rank + c) │   c = 60
                 └────────────┬─────────────┘
                              ▼
                     doc1, doc3, doc7  ← one fused ranking
Fíjate en lo que no ocurre: la query no se reescribe, ni se divide, ni se enruta. El mismo string va a ambas ramas. Esto importa porque significa que la búsqueda híbrida no te cuesta ninguna llamada al LLM, a diferencia del multi-query que veremos más adelante en esta parte, que hace exactamente el intercambio contrario.
RRF, y por qué gana el consenso
Reciprocal Rank Fusion tira los scores. De eso se trata: una distancia coseno de 0.31 y un score BM25 de 14.2 no están en la misma escala ni lo estarán nunca, así que RRF usa lo único que comparten las dos listas: la posición. Esta es la implementación publicada, y merece la pena leerla porque de vez en cuando tendrás que volver a deducir su comportamiento desde los primeros principios cuando la salida fusionada te sorprenda.
# .venv/.../langchain_classic/retrievers/ensemble.py — EnsembleRetriever (abridged)
class EnsembleRetriever(BaseRetriever):
    retrievers: list[RetrieverLike]
    weights: list[float]
    c: int = 60
    id_key: str | None = None

    @model_validator(mode="before")
    @classmethod
    def _set_weights(cls, values: dict[str, Any]) -> Any:
        if not values.get("weights"):
            n_retrievers = len(values["retrievers"])
            values["weights"] = [1 / n_retrievers] * n_retrievers
        return values

    def weighted_reciprocal_rank(
        self, doc_lists: list[list[Document]]
    ) -> list[Document]:
        if len(doc_lists) != len(self.weights):
            msg = "Number of rank lists must be equal to the number of weights."
            raise ValueError(msg)

        rrf_score: dict[str, float] = defaultdict(float)
        for doc_list, weight in zip(doc_lists, self.weights, strict=False):
            for rank, doc in enumerate(doc_list, start=1):
                rrf_score[
                    doc.page_content
                    if self.id_key is None
                    else doc.metadata[self.id_key]
                ] += weight / (rank + self.c)

        all_docs = chain.from_iterable(doc_lists)
        # `_key` below stands for the same page_content-or-id_key ternary, which the
        # source inlines a third and fourth time here.
        return sorted(
            unique_by_key(all_docs, _key),
            reverse=True,
            key=lambda doc: rrf_score[_key(doc)],
        )
Dos cosas que conviene tener claras antes de la aritmética. Primero, _set_weights: omitir weights por completo no lanza ningún error: le da en silencio 1/n a cada retriever. Es un valor por defecto razonable y una sorpresa terrible si creías haber configurado una inclinación. Segundo, la constante c = 60 es el término de amortiguación, y es la razón de que el algoritmo se comporte como se comporta. Con c = 60, la posición 1 aporta w/61 y la posición 3 aporta w/63: una diferencia de alrededor del 3%. Las posiciones se tratan como casi igual de buenas, así que estar presente en ambas listas importa mucho más que ser el primero en una.
Haz la aritmética para el caso 50/50:
| Documento | Posición BM25 | Posición vectorial | Score RRF | Posición fusionada |
|---|---|---|---|---|
| doc A | 1 | ausente | 0.5/61 = 0.00820 | empatado en 2.º |
| doc B | 3 | 3 | 0.5/63 + 0.5/63 = 0.01587 | 1.º |
| doc C | ausente | 1 | 0.5/61 = 0.00820 | empatado en 2.º |
Un documento que es el n.º 3 en ambas listas gana a un documento que es el n.º 1 en una y no aparece en la otra 01:59:58. Esa es la propiedad emergente a la que se refiere la gente cuando dice que la búsqueda híbrida «equilibra de forma natural la relevancia semántica con la precisión de las palabras clave». No es magia; es c = 60 haciendo que el acuerdo salga barato y el desacuerdo caro. (Los empates se resuelven según el orden en que sorted los encontró: sorted es estable, y chain.from_iterable recorre las listas de los retrievers en el orden de declaración, así que en un empate exacto gana el primer retriever de tu lista. Otra razón más por la que el orden de los retrievers no es cosmético).
Hay una trampa sutil escondida en ese código: la clave de deduplicación es por defecto doc.page_content, es decir, el texto completo. Dos chunks con texto idéntico procedentes de archivos fuente distintos se colapsan en uno y sus scores se suman. A la inversa, si pasaste los chunks por contextual retrieval (Parte 14) de modo que cada uno lleva un preámbulo ligeramente distinto escrito por el LLM, dos copias del mismo chunk no se deduplicarán. Fija id_key a un campo estable de ID de documento en los metadatos siempre que tu corpus tenga identificadores reales, y ten en cuenta que id_key se lee como doc.metadata[id_key], un acceso directo por clave, así que un solo documento al que le falte ese campo lanza KeyError en mitad de la fusión.
Construirlo: tres componentes, tres líneas
La construcción es realmente pequeña 02:01:59: un retriever vectorial que ya tienes («el núcleo de la comprensión semántica»), un retriever BM25 que ocupa una línea y un ensemble que los fusiona. Instala primero el motor de palabras clave 02:02:59:
uv add rank-bm25
Las versiones con las que se verificó esta parte, sacadas directamente del pyproject.toml del repo:
| Paquete | Pin |
|---|---|
python | >=3.12 |
langchain | >=1.2.7 |
langchain-openai | >=1.1.7 |
langchain-chroma | >=1.1.0 |
langchain-community | >=0.4.1 |
rank-bm25 | >=0.2.2 |
langgraph | >=1.0.7 |
Ahora el corpus, y aquí tienes que separar dos cosas que la fuente mezcla. El vídeo demuestra la búsqueda híbrida con un corpus deliberadamente adversarial que mezcla SKU, códigos de error, prosa sobre OAuth, configuración de routers y direcciones IP, «para emular un caso de uso real en el que tienes documentos de esta naturaleza» 02:02:59: ese es el corpus que hay detrás de la tabla de resultados de cinco queries de más abajo, y su archivo no está en ninguno de los dos repos publicados. La demo del commit se ejecuta sobre TECH_DOCS, ocho párrafos limpios sobre Python, JavaScript, ML, LangChain, LangGraph, Docker, PostgreSQL y bases de datos vectoriales, sin un solo SKU ni código de error.
Construye el tuyo como el del vídeo, no como el del repo. Un corpus de prosa limpia te dirá que la búsqueda híbrida no hace nada, y te estará mintiendo: es la misma trampa que hace que la demo de compresión parezca rota más adelante en esta parte.
# production-course-main-code/advanced_rag.py — demo_ensemble_hybrid_search() (abridged)
from langchain_classic.retrievers import EnsembleRetriever
from langchain_community.retrievers import BM25Retriever


def demo_ensemble_hybrid_search():
    """Hybrid search combining keyword (BM25) and semantic search."""

    vectorstore = create_base_vectorstore()

    # BM25 keyword retriever
    bm25_retriever = BM25Retriever.from_documents(TECH_DOCS)
    bm25_retriever.k = 3

    # Semantic retriever
    semantic_retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

    # Ensemble combines both
    ensemble_retriever = EnsembleRetriever(
        retrievers=[bm25_retriever, semantic_retriever],
        weights=[0.4, 0.6],  # 40% keyword, 60% semantic
    )

    queries = [
        "ACID transactions",                                    # Keyword-heavy (BM25 helps)
        "How do I store AI model outputs for later retrieval?", # Semantic (vectors help)
        "fast similarity lookup for embeddings",                # Mixed
    ]

    for query in queries:
        bm25_results = bm25_retriever.invoke(query)
        semantic_results = semantic_retriever.invoke(query)
        ensemble_results = ensemble_retriever.invoke(query)

        print(f"BM25 top result: {bm25_results[0].page_content[:60]}...")
        print(f"Semantic top result: {semantic_results[0].page_content[:60]}...")
        print(f"Ensemble top result: {ensemble_results[0].page_content[:60]}...")
Fíjate en la disciplina de esa lista de queries: cada query de prueba está anotada con la categoría que pone a prueba. Con muchas palabras clave, semántica, mixta. Ese comentario no es decoración: es la única forma de leer la salida y saber qué retriever debería haber ganado, que es el requisito previo para ajustar los pesos con evidencia en lugar de por gusto.
El fallback sin dependencias
Como la ruta de import es inestable y como quizá quieras fusionar resultados completamente fuera de LangChain, mantén un RRF de 20 líneas en tu propio código. Esta es una reimplementación fiel de langchain_classic/retrievers/ensemble.py::weighted_reciprocal_rank: misma constante, misma acumulación, misma regla de deduplicación, sin dependencia de ningún framework.
RRF ponderado escrito a mano (sin dependencias)
# Reimplementation of langchain_classic/retrievers/ensemble.py::weighted_reciprocal_rank
# Same algorithm, same c=60. Use when the import path moves or you are not on LangChain.
from collections import defaultdict
from itertools import chain


def weighted_rrf(doc_lists, weights, c=60, id_key=None):
    """Fuse N ranked lists of Documents into one ranking.

    doc_lists: list of ranked lists, best-first.
    weights:   one float per list, positionally matched.
    c:         rank damping constant; larger => ranks matter less, consensus more.
    id_key:    metadata field to dedupe on; falls back to page_content.
    """
    if len(doc_lists) != len(weights):
        raise ValueError("Number of rank lists must equal the number of weights.")

    def key(doc):
        return doc.page_content if id_key is None else doc.metadata[id_key]

    scores = defaultdict(float)
    for doc_list, weight in zip(doc_lists, weights):
        for rank, doc in enumerate(doc_list, start=1):
            scores[key(doc)] += weight / (rank + c)

    seen, unique = set(), []
    for doc in chain.from_iterable(doc_lists):
        k = key(doc)
        if k not in seen:
            seen.add(k)
            unique.append(doc)

    return sorted(unique, key=lambda d: scores[key(d)], reverse=True)


# Usage — the ensemble is a LIST, not a pair. N retrievers, N weights.
fused = weighted_rrf(
    [bm25_retriever.invoke(q), vector_retriever.invoke(q)],
    weights=[0.5, 0.5],
)
El ensemble se generaliza a N ramas, no solo a dos:
«Si tuviéramos 10 retrievers, esto es una lista. Podríamos haberlos puesto todos ahí». 02:05:03
Una tercera rama —un retriever filtrado por metadatos, un segundo embedding model, un retriever de grafos— cuesta una entrada más en retrievers y un float más en weights. La única restricción que impone el código es que las dos listas tengan la misma longitud; todo lo demás queda a tu criterio.
Ajustar los pesos
weights es un deslizador entre dos polos, y se corresponde por posición con retrievers.
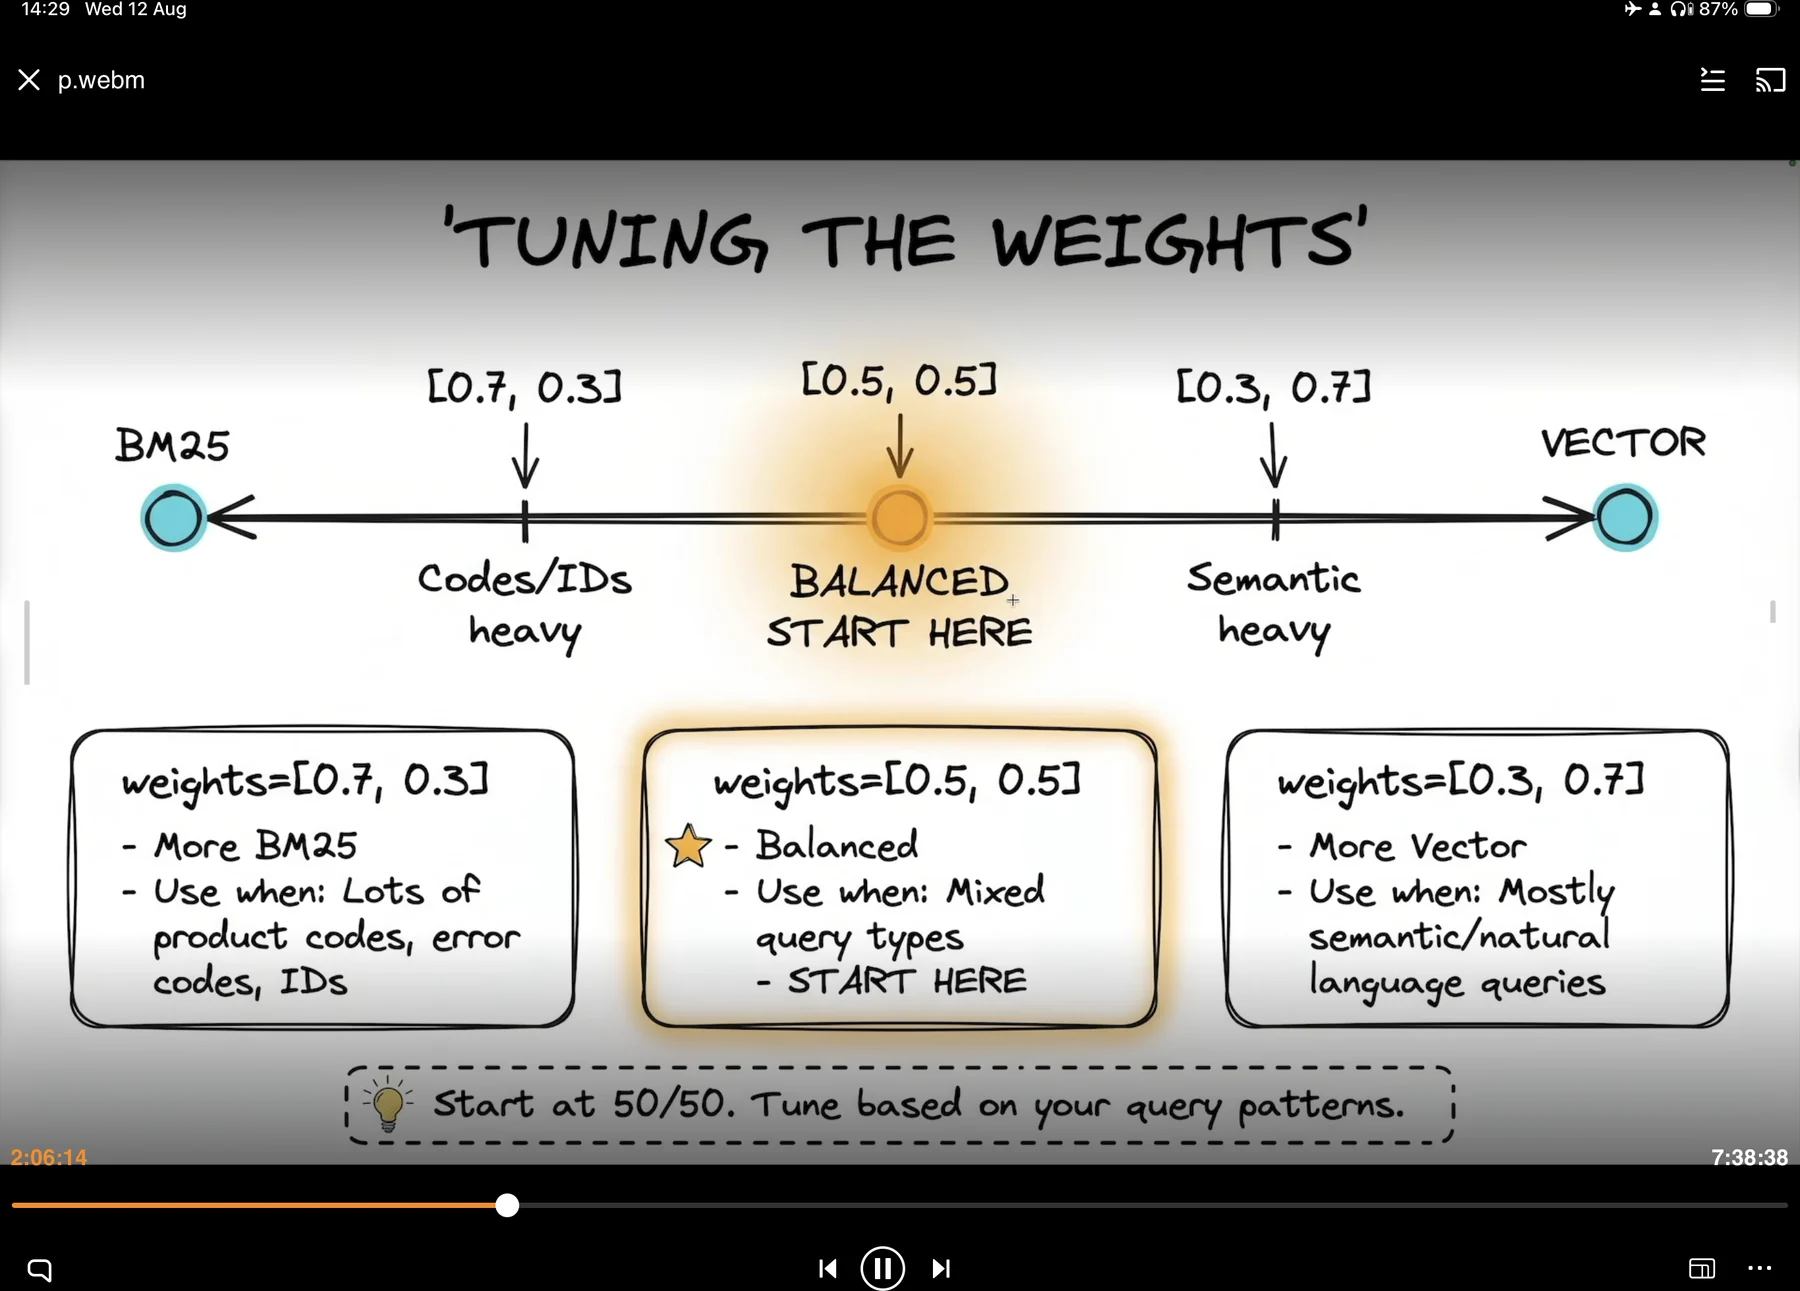
Pesos [bm25, vector] | Inclinación | Úsalo cuando |
|---|---|---|
[0.7, 0.3] | Más BM25 | Muchos códigos de producto, códigos de error, ID |
[0.5, 0.5] | Equilibrado: EMPIEZA AQUÍ ★ | Tipos de query mixtos; todavía no has medido |
[0.3, 0.7] | Más vectorial | Queries sobre todo semánticas / en lenguaje natural |
«Empieza con 50/50. Ajusta según tus patrones de queries». — diapositiva 05
La fuente se contradice sobre el valor inicial, y conviene que sepas cuál seguir. La diapositiva 05 y el recorrido dicen ambos que empieces con [0.5, 0.5] 02:05:03, 02:12:09. El advanced_rag.py del commit trae [0.4, 0.6], inclinado hacia lo semántico. Ninguno está mal; la diapositiva es el valor por defecto didáctico y el repo es el resultado ajustado por un desarrollador para un corpus de ocho documentos en prosa en el que BM25 tiene poco donde morder. Empieza con 50/50 y luego muévete.
Fíjate también en lo que los pesos no hacen. Son multiplicadores de w/(rank + 60), un término que varía ~3% en la parte alta de una lista. Pasar de [0.5, 0.5] a [0.7, 0.3] es una perturbación mucho mayor que mover un documento de la posición 1 a la 3. Los pesos son una palanca gruesa; si el documento correcto no está en el conjunto de candidatos de ninguna de las dos ramas, ningún peso lo rescata. Eso es un problema de k, no de pesos.
El arnés de comparación directa
Los pesos no se ajustan razonando. Se ajustan pasando la misma query por los tres retrievers y leyendo cuál puso el documento correcto en la posición 1 02:06:04. Escríbelo una vez y reutilízalo en cada cambio de retrieval que hagas:
# RECONSTRUCTED — the on-screen harness file is not in either published repo. The shape,
# the five queries and their category labels are transcribed from the walkthrough; the
# retriever APIs are the verified ones above. Bind the three retrievers however your code
# names them (in `advanced_rag.py` the vector branch is called `semantic_retriever`).
def test_query(retriever, query, name, n=3):
    docs = retriever.invoke(query)
    print(f"\n[{name}] {query}")
    for i, doc in enumerate(docs[:n], start=1):
        src = doc.metadata.get("source", "?")
        print(f"  {i}. ({src}) {doc.page_content[:80]}...")


QUERIES = [
    ("SKU-7742X specifications",  "product code"),
    ("E_CONN_REFUSED error",      "error code"),
    ("How do I authenticate?",    "semantic question"),
    ("WCAG compliance",           "acronym"),
    ("router configuration",      "config lookup"),
]

for query, category in QUERIES:
    print(f"\n===== {category.upper()} =====")
    test_query(bm25_retriever,     query, "BM25")
    test_query(vector_retriever,   query, "VECTOR")
    test_query(ensemble_retriever, query, "HYBRID")
El resultado de ejecutar exactamente eso en el curso, con el corpus adversarial del vídeo, con cinco queries y tres retrievers 02:07:04–02:10:05:
| # | Query | Categoría | Vectorial | BM25 | Híbrido | Veredicto del instructor |
|---|---|---|---|---|---|---|
| 1 | SKU-7742X specifications | código de producto | n.º 1 correcto, n.º 2/n.º 3 relacionados | n.º 1 correcto, luego ruido (WCAG, doc del router) | n.º 1 correcto | «el vectorial y el híbrido ganaron, más o menos» |
| 2 | error E_CONN_REFUSED | código de error | n.º 1 correcto, n.º 2 también bueno, n.º 3 algo de ruido | n.º 1 correcto, ruido de WCAG debajo | n.º 1 correcto | «el ganador claro… es el vectorial» |
| 3 | «How do I authenticate?» | pregunta semántica | n.º 1 correcto | falló: el n.º 1 fue cumplimiento de WCAG 2.1 | n.º 1 correcto | «ganaron el vectorial y el híbrido» |
| 4 | WCAG compliance | sigla | correcto | correcto (las palabras clave lo clavaron) | correcto | «todos» |
| 5 | router configuration | búsqueda de configuración | n.º 1 correcto | n.º 1 correcto + un doc de redes relacionado | n.º 1 correcto | todo bien |
«El vectorial tiende a entender el significado, BM25 casa términos exactos y el híbrido te da lo mejor de ambos mundos». 02:10:05
Ahora vuelve a leer las queries 1 y 2, porque contienen la lección menos obvia de la tabla. Son las queries de código de producto y código de error —justo los casos para los que existe el híbrido— y la búsqueda vectorial pura resolvió ambas. ¿Por qué? Porque el corpus de la demo son un puñado de documentos, así que SKU-7742X casi no tenía con qué confundirse. El valor de la rama BM25 crece con el tamaño del corpus, porque el fallo que evita es que vecinos plausibles adelanten al documento correcto, y los vecinos plausibles son exactamente lo que trae la escala (el precipicio de 10 → 10,000 documentos de la Parte 1). Un A/B del híbrido sobre un corpus de juguete infravalorará el beneficio; ejecútalo con datos de tamaño de producción antes de sacar ninguna conclusión.
Cuándo añadir búsqueda híbrida y cuándo no
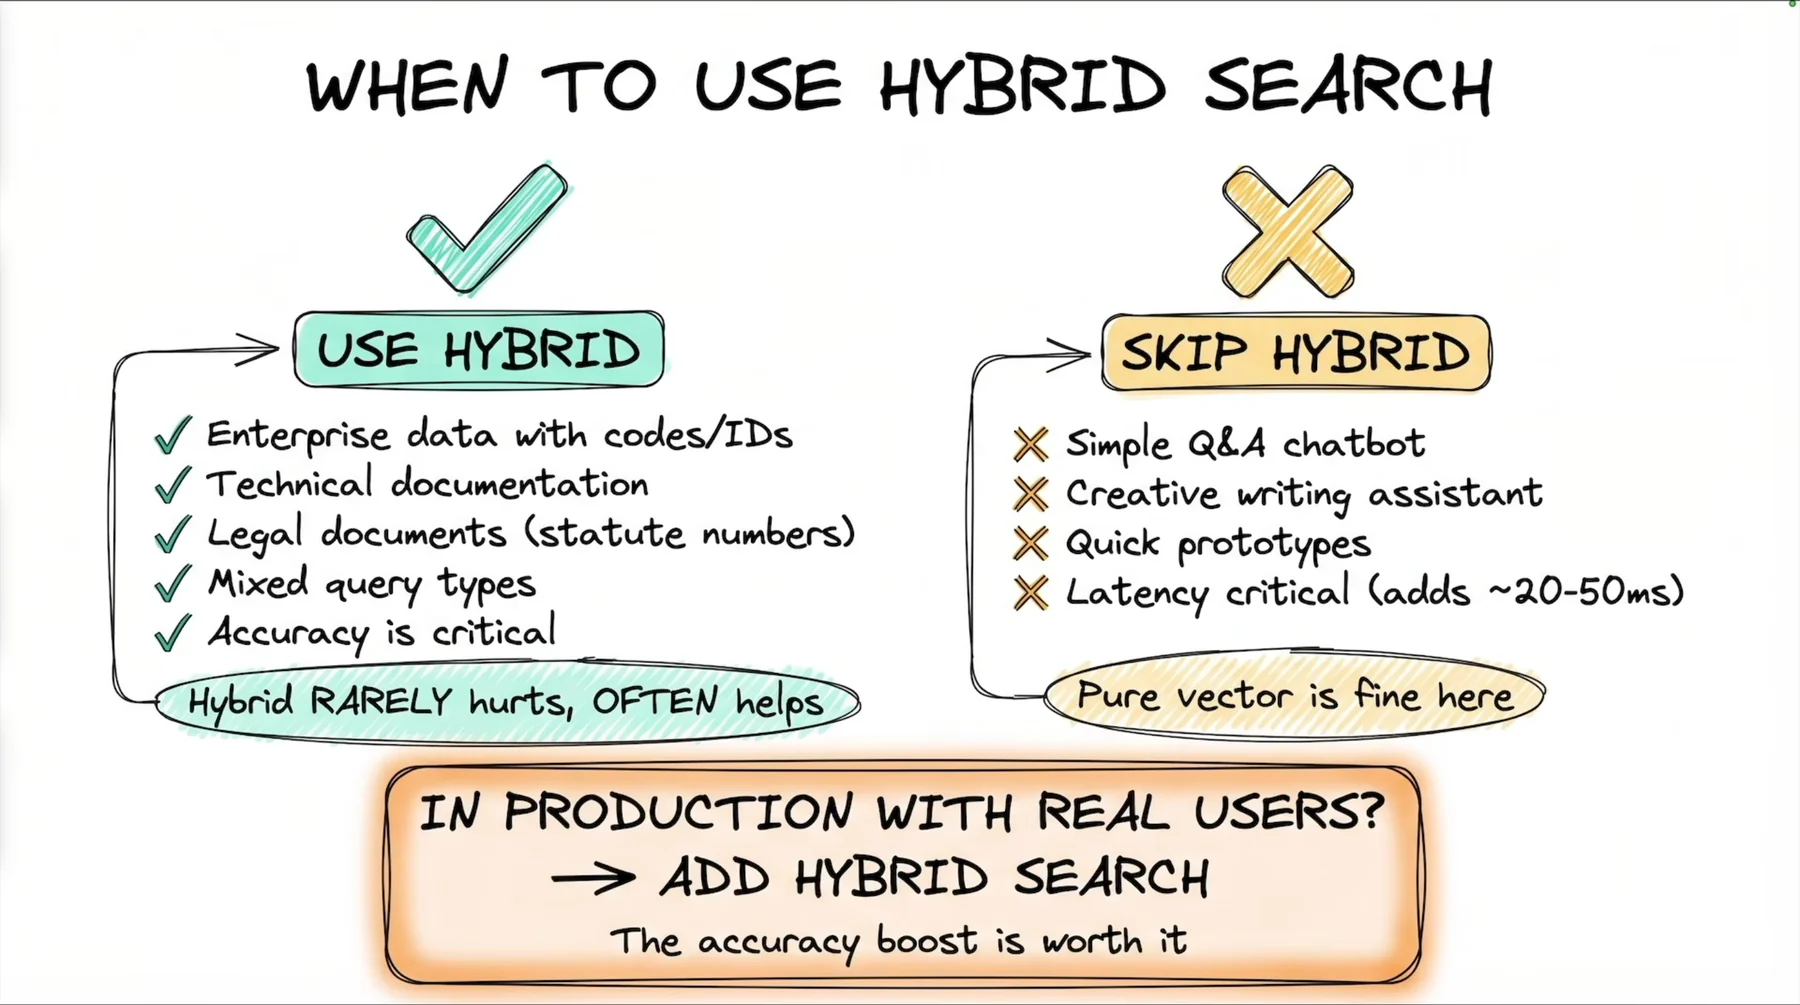
| Añade búsqueda híbrida | Omite la búsqueda híbrida |
|---|---|
| Datos empresariales con códigos / ID | Chatbot sencillo de Q&A |
| Documentación técnica | Asistente de escritura creativa |
| Documentos jurídicos (números de artículos legales) | Prototipos rápidos |
| Tipos de query mixtos | Rutas críticas en latencia (añade ~20–50 ms) |
| La precisión es crítica | |
| «El híbrido RARA VEZ perjudica, A MENUDO ayuda» | «Aquí basta con el vectorial puro» |
«¿En producción con usuarios reales? → Añade búsqueda híbrida. La mejora de precisión lo vale». — diapositiva 04, repetido en 02:00:59
El coste del híbrido es tiempo, no corrección 02:00:59. Ejecutas dos retrievals en lugar de uno. Presupuesta ~20–50 ms y ten en cuenta que se suman a tu llamada de embedding, a tu búsqueda vectorial y (si las añades) a tus llamadas de compresión y generación: los tres presupuestos de la Parte 1 están siempre en tensión, y este gasta latencia para comprar calidad.
Consideraciones de producción para la búsqueda híbrida
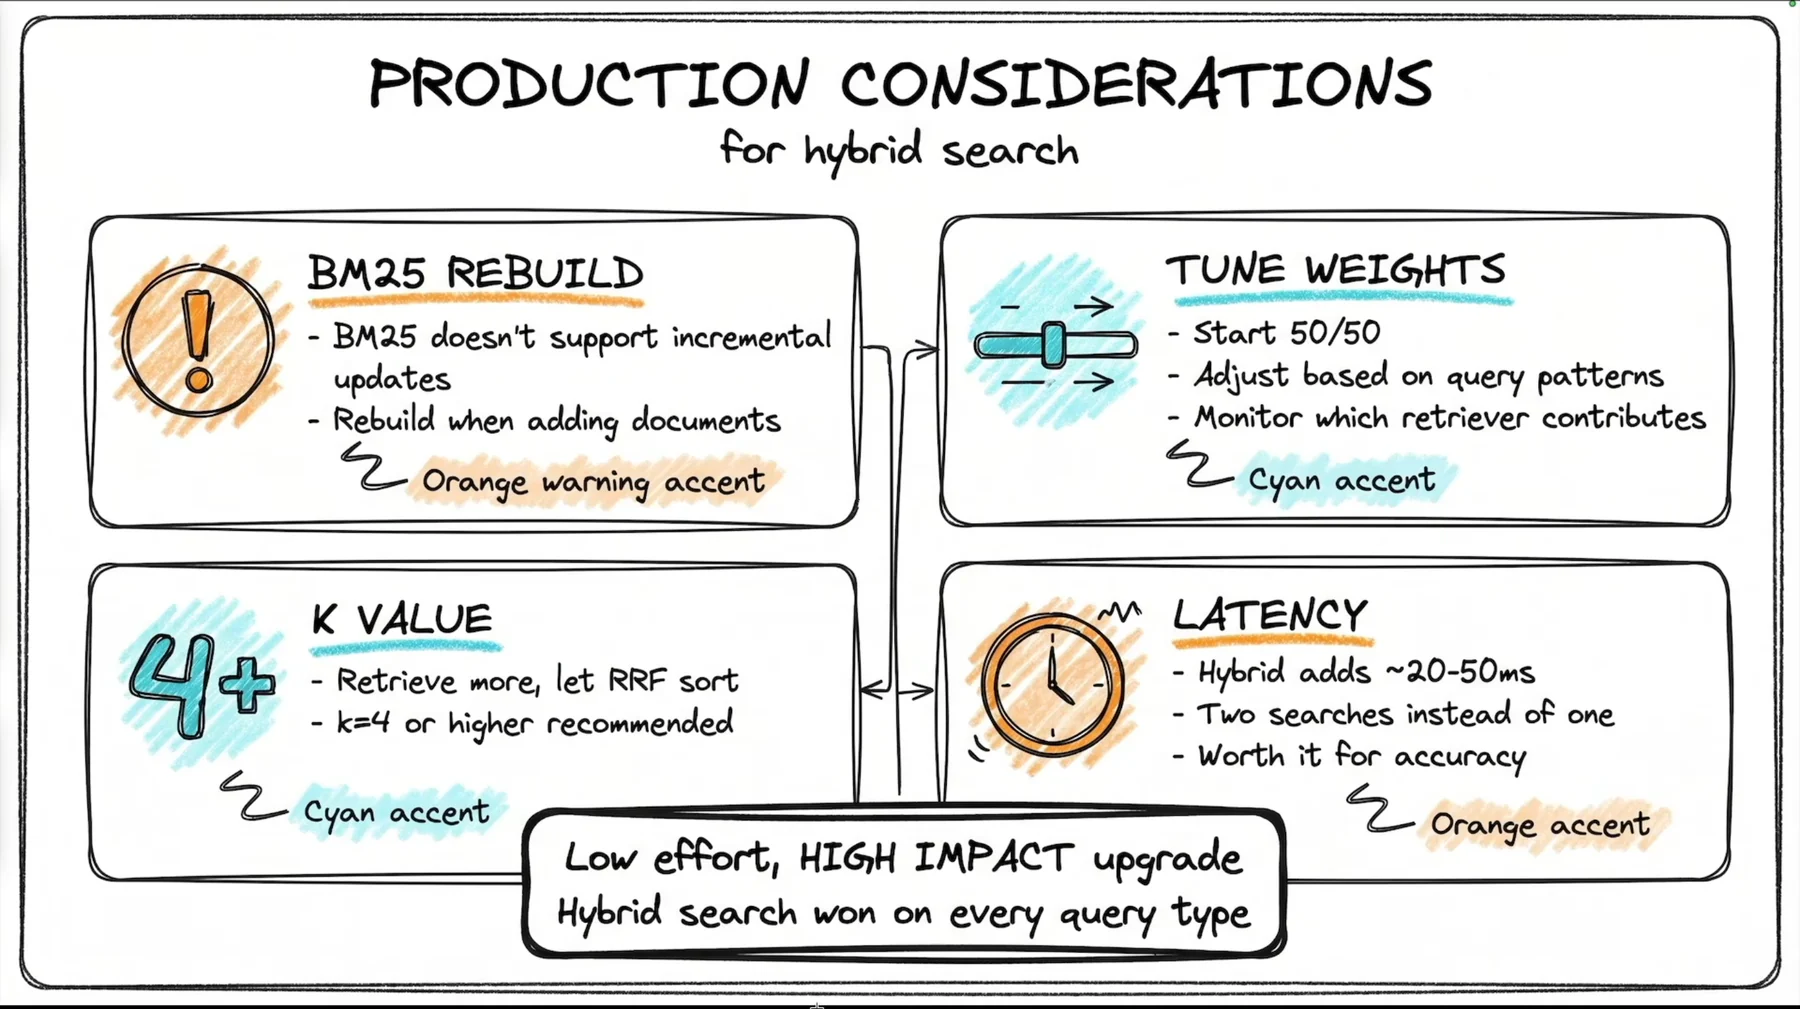
1. BM25 no tiene actualizaciones incrementales: esta es la trampa
El instructor lo señala dos veces, con un minuto de diferencia, y lo precede de un «muy muy muy importante» 02:11:06, 02:12:09. No puedes añadir documentos a un índice BM25. El vectorizador BM25Okapi calcula estadísticas de todo el corpus (frecuencias de documento, longitud media de documento, el suelo del idf) en el momento de la construcción. Añadir un documento las invalida todas.
Así que el fallo tiene este aspecto: llamas a vector_store.add_documents(new_docs), todo va bien, no se lanza ninguna excepción… y los documentos nuevos son invisibles para la rama de palabras clave para siempre. Tu retriever híbrido se degrada poco a poco hasta ser un retriever vectorial con latencia extra, y la degradación es proporcional a la parte de tu corpus que llegó después del arranque. Es el ejemplo más puro del invariante 4 de toda esta guía.
La solución es estructural: haz que sea imposible olvidar la reconstrucción poniendo ambas escrituras detrás de un único método.
# The production skeleton described at [02:10:05]-[02:11:06]. The class name and method
# names are as spoken; the file shown on screen (hybrid_search/prod_hybrid_search.py) is
# NOT present in either published repo, so this is reconstructed from the walkthrough
# plus the verified APIs above. `weighted_rrf` is the fallback function from the toggle.
from langchain_chroma import Chroma
from langchain_openai import OpenAIEmbeddings
from langchain_community.retrievers import BM25Retriever


class HybridRetriever:
    def __init__(self, documents, collection_name="hybrid", k=4,
                 weights=(0.5, 0.5), embeddings=None):
        # Swappable: "you can change that to whatever you need"
        self.embeddings = embeddings or OpenAIEmbeddings(model="text-embedding-3-small")
        self.documents = list(documents)
        self.k = k
        self.weights = weights

        # No persist_directory => this Chroma collection is in-memory and dies with the
        # process, re-embedding the whole corpus on every boot. Pass one in production.
        self.vector_store = Chroma.from_documents(
            documents=self.documents,
            embedding=self.embeddings,
            collection_name=collection_name,
        )
        self.vector_retriever = self.vector_store.as_retriever(
            search_kwargs={"k": self.k}
        )
        self._build_bm25()

    def _build_bm25(self):
        """BM25 has no incremental update path — it is always rebuilt from scratch."""
        if not self.documents:          # from_documents unpacks a zip(*...) and
            self.bm25_retriever = None  # raises ValueError on an empty corpus
            return
        self.bm25_retriever = BM25Retriever.from_documents(self.documents, k=self.k)

    def search(self, query):
        if self.bm25_retriever is None:
            return self.vector_retriever.invoke(query)
        return weighted_rrf(
            [self.bm25_retriever.invoke(query), self.vector_retriever.invoke(query)],
            weights=list(self.weights),
        )

    def add_documents(self, docs):
        # Give every Document a stable `id`: langchain-chroma calls collection.upsert(),
        # so ids make a replayed ingest idempotent. Without them it mints a fresh UUID
        # per call and a re-run silently duplicates your corpus (the Part 4 rule).
        self.vector_store.add_documents(docs)   # incremental — cheap
        self.documents.extend(docs)
        self._build_bm25()                      # MANDATORY full rebuild — not cheap
La asimetría de add_documents es toda la lección, y es el invariante 3 con el signo cambiado: la escritura en el vector store es incremental y barata; la escritura en BM25 es O(corpus) y se repite en cada ingesta. Con 1,000 documentos nadie lo nota. Con 500,000 documentos, una ingesta que se dispara una vez por minuto pasará la mayor parte de su vida volviendo a tokenizar el corpus, y self.documents es una copia completa en memoria de tu texto, además de la copia del vector store.
Tu ruta de escalado, por orden:
- Reconstruye por lotes. Acumula los documentos nuevos y reconstruye BM25 de forma programada (cada N minutos / N documentos) en lugar de en cada llamada. Acepta una ventana de desfase acotada en la rama de palabras clave y déjala por escrito: es un contrato de corrección, no un detalle de implementación.
- Doble búfer. Construye el nuevo
BM25Retrieveren una variable local y reasigna el atributo solo cuando esté completo, para que las queries concurrentes nunca vean un índice a medio construir. - Lleva la búsqueda por palabras clave a la base de datos.
tsvector+ts_rankde Postgres, o el modo híbrido nativo de tu base de datos vectorial, te dan un índice de palabras clave realmente incremental y eliminan este problema por completo. Esa es la mejora de la Parte 10 (pgvector / Supabase), y esta trampa es la razón principal para hacerla.
2. El valor de k: recupera en amplitud y deja que RRF estreche
La recomendación es k = 4 o más, «y que RRF lo ordene todo» 02:12:09; la diapositiva 06 lo resume en «Recupera más, deja que RRF ordene». La intuición es mecánica: la fusión necesita candidatos que conciliar. Con k=1 o k=2 casi no hay nada que fusionar y habrás pagado 20–50 ms por un error de redondeo. Fíjate en que en la demo ambas ramas se ejecutan con k=3 —por debajo del propio consejo de la diapositiva—, lo cual está bien para ocho documentos y no para ochenta mil.
Una forma razonable para producción: k=10–20 por rama hacia la fusión, y luego quedarte con los 3–5 mejores después de la fusión (y después del reranking, más abajo). La etapa de fusión es casi gratuita; la que te cobra por token es la de generación.
3. Monitoriza qué retriever contribuye
El panel «TUNE WEIGHTS» (ajustar pesos) de la diapositiva 06 dice monitoriza qué retriever contribuye, y es el único punto de la diapositiva que no tiene código en ninguna parte del curso. Impleméntalo tú: son unas seis líneas, y sin ello «ajusta según tus patrones de queries» no es accionable:
# Attribution: for each query, log which branch supplied each surviving document.
def attribute(fused, bm25_docs, vector_docs, id_key=None):
    def key(d):
        return d.page_content if id_key is None else d.metadata[id_key]

    bm25_keys = {key(d) for d in bm25_docs}
    vector_keys = {key(d) for d in vector_docs}
    return [
        {
            "rank": i,
            "in_bm25": key(d) in bm25_keys,
            "in_vector": key(d) in vector_keys,
            "source": d.metadata.get("source"),
        }
        for i, d in enumerate(fused, start=1)
    ]
Envía eso a tus logs estructurados (Parte 7) y podrás responder, semana a semana: ¿qué fracción de los documentos del top-3 vino solo de BM25? Si es ~0%, tu rama de palabras clave es peso muerto: o tus pesos están mal, o tu tokenizador se está comiendo tus códigos, o de verdad no necesitas búsqueda híbrida. Si es el 30%, has cuantificado la mejora y tienes la evidencia que justifica mover los pesos.
4. Latencia
~20–50 ms, porque haces dos búsquedas en lugar de una. Las dos ramas son independientes y deberían ejecutarse de forma concurrente: EnsembleRetriever.arank_fusion hace exactamente eso con asyncio.gather, mientras que el rank_fusion síncrono las ejecuta en una simple list comprehension. En la ruta síncrona pagas la suma; en la asíncrona pagas el máximo. Usa ainvoke en cualquier servicio sensible a la latencia.
«Mejora de poco esfuerzo y ALTO IMPACTO». — diapositiva 06
Ese distintivo es justo. De todo lo que hay en esta parte, la búsqueda híbrida es lo que mejor relación tiene entre líneas de código y calidad recuperada —tres componentes, ninguna llamada al LLM, ningún re-embed—, siempre que hagas bien la reconstrucción. Sáltate la reconstrucción y el esfuerzo sigue siendo bajo mientras el impacto se vuelve negativo.
Reranking: lo que promete la fuente y lo que cumple
Hablemos claro. El curso menciona el reranking como la solución al modo de fallo n.º 3 en su tabla inicial, y el README que lo acompaña lo incluye en «Part 3 — Optimize for Quality». Pero no hay ningún reranker en ninguno de los dos repos publicados. Ni cross-encoder, ni Cohere Rerank, ni CrossEncoderReranker: ni un solo punto de llamada. Lo más cerca que llega la fuente es una lección vecina que recomienda combinar el contextual retrieval (Parte 14) con la búsqueda híbrida BM25 «para obtener los mejores resultados». Trata esa ausencia como un hueco de la fuente, no como una señal de que el reranking sea opcional: esta parte te da un arnés de medición y un conjunto de candidatos, y el reranking es la segunda etapa estándar sobre ellos.
Es importante que entiendas la diferencia, porque a menudo, y de forma errónea, se llama reranking a RRF:
| Fusión de rankings (RRF) | Reranking (cross-encoder) | |
|---|---|---|
| Entrada | N listas ordenadas | 1 lista de candidatos + la query |
| ¿Ve la query? | No: solo posiciones | Sí, conjuntamente con cada documento |
| Modelo | Ninguno; pura aritmética | Un modelo de relevancia entrenado |
| Coste | Microsegundos | Una pasada del modelo por candidato |
| Corrige | Una rama no encontró el documento | El documento correcto se recuperó pero quedó en la posición 7 |
Un bi-encoder (tu embedding model) codifica la query y el documento por separado y compara los dos vectores: rápido, indexable y con pérdidas, porque el vector del documento se calculó sin ver nunca tu query. Un cross-encoder pasa (query, document) por el modelo a la vez y devuelve un score de relevancia. No se puede indexar, así que nunca puede ser tu retriever de primera etapa; es exclusivamente una segunda etapa sobre un conjunto pequeño de candidatos.
El entorno fijado ya incluye la maquinaria, aunque el curso nunca la toca:
# .venv/.../langchain_classic/retrievers/document_compressors/__init__.py
__all__ = [
    "CohereRerank",
    "CrossEncoderReranker",
    "DocumentCompressorPipeline",
    "EmbeddingsFilter",
    "FlashrankRerank",
    "LLMChainExtractor",
    "LLMChainFilter",
    "LLMListwiseRerank",
]
Y el reranker son cuatro líneas de trabajo real; no tiene ningún misterio:
# .venv/.../langchain_classic/retrievers/document_compressors/cross_encoder_rerank.py
class CrossEncoderReranker(BaseDocumentCompressor):
    """Document compressor that uses CrossEncoder for reranking."""

    model: BaseCrossEncoder
    top_n: int = 3

    def compress_documents(self, documents, query, callbacks=None):
        scores = self.model.score([(query, doc.page_content) for doc in documents])
        docs_with_scores = list(zip(documents, scores, strict=False))
        result = sorted(docs_with_scores, key=operator.itemgetter(1), reverse=True)
        return [doc for doc, _ in result[: self.top_n]]
Fíjate en la forma: en LangChain, un reranker es un BaseDocumentCompressor, así que se conecta al mismo wrapper ContextualCompressionRetriever que el extractor de más abajo. Ese es el truco de composición que hace intercambiable a toda la familia, y significa que añadir un reranker al pipeline híbrido que acabas de construir es un wrapper, no una reescritura:
# Wiring a reranker over the hybrid retriever. NOTE: `HuggingFaceCrossEncoder` needs
# `sentence-transformers`, which the course's pinned environment does NOT install —
# `uv add sentence-transformers` first, and expect a model download on first run.
from langchain_classic.retrievers import ContextualCompressionRetriever
from langchain_classic.retrievers.document_compressors import CrossEncoderReranker
from langchain_community.cross_encoders import HuggingFaceCrossEncoder

reranked = ContextualCompressionRetriever(
    base_compressor=CrossEncoderReranker(
        model=HuggingFaceCrossEncoder(model_name="BAAI/bge-reranker-base"),  # the default
        top_n=3,
    ),
    base_retriever=ensemble_retriever,   # wide first stage: k=10-20 per branch
)
Hay dos cosas que ese fragmento no oculta. El cross-encoder se ejecuta en local sobre CPU a menos que le des una GPU, así que su coste por candidato es latencia que asumes tú y no una factura de API, y por eso precisamente importa el presupuesto de k «amplio y luego estrecho». Y CrossEncoderReranker se declara con extra="forbid", así que un nombre de campo mal escrito lanza un error en la construcción en lugar de ignorarse en silencio.
Como el curso no te da ningún número sobre reranking, no te inventes ninguno, y desconfía de quien te cite uno sin nombrar el dataset. Lo que el curso sí te da es una aproximación más barata, basada en el LLM, de la misma idea, y está dos secciones más abajo.
Parent-document retrieval: busca en pequeño, devuelve en grande
Esta es la respuesta del capítulo a un dilema real que te encontraste en la Parte 3 y que no pudiste resolver allí, porque no tiene solución en tiempo de chunking.
| Precisión de búsqueda | Completitud del contexto para el LLM | |
|---|---|---|
| Solo chunks pequeños (200 caracteres) | Alta: embedding enfocado, match nítido | Baja: fragmentado; «la respuesta podría hacer referencia a algo de un párrafo anterior o siguiente» 02:53:17 |
| Solo chunks grandes (2,000 caracteres) | Baja: embedding diluido; «matching menos preciso, y podría perderse el mejor match» 02:54:18 | Alta |
| Parent-document | Alta | Alta |
«Chunks pequeños para la búsqueda y contexto grande, porque los chunks pequeños van a estar conectados a su padre, que es un chunk grande». 02:50:15
El instructor lo presenta con el respaldo más rotundo del capítulo: «si vas en serio con la calidad del RAG, esta es la mejora que más importa» 02:50:15. Tómalo como entusiasmo, no como una medición: a diferencia del A/B de chunking de la Parte 3, este patrón nunca se somete a benchmark en la fuente. Lo que sí se demuestra es el mecanismo, y el mecanismo es sólido.
El mecanismo son dos splitters y dos stores. Solo se hace embedding de los hijos y solo ellos se indexan; los padres viven en un store simple clave→documento y se recuperan por id después de la búsqueda. El trabajo del hijo es ser encontrable; el del padre, ser legible.
# production-course-main-code/advanced_rag.py — demo_parent_document_retriever() (abridged)
from langchain_classic.retrievers import ParentDocumentRetriever
from langchain_classic.storage import InMemoryStore

# Splitters
parent_splitter = RecursiveCharacterTextSplitter(chunk_size=800, chunk_overlap=100)
child_splitter = RecursiveCharacterTextSplitter(chunk_size=200, chunk_overlap=20)

# Storage
vectorstore = Chroma(
    collection_name="parent_child_demo",
    embedding_function=OpenAIEmbeddings(model="text-embedding-3-small"),
)
store = InMemoryStore()

# Create retriever
retriever = ParentDocumentRetriever(
    vectorstore=vectorstore,
    docstore=store,
    child_splitter=child_splitter,
    parent_splitter=parent_splitter,
)

# Add document — this does the splitting AND both writes
retriever.add_documents([long_doc])

query = "What is LangGraph used for?"

# Regular retrieval (would get small chunks)
child_docs = vectorstore.similarity_search(query, k=1)
print("\n--- Child Chunk (what search found) ---")
print(f"Length: {len(child_docs[0].page_content)} chars")

# Parent retrieval (gets full context)
parent_docs = retriever.invoke(query)
print("\n--- Parent Chunk (what's returned) ---")
print(f"Length: {len(parent_docs[0].page_content)} chars")
Con el documento de la demo (ai_agents_guide.md, una guía en Markdown con capítulos ##) y la query «What is LangGraph used for?», el chunk hijo con el que hizo match la búsqueda tenía 173 caracteres y el padre que se devolvió al LLM tenía 675 caracteres 02:52:16– 02:53:17. Imprimir ambos, uno al lado del otro, es lo que hace legible el mecanismo: hazlo una vez en tu propio pipeline y no volverás a confundirlos.
Tres cosas más que te dice el código publicado y que el recorrido no menciona:
- El vínculo es un campo de metadatos.
ParentDocumentRetrieverextiendeMultiVectorRetriever, cuyoid_keypor defecto es"doc_id", yadd_documentsestampa_doc.metadata[self.id_key] = _iden cada hijo antes de indexarlo. Por tanto, el retrieval es: buscar hijos → recoger susdoc_id→docstore.mget(ids). Ese campo es también tuid_keynatural para la deduplicación de RRF si pones el parent-document detrás de un ensemble híbrido. parent_splitteres opcional. Omítelo y, según el propio docstring del campo, «the parent documents will be the raw documents passed in»; es decir, el LLM recibe el documento fuente entero. Es una buena opción para documentos cortos y una catástrofe para la context window con documentos largos.InMemoryStorees un atajo de demo 02:51:15, elegido, en palabras del instructor, «para no tener que lidiar con mucho». Los padres desaparecen al terminar el proceso mientras una colección de Chroma persistida sobrevive, lo que te deja con un índice lleno de hijos huérfanos cuyosdoc_idno apuntan a nada. En producción necesitas un docstore duradero (un file store, Redis o una tabladocumentscon clavedoc_id).
El coste del patrón es el almacenamiento: guardas los padres y los hijos. La tabla comparativa de técnicas de un capítulo posterior (fcc-production-rag-part-6/03_late_chunking.py:351) puntúa parent-child con ★★★ en calidad de contexto y ★★☆ en almacenamiento, y detalla la penalización como 2× vector store. El ejercicio que propone el instructor es el adecuado: «busca documentos quizá más grandes y pruébalo» 02:54:18; con el diminuto documento de la demo, el beneficio solo es sugerente, y no deberías asumir un coste de almacenamiento de 2× por una sugerencia.
Compresión contextual: paga en el retrieval para ahorrar en la generación
El parent-document retrieval hace el contexto más grande. La compresión lo hace más pequeño. No se contradicen: actúan sobre enfermedades distintas. El parent-document corrige los fragmentos; la compresión corrige el relleno.
La compresión contextual es extracción, no resumen 02:55:18. Cada chunk recuperado se envía a un LLM junto con la query, y el modelo devuelve solo los fragmentos que la responden. Puedes leer el prompt exacto en el paquete instalado, y zanja de forma definitiva la pregunta de si parafrasea:
# .venv/.../langchain_classic/retrievers/document_compressors/chain_extract_prompt.py
# (the first paragraph is one long line in the source; wrapped here to fit the page)
prompt_template = """Given the following question and context, extract any part of the
context *AS IS* that is relevant to answer the question. If none of the context is
relevant return {no_output_str}.

Remember, *DO NOT* edit the extracted parts of the context.

> Question: {{question}}
> Context:
>>>
{{context}}
>>>
Extracted relevant parts:"""
{no_output_str} se rellena con NoOutputParser.no_output_str, el string literal "NO_OUTPUT"; el parser convierte esa respuesta en un string vacío, y LLMChainExtractor.compress_documents se salta cualquier documento cuya salida tenga longitud cero. Así que la compresión es a la vez un extractor y un filtro: los chunks irrelevantes no vuelven más cortos; no vuelven en absoluto.
El cableado es un decorador sobre cualquier retriever:
# production-course-main-code/advanced_rag.py — demo_contextual_compression() (abridged)
from langchain_classic.retrievers import ContextualCompressionRetriever
from langchain_classic.retrievers.document_compressors import LLMChainExtractor

vectorstore = create_base_vectorstore()
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# Create compressor
compressor = LLMChainExtractor.from_llm(llm)

# Wrap retriever with compression
compression_retriever = ContextualCompressionRetriever(
    base_compressor=compressor,
    base_retriever=vectorstore.as_retriever(search_kwargs={"k": 4}),
)

query = "What frameworks exist for building LLM applications?"

# Without compression
base_docs = vectorstore.as_retriever(search_kwargs={"k": 2}).invoke(query)
for doc in base_docs:
    print(f"Length: {len(doc.page_content)} chars")

# With compression
compressed_docs = compression_retriever.invoke(query)
for doc in compressed_docs:
    print(f"Length: {len(doc.page_content)} chars")
Hay dos asimetrías en ese fragmento que es fácil pasar por alto, y ambas importan. La línea base se ejecuta con k=2 y la ruta comprimida con k=4, así que las listas de «antes» y «después» no contienen los mismos documentos: es una demostración, no una comparación controlada. Y como recibe un base_retriever, ContextualCompressionRetriever se compone sobre cualquier cosa: ensembles híbridos, multi-query, parent-document. Esa única decisión de diseño es la razón de que el reranker de arriba tenga la misma interfaz.
La demo que parecía rota, y por qué esa es la lección valiosa
Primera ejecución, sobre el corpus limpio TECH_DOCS: 203 → 203 caracteres y 245 → 243 caracteres 02:57:22. Prácticamente no pasó nada.
«Puede parecer que no ha funcionado. En realidad sí ha funcionado… los datos de prueba que tenemos ya son bastante limpios y relevantes». 02:57:22–02:58:24
Si cada chunk recuperado ya está al 100% dentro del tema, no hay nada que comprimir. Es el resultado negativo más útil del capítulo, porque te dice exactamente cuándo la compresión se gana el sueldo y cuándo es puro coste. Los chunks cortos y temáticamente puros —el resultado natural de un buen chunking recursivo sobre documentación bien estructurada— no tienen relleno que quitar.
Vigila el volumen de llamadas mientras lo ejecutas. La demo hace dos llamadas al retriever —la línea base con k=2 y la ruta comprimida con k=4—, así que dos embeddings de query, y luego una completion por cada chunk que devolvió el retriever comprimido. El instructor las cuenta en el terminal en 02:56:20, pero los subtítulos destrozan el recuento, así que toma la cifra del código y no del audio: compress_documents recorre la lista de candidatos exactamente una vez, con un invoke por documento. La compresión es la primera técnica de esta guía en la que el retriever deja de ser pura matemática vectorial y empieza a costar inferencia.
Para hacerlo visible, escribió INFO_BURIED: dos documentos largos —acme_company_overview.pdf y technical_docs_v2.4.pdf— en los que un par de párrafos relevantes quedan enterrados entre la historia de la empresa (fundada en 2018, un garaje de Palo Alto, oficinas en Austin y Seattle, ingresos de 2 M$ → 45 M$, Serie B con una valoración de 500 M$, seguro médico de Aetna) y detalles de infraestructura (AWS EKS, Istio, DataDog, RTO de 4 horas, RPO de 1 hora). Dos párrafos —uno sobre LangChain y otro sobre LangGraph— responden realmente a la query. Luego apuntó la factoría del vector store a INFO_BURIED en lugar de a TECH_DOCS y no cambió nada más.
Segunda ejecución: 1,703 caracteres → 214 caracteres, y un segundo documento de «más de 1,500» caracteres que se reduce de forma parecida. Él lo llama «una reducción de entre el 87 y el 82%» 03:00:26, citando el rango al revés; 1,703→214 es ≈87.4%, y el segundo es ≈82%. Después lo resume como «un 85% menos de tokens en nuestro prompt final» 03:01:29. Las tres cifras son la misma medición sobre un único documento de demo construido a mano, no un benchmark: tómalas como orientativas.
Lo que desapareció es tan instructivo como el porcentaje: antes de la compresión, el contexto llevaba la historia fundacional, las ubicaciones de las oficinas y todo el capítulo de arquitectura de AWS; después, solo sobrevivieron los párrafos de LangChain y LangGraph 03:00:26. El extractor se comportó exactamente como le indica su prompt: leyó cada chunk, se preguntó «¿qué parte de esto responde a what frameworks exist for building LLM applications?» y devolvió esos fragmentos literalmente.
Los tres beneficios que se afirman 03:01:29–03:02:31, con la contabilidad honesta de cada uno:
| Beneficio | Mecanismo | La pega |
|---|---|---|
| Menor coste | ~85% menos tokens de contexto en el prompt de generación | Gastas tokens de LLM en tiempo de retrieval para ahorrarlos en tiempo de generación |
| Mejores respuestas | Menos ruido; «ningún riesgo de que el LLM se distraiga con la historia de la empresa o con detalles de infraestructura» | Solo es cierto cuando había ruido |
| Más rápido | Contexto más pequeño → inferencia más rápida, «especialmente notable con documentos más grandes» | Has añadido un viaje de ida y vuelta al LLM por cada chunk recuperado antes de la generación |
Esa última pega es todo el compromiso, dicho claramente en 03:02:31: «llamadas extra a la completion… lo que significa coste de LLM en tiempo de retrieval». Con k=4 haces cuatro llamadas extra al LLM por cada query del usuario. compress_documents las ejecuta en un bucle for en serie en la ruta síncrona; acompress_documents usa llm_chain.abatch, así que la ruta asíncrona es muchísimo más rápida con el mismo gasto. Usa ainvoke.
Las tres condiciones en las que la compresión merece la pena 03:02:31:
- Los documentos son grandes y de contenido mixto.
- Necesitas un retrieval preciso y enfocado.
- El coste en tokens importa a escala.
Inviértelo y tendrás la regla para omitirla: chunks pequeños y limpios, ruta sensible a la latencia, poco volumen → no comprimas.
Un modo de fallo contra el que protegerse: si el extractor devuelve NO_OUTPUT para todos los candidatos, tu retriever devuelve cero documentos y tu chain formatea un string de contexto vacío. El LLM responde entonces desde su memoria paramétrica, salvo que tu prompt tenga la cláusula de fallback de la Parte 1. Prueba siempre la ruta de contexto vacío.
Multi-query: corrige la query, no el índice
La búsqueda híbrida corrige queries cuyos tokens no sirven para un índice vectorial. El multi-query corrige queries cuya formulación no sirve: una pregunta del usuario se convierte en N reformulaciones, se hace retrieval para cada una y la unión se deduplica 03:06:38. La deduplicación no es simple contabilidad: es donde aparece el valor, porque un documento que sale con tres formulaciones distintas de la pregunta es un documento en el que coinciden tres sondas independientes.
Esta es también la respuesta a la pregunta que todo el mundo se hace al ver el constructor: ¿por qué un *retriever* necesita un argumento llm=? 03:07:39 Porque generar las variaciones es una llamada al LLM. El multi-query es el primer retriever de esta parte que cuesta una completion antes de tocar el índice.
El prompt de generación tampoco tiene misterio: es una constante del paquete:
# .venv/.../langchain_classic/retrievers/multi_query.py
DEFAULT_QUERY_PROMPT = PromptTemplate(
    input_variables=["question"],
    template="""You are an AI language model assistant. Your task is
    to generate 3 different versions of the given user
    question to retrieve relevant documents from a vector  database.
    By generating multiple perspectives on the user question,
    your goal is to help the user overcome some of the limitations
    of distance-based similarity search. Provide these alternative
    questions separated by newlines. Original question: {question}""",
)
Tres variaciones, fijadas en la plantilla por defecto: de ahí sale el «3» del recorrido, no de un parámetro. Pasa tu propio prompt= para cambiarlo. La salida la parsea LineListOutputParser, que divide por saltos de línea y descarta las líneas vacías, así que un modelo que responda con una lista numerada te entregará variaciones con el prefijo 1. , 2. : inofensivo para el retrieval, feo en los logs.
# production-course-main-code/advanced_rag.py — demo_multi_query_retriever() (abridged)
from langchain_classic.retrievers.multi_query import MultiQueryRetriever

# Enable logging to see multi-query generation  (module top, lines 25-27)
logging.basicConfig(level=logging.INFO, format="%(name)s - %(message)s")
logging.getLogger("langchain.retrievers.multi_query").setLevel(logging.INFO)

vectorstore = create_base_vectorstore()
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.3)

# Create multi-query retriever
retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(search_kwargs={"k": 2}), llm=llm
)

query = "What tools can I use to build AI applications?"
print("(Check INFO logs above for generated queries)\n")

docs = retriever.invoke(query)
print(f"Retrieved {len(docs)} unique documents:")
Puntos que conviene interiorizar:
temperature=0.3, no 0. Quieres variación en las reformulaciones. Es uno de los pocos sitios de toda la guía en los que una temperatura distinta de cero es el valor por defecto correcto.- Tienes que activar el logging en INFO para ver las reescrituras 03:04:38. Por defecto son invisibles, lo que significa que estás pagando por la expansión de queries sin ninguna visibilidad sobre si las expansiones tienen sentido. Eso es inaceptable en producción.
- El coste son N llamadas de embedding más una completion, por cada query del usuario. Con tres variaciones, la ejecución hizo tres llamadas al endpoint de embeddings y devolvió 3 documentos únicos 03:08:40. El
k=2por variación supone hasta 6 resultados que se reducen a 3 tras la deduplicación. - La deduplicación es igualdad exacta de objetos.
_unique_documentses[doc for i, doc in enumerate(documents) if doc not in documents[:i]]: una comparación deDocument, así que un texto idéntico con metadatos distintos sobrevive como dos entradas. Combínalo con parent-document o con un loader que estampe metadatos y puedes acabar con casi-duplicados en el contexto. include_originalvaleFalsepor defecto. La pregunta literal del usuario no está entre las queries para las que se hace retrieval salvo que lo pidas. Si tus usuarios escriben queries técnicas precisas, fijainclude_original=True; si no, habrás sustituido su redacción exacta por la paráfrasis de un LLM, que es justo lo queRunnablePassthroughexiste para evitar en la mitad de generación de la chain.
El multi-query es una herramienta de recall: existe para meter el documento correcto en el conjunto de candidatos. Combínalo con una herramienta de precision (compresión o un reranker) o simplemente habrás hecho tu contexto más ruidoso.
Componer la pila
Cada técnica de esta parte recibe un BaseRetriever y devuelve un BaseRetriever, lo que significa que se pueden anidar. La demo más avanzada del repo apila dos de ellas:
# production-course-main-code/advanced_rag.py — demo_advanced_rag_chain() (abridged)
vectorstore = create_base_vectorstore()
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# Multi-query for better recall
multi_retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(search_kwargs={"k": 3}), llm=llm
)

# Compression to focus on relevant info
compressor = LLMChainExtractor.from_llm(llm)
advanced_retriever = ContextualCompressionRetriever(
    base_compressor=compressor, base_retriever=multi_retriever
)

prompt = ChatPromptTemplate.from_template(
    """
Answer the question based on the following context. Be specific and cite which technologies you're referring to.

Context:
{context}

Question: {question}

Answer:"""
)

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

rag_chain = (
    {"context": advanced_retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
Primero el recall, la precision al final. El multi-query amplía (3 variaciones × k=3 → hasta 9 candidatos) y la compresión estrecha. Invertir el orden comprimiría documentos que estás a punto de descartar: puro desperdicio.
Haz la aritmética antes de publicar esto, porque es en la composición donde se va el dinero. Una pregunta del usuario a través de esa chain cuesta: 1 completion (generación de queries) + 3 llamadas de embedding + 3 búsquedas vectoriales + hasta 9 completions (una por cada candidato superviviente, en serie) + 1 completion (la respuesta). Eso son hasta 11 viajes de ida y vuelta al LLM por una sola pregunta. Es una arquitectura legítima para una herramienta interna de poco volumen y mucho valor, y una claramente equivocada para un chatbot público. La Parte 9 —que se encarga tanto del presupuesto de tokens que rechaza una request antes de gastar nada de eso como de las caches que evitan que pagues dos veces— existe precisamente para esta chain.
Esta es la regla de ordenación generalizada:
| Etapa | Técnica | Dirección | Coste |
|---|---|---|---|
| 1 | Expansión de la query (multi-query) | Ampliar | 1 llamada al LLM + N embeddings |
| 2 | Retrieval híbrido (vectorial + BM25 → RRF) | Ampliar | ~20–50 ms, 1 embedding |
| 3 | Filtro de metadatos | Estrechar | Gratis (en el índice) |
| 4 | Rerank (cross-encoder) | Estrechar | 1 pasada del modelo por candidato |
| 5 | Compresión / extracción | Estrechar | 1 llamada al LLM por chunk superviviente |
| 6 | Expansión al padre (consulta al docstore) | Ampliar (deliberadamente) | 1 get clave-valor por resultado |
La expansión al padre va al final a propósito: quieres seleccionar sobre hijos enfocados y luego entregarle al LLM padres completos. Seleccionar sobre los padres echa por tierra todo el patrón.
Citas: hacer que la respuesta sea auditable
Una calidad de retrieval que el usuario no puede verificar es una afirmación, no un resultado. La cadena de confianza de la Parte 1 —fuentes → citas → verificabilidad → confianza— replantea la precisión como auditabilidad: el trabajo del sistema es abaratar la comprobación, no que le crean.
Lo notable es el poco código que hace falta. Comparadas con la chain RAG básica, las citas son un cambio en el prompt y un cambio en el formateador, nada más 03:09:42–03:11:49.
Viene acompañado de una pequeña refactorización, hecha en directo y conservada en el repo: el LLM se saca de las funciones de demo y se sube a nivel de módulo —llm = init_chat_model(model="gpt-4o-mini", temperature=0.2) en la línea 58—, de modo que todas las chains del archivo comparten un único cliente 03:09:42. Es un detalle menor, pero es la forma que quieres: una declaración de modelo por módulo, la misma disciplina que el invariante 2 exige al embedding model.
# production-course-main-code/rag_pipeline.py — demo_rag_with_sources()
def demo_rag_with_sources():

    vectorstore = create_kb()
    retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

    prompt = ChatPromptTemplate.from_template(
        """
Answer the question based on the context below. Include which sources you used.

Context:
{context}

Question: {question}

Answer (include sources):"""
    )

    def format_docs_with_sources(docs):
        formatted = []
        for i, doc in enumerate(docs):
            source = doc.metadata.get("source", "unknown")
            formatted.append(f"[{i+1}] {source}:\n{doc.page_content}")
        return "\n\n".join(formatted)

    rag_chain = (
        {
            "context": retriever | format_docs_with_sources,
            "question": RunnablePassthrough(),
        }
        | prompt
        | llm
        | StrOutputParser()
    )

    answer = rag_chain.invoke("What are the core components of LangChain?")
Tres detalles sostienen todo el patrón:
- Las fuentes viajan *dentro* del string de contexto.
format_docs_with_sourcesantepone[n] <source>:al texto de cada chunk. El modelo nunca recibe metadatos por un canal aparte: lee la etiqueta de la cita como parte del documento, y por eso puede reproducirla.doc.metadata.get("source", "unknown")es la forma defensiva; unKeyErroraquí tumbaría la request por una etiqueta que falta. - El hueco de salida es el que pide.
Answer (include sources):hace tanto trabajo como la frase de instrucciones que tiene encima. Los modelos completan la forma que les das. - El esqueleto de la chain no cambia.
{"context": retriever | formatter, "question": RunnablePassthrough()} | prompt | llm | StrOutputParser(): idéntico a la chain básica de la Parte 5, idéntico a la chain avanzada de arriba.
«La mecánica es siempre la misma. Lo que cambia son, quizá, unas pocas cosas». 03:11:49
Esa es la conclusión estructural de toda esta parte. Híbrido, multi-query, compresión, parent-document y citas son cinco ediciones distintas de uno de los seis huecos de esa expresión. Nada más se mueve.
En la ejecución, la respuesta volvió con los cinco componentes principales de LangChain —models, prompts, chains, agents y memory— citados a langchain_knowledge_base.md, el source que se estampó en el documento en create_kb():
# production-course-main-code/rag_pipeline.py — create_kb()
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
doc = Document(
    page_content=KNOWLEDGE_BASE, metadata={"source": "langchain_knowledge_base.md"}
)
chunks = splitter.split_documents([doc])
split_documents propaga esos metadatos a cada chunk. Si el código hubiera usado split_text, la fuente se habría destruido en tiempo de chunking y ninguna cantidad de prompt engineering habría podido recuperarla. Lo que se puede citar se decide en tiempo de indexación: la misma regla que para lo que se puede filtrar en la Parte 4.
«Si estás construyendo un bot de Q&A, tener aquí esta cita es realmente importante». 03:11:49
La razón que da es de producto: una cita permite al usuario hacer clic y ver de dónde salió realmente la información.
Los límites de las citas basadas en el prompt
Ten claro lo que has construido: la cita es texto generado. El modelo copia una etiqueta que leyó en el prompt, y los modelos copian mal, fusionan e inventan etiquetas. Nada en este patrón garantiza que [2] se corresponda con el documento que realmente respaldaba la frase.
Dos medidas de refuerzo, ambas con código que ya tienes:
- Devuelve los documentos recuperados junto con la respuesta, para que tu UI enlace a los objetos chunk reales en lugar de parsear la prosa del modelo. Construye la chain con
RunnableParallel—ya importado enrag_pipeline.py— y conserva la ramadocs. - Pide estructura en lugar de prosa. El mismo archivo del repo ya lo hace, y el campo
sources_usedse puede comprobar automáticamente: puedes verificar con un assert que cada fuente devuelta aparece en el conjunto recuperado y marcar la request cuando no sea así:
# production-course-main-code/rag_pipeline.py — demo_structured_rag()
# (RAGResponse is declared inside the demo function in the repo)
class RAGResponse(BaseModel):
    """Structured RAG response."""

    answer: str = Field(description="The answer to the question")
    confidence: str = Field(description="high, medium, or low")
    sources_used: List[str] = Field(description="List of sources referenced")
    follow_up: str = Field(description="Suggested follow-up question")

structured_llm = llm.with_structured_output(RAGResponse)
Fíjate en que confidence es la autoevaluación del modelo tipada como un string libre, no una probabilidad calibrada y ni siquiera un enum restringido. Es una señal útil para ordenar la revisión humana y no vale nada como garantía de corrección: la regla de la Parte 1 sigue en pie: coherencia no es corrección, y la confianza tampoco.
Dos trampas de citas heredadas de la Parte 2 que aquí muerden con más fuerza:
pageempieza en 0,page_labeles un string que empieza en 1. Citapagey todas las citas de tu producto estarán desplazadas en uno.- Los documentos cargados desde rutas de
tempfilellevan metadatossourcebasura.create_kb()usatempfile.mkdtemp()para el directorio de persistencia de Chroma (bien, es almacenamiento), pero si alguna vez cargas documentos desde rutas temporales, la fuente que citas es una ruta que ya no existe. Carga desde rutas estables siempre que vayas a citar.
Procedencia: qué está verificado y qué no
Esta parte se basa en un capítulo con subtítulos generados automáticamente y en un repo que no coincide con el vídeo en varios puntos. Todo lo anterior está contrastado con el código publicado allí donde existe código publicado. Esto es lo que no lo está.
Discrepancias señaladas y detalles sin verificar
hybrid_search/prod_hybrid_search.py: el archivo que aparece en pantalla durante todo el recorrido de la búsqueda híbrida 02:02:59 no existe en ninguno de los dos repos publicados (production-course-main-code,fcc-production-rag-part-6). El código real más cercano, y la fuente de todos los fragmentos híbridos de arriba, esproduction-course-main-code/advanced_rag.py::demo_ensemble_hybrid_search(). El corpus de SKU / códigos de error y la tabla de resultados de cinco queries vienen de ese archivo ausente, no delTECH_DOCSdel repo.- La clase
HybridRetriever02:10:05 se menciona de palabra pero nunca se muestra. Los nombres de métodosearch()yadd_documents()son los que se narran; el esqueleto de arriba es una reconstrucción basada en APIs verificadas, no una transcripción. chunking/semantic_chunking.pyychunking/production_ready.py: también aparecen en pantalla y también faltan en ambos repos. Pertenecen a un tercer repo («Part 3 — Optimize for Quality»). Son relevantes para la Parte 3, no para esta, pero siguen el mismo patrón de artefacto ausente.XR9000: se menciona una vez de palabra como segundo código de producto 01:53:47, sin respaldo en ninguna diapositiva; la diapositiva 02 muestra otros distractores (Toaster X-500, Tool-88, Per-98, Shoe-99). Solo ilustrativo.[0.5, 0.5]frente a[0.4, 0.6]: la diapositiva y el recorrido dicen lo primero; el código del commit trae lo segundo. Conciliado arriba: empieza con 50/50.- «El híbrido ganó en todos los tipos de query» (diapositiva 06) frente al recorrido, en el que el vectorial se declara una y otra vez ganador claro y el híbrido empata. Conciliado arriba: el híbrido nunca fue peor.
- «Reducción de entre el 87 y el 82%» 03:00:26 se cita de mayor a menor; las mediciones subyacentes son 1,703→214 (≈87%) y ~1,500→~270 (≈82%; el segundo valor nunca se dice en voz alta). El «85% menos de tokens» de 03:01:29 es la misma medición redondeada otra vez.
- El número de llamadas al LLM por query durante la compresión 02:56:20 no se puede reconstruir a partir de los subtítulos («1 2 3 4 five calls to embeddings and also the completion»). La afirmación de arriba —una completion por chunk recuperado— se ha leído en
LLMChainExtractor.compress_documents, no en el audio. - El arnés de evaluación de cinco queries es una reconstrucción. Las queries y sus etiquetas de categoría están transcritas de 02:06:04–02:10:05; el nombre exacto y la firma del helper
test_queryno, y el archivo fuente es elprod_hybrid_search.pyausente. - El docstring de
advanced_rag.pyanuncia «self-query» y el instructor lo incluye en la agenda del capítulo 03:03:34, pero no hay ningúnSelfQueryRetrieveren ninguno de los dos repos y nunca se hace la demo. Esta parte no lo cubre, y el curso tampoco. - El fragmento de cableado del reranker de arriba está compuesto a partir de APIs verificadas (
CrossEncoderRerankerenlangchain_classic,HuggingFaceCrossEncoderenlangchain_community), no copiado del curso; ysentence-transformers, queHuggingFaceCrossEncoderimporta en la construcción, no está en el entorno fijado. - La constante de RRF
c = 60nunca se dice en voz alta. Se ha leído directamente enlangchain_classic/retrievers/ensemble.py:70, es decir, el algoritmo que el instructor reimplementó a mano. - No existe ningún reranker en el material fuente. El fragmento de
CrossEncoderRerankerde arriba se ha leído en el paquetelangchain_classicinstalado, no en el curso, y el curso no cita ningún benchmark de reranking. La cifra de Anthropic sobre contextual retrieval que el curso sí cita —un 67% menos de fallos de retrieval— se atribuye en el repo al contextual retrieval, y pertenece a la Parte 14, no a esta. - El nombre del logger de multi-query en el repo (
langchain.retrievers.multi_query) no coincide con el logger real del módulo (langchain_classic.retrievers.multi_query), lo que se ha verificado leyendomulti_query.pyy confirmando que el paquetelangchainfijado no tiene submóduloretrievers. - La query de citas del repo es
"What are the core components of LangChain?"; el vídeo dice «common components». Misma pregunta, otra palabra.
Dónde enlaza esta parte con las siguientes
- Presupuesto de tokens: la segunda mitad del mismo marcador de capítulo 02:13:12–02:21:10 gira hacia
TokenBudget/BudgetedLLM. La compresión, el multi-query y el híbrido son exactamente las funcionalidades que hacen necesaria una barrera de tokens previa. Parte 9. - Búsqueda híbrida en la base de datos. Todo lo de aquí se ejecuta en el propio proceso. pgvector/Supabase pueden hacer la mitad de palabras clave dentro de la base de datos con un índice incremental, lo que elimina por completo el problema de la reconstrucción de BM25. Parte 10.
- Contextual retrieval. Anteponer a cada chunk, en tiempo de indexación, un contexto escrito por el LLM es una técnica distinta de la compresión contextual: no confundas los nombres. La propia frase clave del curso al respecto es «combínalo con la búsqueda híbrida BM25 para obtener los mejores resultados» (
fcc-production-rag-part-6/02_contextual_retrieval.py:473), es decir, las dos se apilan. Parte 14. - Contabilidad de costes de parent-child —la valoración de ★★★ en contexto / ★★☆ en almacenamiento, 2× vector store— y la alternativa de late chunking, que intenta conseguir la misma calidad de contexto sin la segunda copia. Parte 14.
- Retrieval agéntico: evaluar el conjunto recuperado con un LLM evaluador y volver a hacer la query cuando es malo, que es a lo que recurres cuando el reranking y la compresión siguen sin bastar. Parte 15.
- Preguntas multi-hop, en las que la entidad puente nunca aparece en la query. Ninguna de las dos ramas de un retriever híbrido puede ayudar. Parte 16.
La matriz de técnicas
| Técnica | Corrige | Fase | Coste añadido por query | Añádela cuando |
|---|---|---|---|---|
| Híbrido (BM25 + RRF) | Códigos, ID, siglas, nombres exactos | Retrieve | ~20–50 ms, sin LLM | Estás en producción con usuarios reales y tu corpus tiene identificadores |
| Ajuste de pesos | Domina la rama equivocada | Fuse | Gratis | Cuando ya tengas datos de categorías de queries |
| Reranking (cross-encoder) | Doc correcto recuperado, pero en la posición 7 | Rerank | 1 pasada del modelo por candidato | El recall está bien pero la precision@3 no |
| Parent-document | Contexto fragmentado; embeddings diluidos | Retrieve | 1 get al docstore por resultado; 2× almacenamiento | Los chunks son precisos pero las respuestas hacen referencia a vecinos |
| Compresión contextual | Relleno que ahoga la señal | Compress | 1 llamada al LLM por chunk recuperado | Documentos grandes y mixtos y el coste en tokens importa |
EmbeddingsFilter | Lo mismo, pero barato | Compress | 1 embedding de query + N de candidatos, sin LLM | Quieres el filtrado de la compresión sin su factura |
| Multi-query | Desajuste de formulación | Query | 1 llamada al LLM + N embeddings | Los usuarios preguntan lo mismo de muchas maneras |
| Citas | Respuestas no verificables | Assemble | ~0 | Siempre |
Decisiones que tomar
- ¿Necesitas búsqueda híbrida? La regla de la fuente es cualitativa: códigos, ID, números de artículos legales, tipos de query mixtos, precisión crítica. Hazla cuantitativa: toma una muestra de 200 queries reales y cuenta cuántas contienen un código, un ID, una sigla, un nombre propio o una frase exacta entre comillas. Esa fracción es la tasa de aciertos que cabe esperar de la rama BM25, y es el número que compararás después con los logs de atribución. (Un umbral de ~10% es la regla práctica de esta guía, no del curso; lo que importa es que hayas medido la fracción).
- ¿BM25 en el propio proceso o búsqueda por palabras clave en la base de datos?
rank_bm25vive en memoria, es O(corpus) por query y solo admite reconstrucción completa. Es la opción correcta hasta aproximadamente decenas de miles de documentos y la equivocada a partir de ahí. Decídelo ahora, porque migrar más tarde implica rediseñar la ingesta. - ¿Cuál es tu tokenizador de BM25? El valor por defecto es
str.split(). Si tus identificadores llevan signos de puntuación —y los llevan—, escribe unapreprocess_func, pásasela afrom_documents(no a la instancia después) y pruébala con tests unitarios contra diez códigos reales de tu corpus. - ¿Cuáles son tus dos valores de k? El k por rama hacia la fusión (empieza con 10–20; el mínimo del curso es 4 o más) y el k posterior a la fusión hacia el prompt (3–5). Son números distintos, y confundirlos es el error de ajuste más común.
- ¿Dónde empiezan los pesos? En
[0.5, 0.5], escrito explícitamente: omitirweightste da en silencio pesos uniformes, lo que parece lo mismo hasta que alguien añade un tercer retriever. Mantén la lista de retrievers y la de pesos en líneas contiguas con los porcentajes en un comentario, y muévelos solo a partir de datos de atribución. - ¿Cómo vas a reconstruir BM25? En cada escritura, por lotes o con doble búfer; ¿y cuál es la ventana de desfase documentada para la rama de palabras clave?
- ¿Reranking o compresión? Resuelven mitades distintas del problema del ruido. El reranking reordena (barato por candidato, sin cambiar el texto). La compresión encoge (cara, reescribe el contenido, puede devolver cero documentos). La mayoría de los sistemas quieren primero un reranker y solo añaden compresión si los chunks supervivientes siguen hinchados.
- ¿Es honesta tu demo de compresión? Si tu corpus de prueba está limpio, la compresión parecerá rota. Construye un documento al estilo de
INFO_BURIED, con relleno real, antes de decidir que no hace nada. - ¿Dónde vive el padre?
InMemoryStorees para demos. Elige el docstore duradero y la clavedoc_idantes de indexar nada, porque los hijos huérfanos no se pueden recuperar sin reindexar. - ¿Sobrevive la pregunta literal del usuario? Multi-query con
include_original=Falsesignifica que no. Decídelo deliberadamente. - ¿Cómo verificas las citas? Las citas en prosa las genera el modelo y no están verificadas. O devuelves los objetos documento junto con la respuesta, o usas structured output con un campo
sources_usedque puedas comprobar con un assert contra el conjunto recuperado.
Checklist antes de dar el retrieval por «terminado»
Cada línea está redactada para que se cumpla o no se cumpla: ninguna se satisface con una opinión.
- Existe un arnés
test_query(retriever, query, name), está en el repo y pasa la misma query por todas las variantes de retriever, una al lado de otra. Ejecutarlo es un solo comando. - Las queries de prueba están anotadas por categoría (código de producto, código de error, semántica, sigla, búsqueda de configuración), y el corpus de fixtures es adversarial: contiene códigos, ID y siglas reales de tu dominio, no ocho párrafos de prosa limpia.
- El retrieval se mide por separado de la generación: puedes responder a «¿volvió el chunk correcto?» sin leer ninguna respuesta.
- Hay un test que llama a
add_documents()con un documento que contiene un token único y luego comprueba con un assert que la rama BM25 por sí sola lo devuelve. Es el único test que detecta la degradación silenciosa de híbrido a vectorial. - La
preprocess_funcde BM25 se pasa afrom_documents(...)en la construcción (nunca se asigna a la instancia) y tiene un test unitario con diez identificadores reales de tu corpus, incluido uno con puntuación al final y otro con mayúsculas/minúsculas cambiadas. - Los
weightsdel ensemble están escritos explícitamente en la línea de debajo deretrievers, en el mismo orden, con los porcentajes en un comentario. Nadie depende del valor por defecto silencioso1/n. id_keyestá fijado a un identificador de documento real si dos chunks de tu corpus pueden compartir texto; si no, has confirmado que la clave de deduplicaciónpage_contentes segura, y que todos los documentos llevan el campoid_key(si falta en uno, se lanzaKeyErroren mitad de la fusión).- Los dos valores de k son distintos y están por escrito: el k por rama hacia la fusión y el k posterior a la fusión hacia el prompt.
- La atribución por retriever (solo BM25 / solo vectorial / ambos) está en tus logs estructurados (Parte 7), y alguien ha leído los números de la semana pasada y puede decir de memoria el porcentaje de solo BM25.
- Se usan rutas asíncronas (
ainvoke) siempre que se ejecuten dos retrievals o N compresiones; la ruta síncrona paga la suma en lugar del máximo. - Las variaciones generadas por el multi-query se registran como campos estructurados, no a través de un nombre de logger copiado de un tutorial, que en el entorno fijado configura un logger que no existe.
- La ruta de contexto vacío está probada: una compresión que devuelve cero documentos debe producir un rechazo, no una respuesta alucinada.
- Los documentos padre viven en un docstore duradero, no en
InMemoryStore, y hay una comprobación de que eldoc_idde cada hijo indexado apunta a un padre. - Los metadatos
sourcesobreviven del loader al chunk y al prompt (split_documents, nosplit_text), y las citas usanpage_label, nopage. - Las fuentes citadas se validan contra el conjunto recuperado, ya sea devolviendo los objetos
Documentjunto con la respuesta o comprobando con un assertsources_used ⊆ retrieved sourcessobre el structured output. - Cada mejora de calidad tiene un antes/después medido sobre tu corpus. Todas las cifras de esta parte —~20–50 ms, 87%, 85%, 173 → 675 caracteres— son una demo sobre un documento, en una ejecución, hecha por una persona. Ninguna es tu número hasta que la hayas medido.