
Escalado: ajuste del índice, HNSW y cuándo hacer sharding
Los parámetros M y ef de HNSW, presets de recall frente a latencia, escalar en vertical primero y cuándo hacer sharding.
Todo lo anterior hizo que tu sistema fuera bueno. Esta parte hace que sobreviva al crecimiento, y empieza con la observación de que el crecimiento rompe un RAG de una forma que no verás en tu suite de tests.
El arco del fallo es siempre el mismo 03:12:59. Desarrollas contra unos pocos miles de documentos. Las queries vuelven al instante. Haces el deploy. Producción tiene cien mil documentos, o un millón, o diez millones —la propia respuesta del instructor a «¿cuántos?» es «¿quién sabe?»— y dos cosas fallan a la vez:
- Las queries se vuelven lentas. Los milisegundos se convierten en segundos.
- Las queries se vuelven incorrectas —el «o algo peor» del propio instructor— porque el índice nunca se
configuró para esta escala.
La segunda es la que te costará un trimestre. Un índice aproximado mal ajustado no lanza ninguna excepción, no registra ningún aviso y no devuelve menos resultados. Devuelve k documentos que tienen exactamente la forma de la respuesta correcta y que, sencillamente, no son los verdaderos vecinos más cercanos. Es el invariante 4 del modelo mental —los fallos son silenciosos— apareciendo en la capa de infraestructura, y es la razón por la que esta parte va después de la observabilidad (Parte 7) y no antes: cada disparador de esta parte es un número que ya debes estar midiendo.
En la imagen de las dos fases, esta parte modifica exactamente dos cajas: Store + Index en la Phase A y Retrieve en la Phase B. No cambia el chunking, ni los embeddings, ni los prompts. Eso es precisamente lo que la hace peligrosa: puedes degradar la calidad del retrieval sin tocar ni una línea del código de la aplicación.
Ajustar el índice es la única optimización de esta guía que puede empeorar tus respuestas mientras todos los dashboards siguen en verde.
Embedding no es indexación
La semilla que se plantó en la Parte 1 hay que desenterrarla ahora, porque sin ella el resto de esta parte es ininteligible. Un vector store hace dos cosas independientes, y la gente las confunde constantemente:
- El embedding decide dónde cae un vector en el espacio. Es una propiedad del modelo.
- La indexación decide cómo encuentras los vecinos de un punto una vez que están todos en ese
espacio. Es una propiedad de la estructura de datos construida encima de los vectores.
Son ortogonales. Puedes tener embeddings perfectos y un índice mal ajustado (geometría correcta, vecinos devueltos incorrectos) o embeddings basura y un índice perfecto (recuperas, sin fallo, los verdaderos vecinos más cercanos de un punto sin sentido). Los dos modos de fallo se ven idénticos desde fuera —«no se recuperó el chunk correcto»— y tienen arreglos completamente distintos.
| Propiedad | Decide | Se fija en | Coste de cambiarlo | Firma del fallo |
|---|---|---|---|---|
| Embedding model | dónde está cada vector | al indexar, y luego congelado para siempre | re-embed de todo el corpus: factura completa de la API + reconstrucción completa | incomparabilidad silenciosa (invariante 2); las dimensiones que no coinciden fallan de forma ruidosa, mismas dimensiones con distinto modelo falla en silencio |
| Tipo de índice + M | el grafo a través del cual buscas | al construir el índice | reconstruir el grafo sobre los vectores existentes: sin re-embedding, sin coste de API | recall discretamente por debajo del 100%; resultados plausibles pero no óptimos |
| Esfuerzo de búsqueda (ef) | cuánto te esfuerzas en buscar en esta query | en tiempo de query en pgvector, a nivel de colección en Chroma | de gratis a barato: cambias un ajuste, sin reconstrucción | el recall cae a medida que crece el corpus, sin cambiar ni una línea de código |
Esa tercera fila es toda la razón por la que merece la pena leer esta parte. Hay un mando en todo tu stack de retrieval que no cuesta nada cambiar, no requiere reconstrucción y mueve la precisión varios puntos. La mayoría de equipos no lo tocan nunca porque no saben que existe.
HNSW, con el nivel de detalle que de verdad necesitas
La mayoría de bases de datos vectoriales indexan con HNSW —grafos Hierarchical Navigable Small World— o algo muy parecido. El instructor nombra cuatro: Pinecone, pgvector, Chroma y Qdrant 03:12:59. (Qdrant se nombra exactamente una vez en las siete horas y media del curso y nunca se vuelve a él.)
La idea esencial: en lugar de comparar tu query con cada vector almacenado —exacto pero O(n), inservible con un millón de vectores—, HNSW construye un grafo en el que cada vector es un nodo conectado a un puñado de sus vecinos, organizado en capas. Una búsqueda entra por la capa superior, poco poblada, camina de forma voraz hacia la query, baja una capa, vuelve a caminar y termina con un recorrido de grano fino en la capa inferior. Visitas unos cientos de nodos en lugar de un millón.
El precio está en el nombre de la familia: ANN, approximate nearest neighbour (vecino más cercano aproximado). El recorrido del grafo puede quedarse atascado en un vecindario local y perderse un vector realmente más cercano que está a una arista sin explorar. La aproximación no es un bug que puedas eliminar; es el trato que aceptas a cambio de una búsqueda sublineal. Lo que hacen los dos parámetros es recomprar precisión: uno con memoria, el otro con tiempo.
El curso es explícito y, en mi opinión, acertado sobre el alcance:
«No necesitas entender el algoritmo a fondo… Pero sí necesitas entender los dos parámetros que lo controlan todo.» 03:12:59
Tómalo al pie de la letra con una salvedad: la abstracción de dos mandos basta para operar un índice. No basta para depurar un recall patológico, donde empiezan a importar cosas como la métrica de distancia, la normalización de los vectores y la probabilidad de asignación de capas. Más del noventa por ciento del ajuste en producción es M y ef.
Parámetro 1: M, el número de amigos que tiene cada vector
M es el número máximo de conexiones (aristas) por nodo del grafo. Imagina el espacio vectorial como un grafo de nodos con aristas entre ellos; M es cuántas aristas recibe cada nodo.
La analogía que usa el curso es la que merece la pena memorizar:
«piensa en ello como en una red social. Una m baja… significa que todo el mundo conoce a ocho personas. Una m alta significa que todo el mundo conoce a 64 personas.» 03:15:03
Más amigos significa que se puede llegar a cualquier destino en menos saltos, así que el recorrido voraz encuentra el vecindario verdadero con más fiabilidad. También significa que almacenas todas esas aristas: en RAM, para siempre, para cada vector de tu corpus. Y construir el grafo es más lento, porque cada inserción tiene que elegir y mantener más conexiones.
| Franja de M | Valores | Tamaño del índice | Velocidad de construcción | Precisión |
|---|---|---|---|---|
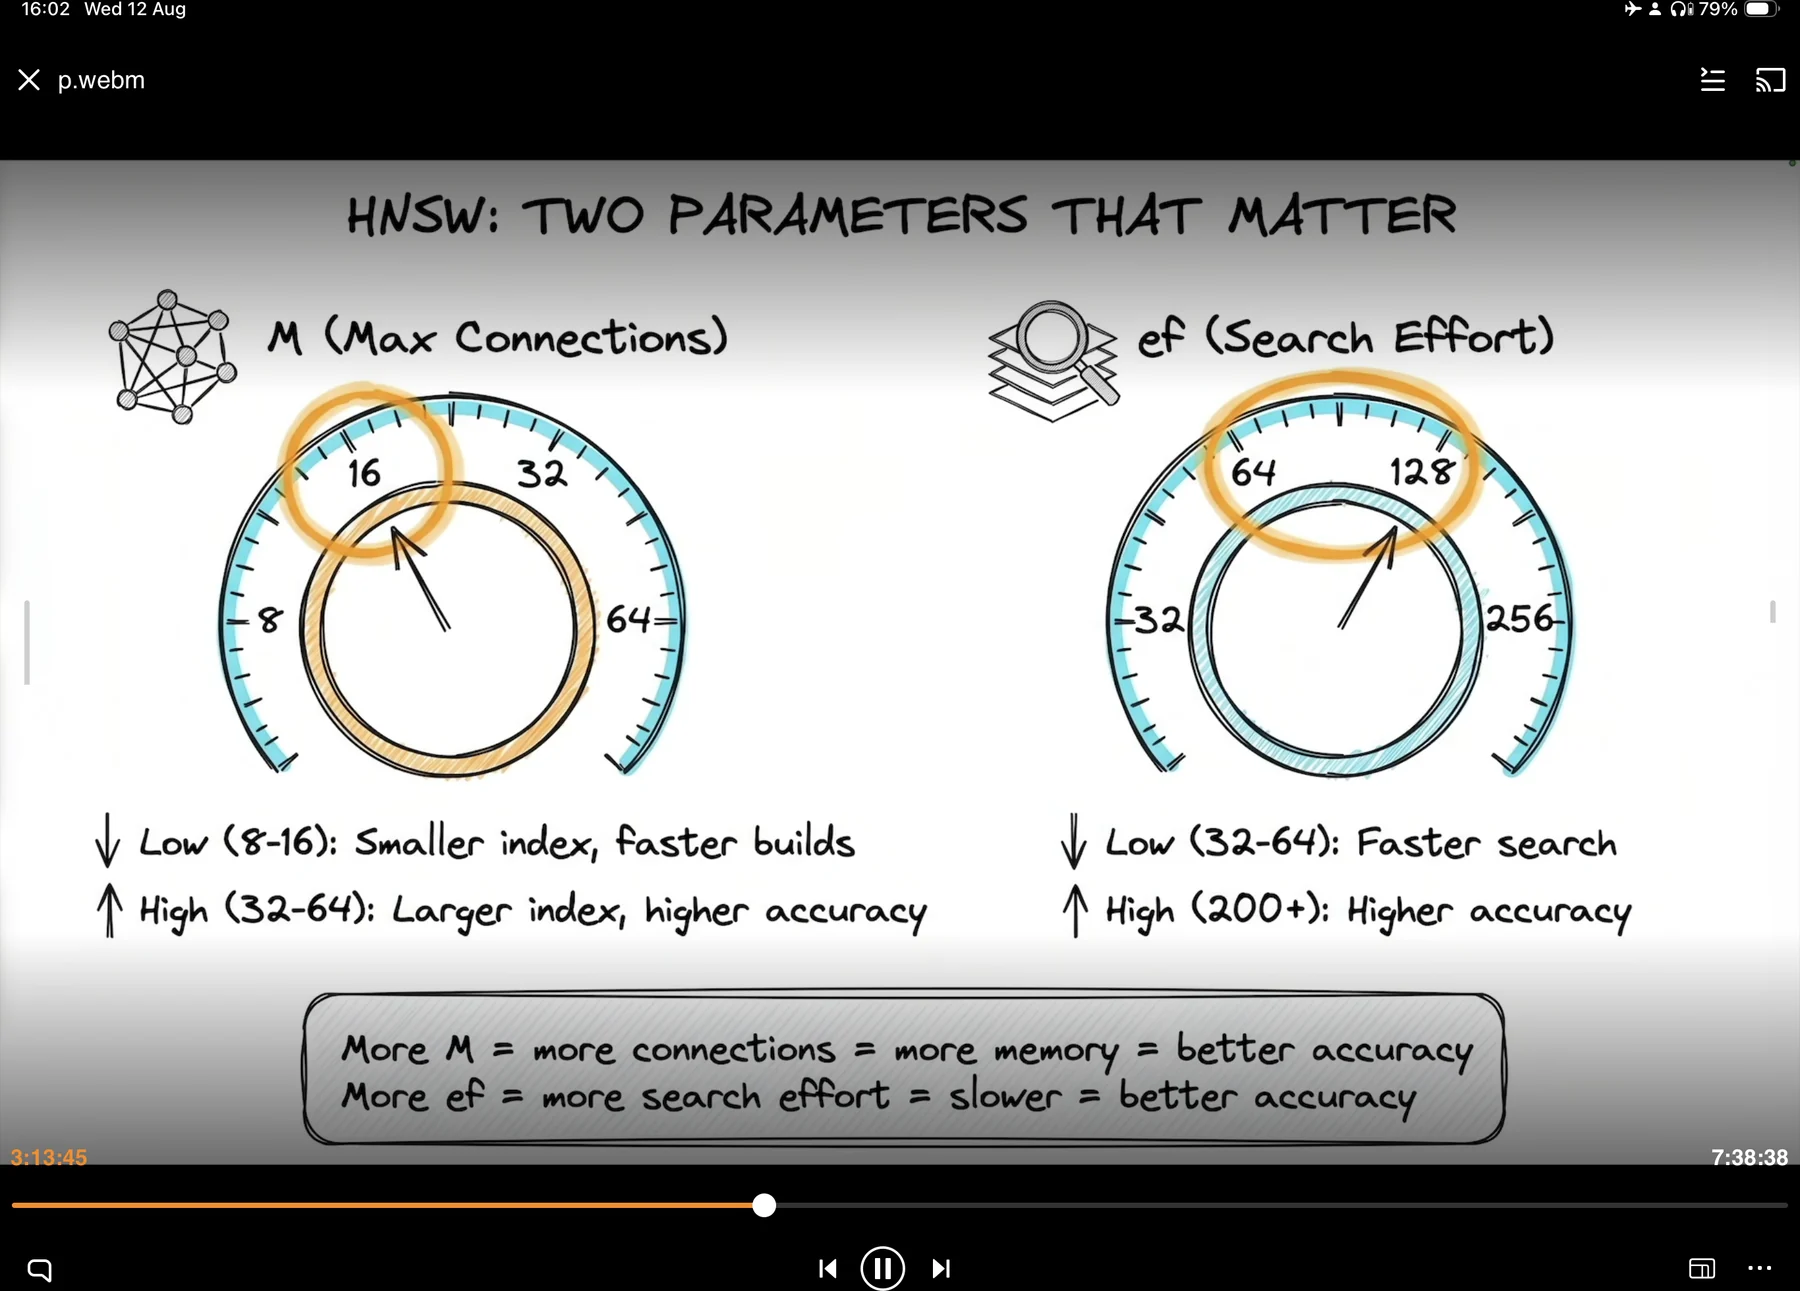
| Baja | 8–16 | más pequeño | construcciones más rápidas | menor |
| Por defecto | 16 | equilibrado | equilibrada | equilibrada |
| Alta | 32–64 | más grande | construcciones más lentas | mayor |
La diapositiva 11 dibuja M como un dial con marcas en 8 / 16 / 32 / 64 y rodea 16 como valor por defecto, bajo esta ley de una línea:
«Más M = más conexiones = más memoria = mejor precisión.» — diapositiva, 3:13:45
Fíjate en que subir M te cuesta dos veces: un índice residente más grande y una construcción o reindexación más lenta 03:14:01. Ese doble coste es la razón por la que los consejos de ajuste de más abajo mueven primero ef y M en último lugar.
Parámetro 2: ef, cuánto se esfuerza la búsqueda
ef es el tamaño de la lista dinámica de candidatos que se mantiene durante una búsqueda 03:15:03. Cuando el recorrido avanza por el grafo, mantiene un conjunto de trabajo con los mejores candidatos encontrados hasta el momento y sigue expandiéndose a partir de ellos; ef es lo grande que puede llegar a ser ese conjunto antes de que la búsqueda se dé por terminada. Una lista más grande significa que se explora más parte del grafo, más oportunidades de escapar de un óptimo local, mejor recall y más cálculos de distancia por query.
| Franja de ef | Valores | Velocidad de búsqueda | Precisión |
|---|---|---|---|
| Baja | 32–64 | más rápida | menor |
| Por defecto | 64–128 | equilibrada («ese efecto bien equilibrado») | equilibrada |
| Alta | 200+ | más lenta | mayor |
El dial de ef de la diapositiva 11 va de 32 / 64 / 128 / 256 con la zona 64–128 rodeada, y describe la franja superior como «High (200+): Higher accuracy». La narración dice «entre 200 y 500» 03:15:03. En realidad no se contradicen: la franja de la diapositiva es abierta y su dial simplemente deja de dibujarse en 256. El número que importa es 200, porque es el que usa el preset de alta precisión; trata cualquier valor por encima de 256 como territorio fuera del dial en el que solo entras con una medición de recall en la mano.
«Más ef = más esfuerzo de búsqueda = más lento = mejor precisión.» — diapositiva, 3:13:45
La asimetría que lo gobierna todo
La diapositiva dibuja M y ef como dos diales idénticos. No son idénticos, y la diferencia es lo más accionable de este capítulo:
- M queda fijado al construir el índice. Cambiarlo significa reconstruir el índice.
- ef no. Se fija después de que exista el grafo y se puede subir sin volver a hacer el embedding
de nada.
Lo barato que es ese «no queda fijado» depende de tu store, y conviene saberlo antes de planificar en función de ello:
- pgvector: de verdad por request.
SET hnsw.ef_searches un ajuste de sesión, así que distintas
queries en distintas conexiones pueden usar valores distintos.
- Chroma: un ajuste a nivel de colección. Lo eliges al crear la colección y, en
las versiones actuales, puedes cambiarlo después con collection.modify(...). Lo que no puedes hacer es variarlo por query.
- Pinecone: no está expuesto en absoluto.
Así que: cuando te falte precisión, sube primero ef. Es reversible, barato de probar y no requiere re-embedding. Sube M —y paga una reconstrucción más RAM permanente— solo cuando ef por sí solo no te lleve hasta donde necesitas.
Tres parámetros con dos nombres
La trampa de nomenclatura más retorcida de todo este material. «ef» en la diapositiva significa esfuerzo de búsqueda, pero el ejemplo de pgvector de más abajo fija ef_construction, y el «ef» de la tabla de presets es un valor de búsqueda. Tres cosas distintas:
| Parámetro | Cuándo se aplica | Efecto | ¿Reversible? |
|---|---|---|---|
m | construcción | aristas por nodo; densidad del grafo | requiere reconstrucción |
ef_construction | construcción | cuánto se esfuerza el constructor en buscar al insertar cada vector: calidad del grafo, de forma permanente | requiere reconstrucción |
ef_search | búsqueda | cuánto se esfuerza el recorrido en buscar | sí, sin reconstrucción |
ef_construction no es un mando de rendimiento para tus usuarios; es un mando de calidad del propio grafo. Si lo pones demasiado bajo, produces un grafo permanentemente mediocre que ninguna cantidad de ef en tiempo de búsqueda puede rescatar del todo. Si lo pones alto, pagas una sola vez, al construir, en tiempo de reloj.
El trade-off de producción: elige dos
«por desgracia, no puedes tener las tres cosas funcionando a la vez» 03:16:04
Tres vértices —Accuracy, Speed, Memory (precisión, velocidad, memoria)— y las palabras en el centro de la diapositiva son PICK 2. Es el invariante 5 del modelo mental aplicado a la capa del índice, y los tres vértices se corresponden uno a uno con los tres presupuestos de la guía: la precisión es el presupuesto de calidad, la velocidad es el presupuesto de latencia y la memoria es el presupuesto de dinero (la RAM es la partida que alquilas cada mes). Cada decisión sobre el índice de esta parte es una transferencia entre esas tres cuentas.
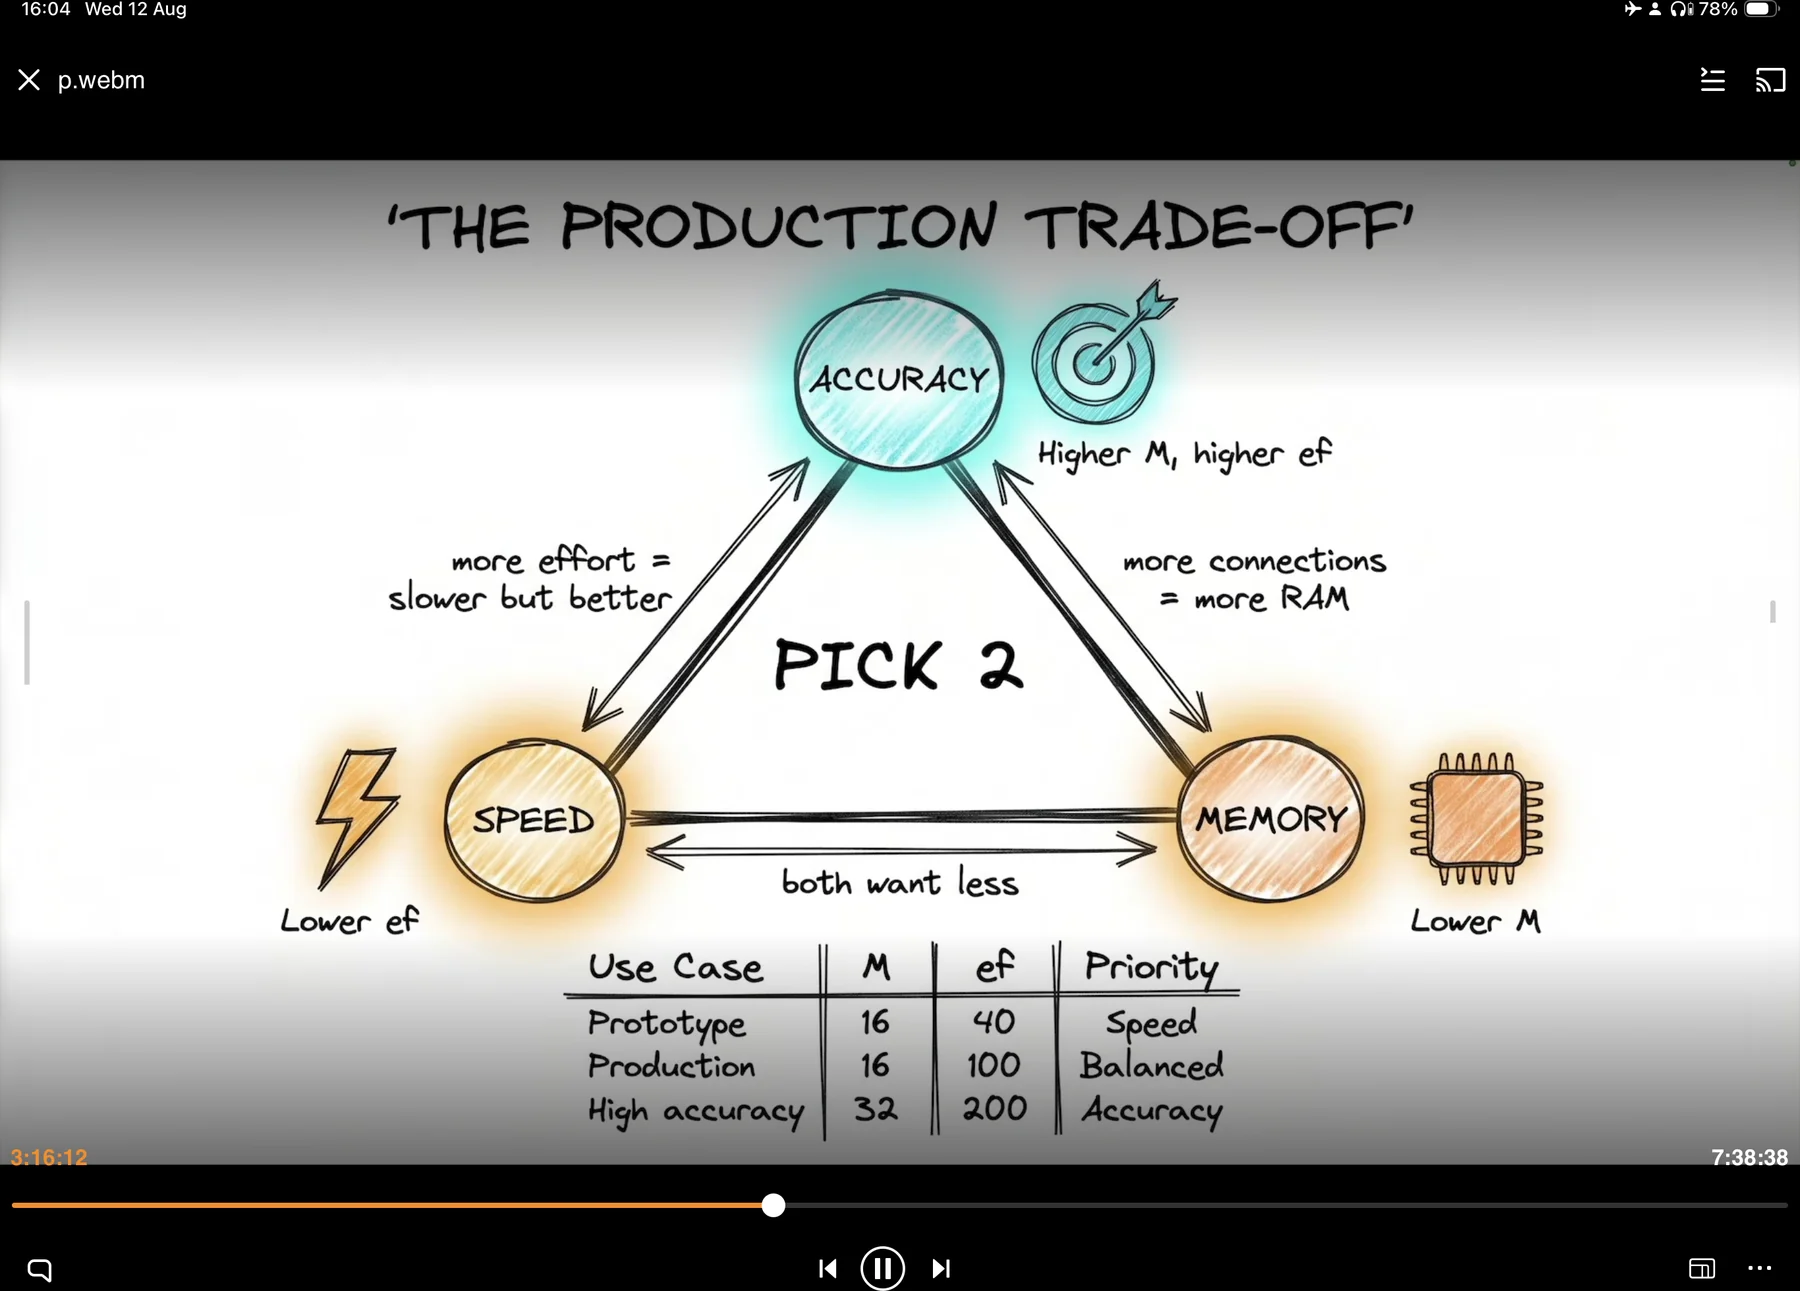
Las tres palancas, formuladas como «si quieres esto, pagas aquello» 03:16:04:
| Tu objetivo | Acción | El precio que pagas |
|---|---|---|
| Alta precisión | subir tanto M como ef | memoria y velocidad |
| Queries más rápidas | bajar ef | precisión |
| Índice más pequeño | bajar M | precisión |
Las etiquetas de aristas y vértices de la diapositiva codifican la geometría, y merece la pena leerlas con atención:
- Speed ↔ Accuracy: «más esfuerzo = más lento pero mejor» (esa arista es ef; el vértice SPEED está
anotado con «Lower ef»)
- Memory ↔ Accuracy: «más conexiones = más RAM» (esa arista es M; el vértice MEMORY está
anotado con «Lower M»)
- Speed ↔ Memory: «las dos quieren menos»
- Y junto a ACCURACY: «Higher M, higher ef», el único vértice que te cuesta las dos cosas
Esa tercera arista es la clave. La velocidad y el ahorro de memoria no están en tensión entre sí: las dos quieren ajustes más pequeños y más baratos. La tensión real es de uno contra dos: la precisión frente a la pareja. Lo que replantea todo el ejercicio: no estás equilibrando tres cosas, estás decidiendo cuánta velocidad y cuánta RAM estás dispuesto a gastar para comprar recall.
«normalmente eliges dos, no puedes elegir tres.» 03:16:04
Los tres presets
Este es el resultado práctico del capítulo: la tabla de la parte inferior de la diapositiva 12, que también se lee en voz alta 03:16:04–03:17:04:
| Caso de uso | M | ef | Prioridad |
|---|---|---|---|
| Prototipo | 16 | 40 | Velocidad |
| Producción | 16 | 100 | Equilibrio |
| Alta precisión | 32 | 200 | Precisión |
Fíjate en la forma de ese consejo más que en los números. M pasa de 16 → 16 → 32. ef pasa de 40 → 100 → 200. En todo el rango, desde el prototipo de usar y tirar hasta el sistema en el que la precisión es crítica, M cambia exactamente una vez y ef se multiplica por 5. Los propios presets son un argumento a favor de «ajusta ef y deja M en paz», que es exactamente lo que predice la asimetría entre tiempo de construcción y tiempo de búsqueda.
Dos notas al pie sobre los números:
- El ef = 40 del prototipo está dentro de la franja baja declarada (32–64), pero no es una de las marcas
del dial. Léelo como «deliberadamente barato», no como una constante mágica.
- El instructor se cubre explícitamente: son «muy buenos puntos de partida» 03:17:04 que hay que
contrastar con tu propio caso de uso, no respuestas. Valores a partir de los cuales medir.
Fijar los parámetros, base de datos a base de datos
Tres proveedores, tres superficies realmente distintas, y una de ellas no tiene superficie alguna.
pgvector: SQL, dos veces
Lo escribes una vez al construir, en DDL, y otra vez en tiempo de query:
-- build time: M and ef_construction are baked into the index
CREATE INDEX ON documents
  USING hnsw (embedding vector_cosine_ops)
  WITH (m = 16, ef_construction = 64);

-- query time: raise search effort for higher accuracy (slower)
SET hnsw.ef_search = 100;
vector_cosine_ops es la clase de operador de distancia coseno: la clase de operador tiene que coincidir con el operador de distancia con el que buscas de verdad (<=> para coseno); si no, el planificador ignorará el índice y hará un escaneo secuencial de la tabla. Fíjate también en que los m = 16, ef_construction = 64 del DDL son los valores por defecto del propio pgvector, así que esa sentencia en realidad documenta una intención más que cambiar el comportamiento; la línea que cambia el comportamiento es la segunda.
La segunda sentencia es un GUC de sesión: se aplica a las queries posteriores en esa conexión. En una aplicación con pool de conexiones eso es una trampa: fíjalo una vez al arrancar y se aplicará en silencio a la conexión que casualmente estuviera tomada en ese momento y a ninguna otra. Fíjalo en cada checkout, o limítalo a la transacción con SET LOCAL hnsw.ef_search = 100 dentro de la transacción que ejecuta la búsqueda. (Lo del pooling y lo de la clase de operador son aportaciones mías, no del curso; lo del pooling es la forma más habitual en que este ajuste deja de aplicarse en producción.)
Chroma: un diccionario de metadatos al crear la colección
Chroma expone los ajustes de HNSW como entradas con el prefijo hnsw: en el dict de metadatos de la colección, que se fijan al crearla:
# Chroma native client — HNSW settings live in collection metadata
collection = client.create_collection(
    name="my_collection",
    metadata={
        "hnsw:space": "cosine",
        "hnsw:M": 16,
        "hnsw:construction_ef": 100,
        "hnsw:search_ef": 100,
    },
)
Y a través del wrapper de LangChain que es el que usa realmente todo el curso:
from langchain_chroma import Chroma

vectorstore = Chroma.from_documents(
    documents=docs,
    embedding=embeddings_model,
    persist_directory="./chroma_db/",
    collection_metadata={
        "hnsw:space": "cosine",
        "hnsw:M": 16,
        "hnsw:construction_ef": 100,
        "hnsw:search_ef": 100,
    },
)
Tres cosas sobre esto que el original no te cuenta y que valen más que el propio snippet. Las tres se han comprobado con las versiones que fija el repo de esta guía, chromadb 1.4.1 / langchain-chroma 1.1.0:
1. Los valores por defecto de Chroma, sin tocar, ya son el preset de producción, salvo la métrica. Una colección creada sin ningún metadato HNSW sale como {space: "l2", ef_construction: 100, ef_search: 100, max_neighbors: 16, …}. max_neighbors es M. Así que la fila de producción del curso (M = 16, ef = 100) no es un cambio sobre Chroma, sino una reformulación de lo que Chroma ya hace. Lo único que merece la pena fijar explícitamente es hnsw:space, que por defecto es L2, no coseno. Con los embeddings normalizados a norma unidad de OpenAI, L2 y coseno ordenan igual, así que esto no rompe el ranking, pero sí cambia la escala de los scores, que es exactamente la razón por la que la Parte 4 insiste en que un umbral de distancia nunca es portable entre stores.
2. Puedes leer lo que Chroma construyó realmente. No te fíes de que tus ajustes se hayan aplicado; compruébalo:
# Verified on chromadb 1.4.1: legacy hnsw:* keys are translated into the modern config
print(vectorstore._collection.configuration_json["hnsw"])
# {'space': 'cosine', 'ef_construction': 100, 'ef_search': 100, 'max_neighbors': 16, ...}
3. Una clave mal escrita falla de dos formas completamente distintas. Una clave dentro del espacio de nombres hnsw: que Chroma no reconoce —hnsw:m en minúscula, o hnsw:ef_search cuando el nombre heredado es hnsw:search_ef— hace que create_collection lance InvalidArgumentError: Failed to parse hnsw parameters from segment metadata. Una clave a la que le falta el prefijo por completo —"M": 16— se acepta, se guarda como metadato normal de la colección y no hace absolutamente nada. El fallo ruidoso es el afortunado.
Las versiones más recientes de Chroma aceptan también una configuración estructurada en lugar de las claves de metadatos heredadas, que langchain_chroma expone como collection_configuration=. Son los mismos tres números con nombres mejores y, a diferencia del dict de metadatos, se pueden actualizar sobre una colección existente:
# modern equivalent; max_neighbors is M, and modify() works after creation
collection = client.create_collection(
    name="my_collection",
    configuration={"hnsw": {"space": "cosine", "ef_construction": 100,
                            "max_neighbors": 16, "ef_search": 100}},
)
collection.modify(configuration={"hnsw": {"ef_search": 300}})  # no rebuild
Esa llamada a modify es lo más cerca que llega Chroma del SET por request de pgvector: cambia el esfuerzo de búsqueda de una colección existente sin volver a hacer el embedding de nada. Es también la única forma admitida de cambiar ef a posteriori; reabrir una colección con metadatos distintos no funciona, que es el siguiente aviso.
Pinecone: sin mandos
«no tienes que preocuparte por esto, pero puedes controlar el número de resultados. En este caso, el top K.» 03:18:05
Pinecone ajusta HNSW automáticamente según tu tipo de pod. Tú eliges el pod; Pinecone elige M y ef. Toda la superficie de ajuste de esta parte se sustituye por dos decisiones: qué pod y qué top_k.
Eso se vende como comodidad, y en general lo es. Pero fíjate en lo que cuesta: es la columna de control del trade-off entre managed y self-hosted la que se está gastando. Si necesitas un comportamiento del índice determinista y reproducible —por ejemplo, un benchmark de recall en una suite de evals que no debe moverse bajo tus pies entre ejecuciones—, el ajuste automático es una limitación, no solo una ventaja. Y ten en cuenta que el planteamiento de los pods describe el nivel basado en pods de Pinecone; el nivel serverless, que es el que elige la propia escalera de recomendaciones de la Parte 9 para 100 K–1 M vectores, no tiene pod que dimensionar, lo que reduce aún más la superficie, a solo top_k.
| Proveedor | Superficie en tiempo de construcción | Superficie del esfuerzo de búsqueda | Quién elige |
|---|---|---|---|
| pgvector | WITH (m=…, ef_construction=…) en el DDL | SET hnsw.ef_search = …, por sesión o por transacción | tú, por completo |
| Chroma | collection_metadata={"hnsw:M": …, "hnsw:construction_ef": …} al crearla | hnsw:search_ef al crearla, o modify(configuration=…) después; nunca por query | tú, al crearla |
| Pinecone | ninguna: tipo de pod | ninguna: solo top_k | Pinecone |
| Qdrant | configuración HNSW (nombrada una vez en el original, nunca desarrollada) | — | tú |
El código que el curso nunca escribió
Un hecho crudo que conviene decir sin rodeos: ninguno de los dos repos del curso contiene ni un solo ajuste de HNSW. Buscar en production-course-main-code/ y en fcc-production-rag-part-6/ hnsw, ef_search, ef_construction, collection_metadata y create index no devuelve nada. Este capítulo es 100% diapositivas: no se abre ningún editor y no se ejecuta nada.
Así que aquí está el fichero que debería haber editado. Cada construcción de Chroma del repo funciona con los valores por defecto de fábrica:
# production-course-main-code/vector_stores.py:50-58, as shipped
def chroma_basics():
    with tempfile.TemporaryDirectory() as tmpdir:
        # create vector store from documents
        vectorstore = Chroma.from_documents(
            documents=SAMPLE_DOCS, embedding=embeddings_model, persist_directory=tmpdir
        )
        print(
            f"Vector store created {vectorstore._collection.count()} documents and persisted."
        )
Sin collection_metadata, así que cada store de chroma_basics(), similarity_search_with_scores(), metadata_filtering(), as_retriever(), persist_chroma() y del ejercicio del final del fichero se construye con M = 16, ef_construction = 100, ef_search = 100, L2. Con ocho documentos de ejemplo, ese comportamiento es del todo correcto: el grafo es mucho más pequeño que la lista de candidatos, así que cada búsqueda es en la práctica exhaustiva y el recall es 1.0 por construcción. Es también la razón por la que nunca verás un problema de ajuste del índice en este repo, que es precisamente la trampa de «desarrollo es una mentira» con la que abre el capítulo.
La versión ajustada de la misma función, con la diferencia de una línea:
# vector_stores.py, tuned: the production preset stated explicitly at collection creation
def chroma_basics_tuned():
    with tempfile.TemporaryDirectory() as tmpdir:
        vectorstore = Chroma.from_documents(
            documents=SAMPLE_DOCS,
            embedding=embeddings_model,
            persist_directory=tmpdir,
            collection_metadata={          # <-- the whole of Part 8, in one kwarg
                "hnsw:space": "cosine",
                "hnsw:M": 16,
                "hnsw:construction_ef": 100,
                "hnsw:search_ef": 100,
            },
        )
        cfg = vectorstore._collection.configuration_json["hnsw"]
        print(f"{vectorstore._collection.count()} docs indexed with {cfg}")
k no es ef, y ef debe ser ≥ k
El original no lo dice, y es algo que pilla a la gente. El k del retriever y el ef del índice son números distintos en capas distintas:
# vector_stores.py:129-131 — k is an application-layer setting
retriever = vectorstore.as_retriever(
    search_type="similarity", search_kwargs={"k": 3}
)
k es cuántos documentos quieres de vuelta. ef es cuántos candidatos puede considerar el recorrido del grafo por el camino para encontrarlos. La lista de candidatos tiene que ser al menos tan grande como el conjunto de resultados, así que ef_search ≥ k siempre, y que ef_search sea bastante mayor que k es de donde sale realmente la precisión. Si usas el retriever MMR del mismo fichero, ten en cuenta que fetch_k sube la demanda real de resultados:
# vector_stores.py:141-144 — MMR fetches 5, returns 3 diverse
mmr_retriever = vectorstore.as_retriever(
    search_type="mmr",
    search_kwargs={"k": 3, "fetch_k": 5},  # fetch 5 docs and return 3 diverse
)
Con fetch_k=5, el índice tiene que producir cinco candidatos, así que ef_search=40 te da un margen de holgura de 8× y ef_search=100 te da 20×. Donde esto sale mal es en el otro extremo: un pipeline de reranking (Parte 6) que recupera k=100 para hacer rerank hasta 5 le está pidiendo al índice 100 resultados con una lista de candidatos de 100, una proporción de 1.0, que es la peor configuración posible para el recall. Si haces rerank, sube ef.
Mídelo tú mismo: un arnés de recall que no necesita API key
El capítulo afirma que ef compra precisión y nunca lo demuestra. Esto sí lo hace, sin conexión, en unos treinta segundos. DeterministicFakeEmbedding sustituye a un embedding model real para que el índice sea la única variable, y un escaneo coseno por fuerza bruta sobre los mismos vectores proporciona el ground truth contra el que se puntúa el resultado ANN.
# Original: an offline recall harness. Needs chromadb + langchain-chroma + numpy.
import tempfile

import numpy as np
from langchain_chroma import Chroma
from langchain_core.embeddings import DeterministicFakeEmbedding

PRESETS = {
    "prototype":     {"hnsw:space": "cosine", "hnsw:M": 16, "hnsw:construction_ef": 100, "hnsw:search_ef": 40},
    "production":    {"hnsw:space": "cosine", "hnsw:M": 16, "hnsw:construction_ef": 100, "hnsw:search_ef": 100},
    "high_accuracy": {"hnsw:space": "cosine", "hnsw:M": 32, "hnsw:construction_ef": 200, "hnsw:search_ef": 200},
}


def effective_hnsw_config(vectorstore: Chroma) -> dict:
    """Read back what Chroma built, not what you asked for."""
    return vectorstore._collection.configuration_json["hnsw"]


def recall_at_k(vectorstore, embeddings, texts, queries, k=5) -> float:
    matrix = np.array(embeddings.embed_documents(texts))
    matrix /= np.linalg.norm(matrix, axis=1, keepdims=True)
    hits = 0
    for query in queries:
        qv = np.array(embeddings.embed_query(query))
        qv /= np.linalg.norm(qv)
        exact = {texts[i] for i in np.argsort(-(matrix @ qv))[:k]}  # brute force = ground truth
        approx = {d.page_content for d in vectorstore.similarity_search(query, k=k)}
        hits += len(exact & approx)
    return hits / (k * len(queries))


embeddings = DeterministicFakeEmbedding(size=1536)
texts = [f"document number {i}" for i in range(2000)]
queries = texts[::200]

for name, preset in PRESETS.items():
    with tempfile.TemporaryDirectory() as tmpdir:
        store = Chroma.from_texts(
            texts=texts, embedding=embeddings,
            persist_directory=tmpdir, collection_metadata=preset,
        )
        cfg = effective_hnsw_config(store)
        print(
            f"{name:14s} M={cfg['max_neighbors']:3d} ef_search={cfg['ef_search']:4d} "
            f"recall@5={recall_at_k(store, embeddings, texts, queries):.2f}"
        )
Salida típica con 2 000 vectores (chromadb 1.4.1; las cifras exactas se mueven uno o dos puntos entre ejecuciones):
prototype      M= 16 ef_search=  40 recall@5=0.90
production     M= 16 ef_search= 100 recall@5=0.97
high_accuracy  M= 32 ef_search= 200 recall@5=1.00
Tres cosas que sacar de aquí. Primera: los presets son reales; el orden es exactamente el que afirma la diapositiva. Segunda —y esta es la idea de toda la parte—: las tres ejecuciones devolvieron cinco documentos y no lanzaron nada. El preset de prototipo perdió uno de cada diez vecinos verdaderos y no te dijo nada al respecto. Tercera: fíjate en lo ruidoso que es 10 queries × k = 5: cincuenta juicios no bastan para distinguir un cambio de dos puntos en el recall, que es tu primera lección sobre el tamaño del golden set. Los vectores gaussianos aleatorios en 1536 dimensiones son además un caso deliberadamente difícil para ANN, así que lee estas cifras como una cota inferior, no como una previsión para tu corpus.
Cuándo escalar: cuatro síntomas, cuatro diagnósticos
Antes de comprar nada, ponle nombre al síntoma. La tabla del curso 03:18:05–03:19:07:
| Síntoma | Causa probable | Solución |
|---|---|---|
| Las queries tardan ≥ 100 ms | el índice es demasiado grande para la memoria | añadir más RAM, o sharding |
| Picos en la latencia de inserción | cuello de botella de escritura | escalar las escrituras por separado |
| Errores de memoria agotada | el índice no cabe en lo que estás haciendo | instancia más grande, o sharding |
| La precisión cae | ef_search demasiado bajo para la nueva escala | subir ef, o sharding |
Tres observaciones que la tabla no hace por ti.
El umbral de 100 ms es un umbral de búsqueda vectorial, no de extremo a extremo. El p95 de tus usuarios está dominado por la generación, que se mide en segundos. Un paso de retrieval de 100 ms no es, por tanto, una emergencia de latencia para el usuario: es un diagnóstico de que tu índice ha dejado de caber holgadamente en RAM. Trátalo como una alarma de memoria disfrazada de latencia.
La fila 4 es la importante, y es fácil pasarla por alto. Un ef_search que era correcto con 100 K vectores no es correcto con 10 M vectores. Una lista de candidatos fija explora una fracción cada vez menor de un grafo que crece, así que el recall decae en silencio a medida que crece el corpus. No ha cambiado nada en tu código. No hay errores. Tus respuestas simplemente empeoran un poco cada semana.
El crecimiento degrada por sí solo la calidad del retrieval. Reajusta ef cuando crezca el corpus; la configuración de ayer no es una prueba sobre la de hoy.
La fila 2 es el único arreglo que no tiene que ver con la RAM. «Escalar las escrituras por separado» apunta a la separación de lecturas y escrituras —un camino de escritura dedicado, réplicas para las lecturas, inserciones en batch—, y el original lo nombra y nunca lo desarrolla. En ningún punto del capítulo se da una topología de réplicas, un diseño de colas ni orientaciones sobre batching. Trátalo como una pista, no como un diseño. Su única implicación práctica sobre la que puedes actuar hoy: mide la latencia de inserción en su propia serie, porque un cuello de botella de escritura es invisible en un dashboard de latencia de queries.
No puedes actuar sobre nada de esto sin instrumentación
Cada fila de arriba es una medición. Por eso la Parte 7 va antes que la Parte 8 en esta guía, aunque el curso las ordene al revés: los disparadores no sirven de nada si no puedes verlos. El colector de métricas del repo tiene la forma correcta y el alcance equivocado:
# production-course-main-code/monitoring.py:95-105 — the summary the repo produces
    def get_summary(self) -> dict:
        avg_latency = (
            self.metrics["latency_sum"] / self.metrics["latency_count"]
            if self.metrics["latency_count"] > 0
            else 0
        )
        error_rate = (
            self.metrics["errors_total"] / self.metrics["requests_total"]
            if self.metrics["requests_total"] > 0
            else 0
        )
Dos carencias para lo que nos ocupa. Primera: InstrumentedLLM cronometra la llamada al LLM, no la llamada de retrieval; la señal de 100 ms que necesitas le resulta invisible. Segunda: informa de avg_latency_ms, y una media oculta justo la cola que estás buscando: un índice que se ha salido a medias de la RAM muestra una media correcta y un p95 catastrófico.
Instrumenta el propio retriever y quédate con los percentiles:
# Original: retrieval-only timing, built on the repo's MetricsCollector shape.
# Wrap the retriever, not the chain — the index signal lives here.
import time
from collections import deque
from statistics import quantiles


class TimedRetriever:
    def __init__(self, retriever, window: int = 2000):
        self.retriever = retriever
        self.samples_ms: deque[float] = deque(maxlen=window)

    def invoke(self, query: str):
        start = time.perf_counter()
        docs = self.retriever.invoke(query)          # never swallow: no try/except here
        self.samples_ms.append((time.perf_counter() - start) * 1000)
        return docs

    def p95_ms(self) -> float:
        if len(self.samples_ms) < 20:
            return 0.0                                # too few samples to have a tail
        return quantiles(self.samples_ms, n=20)[-1]   # 19th cut point = 95th percentile
Alerta cuando p95_ms() >= 100. Ese es el disparador de escalado del curso, hecho medible. El deque acotado importa más de lo que parece: una lista de muestras sin límite en un proceso de API de larga duración es una fuga de memoria lenta dentro de tu propio detector de presión de memoria.
Y para la fila 4 —la degradación de la precisión— no hay ninguna señal de tiempos. Necesitas el golden set de la Parte 7 (pregunta → chunk esperado) reproducido de forma programada, con el recall@k seguido como serie temporal y conectado a la puerta de regresión de CI de la Parte 13. Sin él, la fila 4 es indetectable por construcción; el arnés del desplegable de arriba es la versión más pequeña que funciona.
Vertical antes que horizontal
Escalado vertical: compra RAM, no cambies nada
Definición: «simplemente coge una máquina más grande, más RAM, más CPU» 03:20:08. El ejemplo resuelto:
| RAM | Vectores | Latencia de query | |
|---|---|---|---|
| Antes | 8 GB | 100 K | ~50 ms |
| Después | 32 GB | 100 K | ~10 ms |
Mismos datos. Mismo índice. Mismo código. 5× más rápido. El mecanismo se enuncia en cuatro palabras:
«Eso significa que el índice cabe en memoria.» 03:20:08
Esa frase es la física de toda esta parte. El rendimiento de la búsqueda vectorial es, antes que nada, una cuestión de si el índice cabe en RAM. Todo lo demás —M, ef, sharding, elección de proveedor— viene después de esa única condición binaria. Cuando el índice se desborda, el recorrido del grafo empieza a tocar disco con patrones de acceso aleatorio, que es lo peor que le puedes hacer a un dispositivo de almacenamiento.
Las tres condiciones que el instructor asocia al escalado vertical 03:20:08: estás por debajo de 5–10 M vectores, tu presupuesto da para una instancia más grande y —la que la gente se salta— la simplicidad te importa más que el coste. Esa tercera condición es una decisión real, no relleno: una máquina más grande suele ser la respuesta cara y aun así la correcta, porque todas las respuestas más baratas cuestan tiempo de ingeniería.
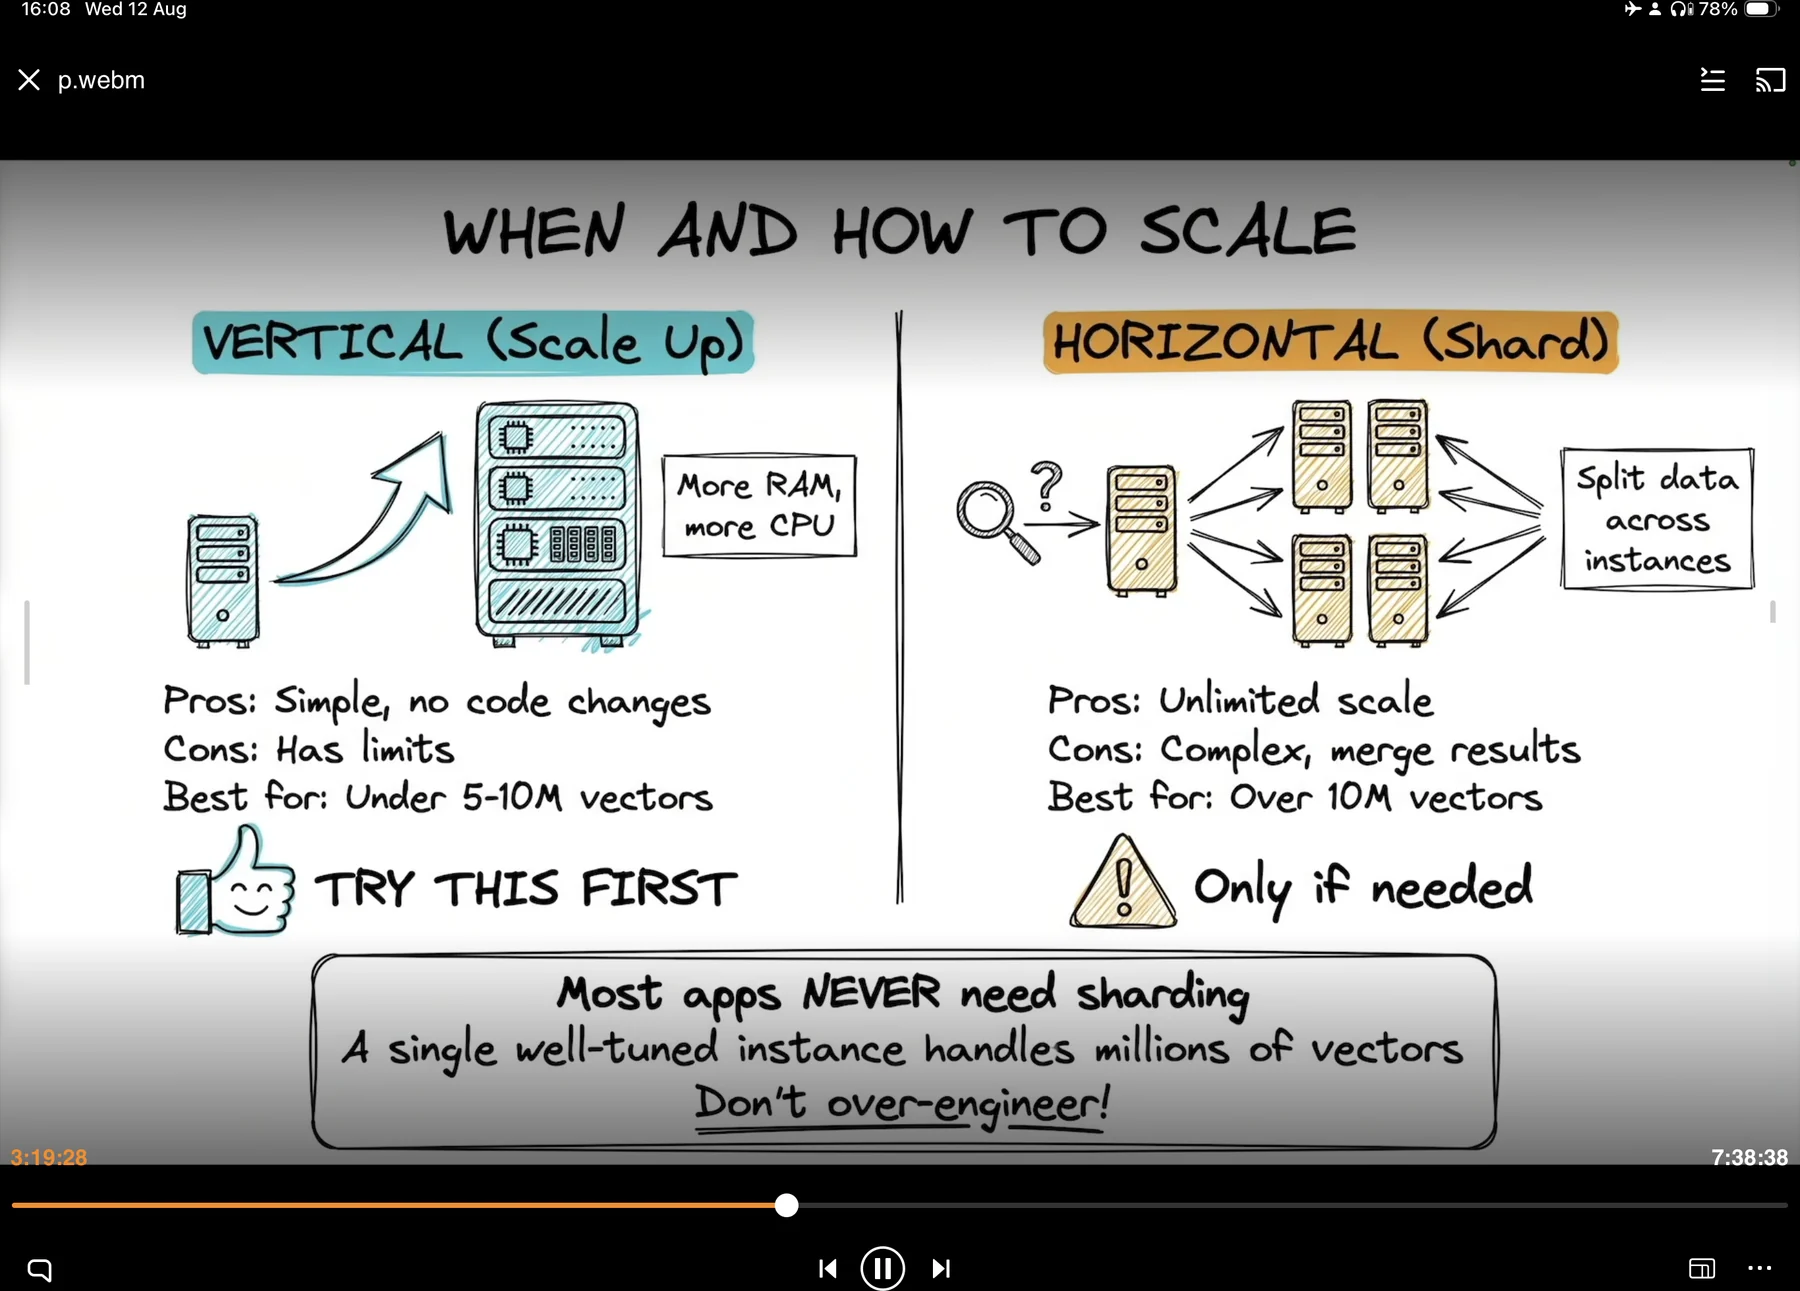
La tarjeta de la diapositiva 13 para el escalado vertical: Pros «Sencillo, sin cambios de código» · Contras «Tiene límites» · Ideal para «Menos de 5-10M vectores» · insignia «TRY THIS FIRST».
«el escalado vertical es el más fácil, el más rápido. Así que siempre probarías esto primero.» 03:20:08
Escalado horizontal: divide los datos, hereda un problema de fusión
Definición: repartir tus datos entre varias instancias, cada una con una porción 03:20:08–03:21:10. Pros: escala ilimitada. Contras: complejidad, «porque estás fusionando resultados y todo eso» 03:21:10. Ideal para: más de 10 millones de vectores. Insignia: «Only if needed».
El coste del sharding no son los servidores. Es la corrección. Cada query se reparte ahora entre N shards y algo tiene que fusionar N conjuntos de resultados en un único ranking, lo que introduce modos de fallo que sencillamente no existen en una sola instancia:
- Cada shard debe devolver más que tu
kfinal (normalmentekpor shard, y luego fusionar y
truncar); si no, pierdes documentos del verdadero top-k que casualmente se agruparon en un shard.
- Los scores tienen que ser comparables entre shards. Con distancia coseno suelen serlo; con cualquier
normalización de scores, fusión híbrida (el RRF de la Parte 6) o reranking por shard, a menudo no lo son.
- El recall deja de ser uniforme: un shard cuya porción resulta ser más densa tiene un problema de búsqueda
más difícil con el mismo ef.
- Un shard lento o que se está reiniciando degrada todas las queries, no una de cada N.
Ese desarrollo es mío; el original solo enuncia el coste como «fusionar resultados y todo eso». Pero es ahí donde viven los bugs, y es por lo que la frase contra el hype da en el clavo:
«la mayoría de aplicaciones no necesitan realmente sharding… en la mayoría de los casos eso es simplemente sobreingeniería.» 03:21:10
El banner inferior de la diapositiva 13 es toda la tesis del capítulo, y yo lo colgaría en la pared:
«La mayoría de aplicaciones NUNCA necesitan sharding. Una sola instancia bien ajustada maneja millones de vectores. ¡No caigas en la sobreingeniería!»
El orden de escalada
- Ajusta primero el índice. ef cuesta un cambio de ajuste. M cuesta una reconstrucción. El hardware cuesta dinero
cada mes, para siempre.
- Escala verticalmente. Máquina más grande, más RAM/CPU. Sin cambios de código. Sirve hasta aproximadamente
5–10 M vectores.
- Haz sharding. Solo por encima de ~10 M vectores, solo cuando el paso 2 esté agotado y solo con los ojos
bien abiertos ante el reparto y la fusión.
Managed frente a self-hosted
La misma lógica de «elige dos», subida una capa: de los parámetros del índice a la infraestructura. Los cuatro factores del curso, con Pinecone como ejemplo de managed y pgvector self-hosted como ejemplo de hazlo-tú-mismo 03:21:10–03:22:13:
| Factor | Managed (Pinecone) | Self-hosted (pgvector) |
|---|---|---|
| Infraestructura | automática, te la hacen | la gestionas tú entera |
| Carga operativa | cero | muy considerable: «tienes que cargar con el peso» |
| Coste a escala | «bastante caro» | «no tan caro… las cosas están controladas» |
| Control | «muy limitado, porque es managed» | total |
El intercambio es simétrico y honesto: cambias dinero por carga operativa, y control por comodidad. Aquí tampoco hay ningún vértice gratis.
El diagrama de decisión 03:22:13–03:23:14:
ASCII original
Under 1 million vectors?
├── YES → a single pgvector instance is just fine.  (stop here)
└── NO  → Do you have a DevOps team?
          ├── NO  → use Pinecone (easy, managed, nothing to worry about)
          └── YES → Is cost a primary concern?
                    ├── NO  → stick with Pinecone for convenience
                    └── YES → self-host pgvector
Fíjate en cuál es la primera pregunta: el tamaño del corpus, no las funcionalidades del proveedor. Por debajo del millón de vectores, todo el debate entre managed y self-hosted es irrelevante, y cualquier tiempo que le dediques es tiempo que no dedicas al chunking, que es, según el invariante 1, de donde sale realmente tu calidad. Comprimido en dos frases:
«si no quieres lidiar con operaciones, ve directamente a managed. Si el coste importa a escala, entonces self-host…» 03:23:14
Lo que este capítulo deja abierto a propósito
Enumera las carencias en lugar de fingir que estaban cubiertas:
- El propio algoritmo HNSW: nunca se explica más allá de la imagen del grafo. A propósito.
- Dinero. Este capítulo solo dice «caro» y «no tan caro». La Parte 9 tiene las
facturas reales, y divergen 5× entre 500 K y 5 M vectores.
- Quantization y reducción de dimensiones como alternativas a comprar RAM: directamente relevantes
para «¿cabe el índice en memoria?», y aquí no se mencionan en absoluto. Parte 9.
- «Escalar las escrituras por separado»: se nombra como el arreglo para los picos de latencia de inserción y nunca
se desarrolla como diseño.
- Medir los cuatro síntomas: depende por completo de las Partes 7 y 13.
- Qdrant: se nombra una vez en todo el curso y nunca se vuelve a él.
- IVF/IVFFlat, product quantization y DiskANN: las otras familias de índices que ofrecen pgvector y
el ecosistema en general. Fuera del alcance del original; conviene saber que existen para cuando tu índice de verdad no quepa en RAM a ningún precio.
Decisiones que tomar
Recorre esta lista en orden. Detente en cuanto tus números sean aceptables: cada paso por debajo de tu punto de parada es sobreingeniería.
- Confirma qué propiedad está rota. ¿Falta el chunk correcto por culpa del embedding
(geometría equivocada) o del índice (geometría correcta, pero la búsqueda aproximada se lo saltó)? Ejecuta un escaneo por fuerza bruta sobre una muestra y compáralo con el resultado ANN: el helper recall_at_k de arriba es esa prueba. Si los dos se pierden el chunk, el problema está aguas arriba: vuelve a la Parte 3.
- Escribe explícitamente los parámetros de tu índice, aunque sean los valores por defecto, y compruébalos
al arrancar leyendo la configuración de vuelta. Un collection_metadata sin fijar es una decisión que no tomaste. Empieza con M = 16, ef_construction = 100, ef_search = 100 y fija explícitamente la métrica de distancia.
- Fija
ef_searchdonde realmente surta efecto. En pgvector detrás de un pool, eso significa por
cada conexión tomada del pool, o SET LOCAL dentro de la transacción de búsqueda, no una vez al arrancar. En Chroma significa al crear la colección, o modify(configuration=…) después.
- Comprueba que
ef_search ≥ k, con margen. Multiplica por el factor de fetch del reranker si tienes
uno. Un retrieve-para-rerank con k=100 y ef_search=100 está mal configurado.
- Instrumenta la latencia del retrieval por separado de la latencia de generación, y quédate con el p95, no con
la media. Alerta a partir de 100 ms. Dale a las inserciones su propia serie.
- Programa una regresión de recall@k con un conjunto fijo de queries. Es la única forma de
ver cómo decae la precisión a medida que crece el corpus: el fallo que no tiene mensaje de error.
- Cuando te falte precisión, sube primero ef. 100 → 200. Mide. Sin reconstrucción, sin re-embedding.
- Solo entonces sube M (16 → 32), aceptando una reconstrucción y más RAM de forma permanente.
- Antes de comprar hardware, comprueba si el índice cabe en RAM. Si no cabe, compara el
coste de la RAM con el de vectores más cortos (1536 → 512) o de la quantization (float32 → int8): Parte 9.
- Escala verticalmente. Sin cambios de código. Sirve hasta 5–10 M vectores.
- Elige managed o self-hosted según la desigualdad, no según el número de vectores: pasa a self-hosted cuando
el ahorro mensual > el coste operativo, y nunca te alojes tú mismo sin alguien cuyo trabajo sea mantenerlo en marcha.
- Haz sharding lo último, por encima de ~10 M vectores, y solo después de poner por escrito cómo vas a fusionar y
ordenar los resultados entre shards. Si no eres capaz de escribir ese párrafo, no estás preparado para hacer sharding.
El resumen en una línea de toda esta parte: ajusta ef, compra RAM, no hagas sharding.