
Chunking: la palanca de calidad más importante
Splitters, chunk size y overlap, semantic chunking y un harness A/B: la palanca que decide todo lo que viene después.
Estás en la fase A, caja 2 del modelo mental: Load ──► Split ──► Embed ──► Store. Esta es la caja que decide si alguna de las cajas a su derecha podrá funcionar. Todo lo de las Partes 4 a 16 —mejores embeddings, búsqueda híbrida, reranking, compresión, retrieval agéntico— opera sobre unidades que fabrica esta etapa. Si las unidades están mal, toda esa maquinaria está puliendo el objeto equivocado.
Es el invariante 1 reformulado en su versión más afilada: la calidad se hereda hacia delante y nunca se recupera aguas abajo. El instructor lo llama la «verdad brutal» 00:33:37: el mejor embedding model, la base de datos vectorial más rápida y el LLM más listo, juntos, siguen produciendo basura si el chunking está mal. El dinero no arregla un bug de chunking.
«El chunking no es preprocesamiento. Es arquitectura». 00:36:40
Repite la frase dos veces seguidas a propósito. El chunk es el átomo de tu sistema: es lo que se convierte en embedding, lo que se indexa, lo que se recupera, lo que acaba en la context window y sobre lo que se pide al modelo que razone. Elegir su forma es una decisión de arquitectura con la misma permanencia que elegir un esquema y, como concreta la Parte 4, cambiarla más adelante supone hacer re-embed y reindexar todo el corpus.
Esta parte carga la teoría al principio de forma deliberada, porque la teoría es lo que te permite leer el experimento del final. Ese experimento es el resultado más valioso del curso de origen, porque refuta la propia recomendación del curso: en un documento estructurado por encabezados, el chunking semántico —la estrategia «premium»— pierde 1 a 4 frente al chunking recursivo de toda la vida.
Dónde encaja el splitting: el pipeline de indexación en cuatro etapas
La mitad de indexación del RAG son cuatro etapas y nada más 00:28:27:
- Load — un document loader extrae el texto y normaliza los formatos (Parte 2).
- Split — corta el texto en chunks de unos 500 a 1,000 caracteres, respetando
los límites de las frases y añadiendo overlap para que el significado sobreviva a las costuras.
- Embed — convierte cada chunk en un vector (Parte 4).
- Store — escribe los vectores, el texto original y los metadatos en una base de datos vectorial (Parte 4).
Solo después de la etapa 4 el sistema está listo para recibir queries. La etapa 2 es la que merece un estudio a fondo, porque es la única en la que haces un juicio irreversible sobre el significado sin ninguna señal de feedback. Las etapas 1, 3 y 4 fallan con estrépito: si falta un parser, salta una excepción; si la dimensión es incorrecta, salta una excepción; si la conexión es mala, salta una excepción. La etapa 2 nunca lanza nada. Produce chunks perfectamente válidos de texto perfectamente inútil y los pasa aguas abajo.
El fallo que no ves: el chunk 47 y el chunk 48
Toma el ejemplo que el curso usa durante todo el capítulo: 50 páginas de documentación de una API que contienen una sección de autenticación OAuth2 00:29:29.
Haz chunking con un tamaño fijo de 500 caracteres. No hay ningún algoritmo detrás de ese límite: cortas donde se acaba el contador. La sección de OAuth2 cae justo encima del corte, a mitad de frase:
- El chunk 47 acaba conteniendo algo como *«para autenticarte primero necesitas obtener
el client ID…»*
- El chunk 48 continúa con «…developer portal, y luego haz una petición POST…»
Ahora un usuario pregunta «¿cómo me autentico con OAuth2?». El veredicto 00:30:32:
«Cuando buscamos, ningún chunk tiene la respuesta completa».
El chunking semántico, sobre este mismo documento, corta en cambio por el límite de significado, y toda la sección de OAuth2 cae intacta en un único chunk 12. Mismos documentos, mismo embedding model, misma base de datos vectorial, misma query: «resultados como la noche y el día» 00:31:34. La única variable que cambió fue cómo se cortó el texto.
Por qué falla, mecánicamente
Esta es la idea más sutil y más útil del capítulo, y vale la pena ir despacio. Cuando generas el embedding del chunk 47, el embedding model hace su trabajo a la perfección. Lee credenciales de cliente, algo sobre desarrolladores, un pensamiento incompleto, y produce un vector fiel exactamente de eso. No tiene forma de saber que el texto es un fragmento. Su trabajo es generar embeddings 00:31:34.
«No está mal. Está representando con precisión un fragmento incompleto». 00:32:35
Así que el vector resultante es correcto e inútil. Tu vector de query codifica un concepto completo; tus vectores almacenados codifican fragmentos. Esas dos cosas no viven en el mismo vecindario del espacio de embeddings, así que la búsqueda por similitud devuelve lo que esté más cerca de medio pensamiento, que suele ser otro medio pensamiento. La diapositiva lo ilustra con un cristal hecho añicos; el instructor recurre a una analogía mejor 00:32:35:
«Imagina que rompes una fotografía en pedazos y le pides a alguien que encuentre a la persona que sonríe».
Si la sonrisa queda partida entre dos pedazos, ninguno de los dos muestra una sonrisa. El rasgo por el que quieres buscar solo existe en el conjunto. Romperlo lo destruye, y ninguna mejora de la búsqueda lo recupera.
Los tres daños aguas abajo
Un mal chunking degrada exactamente tres cosas 00:33:37, y vale la pena nombrarlas por separado porque tienen síntomas distintos:
| Daño | Síntoma que observas |
|---|---|
| Precisión del retrieval | El chunk correcto nunca aparece en el top-k. |
| Eficiencia de contexto | Quemas context window en chunks parciales: has pagado tokens que no responden nada. |
| Calidad de la respuesta | Incluso recuperando los chunks correctos, el modelo no puede sintetizar a partir de fragmentos; necesita una sección completa. |
Fíjate en que el tercero sobrevive a un retriever perfecto. Esa es la parte que se le escapa a la gente: arreglar el retrieval no arregla la fragmentación, porque el modelo sigue recibiendo texto roto.
Las cuatro variables que realmente controlas
Hay exactamente cuatro mandos 00:33:37: chunk size, overlap, límite de corte y tipo de contenido. Toda estrategia de chunking que exista es una configuración concreta de estas cuatro.
Variable 1 — Chunk size (un fallo por los dos lados)
| Dirección | Qué se rompe | Efecto de segundo orden |
|---|---|---|
| Demasiado pequeño | Los fragmentos pierden contexto: un chunk que solo dice «client ID» no significa nada | Más chunks → más ruido en el retrieval (más candidatos compitiendo por el top-k) |
| Demasiado grande | Los datos concretos se diluyen en la media: 10 páginas de texto dan un embedding muy vago | Presupuesto de tokens desperdiciado en la context window |
El punto óptimo está entre unos 200 y 1,000 tokens 00:34:38. El barrido del propio repo usa exactamente ese rango:
# production-course-main-code/text_splitters.py
def chunk_size_comparison():
    sizes = [200, 500, 1000]

    print("=== Chunk Size Comparison ===")
    for size in sizes:
        splitter = RecursiveCharacterTextSplitter(
            chunk_size=size, chunk_overlap=size // 5
        )  # 20% overlap
        chunks = splitter.split_text(SAMPLE_TEXT)
        print(f" Size {size}: {len(chunks)} chunks")
Variable 2 — Overlap
El overlap duplica una región de texto entre chunks consecutivos para que una idea que cae sobre la costura sobreviva entera en al menos un chunk 00:34:38. Sin overlap, una frase que cruza el límite queda huérfana por los dos lados y no se preserva el contexto.
Regla general: 10–20% del chunk size. El repo no es coherente consigo mismo sobre cuál de los dos, y deberías saberlo antes de copiar un número:
RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)— 10% — se usa en
recursive_splitter(), document_splitter(), rag_pipeline.create_kb() y, en la práctica, en todo el repo de producción.
chunk_overlap = size // 5— 20% — solo se usa enchunk_size_comparison().
Los dos aparecen a menos de 20 líneas de distancia en el mismo fichero. Toma el 10% como el valor por defecto que se entrega y el 20% como el «buen overlap» del que habla la regla 80/20.
Vale la pena ejecutar la demo de overlap una vez, porque hace visible la costura:
# production-course-main-code/text_splitters.py
def overlap_importance():
    text = "The quick brown fox jumps over the lazy dog. " * 10  # Repeated text

    # without overlap
    no_overlap = RecursiveCharacterTextSplitter(chunk_size=50, chunk_overlap=0)

    # with overlap
    with_overlap = RecursiveCharacterTextSplitter(chunk_size=50, chunk_overlap=20)

    chunks_no_overlap = no_overlap.split_text(text)
    chunks_with_overlap = with_overlap.split_text(text)

    print("Without overlap:")
    print(f"  Chunk 1 end: ...{chunks_no_overlap[0][-20:]}")
    print(f"  Chunk 2 start: {chunks_no_overlap[1][:20]}...")

    print("\nWith overlap:")
    print(f"  Chunk 1 end: ...{chunks_with_overlap[0][-20:]}")
    print(f"  Chunk 2 start: {chunks_with_overlap[1][:20]}...")
Esa frase —«The quick brown fox jumps over the lazy dog»— es la misma que usa la diapositiva de chunking fijo para mostrar la carnicería a mitad de palabra. La demo imprime los últimos 20 caracteres del chunk 1 junto a los primeros 20 del chunk 2, para que veas con tus propios ojos si la costura se ha cerrado.
Variable 3 — Límite de corte
Tres métodos, ordenados de peor a mejor 00:35:40:
| Método | Qué decide el corte | Veredicto |
|---|---|---|
| Fijo | Cada N caracteres: «básicamente, más bien un corte aleatorio» | No lo uses. |
| Recursivo | Separadores estructurales naturales, probados por orden de preferencia | Más inteligente. El valor por defecto. |
| Semántico | Donde cambia el significado: ni al azar ni simplemente en los párrafos | Premium, condicional. |
Variable 4 — Tipo de contenido
El código, los documentos legales y el Markdown son tipos de contenido muy distintos, y cada uno necesita un tratamiento diferente 00:35:40. El desastre canónico es el código: parte un bucle for por la mitad y ninguna de las dos mitades sirve como contexto, porque en el momento de la query el modelo no tiene forma de reensamblar las piezas 00:36:40. La regla para el código es sencilla: mantén juntas las funciones, mantén juntas las clases.
Las cuatro estrategias
El curso las presenta como una escalera de madurez 00:37:42: fijo (básico) → recursivo (intermedio) → semántico (intermedio) → late chunking (avanzado).
«Cuando entiendes el chunking, controlas la calidad del RAG en el origen». 00:37:42
Estrategia 1 — Chunking de tamaño fijo: nunca
Mecanismo: cortar cada N caracteres o tokens, sin ninguna consciencia del contenido. Con la frase «The quick brown fox jumps over the lazy dog», la diapositiva recorre la carnicería 00:37:42:
- Chunk 1 =
"The quick brown fox jump": corte a mitad de palabra, incompleto. - Chunk 2 =
"ps over the la": sin contexto, pérdida total del fragmento. - Chunk 3 =
"zy dog": demasiado pequeño para ser útil.
La lista de daños: destruye el significado, pierde el contexto, retrieval pobre, frases incompletas y un texto que a un modelo le cuesta de verdad entender. El aviso del instructor es la frase más enfática de todo el capítulo:
«No uses esto en producción. ¿Vale? Jamás. Jamás. Jamás. Nunca jamás». 00:39:43
Los usos legítimos son pocos: implementaciones sencillas en las que necesitas procesamiento rápido y tamaños predecibles, prototipos rápidos, o una restricción externa estricta que imponga ventanas fijas. Fíjate en que CharacterTextSplitter —el splitter de tamaño fijo— se importa en el text_splitters.py del curso y nunca se llama. Ese silencio es la recomendación.
Estrategia 2 — Chunking recursivo: el valor por defecto fiable
El chunking recursivo es el valor por defecto en LangChain y, según el instructor, en muchos otros frameworks. Su mecanismo es una escalera de fallback: intenta cortar por el separador natural de mayor preferencia; si una pieza resultante sigue siendo mayor que chunk_size, baja recursivamente al siguiente separador.
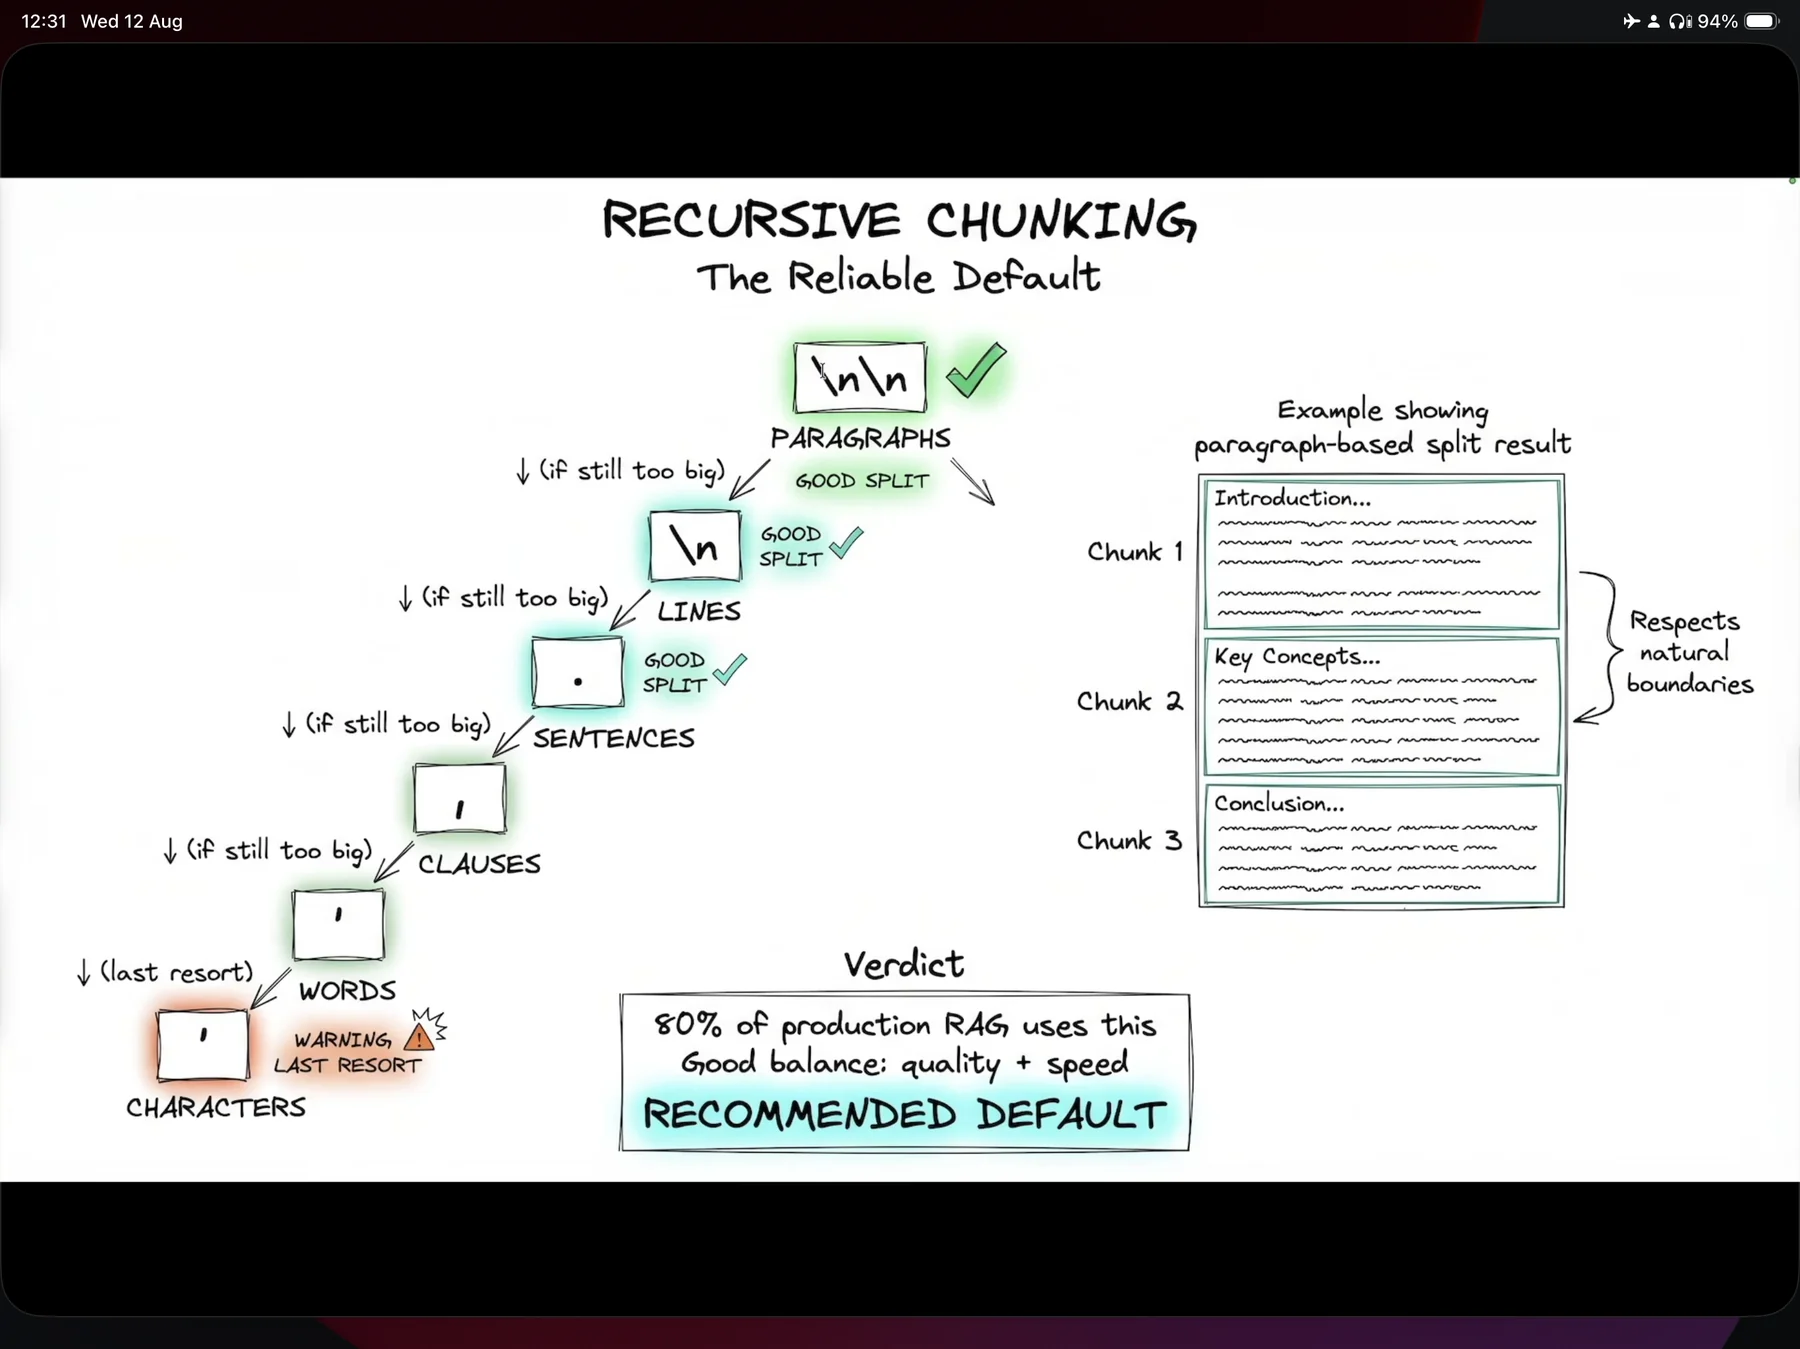
chunk_size, así que un documento bien formado con saltos de párrafo reales nunca baja de \n\n; justo por eso el chunking recursivo gana el test A/B del final de esta parte.La jerarquía, por orden:
- Párrafos —
\n\n✅ buen corte - Líneas —
\n✅ buen corte - Frases —
.✅ buen corte - Cláusulas —
, - Palabras —
- Caracteres — ⚠ ÚLTIMO RECURSO
El ejemplo resuelto de la diapositiva es un documento cuyos tres párrafos —Introduction, Key Concepts, Conclusion— se convierten intactos en los chunks 1, 2 y 3: la escalera nunca pasa del primer peldaño, así que los límites que puso el propio autor sobreviven intactos.
Debajo de este orden hay una teoría del significado, y por eso la escalera no es arbitraria: un párrafo es un pensamiento; una frase es un pensamiento; por debajo de eso estás cortando dentro de un pensamiento. Cada descenso cambia un poco más de significado por un poco más de cumplimiento del tamaño. Llegar al peldaño de los caracteres es posible, pero indeseable 00:40:45.
El recuadro de veredicto de la propia diapositiva:
El 80% del RAG en producción usa esto. Buen equilibrio: calidad + velocidad. VALOR POR DEFECTO RECOMENDADO.
Esa cifra del 80% no tiene fuente: es la impresión de campo del instructor, no una medición. La dirección es correcta (el recursivo es el valor por defecto de la industria), pero no cites el número como un hecho.
Esta es la implementación real, con la escalera pasada de forma explícita:
# production-course-main-code/text_splitters.py
def recursive_splitter():
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=500,
        chunk_overlap=50,
        separators=["\n\n", "\n", " ", ""],
    )
    chunks = splitter.split_text(SAMPLE_TEXT)

    print(f"Original length: {len(SAMPLE_TEXT)} chars")
    print(f"Number of chunks: {len(chunks)}")
    print(f"Chunk sizes: {[len(c) for c in chunks]}")
    print(f"\nFirst chunk preview:\n{chunks[0][:200]}...")
Tres cosas en las que fijarte:
separators=["\n\n", "\n", " ", ""]es exactamente el valor por defecto de la librería (character.py
recurre a esa lista cuando separators es None). Aquí se pasa por claridad. Fíjate también en que es más corta que la jerarquía de la diapositiva: la versión del repo omite los peldaños de frase (.) y de cláusula (,) y salta directamente de líneas a palabras. Si quieres el comportamiento de la diapositiva, tienes que pasar tú la escalera completa: separators=["\n\n", "\n", ". ", ", ", " ", ""].
- El
""final importa. Es el peldaño que corta entre caracteres arbitrarios, y es
el único peldaño que puede garantizar que una pieza quepa. Quítalo y un tramo de texto que no se puede partir se emite sobredimensionado, con solo un logging.warning («Created a chunk of size N, which is longer than the specified M») para avisarte. Si no estás capturando los logs de LangChain, ese aviso es invisible.
split_text()devuelve una lista de strings planos, no objetosDocument. Eso importa
muchísimo: mira la trampa de split_documents más abajo.
Estrategia 3 — Chunking semántico: la opción premium
El chunking semántico corta por significado, no por estructura 00:41:45. El algoritmo tiene tres pasos:
- Generar el embedding de cada frase por separado.
- Comparar embeddings adyacentes: la similitud entre la frase i y la i+1.
- Cortar donde cae la similitud. La caída es el límite del tema.
Recorre el gráfico de similitud: mientras las frases consecutivas siguen en el mismo tema, la similitud adyacente se mantiene alta; cuando cae, el significado ha terminado y ese punto se convierte en el límite del chunk. Las frases se agrupan en tramos: chunk 1 = S1, S2, S3; chunk 2 = S4, S5, S6; cortes limpios, basados en el tema 00:42:46.
En código:
# Reconstructed from the narration at [02:41:01]; the on-screen file
# chunking/semantic_chunking.py is not present in either published repo.
# Requires a separate install: uv add langchain-experimental
from langchain_experimental.text_splitter import SemanticChunker
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

semantic_splitter = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile",
    breakpoint_threshold_amount=90,
)
semantic_chunks = semantic_splitter.split_text(API_DOCS)
Los dos parámetros son toda la superficie de configuración:
| Parámetro | Significado |
|---|---|
breakpoint_threshold_type="percentile" | Decide los puntos de corte por percentil de la distribución de disimilitud observada (las alternativas son desviación estándar, rango intercuartílico y gradiente). |
breakpoint_threshold_amount=90 | Corta en el percentil 90: solo el ~10% de los saltos de significado más grandes se convierten en límites. Más alto = menos chunks y más grandes. |
Dónde encaja: RAG de alto valor en el que la calidad importa: documentos legales, manuales técnicos, bases de conocimiento 00:41:45. El trade-off se dice sin rodeos: úsalo cuando la precisión importe más que la velocidad, porque hay más cómputo en segundo plano.
Estrategia 4 — Late chunking: el enfoque más reciente (referencia adelantada)
El chunking tradicional (también llamado early) es: documento → cortar en chunks 1, 2, 3 → generar el embedding de cada chunk por separado. Cada chunk se convierte en embedding de forma aislada, así que pierde el contexto entre chunks: el chunk 5 no tiene ni idea de lo que contienen los chunks 1 a 4 00:43:47. El síntoma clásico, en palabras del propio fichero del repo del curso: «He founded the company»: ¿quién es «he»? El referente estaba en el chunk anterior.
El late chunking invierte el orden: primero genera el embedding del documento completo (produciendo embeddings a nivel de token) y después divide esos embeddings en vectores por chunk haciendo pooling de los embeddings de token de cada tramo. Como primero se ha generado el embedding de todo el documento, los chunks saben unos de otros.
| Late chunking | |
|---|---|
| Resultado | Mejora de precisión del +10–12% en tareas de retrieval |
| Ventajas | Se preserva el contexto completo del documento; mejor gestión de los límites |
| Inconvenientes | Implementación más compleja; soporte limitado de modelos |
| Requiere | Un modelo que exponga embeddings a nivel de token: la familia Jina |
El veredicto para hoy 00:45:48:
«Este es el futuro del chunking… pero, de momento, el chunking semántico es tu mejor opción práctica».
El tratamiento completo de late frente a early chunking está en la Parte 14. No apuestes la producción a esto todavía.
Las cuatro estrategias, lado a lado
| Estrategia | Regla de corte | Coste de indexación | Calidad | Úsala cuando |
|---|---|---|---|---|
| Fijo | Cada N caracteres/tokens | Trivial | Destruye el significado | Nunca en producción; solo prototipos y restricciones estrictas |
| Recursivo | Escalera ordenada de separadores | Trivial | Buena | Valor por defecto para casi todo |
| Semántico | Caída de similitud entre frases adyacentes | Genera el embedding de cada frase y luego vuelve a hacerlo de cada chunk | La mejor en prosa continua | Texto no estructurado, legal, manuales técnicos |
| Late | Corta después de generar el embedding del documento | Modelo especial + más complejidad | +10–12% | Atento a su evolución (Parte 14) |
Cómo elegir una estrategia
El árbol de decisión
Recórrelo en orden 00:45:48:
- ¿Tiene que ser rápido (prototipo) o es aceptable que sea lento? → rápido ⇒ recursivo.
- ¿Son documentos sencillos y estructurados? → sí ⇒ recursivo.
- ¿La calidad es crítica? → sí ⇒ semántico.
- ¿Hay cambios de tema dentro del contenido? → sí ⇒ semántico; no ⇒ recursivo.
Fíjate en lo que puede devolver el árbol: solo recursivo o semántico. El chunking fijo y el late chunking no son salidas válidas del árbol de decisión de producción. El fijo queda excluido por malo; el late, por no estar maduro.
La regla 80/20 y la puerta de medición
«El chunking recursivo con un buen overlap te lleva el 80% del camino». 00:46:48
«El chunking semántico te da el último 20%. Pero el problema es que cuesta más». 00:46:48
Y la disciplina que va con ella:
«Empieza con el recursivo y mide la calidad de tu retrieval». 00:46:48
Esa es la frase importante. El paso del recursivo al semántico está condicionado a una métrica, no a la ambición. No puedes gastar en chunking semántico hasta que tengas un número de calidad del retrieval que diga que el recursivo no basta. (Cómo conseguir ese número es tema de la Parte 7, observabilidad, y de la Parte 15, evals. Es uno de los motivos principales por los que esta guía adelanta la observabilidad respecto al curso de origen).
La chuleta por tipo de contenido
El instructor dice explícitamente que le hagas una captura a esta 00:46:48:
| Tipo de contenido | Estrategia | Chunk size |
|---|---|---|
| Documentos generales | Recursivo: «usa el recursivo y ya está» | 500–1,000 |
| Contenido técnico / legal | Semántico: «merece la pena» | auto |
| Código | Splitter de código | por función |
| Markdown | Splitter de MD | por encabezados |
«Auto» en la fila del semántico significa que no fijas ningún tamaño: lo decide el umbral de corte, y los tamaños de chunk salen variables por construcción. Es una diferencia operativa real: con chunking semántico no puedes prometer un límite superior para la longitud del chunk, y por eso smart_chunker valida los tamaños después.
Los splitters especializados
LangChain incluye los splitters específicos por tipo de contenido, así que nunca tienes que programarte a mano un splitter que entienda Python o Markdown 00:47:49.
Código: nunca uses un splitter genérico
# production-course-main-code/text_splitters.py
def code_splitter():
    python_splitter = RecursiveCharacterTextSplitter.from_language(
        language=Language.PYTHON, chunk_size=500, chunk_overlap=50
    )
    chunks = python_splitter.split_text(SAMPLE_CODE)
    print(f"Code Splitter produced {len(chunks)} chunks.")
    for i, chunk in enumerate(chunks):
        print(f"\nChunk {i} ({len(chunk)} chars):")
        print(chunk[:150] + "..." if len(chunk) > 150 else chunk)
from_language(language=Language.PYTHON, ...) sustituye la escalera de separadores genérica por una que entiende la sintaxis. Para Python, la librería devuelve, por orden: ["\nclass ", "\ndef ", "\n\tdef ", "\n\n", "\n", " ", ""]: primero las definiciones de clase, luego las funciones de nivel superior, luego los métodos indentados y solo después los peldaños normales de prosa. Ese orden es lo que mantiene enteras las funciones y las clases. El fixture SAMPLE_CODE del curso son dos funciones —quicksort() y binary_search()—, elegidas precisamente para que veas cómo el límite cae entre ellas y no dentro de una.
Markdown: los encabezados se convierten en metadatos
# production-course-main-code/text_splitters.py
def markdown_splitter():
    headers_to_consider = [
        ("#", "h1"),
        ("##", "h2"),
        ("###", "h3"),
    ]
    splitter = MarkdownHeaderTextSplitter(headers_to_split_on=headers_to_consider)
    chunks = splitter.split_text(SAMPLE_TEXT)

    print(f"Markdown Splitter produced {len(chunks)} chunks.")
    for i, chunk in enumerate(chunks):
        print(f"--- Chunk {i} ---")
        print(f" Metadata: {chunk.metadata}\n")
        print(f" Content: {chunk.page_content[:200]}...\n")
Lo importante son las tuplas (marker, metadata_key). Cada chunk vuelve con su ruta de encabezados en metadata; para el fixture SAMPLE_TEXT del repo es {"h1": "Introduction to Machine Learning", "h2": "Types of Machine Learning", "h3": "Supervised Learning"}. Eso es lo que hace posibles las citas a nivel de encabezado aguas abajo («esto viene de §Types of Machine Learning → Supervised Learning»), y es un campo filtrable en el momento de la query. Como concretará la Parte 4, la filtrabilidad se decide en el momento de indexar. Si no capturas ahora la ruta de encabezados, no podrás filtrar ni citar por ella más adelante sin reindexar.
split_documents frente a split_text: la trampa que destruye los metadatos
Es el error más habitual de todo este terreno, y es invisible hasta que tus citas salen vacías.
| Método | Entrada | Salida | Metadatos |
|---|---|---|---|
split_text(str) | un string | list[str] | destruidos: nunca los hubo |
split_documents(docs) | una lista de Document | list[Document] | propagados a cada chunk |
split_documents recibe una lista, incluso para un solo documento. Este es el cableado real de extremo a extremo de las etapas 1 + 2, sacado directamente del repo:
# production-course-main-code/text_splitters.py
def document_splitter():
    from langchain_community.document_loaders import PyPDFLoader
    from langchain_core.documents import Document

    loader = PyPDFLoader("./docs/langchain_demo.pdf")
    docs = loader.load()

    print(f"Loaded {len(docs)} documents from PDF.")

    splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)

    # split the docs
    split_docs = splitter.split_documents(docs)

    print(f"Split into {len(split_docs)} chunks")
    print(f"\nFirst chunk metadata: {split_docs[0].metadata}")
    print(f"First chunk content: {split_docs[0].page_content[:200]}...")
    print(f"\nLast chunk metadata: {split_docs[-1].metadata}")
Imprimir los metadatos del primer y del último chunk es el hábito que vale la pena copiar: demuestra que los campos source y page sobrevivieron al corte en todo el rango, no solo al principio. (La función vuelve a importar PyPDFLoader y Document dentro de su propio cuerpo, aunque Document ya está importado a nivel de módulo; es inofensivo, pero no lo reproduzcas como estilo).
Y cuando el texto no llega desde un loader, envuélvelo tú en un Document para poder adjuntar los metadatos que querrás citar; es exactamente lo que hace el fichero del pipeline:
# production-course-main-code/rag_pipeline.py
def create_kb():
    """Create a vector store from knowledge base."""

    # split the knowledge base into chunks
    splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
    doc = Document(
        page_content=KNOWLEDGE_BASE, metadata={"source": "langchain_knowledge_base.md"}
    )

    chunks = splitter.split_documents([doc])

    # create a vector store from the chunks
    vector_store = Chroma.from_documents(
        documents=chunks,
        embedding=embeddings_model,
        persist_directory=tempfile.mkdtemp(),
    )
    return vector_store
Ese es el pipeline completo de cuatro etapas en catorce líneas: un Document (etapa 1), un corte recursivo a 500/50 (etapa 2), embeddings_model = OpenAIEmbeddings(model="text-embedding-3-small") declarado una sola vez a nivel de módulo (etapa 3) y Chroma.from_documents (etapa 4). Fíjate en split_documents([doc]): los corchetes de lista alrededor de un único documento.
El A/B medido: el chunking semántico pierde 1–4
Todo lo anterior es teoría, y la teoría dice que el chunking semántico es la opción premium. Después el curso hace lo honesto y lo mide 02:37:58. El resultado contradice la teoría, y el instructor lo deja en el vídeo en lugar de repetir la demo: «Me alegro de que haya pasado esto para enseñaros los matices de estas distintas estrategias» 02:48:09. Esa decisión es la razón por la que estos son los veinte minutos más útiles del material de origen.
«¿De verdad funciona mejor el chunking semántico?» 02:37:58
El diseño del experimento
Lo reutilizable es el arnés, más que el resultado:
| Elemento | Valor |
|---|---|
| Corpus | Un documento con cuatro temas deliberadamente distintos: webhooks, gestión de errores, rate limiting y autenticación OAuth 2.0 |
| Formato del documento | Básicamente, un fichero Markdown con encabezados de sección ## |
| Embedding model | text-embedding-3-small, idéntico en los dos brazos |
| Brazo A | RecursiveCharacterTextSplitter(chunk_size=400, chunk_overlap=50, separators=["\n\n", "\n", ",", ". "]) |
| Brazo B | SemanticChunker(embeddings, breakpoint_threshold_type="percentile", breakpoint_threshold_amount=90) |
| Stores | Dos colecciones de Chroma separadas, una por brazo, con collection_names distintos |
| Queries | Las mismas 4 queries en los dos |
| Retrieval | similarity_search(query, k=1) |
Los temas se eligieron para ser lo más distintos posible precisamente para que la contaminación entre chunks se vea al instante 02:38:58. Y k=1 se eligió a propósito 02:45:05: con un único resultado no hay dónde esconderse; el primer resultado o es correcto o no lo es. Con k=4, los dos brazos habrían parecido estar bien.
Hay un detalle del brazo A que conviene copiar a propósito o corregir a propósito: la lista de separadores termina en ". ", sin peldaño " " ni "". Si una sección hubiera superado los 400 caracteres sin ninguna coma ni ningún punto, el splitter la habría emitido sobredimensionada y solo habría registrado un aviso. En este corpus no pasa nunca; en el tuyo podría pasar.
Qué salió
Primera señal, solo con inspeccionar los chunks [02:42:02–02:43:02]:
| Recursivo | Semántico | |
|---|---|---|
| Total de chunks | 4 | 3 |
| Chunk 1 | Guía de autenticación OAuth, 300 caracteres | autenticación |
| Chunk 2 | rate limiting, 283 caracteres | rate limiting + gestión de errores (mezclados) |
| Chunk 3 | gestión de errores | webhooks |
| Chunk 4 | webhooks | — |
| Mezcla de temas | ninguna | 1 de 3 chunks |
El cuarto chunk que falta lo explica todo: el chunking semántico fusionó dos secciones en un solo chunk, mientras que el recursivo mantuvo un tema por chunk. Fíjate en que aquí «mezcla de temas» es una etiqueta humana que el instructor sacó leyendo el volcado de chunks, no una métrica calculada; es lo primero que tienes que automatizar cuando adaptes este arnés (etiqueta cada chunk con los encabezados de sección de los que viene su texto y cuenta los chunks que abarcan más de uno).
Después, el test de retrieval, en el orden en que lo ejecuta [02:45:05–02:47:07]:
| # | Query tal como se ejecutó | Recursivo (k=1) | Semántico (k=1) |
|---|---|---|---|
| 1 | «How do I authenticate with OAuth 2?» | ✅ guía de autenticación | ✅ guía de autenticación |
| 2 | «What happens when I hit the rate limit?» | ✅ chunk de rate limiting | ❌ devolvió el chunk de OAuth |
| 3 | «How are webhooks secured?» | ✅ chunk de webhooks | ❌ devolvió el chunk mezclado |
| 4 | «What format are errors returned in?» | ✅ chunk de gestión de errores | ❌ devolvió el mismo chunk mezclado |
| Score | 4/4 | 1/4 |
Por qué perdió el semántico
No porque el algoritmo fallara. Porque funcionó 02:43:02:
«Hizo exactamente lo que se supone que tiene que hacer».
El rate limiting y la gestión de errores tratan los dos de respuestas de la API. Sus frases generan embeddings muy próximos. Por eso la disimilitud entre frases adyacentes nunca alcanzó el umbral del percentil 90 en el límite entre secciones, así que SemanticChunker —correctamente, según su propia definición— decidió no cortar ahí y pegó las dos secciones en un solo chunk. El embedding model no tiene acceso a la taxonomía de tu documento; solo ve qué frases suenan parecidas.
El chunking recursivo, en cambio, no tenía ninguna opinión sobre el significado. Encontró un \n donde el autor había escrito un encabezado y cortó ahí. El instructor lo reconoce con franqueza 02:41:01:
«Los chunks se cortan en puntos arbitrarios. No pasa nada. Es mejor que nada».
El chunk 2 existe, señala, únicamente porque hay un salto de línea. Fue el separador estructural, no ninguna comprensión semántica, lo que produjo un chunk limpio de rate limiting. El autor ya había hecho la segmentación por temas —en los encabezados— y el chunking recursivo simplemente la respetó.
Fíjate también en el radio de impacto. Una mala fusión no costó una query, costó dos: en cuanto dos temas comparten chunk, las queries sobre cualquiera de los dos devuelven el mismo bloque ruidoso. Los chunks fusionados envenenan el retrieval de todos los temas que contienen.
La regla que se desprende. En documentos bien estructurados con encabezados claros, el chunking estructural recursivo preserva límites lógicos que el chunking semántico destruye. El chunking semántico brilla en texto continuo no estructurado en el que los cambios de tema no están marcados con encabezados 02:47:07: reconstruye límites que el autor nunca escribió. Cuando el autor sí los escribió, respetarlos es estrictamente mejor que volver a deducirlos. Dicho de otro modo: el chunking semántico es un algoritmo de reconstrucción de límites, y la reconstrucción solo aporta valor cuando falta el original.
La lección metodológica: nunca juzgues un chunker mirando los chunks
Esta es la parte que tienes que interiorizar aunque nunca ejecutes este experimento 02:44:04:
- El resumen de la inspección de chunks decía que el semántico era algo peor: 3 chunks en lugar de 4, uno
con mezcla de temas. Algo peor.
- El test de retrieval decía que el semántico era catastróficamente peor: 1/4 frente a 4/4.
Mirar los chunks a ojo no te dice casi nada. Un chunk que parece prosa razonable puede seguir siendo la unidad de retrieval equivocada. Mide el retrieval de extremo a extremo y pon al lado una columna de mezcla de temas: convertirla en una magnitud medida de primera clase es el verdadero recurso didáctico del capítulo.
El arnés A/B, reconstruido y ejecutable
Los dos ficheros con los que trabaja el instructor en pantalla —chunking/semantic_chunking.py y chunking/production_ready.py— no están en ninguno de los dos repos publicados. Pertenecen a un repositorio «Part 3 — Optimize for Quality» que nunca se clonó. Lo que sigue está reconstruido a partir de la transcripción y de los parámetros que lee en voz alta; no es una copia literal de su fichero. Instala primero: uv add langchain langchain-openai langchain-chroma chromadb langchain-experimental.
"""A/B one chunking decision: recursive vs semantic, judged on retrieval."""

from dotenv import load_dotenv
from langchain_chroma import Chroma
from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_experimental.text_splitter import SemanticChunker

load_dotenv()
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# One Markdown-shaped string, four `##` sections separated by blank lines.
# Replace the bodies with your own corpus; keep the headings.
API_DOCS = """## OAuth 2.0 Authentication
To authenticate, first obtain a client ID from the developer portal, then make
a POST request to /oauth/token with your client credentials...

## Rate Limiting
The API allows 1000 requests per hour per API key. When you exceed the limit
the API returns 429 with a Retry-After header...

## Error Handling
Always check the HTTP status code before parsing the body. Errors are returned
as JSON with `code`, `message` and `details` fields...

## Webhooks
Register a webhook endpoint to receive event notifications. Verify the
signature header on every delivery before trusting the payload...
"""

# --- Arm A: recursive -------------------------------------------------
recursive = RecursiveCharacterTextSplitter(
    chunk_size=400,
    chunk_overlap=50,
    separators=["\n\n", "\n", ",", ". "],
)
recursive_chunks = recursive.split_text(API_DOCS)

# --- Arm B: semantic --------------------------------------------------
semantic = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile",
    breakpoint_threshold_amount=90,
)
semantic_chunks = semantic.split_text(API_DOCS)


def print_chunks(name, chunks):
    """Diagnostic ergonomics: you cannot compare chunkers by squinting at lists."""
    print(f"\n=== {name}: {len(chunks)} chunks, "
          f"avg {sum(len(c) for c in chunks) // len(chunks)} chars ===")
    for i, c in enumerate(chunks):
        print(f"--- chunk {i} ({len(c)} chars) ---")
        print(c[:200].replace("\n", " "), "...")


print_chunks("RECURSIVE", recursive_chunks)
print_chunks("SEMANTIC", semantic_chunks)

# --- Two stores, one per arm -----------------------------------------
recursive_store = Chroma.from_texts(
    recursive_chunks, embeddings, collection_name="recursive_chunks"
)
semantic_store = Chroma.from_texts(
    semantic_chunks, embeddings, collection_name="semantic_chunks"
)


def test_retrieval(query, vectorstore, name):
    """k=1: the top hit is either right or wrong. Nowhere to hide."""
    results = vectorstore.similarity_search(query, k=1)
    print(f"\n[{name}] {query}")
    print(f"  -> {results[0].page_content[:160]!r}")


QUERIES = [
    "How do I authenticate with OAuth 2?",
    "What happens when I hit the rate limit?",
    "How are webhooks secured?",
    "What format are errors returned in?",
]

for q in QUERIES:
    test_retrieval(q, recursive_store, "recursive")
    test_retrieval(q, semantic_store, "semantic")
Cuatro cosas que conservar cuando lo adaptes: dos colecciones separadas (nunca mezcles brazos en un mismo store), k=1, un helper print_chunks y una etiqueta de mezcla de temas por chunk. Y el último paso de la receta, el que todo el mundo se salta: lee la estructura del documento de origen antes de sacar ninguna conclusión; los encabezados son la explicación 02:48:09.
smart_chunker: el compromiso de producción
Después de demostrar que el chunking semántico puede fallar, el curso entrega un wrapper que da por hecho que normalmente no fallará, pero que sobrevive cuando falla [02:48:09–02:49:11]. Cuatro requisitos:
- Semántico como principal.
- Recursivo como fallback si falla el semántico.
- Validar los tamaños de chunk.
- Gestionar los errores con elegancia: una excepción del splitter nunca debe tumbar una ingesta.
La firma es smart_chunker(text, use_semantic=True), y el flag booleano existe por un motivo concreto: hace que el camino de fallback sea testeable. Puedes forzar la rama recursiva en un test sin romper ni mockear la rama semántica.
# Reconstructed from the narration at [02:48:09-02:49:11]; the on-screen file
# chunking/production_ready.py is not present in either published repo.
# MIN_CHUNK / MAX_CHUNK are our values -- the course names requirement 3
# ("validate chunk sizes") without giving thresholds. Pick yours deliberately.
import logging

from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_experimental.text_splitter import SemanticChunker

logger = logging.getLogger(__name__)

MIN_CHUNK = 100
MAX_CHUNK = 2000


def smart_chunker(text: str, use_semantic: bool = True) -> list[str]:
    """Semantic chunking with a recursive fallback and size validation.

    Requirement 1: semantic primary.
    Requirement 2: recursive fallback on any failure.
    Requirement 3: validate chunk sizes.
    Requirement 4: never let a splitter exception kill the ingest.
    """

    def _recursive_fallback(t: str) -> list[str]:
        splitter = RecursiveCharacterTextSplitter(
            chunk_size=500,
            chunk_overlap=50,
            separators=["\n\n", "\n", ". ", ", ", " ", ""],
        )
        return splitter.split_text(t)

    if not use_semantic:
        return _recursive_fallback(text)

    try:
        splitter = SemanticChunker(
            OpenAIEmbeddings(model="text-embedding-3-small"),
            breakpoint_threshold_type="percentile",
            breakpoint_threshold_amount=90,
        )
        chunks = splitter.split_text(text)
    except Exception as exc:  # network, rate limit, experimental-API breakage
        logger.warning("semantic chunking failed (%s); falling back to recursive", exc)
        return _recursive_fallback(text)

    # Requirement 3: semantic chunking gives you no size guarantee at all.
    oversized = [c for c in chunks if len(c) > MAX_CHUNK]
    if oversized:
        logger.warning(
            "%d/%d semantic chunks exceed %d chars; re-splitting those",
            len(oversized), len(chunks), MAX_CHUNK,
        )
        repaired = []
        for c in chunks:
            repaired.extend(_recursive_fallback(c) if len(c) > MAX_CHUNK else [c])
        chunks = repaired

    return [c for c in chunks if len(c.strip()) >= MIN_CHUNK]
El argumento del coste sobrevive a la demo fallida, y es justo exponerlo bien: lo que afirma el instructor en 02:50:15 es que con el chunking semántico el coste es mínimo y la implementación sencilla. Es cierto para el código. No lo es para la factura en tiempo de indexación sobre un corpus grande, y por eso existe la puerta de medición.
Lo que el chunking no puede arreglar, y quién lo arregla
El chunking es un problema de partición: cada trozo de texto cae exactamente en una unidad principal, y elijas el límite que elijas, destruyes algo. Es inevitable, y por eso existen varias técnicas posteriores cuyo único fin es recuperar lo que costó la partición:
| Técnica | Qué recupera | Dónde |
|---|---|---|
| Parent-document retrieval | Busca sobre chunks pequeños y focalizados, y pasa al LLM el documento padre grande | Parte 6 |
| Compresión contextual | Elimina los tramos irrelevantes de los chunks recuperados sobredimensionados | Parte 6 |
| Búsqueda híbrida | Recupera las coincidencias de términos exactos que un embedding de chunk diluido perdió | Parte 6 |
| Contextual retrieval | Antepone a cada chunk un contexto del documento generado por un LLM antes de generar el embedding | Parte 14 |
| Late chunking | Genera primero el embedding de todo el documento, para que los vectores de chunk lleven contexto entre chunks (+10–12%) | Parte 14 |
Todas son más caras que acertar con el límite a la primera. Recurre a ellas después de haber medido que un splitter recursivo bien configurado es de verdad insuficiente, no en lugar de configurarlo.
Decisiones que tomar
Repasa esta lista una vez por corpus, no una vez por proyecto.
- ¿Cuál es mi tipo de contenido, de verdad? Prosa, Markdown, código, PDF de tablas o una mezcla. Si
es una mezcla, ¿dónde vive el dispatcher de enrutado?
- ¿Qué estrategia me da el árbol de decisión? Prototipo rápido o documentos estructurados →
recursivo. Calidad crítica o cambios de tema sin marcar → semántico. El fijo nunca es una respuesta.
- ¿Qué chunk size y en qué unidad? Empieza con 500 caracteres; contrástalo con
el punto óptimo de 200–1,000 tokens; decide si presupuestas en caracteres o en tokens y sé coherente, porque la factura va en tokens.
- ¿Qué overlap? El 10% (
chunk_overlap=50con 500) como valor por defecto entregado, el 20%
(size // 5) si te puedes permitir la duplicación. Nunca cero.
- ¿Mi escalera de separadores termina en
""? Sin ese último peldaño, un tramo que no se puede partir se
emite sobredimensionado y solo queda registrado en el log. ¿Estás capturando siquiera los avisos de LangChain?
- ¿Estoy usando
split_documents()? Si algún camino del código llama asplit_text()sobre documentos
reales del corpus, tus citas ya se han perdido. Compruébalo imprimiendo split_docs[0].metadata y split_docs[-1].metadata.
- ¿Qué metadatos tiene que llevar cada chunk? Como mínimo
source; la ruta de encabezados para Markdown;
page/page_label para PDF. Decídelo ahora: la filtrabilidad queda fijada en el momento de indexar.
- Si es Markdown: ¿hay una segunda pasada que imponga el tamaño?
MarkdownHeaderTextSplitterpor sí solo
no limita el chunk size.
- Si es código: ¿estoy usando
from_language()? Un splitter genérico sobre código fuente es un defecto. - ¿Cómo voy a medir la calidad del retrieval? Define el arnés antes de elegir la estrategia. Dos
colecciones, las mismas queries, k=1 y una etiqueta de mezcla de temas.
- ¿He ejecutado de verdad el A/B sobre mi propio corpus? El resultado publicado es 4/4 frente a 1/4 en
un documento estructurado por encabezados. El tuyo será distinto. El arnés se puede trasladar; el número, no.
- Si es semántico: ¿cuál es el camino de fallo? Fallback al estilo de
smart_chunker, validación de tamaños
y una línea de log lo bastante ruidosa como para que una ingesta parcialmente degradada se vea.
- ¿Tengo un plan de reindexación? Cambiar el chunk size, el overlap o la estrategia invalida todos
los vectores que tienes almacenados. Presupuesta el re-embed antes de afinar, no después.
Checklist antes de pasar a la Parte 4
- El chunking de tamaño fijo no aparece en ningún punto de mi camino de ingesta.
RecursiveCharacterTextSplitteres mi valor por defecto, con una escalera de separadores explícita si quiero los peldaños de frase y de cláusula, y esa escalera termina en"".chunk_overlapes el 10–20% dechunk_size, nunca 0.- Todas las llamadas al splitter del pipeline son
split_documents([...]), nosplit_text(). - Los metadatos de los chunks llevan
sourcey todo aquello por lo que pienso citar o filtrar. - El código pasa por
from_language(); el Markdown pasa porMarkdownHeaderTextSplittermás una segunda pasada que impone el tamaño. - Tengo un arnés de retrieval con dos colecciones y
k=1que puedo volver a ejecutar cuando quiera. - Tengo un número de calidad del retrieval para el recursivo antes de gastar nada en el semántico.
- Si el semántico está activado, hay un fallback recursivo, validación de tamaños y un log de aviso.
- La configuración del splitter vive en un único sitio del código, porque la voy a cambiar y voy a reindexar.
Llévate una frase a la Parte 4: el embedding model codificará fielmente todo lo que le des, y nunca te dirá que lo que le diste era medio pensamiento.