
El presupuesto de coste y latencia
Quantization, batching, tres capas de caching y un modelo de costes resuelto: recupera el dinero.
Todas las partes anteriores gastaron dinero para comprar calidad. El chunking semántico pagaba una llamada de embedding por frase. La búsqueda híbrida ejecuta dos retrievals en lugar de uno. Multi-query lanza tres reformulaciones. El reranking añade un modelo. Cada una se justificaba por sí misma, y cada una subía en silencio tu factura por request y tu p95.
Esta es la parte en la que recuperas el dinero.
Recuerda el modelo mental de la Parte 1: el pipeline está gobernado por tres presupuestos en tensión permanente — CALIDAD, LATENCIA, DINERO. Las Partes 3 a 6 optimizaron la calidad. La Parte 7 te dio la instrumentación para ver los tres. La Parte 8 hizo que el índice sobreviviera a la escala. Esta parte se ocupa de los otros dos presupuestos y defiende una tesis por encima de todas: el coste no es una partida que descubres a final de mes. Es un parámetro de diseño, fijado en cuatro medidores concretos del pipeline — y si no lo fijas tú, el pipeline lo fija por ti. Esos cuatro medidores son la tabla siguiente.
Las fuentes son tres capítulos: la mitad del capítulo 11 dedicada al presupuesto de tokens (02:13:12–02:21:10), el capítulo 16 entero sobre los costes reales de la búsqueda vectorial (03:23:35–03:33:17) y la mitad del capítulo 18 dedicada al caching (03:54:27–04:04:41). Dos de las tres son mitades huérfanas — los marcadores de capítulo del curso no coinciden con los límites de sus lecciones, así que el presupuesto de tokens va grapado al final de un capítulo de búsqueda híbrida y el caching al final de un capítulo de Supabase. Están a hora y media de distancia en la línea temporal y nunca se presentan entre sí. Juntas forman un stack completo de control de costes, y esta parte es donde por fin se encuentran.
Adónde va realmente el dinero
El invariante 3 de la Parte 1 es todo el marco: el coste en tiempo de indexación es único; el coste en tiempo de query se repite en cada request. Cada optimización de esta parte es una aplicación de esa frase. Antes de optimizar nada, tienes que saber cuál de los cuatro medidores estás leyendo.
| Medidor | Fase | Se factura por | Escala con | Lo trata |
|---|---|---|---|---|
| Tokens de embedding (corpus) | Índice, único | tokens embebidos | tamaño del corpus × número de reindexaciones | Parte 4 |
| Almacenamiento + RAM del índice | Índice, recurrente | vectores almacenados | número de vectores × dimensiones × bytes/dim | Parte 8, esta parte |
| Embedding de la query + búsqueda vectorial | Query, por request | una llamada de embedding + una (o dos) búsquedas | queries/día | esta parte |
| Tokens de entrada + salida del LLM | Query, por request | tamaño del contexto + tamaño de la respuesta | queries/día × k × chunk size | esta parte |
De la tabla salen directamente dos consecuencias.
Primera: el índice es una compra de capacidad y el camino de la query es una compra de consumo. Responden a palancas completamente distintas. Reducir tus vectores de 1536 a 512 dimensiones arregla la segunda fila para siempre y no hace absolutamente nada por la cuarta. Cachear respuestas arregla la cuarta fila y no hace nada por la segunda.
Segunda — y esto sorprende a la gente —: en un sistema RAG típico la base de datos vectorial no es la parte cara. Lo es el LLM. RAG existe para meter texto recuperado en un prompt; esa es toda su descripción del puesto. Un retrieval con k=4 de chunks de 500 tokens añade 2,000 tokens de entrada a cada request, para siempre. Haremos esta cuenta de forma explícita al final de la parte.
Modo de fallo n.º 4: context overflow, y la request que se come tu día
El capítulo 11 gira en 02:13:12 de la búsqueda híbrida al cuarto de los cinco modos de fallo nombrados en la Parte 1: el context overflow (desbordamiento de contexto). El enfoque es de calidad — al LLM se le entrega más contexto del que realmente puede usar y empieza a ignorar la mitad —, pero el mecanismo que el instructor enseña en realidad es financiero, y lo dice de inmediato:
«con un LLM todo va de tokens. De hecho, así es como se nos cobra la inferencia.» 02:13:12
Los tokens son a la vez la unidad de degradación de la calidad y la unidad de facturación. Esa coincidencia es lo que hace que una sola protección sirva para ambos problemas.
El ejemplo trabajado tiene la forma de un incidente real de producción. Un usuario pega un contrato de 200 páginas en tu caja de chat y escribe «Resume esto». Esa request son más de 50,000 tokens de entrada y unos 2,000 tokens de salida 02:14:13.
«una sola request acaba de costarte lo mismo que 100 requests normales. Sin límites, una mala request puede reventar tu presupuesto diario.» 02:14:13
Fíjate en lo que no está mal aquí. El usuario no hizo nada malicioso. Tu código no dio error. Tu retrieval estaba bien. Cada capa se comportó exactamente según su diseño — es el invariante 4, los fallos son silenciosos, aplicado al dinero en lugar de a la corrección. El único rastro es una línea en una factura que leerás tres semanas después.
El presupuesto de tokens: un portero, no un contable
La solución es una barrera que se ejecuta antes de la llamada a la API. Ese orden es todo el valor del patrón, y el instructor insiste en ello:
«sin llamada a la API, no hay coste.» 02:16:18
Un contador que se ejecuta después de la llamada te da una entrada de log preciosa y una factura real. Una comprobación que se ejecuta antes te da un rechazo y cero dólares 02:14:13.
La implementación son dos clases pequeñas en cost_optimization.py. Primero el libro de cuentas:
# production-course-main-code/cost_optimization.py — lines 203-233
class TokenBudget:
    """Track and limit token usage."""

    def __init__(self, max_tokens_per_request: int = 4000):
        self.max_per_request = max_tokens_per_request
        self.usage = {"total_input": 0, "total_output": 0, "requests": 0}

    def estimate_tokens(self, text: str) -> int:
        """Rough token estimation (actual would use tiktoken)."""
        return int(len(text.split()) * 1.3)

    def check_budget(self, text: str) -> tuple[bool, int]:
        """Check if request is within budget."""
        tokens = self.estimate_tokens(text)
        return tokens <= self.max_per_request, tokens

    def record_usage(self, input_tokens: int, output_tokens: int):
        """Record token usage."""
        self.usage["total_input"] += input_tokens
        self.usage["total_output"] += output_tokens
        self.usage["requests"] += 1

    def get_stats(self) -> dict:
        return {
            **self.usage,
            "total_tokens": self.usage["total_input"] + self.usage["total_output"],
            "avg_per_request": (
                (self.usage["total_input"] + self.usage["total_output"])
                / max(self.usage["requests"], 1)
            ),
        }
Tres contadores — total_input, total_output, requests — más dos estadísticas derivadas, total_tokens y avg_per_request 02:14:13. Es la telemetría de costes mínima viable, y max(self.usage["requests"], 1) en el denominador es el pequeño detalle defensivo que permite llamar a get_stats() antes de la primera request.
El estimador es tosco a propósito. words × 1.3 02:15:17. El propio docstring lo admite — «actual would use tiktoken» (el real usaría tiktoken). La defensa del instructor es la mejor frase del segmento: esto es un portero, no un contable. La precisión no es su trabajo; rechazar, sí.
«para un guardrail, aproximado basta.» 02:15:17
Ahora el wrapper que lo hace cumplir:
# production-course-main-code/cost_optimization.py — lines 236-264
class BudgetedLLM:
    """LLM with token budgeting."""

    def __init__(self, max_tokens: int = 4000):
        self.llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
        self.budget = TokenBudget(max_tokens_per_request=max_tokens)

    @traceable(name="budgeted_invoke")
    def invoke(self, query: str) -> str:
        # Check budget
        within_budget, tokens = self.budget.check_budget(query)

        if not within_budget:
            raise ValueError(
                f"Query exceeds token budget: {tokens} > {self.budget.max_per_request}"
            )

        # Execute
        response = self.llm.invoke(query)
        result = response.content

        # Record usage
        output_tokens = self.budget.estimate_tokens(result)
        self.budget.record_usage(tokens, output_tokens)

        return result

    def get_stats(self) -> dict:
        return self.budget.get_stats()
El flujo, dicho sin rodeos 02:16:18: estimar → ¿por encima del presupuesto? rechazar, sin llamada a la API, $0 → si no, llamar → registrar → devolver. El límite por defecto es de 4,000 tokens por request; la demo lo baja a 100 para que la barrera salte con facilidad.
La demo ejecutable y la aritmética exacta del rechazo
# production-course-main-code/cost_optimization.py — lines 267-286
def demo_token_budgeting():
    """Demonstrate token budgeting."""

    llm = BudgetedLLM(max_tokens=100)

    queries = [
        "What is AI?",  # Within budget
        "Explain " + "very " * 100 + "complex topic",  # Over budget
    ]

    print("\nToken Budgeting Demo:\n")

    for query in queries:
        try:
            result = llm.invoke(query)
            print(f"✅ {query[:40]}... -> {result[:30]}...")
        except ValueError as e:
            print(f"❌ {query[:40]}... -> {e}")

    print(f"\nUsage: {llm.get_stats()}")
La query inflada es "Explain " + "very " × 100 + "complex topic". Eso se divide en 1 + 100 + 2 = 103 palabras, e int(103 × 1.3) = 133. La barrera compara 133 > 100 y lanza ValueError("Query exceeds token budget: 133 > 100") 02:17:18. Ninguna request llega nunca a OpenAI.
La query que pasa, "What is AI?", son 3 palabras → 3 tokens de entrada estimados. Cuando termina, las estadísticas que se imprimen en pantalla son total_input = 3, total_output = 282, requests = 1, total_tokens = 285, avg_per_request = 285 02:18:19.
Ten en cuenta que demo_token_budgeting() es la única demo que queda sin comentar bajo __main__ en el fichero publicado. Si quieres la demo de caching de más adelante en esta parte, descomenta demo_caching().
Los rechazos son eventos de observabilidad, no excepciones
invoke lleva @traceable(name="budgeted_invoke"). Ese decorador — el mismo de la Parte 7 — hace que el ValueError lanzado quede capturado como un trace de LangSmith de pleno derecho. Abre la ejecución y verás el nombre budgeted_invoke, el input, un output null y el traceback completo con el motivo 02:18:19. Una llamada correcta en la misma vista muestra además su cifra de latencia 02:18:19.
Un rechazo que solo existe como un HTTP 400 en un log de nginx es invisible. Un rechazo que aparece en el mismo árbol de traces que tus requests correctas responde tanto a «¿por qué no ha funcionado esto?» como a «¿con qué frecuencia rechazamos y de quién es ese tráfico?» — gratis.
Cuatro sitios, tres fórmulas, ninguna correcta
El repo cuenta tokens en cuatro sitios y no coincide consigo mismo en ninguno. Conviene saber que existen los cuatro para no sumar por accidente las salidas de dos de ellos:
| Fichero fuente | Fórmula | Resultado |
|---|---|---|
cost_optimization.py:212 (TokenBudget.estimate_tokens) | int(len(text.split()) * 1.3) | int, 1.3 tokens/palabra |
cost_optimization.py:67 (ModelRouter.invoke) | len(query.split()) * 1.3 | float — misma proporción, sin truncar |
monitoring.py:145 (InstrumentedLLM) | len(query.split()) * 4 // 3 | int, ≈1.333 tokens/palabra |
conversation_memory.py:190 | token_counter=llm en trim_messages | depende del proveedor |
Se parecen lo bastante entre sí como para ser indistinguibles en una demo y se alejan lo bastante de la realidad como para ser inútiles en una factura. La respuesta de verdad es que los modelos de chat modernos devuelven el recuento: llm.invoke(...) te entrega un AIMessage cuyo usage_metadata trae input_tokens, output_tokens y total_tokens directamente del proveedor. Registra eso. Usa la heurística words × 1.3 solo para la barrera previa, donde todavía no tienes respuesta ni otra opción.
Dos trampas más que conviene nombrar antes de desplegar esta clase. estimate_tokens usa .split(), así que cuenta palabras separadas por espacios — un blob JSON de 50,000 caracteres sin espacios se estima en más o menos un token y pasa sin problemas. Y TokenBudget es un objeto por proceso: detrás de un servidor de API con varios workers, cada worker mantiene sus propios contadores, así que get_stats() informa de la porción de un worker, no del gasto de tu sistema.
Del guardrail a la imputación de costes (chargeback)
El movimiento de producción no es un presupuesto global único — es la atribución:
«en producción lo que harías — registrarías estas estadísticas por usuario, por hora, por endpoint.» 02:19:23
En cuanto los contadores llevan esas tres dimensiones puedes decir «el usuario X ha consumido 50,000 tokens hoy» 02:19:23, que es la frase que desbloquea cualquier respuesta comercial: aplicarle rate limiting, cobrarle, pasarlo a un plan superior o tener una conversación. El planteamiento del instructor es tajante — averigua «quién está disparando tu coste» 02:19:23.
Cuándo añadir un presupuesto de tokens 02:20:25: cuando tienes entradas de cara al usuario, cuando la longitud de la entrada es impredecible o cuando necesitas seguimiento por usuario / por endpoint para imputar costes y prevenir abusos. Dicho de otro modo: casi siempre, y desde luego antes de exponer un endpoint a internet.
«Esto no es un juego. Es coste real y deberías plantearte en serio implementar estas estrategias.» 02:20:25
Los tres patrones del lado del LLM se combinan en un solo stack
El capítulo 11 cierra el segmento B nombrando el conjunto completo 02:19:23:
presupuesto de tokens + cache + enrutamiento de modelos = control de costes del LLM.
No son alternativas. Atacan partes distintas de la misma factura y se apilan en un orden concreto a lo largo del camino de la request — que, como formalizará la Parte 11, es primero los rechazos baratos, al final la inferencia cara:
- Presupuesto de tokens — rechaza lo que nunca deberías pagar. Coste: cero.
- Cache — devuelve lo que ya pagaste. Coste: una consulta a un dict.
- Enrutamiento de modelos — paga lo mínimo por lo que queda.
El router está en el mismo fichero:
# production-course-main-code/cost_optimization.py — lines 47-70
    @traceable(name="routed_query")
    def invoke(self, query: str) -> tuple[str, str, float]:
        """
        Route and invoke query.
        Returns: (response, model_used, estimated_cost)
        """
        complexity = self.classify_complexity(query)

        if complexity == "simple":
            model = self.cheap_model
            model_name = "gpt-4o-mini"
            cost_per_1k = 0.00015  # Input cost
        else:
            model = self.expensive_model
            model_name = "gpt-4o"
            cost_per_1k = 0.0025  # Input cost

        response = model.invoke(query)

        # Estimate cost (rough)
        tokens = len(query.split()) * 1.3  # Rough token estimate
        estimated_cost = (tokens / 1000) * cost_per_1k

        return response.content, model_name, estimated_cost
Dos precios, fijados en el código: gpt-4o-mini a $0.00015 por 1K tokens de entrada y gpt-4o a $0.0025 por 1K tokens de entrada — una diferencia de 16.7×. Esa proporción es todo el argumento económico del enrutamiento. classify_complexity es una tercera instancia ChatOpenAI(model="gpt-4o-mini", temperature=0) — el router contiene cheap_model, expensive_model y classifier — cuyo prompt termina con «Respond with only: simple or complex». Devuelve response.content.strip().lower(), y invoke se ramifica según esa cadena.
Otros tres defectos que arreglar antes de producción. Los precios son constantes literales que se quedan obsoletas en cuanto un proveedor cambia su tarifa — ponlos en una única tabla de precios que sea tuya y que versiones. La estimación ignora por completo los tokens de salida, que son el lado caro de la factura. Y prompt.format(query=query) convierte un ChatPromptTemplate en una cadena plana antes de pasárselo al modelo, tirando la estructura de mensajes; prompt.invoke({...}) o encadenar prompt | llm la conserva.
Recortar lo que envías: la mitad conversacional del presupuesto de tokens
Un presupuesto que solo rechaza es un instrumento romo. El movimiento complementario es hacer las requests más pequeñas para que nunca se acerquen al límite. En una app RAG con forma de chat, lo que crece sin límite no es el contexto recuperado — es el historial de la conversación, que se reenvía completo en cada turno. conversation_memory.py trae tres estrategias con curvas de coste realmente distintas. (Procedencia: ese fichero está en el repo del curso pero no se recorre en cámara en ningún capítulo. El código de abajo está citado de él y verificado; el análisis es de esta guía.)
Estrategia 1 — recortar hasta un techo de tokens. trim_messages de LangChain hace la aritmética por ti:
# production-course-main-code/conversation_memory.py — lines 186-193
    trimmed = trim_messages(
        messages,
        max_tokens=60,
        strategy="last",
        token_counter=llm,
        include_system=True,  # Always keep system message
        allow_partial=False,
    )
strategy="last" conserva los mensajes más recientes; include_system=True fija el system prompt para que tus instrucciones anti-alucinación de la Parte 1 nunca sean lo que se descarta; allow_partial=False se niega a cortar un mensaje por la mitad. Ojo con la trampa de token_counter=llm — aquí llm es el init_chat_model("gpt-4o-mini") de nivel de módulo. trim_messages llama al get_num_tokens_from_messages() de ese modelo, que en los modelos de chat de OpenAI es un recuento local con tiktoken, pero que ChatAnthropic implementa llamando a la API de recuento de tokens de Anthropic. Cambia de proveedor y tu mecanismo de control de costes empieza a hacer un viaje de ida y vuelta por la red en cada recorte. Pasa una función de recuento explícita si quieres previsibilidad.
Estrategia 2 — una ventana fija. Hereda del objeto de historial y corta:
# production-course-main-code/conversation_memory.py — lines 210-226
    class WindowedChatHistory(InMemoryChatMessageHistory):
        """Chat history that keeps only last k message pairs."""

        k: int = 3  # Pydantic field - number of exchange pairs to keep

        def add_messages(self, messages):
            super().add_messages(messages)
            # Keep only last k pairs (2k messages: human + ai)
            if len(self.messages) > self.k * 2:
                self.messages = self.messages[-(self.k * 2) :]

    store: Dict[str, WindowedChatHistory] = {}

    def get_session_history(session_id: str) -> BaseChatMessageHistory:
        if session_id not in store:
            store[session_id] = WindowedChatHistory(k=2)
        return store[session_id]
La demo ejecuta cinco intercambios con k=2 y luego imprime, con las propias palabras del fichero, exactamente lo que ha destruido — Lost: name (Paulo), city (Seattle), AND job (AI engineer) en una línea y Kept: cats + the 'remember' question en la siguiente. La línea de resumen del fichero es la declaración honesta del compromiso:
«Este es el compromiso: memoria fija = coste predecible, pero el contexto antiguo se pierde.»
Tres cosas que arreglar si lo copias. El corte cuenta mensajes, no turnos: asume que cada intercambio es exactamente un mensaje Human más uno AI, así que en cuanto un turno emite una tool call o una respuesta en varias partes, la ventana parte un par por la mitad y deja un historial que empieza con un mensaje del asistente — algo que algunos proveedores rechazan sin más. El valor por defecto de la clase, k: int = 3, nunca se usa (get_session_history construye WindowedChatHistory(k=2)), así que el número del docstring y el de producción no coinciden. Y si alguna vez guardas un mensaje de sistema dentro del historial — esta demo no lo hace, su system prompt vive en el ChatPromptTemplate —, el corte a ciegas lo expulsará junto con todo lo demás.
Estrategia 3 — resumen continuo. Conserva literalmente los últimos MAX_RECENT = 4 mensajes y comprime todo lo anterior en un resumen que se va actualizando:
Memoria con resumen continuo — la rama de desbordamiento completa
# production-course-main-code/conversation_memory.py — lines 349-379
        # 2. Add this exchange to recent messages
        recent_messages.append(HumanMessage(content=user_input))
        recent_messages.append(AIMessage(content=response))

        # 3. If recent messages exceed limit, summarize the oldest ones
        if len(recent_messages) > MAX_RECENT:
            # Take the oldest messages that will be summarized away
            messages_to_summarize = recent_messages[:-MAX_RECENT]
            formatted = "\n".join(
                f"{'Human' if isinstance(m, HumanMessage) else 'AI'}: {m.content}"
                for m in messages_to_summarize
            )

            # Update the running summary
            running_summary = summarize_chain.invoke(
                {
                    "current_summary": (
                        running_summary if running_summary else "None yet."
                    ),
                    "new_messages": formatted,
                }
            )

            # Keep only the most recent messages
            recent_messages = recent_messages[-MAX_RECENT:]

            print(
                f"  >>> Summarized! Compressed {len(messages_to_summarize)} old messages"
            )
            print(f"  >>> Summary: {running_summary}")
            print(f"  >>> Recent buffer: {len(recent_messages)} messages")
Merece la pena copiar el prompt de resumen tal cual. Resumir implica pérdida por definición; lo que hace este prompt es dirigir la pérdida a la prosa en lugar de a los hechos — «Preserve all key facts about the user» (conserva todos los datos clave sobre el usuario) es la cláusula que hace el trabajo:
# production-course-main-code/conversation_memory.py — lines 308-314
    summarize_prompt = ChatPromptTemplate.from_template(
        "Condense the current summary and new messages into a single updated summary "
        "(2-3 sentences). Preserve all key facts about the user.\n\n"
        "Current summary:\n{current_summary}\n\n"
        "New messages:\n{new_messages}\n\n"
        "Updated summary:"
    )
El fichero usa dos modelos a propósito: summary_llm con temperature=0 (compresión determinista) y chat_llm con temperature=0.7 (conversación natural). Es el mismo truco que la separación de responsabilidades de la Parte 5 — trabajos distintos, muestreo distinto.
El veredicto del propio fichero tras cinco intercambios: ALL facts preserved (name, city, job, cats, course) / But token cost stays bounded -- old messages are compressed, not deleted! Eso es lo que afirma la demo, no una medición; en una conversación más larga el resumen es justo donde los hechos van a morir en silencio, y por eso el callout de abajo te pide que lo registres.
| Estrategia | Coste en tokens | Fidelidad | Coste oculto |
|---|---|---|---|
| Recortar a N tokens | Techo duro | Solo lo reciente | El contador de tokens puede costar una llamada a la API |
| Ventana (últimos k pares) | Techo duro, trivialmente predecible | Los hechos antiguos se pierden, en silencio | Asume 2 mensajes por turno; puede partir un par |
| Resumen continuo | Acotado, no fijo | Todos los hechos, con pérdida | Una llamada extra al LLM por desbordamiento, y los resúmenes acumulan deriva |
Fíjate también: store: Dict[str, ...] = {} nunca expulsa nada. En un servidor eso es una fuga de memoria por sesión sin límite, y además es por proceso, así que se rompe en cuanto ejecutas más de una réplica. Respáldalo con Redis o SQL — SQLChatMessageHistory(session_id=..., connection=f"sqlite:///{db_path}") es la variante persistente del propio fichero.
Los costes reales de la búsqueda vectorial
El capítulo 16 cambia de tema, de los tokens a la infraestructura, y empieza con el punto metodológico correcto, presentado como una fanfarronada:
«Voy a enseñaros algo que los proveedores no quieren que veáis — las facturas reales.» 03:23:37
Lo que hay debajo del marketing es real: el precio desde de un proveedor describe un índice vacío y sin tráfico. Un precio sin carga de trabajo no es un precio. La promesa del capítulo tiene dos partes a propósito 03:23:47 — cuánto cuesta la búsqueda vectorial a distintas escalas y cómo reducir ese coste sin sacrificar calidad. Cuatro de las cinco palancas de abajo respetan la segunda cláusula, porque intercambian bytes y viajes de ida y vuelta, no recall. La quinta (quantization) se afirma que no tiene coste de calidad y nunca se mide; se señala donde aparece.
Paso 1 — nombra la carga de trabajo
Toda la primera mitad del capítulo está anclada a un único escenario 03:24:02:
500K documentos/vectores, volumen moderado de queries = 10,000 queries/día. (título de la diapositiva, 03:24:22)
Cada cifra en dólares de abajo significa «con esa carga de trabajo» y no significa nada en ningún otro sitio.
Paso 2 — pon precio a cada opción frente a ella, con su atributo no económico al lado
Pon precio a cada candidato frente a la misma carga de trabajo. La forma más habitual de equivocarse no es hacer mal las cuentas, es comparar el plan de entrada de un proveedor con el plan de producción de otro — una fila de plan gratuito y una fila de capacidad reservada no pertenecen a la misma columna.
| Opción | Coste/mes con 500K + 10K queries/día | Qué incluye |
|---|---|---|
| Pinecone Serverless | $20–30 | Cero ops |
| Pinecone Pods | $70–140 | Latencia garantizada |
| pgvector (RDS) | $32 | Pocas ops |
| pgvector (self-hosted) | $15–20 | Ops moderadas |
La diapositiva nunca da un número a secas — cada fila empareja dólares con un atributo no económico, y ese emparejamiento es la verdadera lección. Tres de los cuatro atributos son carga de ops, que es una segunda moneda denominada en tu tiempo; el cuarto es una garantía de latencia, que es una tercera. Todo el abanico va de $15 a $140/mes, dibujado en un gráfico de barras cuyas marcas etiquetadas se detienen en $125. La conclusión de la propia diapositiva: «A esta escala, las diferencias son pequeñas. ¡Pinecone serverless es competitivo!» 03:24:34
La fila de Pinecone Pods es la rara del grupo y merece un momento. Cuesta 2–5× lo que Serverless y lo único que compra ese sobreprecio es latencia garantizada 03:24:14 — capacidad reservada, de modo que la latencia de cola pasa a ser contractual en lugar de una esperanza. Estás pagando capacidad ociosa. Es una compra del presupuesto de latencia que llega en la factura del presupuesto de dinero, y es el ejemplo más claro del curso de dos presupuestos negociando entre sí.
Paso 3 — vuelve a calcular el precio a 10× y a 100×, y mira la forma
Este es el visual central del capítulo, «COSTS AT SCALE: The Divergence» (costes a escala: la divergencia) — tres proveedores, tres puntos de escala y tres curvas que se abren en abanico.
| Escala | Pinecone | pgvector (managed) | pgvector (self-hosted) | Pinecone ÷ self-hosted |
|---|---|---|---|---|
| 500K | $30 | $35 | $20 | 1.5× |
| 5M | $400 | $100 | $75 | 5.3× |
| 50M | $1,500+ | $400 | $300 | 5×+ y subiendo |
Cuatro cosas que sacar de esa tabla.
El ranking se invierte. Con 500K, pgvector managed ($35) es más caro que Pinecone ($30) 03:24:59. La sabiduría popular de que lo autogestionado siempre sale más barato es directamente falsa en la parte baja de la curva. No des por hecho que los órdenes son monótonos.
De 500K a 5M es molesto; de 5M a 50M es estructural. El instructor dice que la diferencia a 5M es «considerable, pero no una locura» 03:25:52 — $75 frente a $400 es 5×, pero solo ~$325/mes en términos absolutos, menos que un día de ingeniero de trabajo de ops. A 50M la diferencia es de ~$1,200/mes, es decir, ~$14,400/año 03:26:20. El pie de la diapositiva: «A gran escala, el self-hosting ahorra MILES al mes.»
Las curvas siguen divergiendo más allá del gráfico. La línea de Pinecone es visiblemente superlineal; la de pgvector se acerca más a la lineal. La extrapolación explícita llega a 100 millones de vectores, donde la diferencia sigue creciendo 03:26:46. La brecha que ves a 50M es un suelo, no un techo.
De ahí la trampa. La historia del fallo se cuenta como un monólogo interior:
«Voy a usar Pinecone porque son solo $30 al mes. Es managed. Listo.» 03:27:06
…y luego llegas a 50M vectores, la factura es 50× mayor y migrar un índice de ese tamaño es un proyecto, no una tarde. Elegir proveedor es una decisión de coste de migración, no de precio 03:27:00.
Cinco palancas, ordenadas por ahorro por unidad de esfuerzo
Elijas el despliegue que elijas, se aplican las mismas cinco optimizaciones 03:27:45. Lo que hace que valga la pena memorizar esta diapositiva no es la lista — es que cada entrada lleva dos valoraciones, ahorro y esfuerzo, para que puedas priorizar por cociente y no por magnitud.
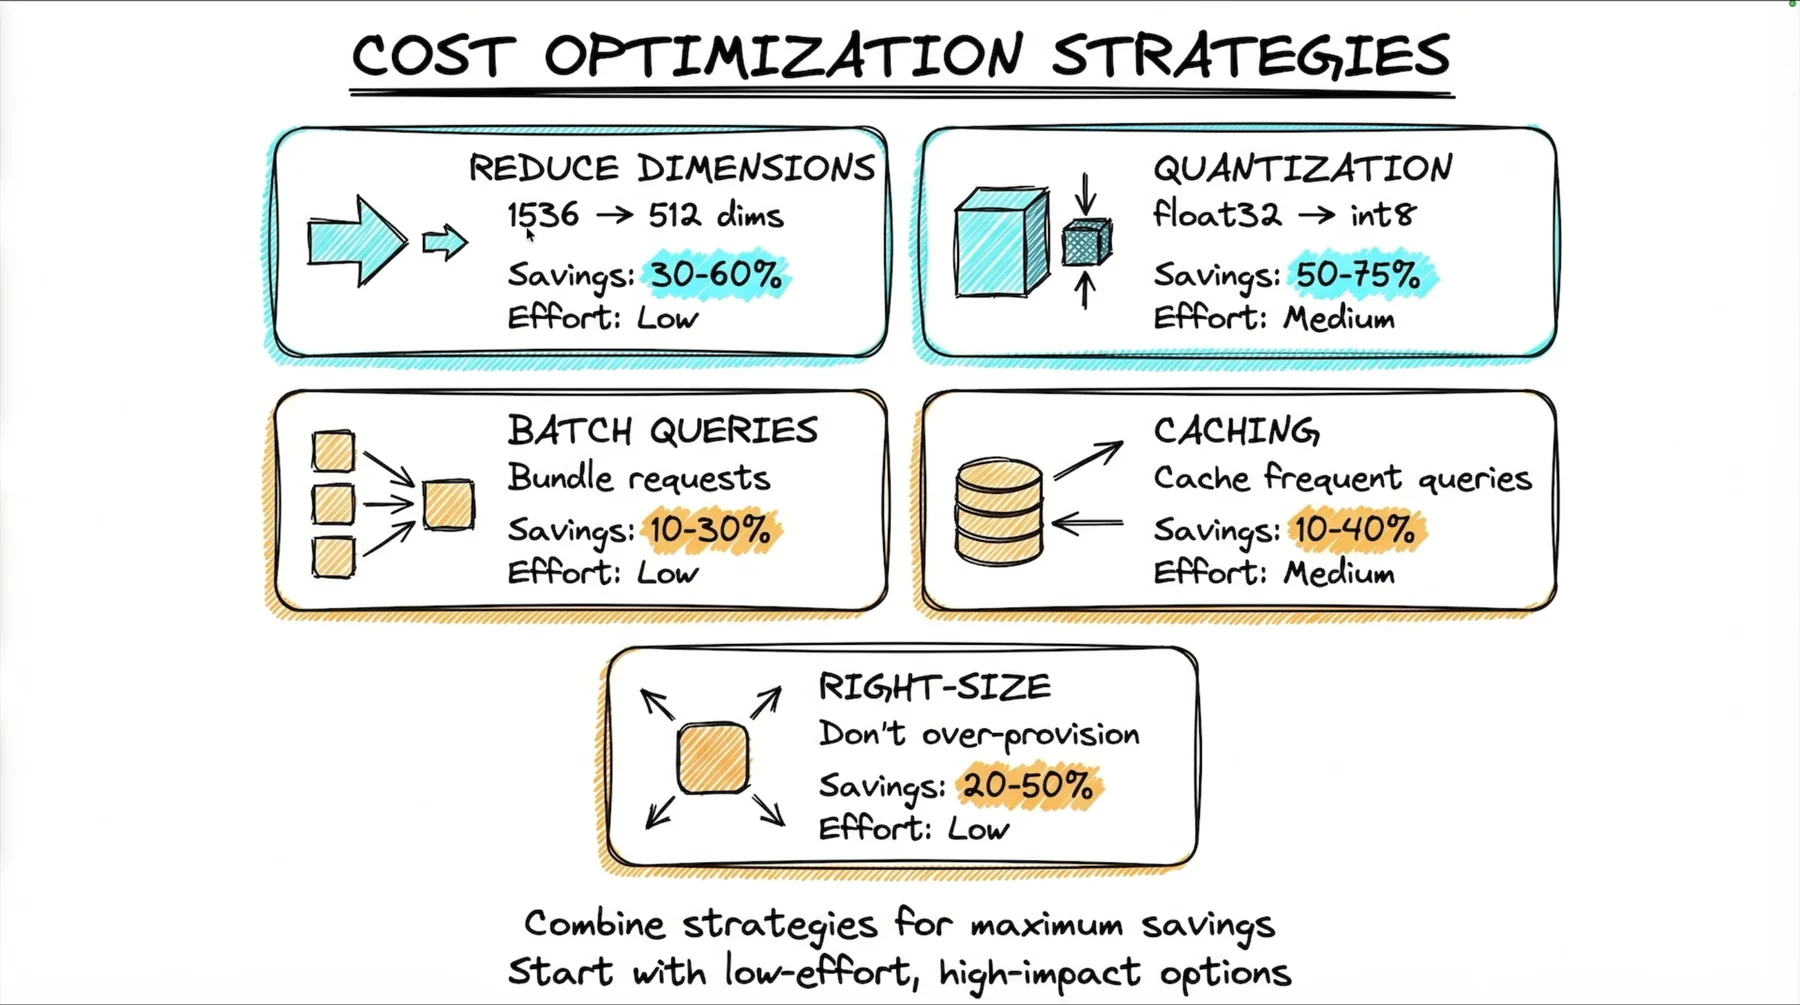
| # | Estrategia | Ahorro | Esfuerzo | Veredicto por cociente |
|---|---|---|---|---|
| 1 | Reducir dimensiones (1536 → 512) | 30–60% | Bajo | Hazlo primero |
| 5 | Dimensionar bien (no sobreaprovisionar) | 20–50% | Bajo | Hazlo en segundo lugar, siempre |
| 3 | Queries en batch (agrupar requests) | 10–30% | Bajo | Hazlo en tercer lugar |
| 2 | Quantization (float32 → int8) | 50–75% | Medio | El mayor ahorro, trabajo real |
| 4 | Caching (cachear queries frecuentes) | 10–40% | Medio | Depende por completo de tu tasa de repetición |
La instrucción de la diapositiva: «Combina estrategias para el máximo ahorro. Empieza por las opciones de poco esfuerzo y mucho impacto.»
Palanca 1 — reducir dimensiones (1536 → 512)
El almacenamiento, el tamaño del índice, la huella en RAM y el cálculo de distancias por query escalan linealmente con el número de floats por vector. La mayoría de los equipos se queda en las 1536 dimensiones por defecto de OpenAI y nunca toca el ajuste. Bajar a 512 es una reducción de 3× en el tamaño del vector a cambio de un 30–60% de ahorro con esfuerzo bajo — el mejor cociente del tablero.
«Así que esto es algo de lo que la gente no habla.» 03:28:12
Con el SDK de OpenAI a pelo es un solo argumento con nombre:
# Slide only, [03:28:35] — this exact snippet is NOT in either course repo.
response = client.embeddings.create(
    model='text-embedding-3-small',
    input='Your text',
    dimensions=512  # Reduced from 1536
)
Y es persistente: todo lo que produce ese modelo instanciado sale a partir de entonces con 512 dimensiones 03:28:38. El equivalente en LangChain es un argumento del constructor — OpenAIEmbeddings(model="text-embedding-3-small", dimensions=512) — y solo lo respetan text-embedding-3 y modelos posteriores, así que text-embedding-ada-002 no se puede reducir de esta manera. La línea 8 de embeddings_deep.py del repo es la foto del «antes»: OpenAIEmbeddings(model="text-embedding-3-small") sin argumento dimensions, es decir, el valor por defecto de 1536-d.
Sé preciso sobre qué medidor mueve esto. Las APIs de embeddings facturan por tokens de entrada, no por floats de salida, así que pedir 512 dimensiones en lugar de 1536 no abarata la llamada de embedding ni un céntimo. Lo que reduce es la fila de almacenamiento, la huella en RAM del índice y el cálculo de distancias por query — las filas 2 y 3 de la tabla del principio de esta parte. Por eso la franja de ahorro se refiere al coste de infraestructura y por eso la palanca rinde más cuanto mayor es tu corpus.
La mitad del compromiso relativa al coste es lo que te da el capítulo 16. La mitad relativa a la calidad quedó establecida en la Parte 4: menos dimensiones significa menos matiz semántico, y el punto óptimo para la mayoría de casos de uso está en 768–1536. 512 queda por debajo de esa franja. El capítulo 16 afirma el ahorro y nunca mide la diferencia de recall, así que trata «reducir a 512» como una hipótesis que hay que someter a un test A/B en tu propio corpus con tu propio test de retrieval (la metodología de la Parte 3: mide el retrieval de extremo a extremo, nunca mires los vectores a ojo).
Palanca 2 — quantization (float32 → int8)
Donde la reducción de dimensiones recorta el número de dimensiones, la quantization recorta los bytes por dimensión 03:28:47. De float32 a int8 se pasa de 4 bytes a 1 byte, una reducción de 4×; la quantization binaria va más allá. Valoración: 50–75% de ahorro, esfuerzo medio.
Las dos palancas son ortogonales y se combinan: 1536→512 es 3×, float32→int8 es 4×, y apiladas dan vectores aproximadamente 12× más pequeños. (El instructor nunca hace esa multiplicación; la frase «combina estrategias» de la diapositiva es la misma afirmación en prosa. La aritmética es de esta guía, y es una cota superior de almacenamiento, no una promesa sobre el recall.)
Palanca 3 — queries en batch
El antipatrón es el hábito de programación por defecto — un bucle for sobre las queries —, y eso es lo que lo hace peligroso:
«si tienes 10,000 llamadas a la API haciendo esto, es una locura. Es muchísimo.» 03:29:42
# Slide only, [03:29:52] — generic vector-DB SDK, illustrative.
# Bad: 10,000 API calls
for query in queries:
    results = index.query(query)

# Good: Batched queries (if supported)
results = index.query(queries, batch=True)
El bucle for no es una lógica errónea, es una economía errónea con precios por request. El mecanismo se enuncia exactamente una vez y es todo el modelo:
«menos viajes de ida y vuelta, lo que significa costes más bajos con precios por uso. Esa es la clave.» 03:29:59
Un 10–30% de ahorro, y el esfuerzo se describe como «extremadamente bajo» 03:29:14.
Y no confundas esto con el .batch() de LangChain. Todo Runnable — retrievers incluidos — expone .batch([...]), y su implementación por defecto ejecuta invoke una vez por entrada en un pool de hilos: N llamadas concurrentes, no una sola llamada. Su propio docstring lo dice, y añade que las subclases «deben sobrescribir este método si pueden hacer batching de forma más eficiente». Así que .batch() reduce la latencia de reloj y no le quita nada a una factura por uso, salvo que la integración concreta lo haya sobrescrito. El batching en el servidor es una propiedad de la API del proveedor, no de la capa de orquestación — compruébalo componente a componente, nunca lo des por hecho.
Eso sí, probablemente ya estás haciendo batching en el lado del índice sin darte cuenta. embeddings_model.embed_documents([...]) recibe una lista y la empaqueta en requests de hasta chunk_size elementos cada una (el valor por defecto de LangChain para OpenAIEmbeddings es 1000) — eso sí es un batch real en el servidor, y es la razón de que la ingesta masiva sea barata. embed_query(text) recibe una sola cadena y es lo que pagas como una request en cada pregunta. La asimetría es estructural: el camino del índice admite batching por construcción y el de la query no, porque la query no existe hasta que el usuario la escribe. Donde sí puedes hacer batching de verdad en el camino de lectura es en el trabajo offline — ejecuciones de evaluación, re-scoring nocturno, backfills.
Palanca 4 — caching, cuantificado en una frase
«si el 20% de las queries son repetidas, ahorras un 20% de cómputo» 03:30:13
El porcentaje de ahorro es la tasa de repetición. Ese es todo el modelo económico, y significa que la decisión de construir una cache es empírica: mide primero tu tasa de repetición. Rango de la diapositiva: 10–40% de ahorro, esfuerzo medio.
El escenario canónico es un bot de soporte 03:30:20 — el tráfico de soporte y de FAQ tiene una cabeza pesada en la que un puñado de preguntas domina el volumen, que es justo la distribución que premia una cache LRU. Una herramienta de investigación sobre un corpus de documentos únicos tiene la distribución opuesta, y ahí una cache es peso muerto.
Se pueden cachear dos cosas, en dos capas distintas 03:30:32:
- el resultado del retrieval — te ahorras consultar la base de datos vectorial
- la respuesta — te ahorras también la llamada al LLM
El caching tiene su propia sección completa más abajo, porque el capítulo 18 construye bien las dos capas.
Palanca 5 — dimensionar bien, la que nadie hace
Un 20–50% de ahorro con esfuerzo bajo — y es la estrategia que la gente se salta, porque nunca termina. El bucle 03:31:24:
- Empieza con una instancia pequeña.
- Monitoriza el uso.
- Escala solo cuando llegues a límites reales — no por proyecciones.
- Revisa los costes cada mes.
- Repite para siempre.
«Esta es la cuestión, ¿vale? Es un proceso.» 03:31:39
Un dimensionamiento hecho una sola vez se queda desfasado en cuanto cambia la forma de tu tráfico 03:31:53. Esta es la palanca que más depende directamente de la Parte 7: sin métricas de uso, el paso 2 es adivinar y el paso 3 es superstición.
Caching bien hecho: tres capas, tres implementaciones
El capítulo 18 cambia de tema en 03:54:27, de Supabase (Parte 10) al caching, y construye dos de las tres capas con código real. Junto con la cache de retrieval del capítulo 16, tienes el stack completo.
| Capa | Qué se ahorra | Clave | Tasa de aciertos típica | Dónde se enseña |
|---|---|---|---|---|
| Cache de embeddings | la llamada a la API de embeddings | texto del chunk (hasheado) | ~100% en una reingesta sin cambios | cap. 18 03:54:27 |
| Cache de retrieval | la búsqueda vectorial | query (MD5) | = tasa de repetición | cap. 16 03:30:32 |
| Cache de respuestas | toda la llamada al LLM | query normalizada (MD5) | 30–50% | cap. 18 03:58:32 |
Se combinan. Una respuesta cacheada cortocircuita todo lo que hay detrás; un retrieval cacheado sigue pagando la generación; un embedding cacheado solo ahorra la llamada de embedding. Ordena las comprobaciones de fuera hacia dentro.
Capa 1 — la cache de embeddings
«El caching es muy importante, sobre todo con los embeddings, porque evita llamadas redundantes a la API.» 03:54:27
La lógica es irrebatible: el embedding es una llamada de inferencia, se factura por tokens (Parte 4) y un texto idéntico siempre produce un vector idéntico. Embeber el mismo texto dos veces es puro desperdicio. Compensa siempre que el mismo texto de chunk pase dos veces por el embedder: al relanzar una ingesta que se cayó a medias, al reconstruir un índice en un store nuevo, al reingerir un corpus en el que solo han cambiado unos pocos documentos, o con la costumbre de la demo-en-bucle de la Parte 4, en la que cada ejecución vuelve a hacer re-embed de todo.
Conoce su límite, eso sí, porque es fácil sobrestimarlo. La clave se deriva del texto, así que cambiar tu chunker invalida toda la cache — fronteras distintas significan cadenas distintas, que significan claves distintas. La reindexación que más querrías que saliera gratis es justo la que no lo es.
La respuesta de LangChain es un decorador alrededor de cualquier modelo de embeddings, respaldado por cualquier byte store:
# production-course-main-code/embeddings_deep.py — lines 69-97
def embedding_caching():
    from langchain_classic.embeddings.cache import CacheBackedEmbeddings

    from langchain_classic.storage import LocalFileStore
    import tempfile

    with tempfile.TemporaryDirectory() as tempdir:
        store = LocalFileStore(root_path=tempdir)

        cached_embeddings = CacheBackedEmbeddings.from_bytes_store(
            underlying_embeddings=embeddings_model,
            document_embedding_cache=store,
            namespace="exercise",
        )

        text = "What is Reinforcement Learning?"

        # First call - hits API
        print("First call (API):")
        vectors1 = cached_embeddings.embed_documents([text])
        print(f"  Embedded {len(vectors1)} documents")

        # Second call - from cache
        print("\nSecond call (Cache):")
        vectors2 = cached_embeddings.embed_documents([text])
        print(f"  Embedded {len(vectors2)} documents")

        # Verify same results
        print(f"\nSame vectors: {np.allclose(vectors1[0], vectors2[0])}")
Ejecútalo con uv run embeddings_deep.py y la última línea imprime Same vectors: True 03:58:32. Fíjate en el método de verificación: compara los vectores, no los tiempos. Los tiempos son ruidosos y dependen de la máquina; la igualdad de vectores es una prueba. Fíjate también en lo que la demo no demuestra — las dos llamadas informan Embedded 1 documents, así que los recuentos impresos son idénticos tanto si la cache ha saltado como si no. Solo np.allclose te dice algo.
La interfaz del store es mínima a propósito — según el docstring que aparece en pantalla, «funciona con cualquier store que implemente la interfaz abstracta de store y acepte claves de tipo str y valores de lista de floats» 03:58:20. LocalFileStore es una implementación de ese ByteStore; un store respaldado por Redis, S3 o una base de datos encaja sin cambios, y eso es lo que permite compartir este patrón entre workers.
namespace no es decoración. 03:56:30 La clave de la cache se deriva del texto, no del modelo. Cachea vectores de text-embedding-3-small y de text-embedding-3-large para la misma cadena sin namespace y acabarás sirviendo un vector de 3072-d a un índice de 1536-d — el invariante 2 violado en silencio, por tu propia cache. El propio docstring de LangChain dice que lo pongas con el nombre del embedding model utilizado; como las dimensiones forman parte de la identidad del modelo, separa el namespace por modelo y por dimensions. El namespace="exercise" de la demo es un nombre didáctico, no un patrón que copiar.
Un valor por defecto más que conviene conocer antes de contar tus ahorros: from_bytes_store recibe query_embedding_cache, y vale False. Tal cual viene, esto solo cachea los embeddings de documentos — la llamada embed_query de cada request, la de tu camino caliente, no se cachea en absoluto. Pasa query_embedding_cache=True para reutilizar el mismo store con las queries, que es lo que de verdad compensa cuando la misma pregunta llega dos veces.
Vale la pena leer el aviso de SHA-1 en lugar de descartarlo. Lo lanza _warn_about_sha1_encoder() y se notifica en su punto de llamada, langchain_classic/embeddings/cache.py:58. Dice, en esencia: SHA-1 no es resistente a colisiones, un atacante motivado puede fabricar dos payloads distintos que se correspondan con la misma clave de cache, proporciona un codificador más fuerte mediante el argumento key_encoder — y si cambias el codificador, crea una cache nueva para evitar colisiones con las claves existentes. key_encoder acepta un callable o uno de los literales "sha1", "blake2b", "sha256", "sha512".
El consejo del instructor es:
«Te va a salir ese aviso, pero puedes ignorar todo eso.» 03:58:32
Eso vale para una demo local de un solo usuario y es un error en una cache compartida o multi-tenant, donde una colisión fabricada significa que a un tenant se le sirve el vector de otro. Pasa key_encoder="sha256" y sigue adelante; no cuesta nada.
Capa 2 — la cache de retrieval
El capítulo 16 la muestra en una diapositiva, se equivoca, se da cuenta en directo y lo corrige — lo que la convierte en mejor material didáctico de lo que habría sido una versión limpia.
«Veo que aquí tengo un pequeño bug.» 03:31:11
# Slide v1, [03:31:20] — BROKEN, shown here as the trap.
import hashlib
from functools import lru_cache

@lru_cache(maxsize=1000)
def cached_search(query_hash):          # `query` is not in scope
    return vectorstore.similarity_search(query)

def search(query):
    query_hash = hashlib.md5(query.encode()).hexdigest()
    return cached_search(query_hash)
# Slide v2, [03:31:24] — the corrected version.
import hashlib
from functools import lru_cache

@lru_cache(maxsize=1000)
def cached_search(query_hash, query):
    return vectorstore.similarity_search(query)

def search(query):
    query_hash = hashlib.md5(query.encode()).hexdigest()
    return cached_search(query_hash, query)
El cuerpo de la v1 hace referencia a query, que nunca es un parámetro. En el mejor de los casos es un NameError; en el peor, captura en silencio una query de nivel de módulo y devuelve resultados para la pregunta equivocada — una cache que responde con seguridad y de forma incorrecta, que es el peor fallo posible en un sistema RAG.
Dos cosas que la versión corregida te da gratis. functools.lru_cache(maxsize=1000) ofrece expulsión acotada por uso menos reciente sin ninguna infraestructura — sin Redis, sin servicio, seis líneas 03:31:20. Y MD5 se usa únicamente como huella de contenido de longitud fija 03:31:02, lo que mantiene la clave uniforme sea cual sea la longitud de la query. Aquí no es una primitiva de seguridad y nunca debe reutilizarse como tal.
Capa 3 — la cache de respuestas
La tesis cabe en una frase 03:58:32:
«No pagues dos veces por la misma respuesta.»
Dos pasos por consulta — normalizar y luego hashear. (El instructor lo llama una «cache de dos capas». Se refiere a los dos pasos de arriba, no a dos de las tres capas de cache de la tabla. Misma palabra, otro eje; que no te confunda.)
# production-course-main-code/cost_optimization.py — lines 101-133
class SemanticCache:
    """Cache responses with semantic similarity matching."""

    def __init__(self, similarity_threshold: float = 0.9):
        self.cache = {}
        self.threshold = similarity_threshold
        self.embedder = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    def _hash_query(self, query: str) -> str:
        """Create hash of normalized query."""
        normalized = query.lower().strip()
        return hashlib.md5(normalized.encode()).hexdigest()

    def get(self, query: str) -> Optional[str]:
        """Get cached response if similar query exists."""
        query_hash = self._hash_query(query)

        # Exact match
        if query_hash in self.cache:
            return self.cache[query_hash]["response"]

        # Could add embedding-based similarity here
        # For demo, just use exact match

        return None

    def set(self, query: str, response: str):
        """Cache a response."""
        query_hash = self._hash_query(query)
        self.cache[query_hash] = {"query": query, "response": response}

    def stats(self) -> dict:
        return {"cached_queries": len(self.cache)}
El paso 1 es query.lower().strip() 03:58:32 — victorias baratas, porque los usuarios escriben la misma pregunta con mayúsculas distintas y espacios sueltos. El paso 2 es MD5 a un digest hexadecimal de longitud fija 03:59:33, «muy rápido también».
El wrapper añade los contadores y el tracing:
# production-course-main-code/cost_optimization.py — lines 145-174
    @traceable(name="cached_invoke")
    def invoke(self, query: str) -> tuple[str, bool]:
        """
        Invoke with caching.
        Returns: (response, from_cache)
        """
        # Check cache
        cached = self.cache.get(query)
        if cached:
            self.cache_hits += 1
            return cached, True

        # Call LLM
        self.cache_misses += 1
        response = self.llm.invoke(query)
        result = response.content

        # Cache result
        self.cache.set(query, result)

        return result, False

    def get_stats(self) -> dict:
        total = self.cache_hits + self.cache_misses
        hit_rate = self.cache_hits / total if total > 0 else 0
        return {
            "hits": self.cache_hits,
            "misses": self.cache_misses,
            "hit_rate": f"{hit_rate:.1%}",
        }
Tres detalles de diseño que vale la pena robar. invoke devuelve una tupla (result, from_cache: bool) 04:00:34 para que quien llama sepa de dónde viene la respuesta — que es lo que hace que la demo imprima [CACHE] frente a [LLM], y lo que permite a una API real añadir una cabecera X-Cache: HIT o una métrica cache_hit=True. El camino cacheado sigue teniendo tracing (@traceable(name="cached_invoke")) 04:00:34 — caching y observabilidad no son alternativas; quieres los aciertos en tus traces precisamente para poder calcular la tasa de aciertos a partir de la misma fuente de verdad que todo lo demás. Y en un acierto la respuesta vuelve «al instante. Así que es gratis. Prácticamente no hay latencia.» 04:01:37 — es una optimización de latencia disfrazada de optimización de coste.
La demo y la cifra que produce
# production-course-main-code/cost_optimization.py — lines 177-197
def demo_caching():
    """Demonstrate caching."""

    llm = CachedLLM()

    queries = [
        "What is Python?",
        "What is JavaScript?",
        "What is Python?",  # Cache hit
        "What is python?",  # Cache hit (normalized)
        "What is Rust?",
    ]

    print("\nCaching Demo:\n")

    for query in queries:
        result, from_cache = llm.invoke(query)
        source = "CACHE" if from_cache else "LLM"
        print(f"[{source}] {query} -> {result[:30]}...")

    print(f"\nStats: {llm.get_stats()}")
Cinco queries, y la cuarta es la interesante: "What is python?" acierta solo gracias al .lower() de _hash_query. El resultado impreso 04:03:00:
Stats: {'hits': 2, 'misses': 3, 'hit_rate': '40.0%'}«Una tasa de aciertos del 40% significa que se eliminó el 40% de tus llamadas al LLM. Dos de nuestras cinco queries costaron cero.» 04:02:40
⚠️ Para reproducirlo tienes que editar el fichero. El bloque __main__ publicado tiene demo_caching() comentado y ejecuta demo_token_budgeting() en su lugar. Descoméntalo y luego uv run cost_optimization.py — el comando que se usa en pantalla.
Nota de procedencia. En pantalla, en el momento de la grabación, el fichero terminaba justo después de demo_caching() — el comentario «Production version would…» estaba en las líneas 205–208, no en las 294–297. Toda la sección # === Token Budgeting === (TokenBudget, BudgetedLLM, demo_token_budgeting) se añadió al repo después de grabar este capítulo, y por eso las dos mitades de esta parte vienen de capítulos separados por hora y media y, sin embargo, viven en un mismo fichero. ModelRouter ya estaba y simplemente no se comentó. La demo de caching también se grabó en un workspace distinto (langc-course, Python 3.12.2) del de la mitad de Supabase del mismo capítulo.
Espera tasas de aciertos del 30–50% en producción 04:02:40, porque el tráfico real es repetitivo — los ejemplos del instructor son «¿Cómo restablezco mi contraseña?» y «¿Cuál es vuestro horario?». Eso ahorra dinero y latencia: «los usuarios reciben la respuesta al momento.»
Lo que esta cache no es
La clase se llama SemanticCache y no es semántica. Lo dice el propio instructor 04:02:40: tras la normalización sigue siendo una comparación de igualdad de cadenas. «What is Python» y «Tell me about Python» significan lo mismo y dan hashes distintos, así que fallan.
El fichero arrastra otros cuatro artefactos que confundirán a cualquiera que lo amplíe:
self.embedder = ChatOpenAI(model="gpt-4o-mini", temperature=0)— un modelo de chat asignado a
una variable llamada embedder, y que nunca se usa. Una implementación real necesita OpenAIEmbeddings. Es la línea más engañosa de todo el capítulo.
similarity_threshold(por defecto0.9) se guarda y nunca se lee. Ningún camino de código consume
self.threshold 03:59:33.
if cached:confunde «ausente» con «vacío».SemanticCache.get()devuelveNoneen un fallo,
pero el wrapper comprueba la veracidad, así que una respuesta cacheada que sea una cadena vacía se trata como un fallo y se vuelve a facturar en cada request para siempre. Comprueba is not None.
self.cache = {}no tiene límite y es por proceso. Nunca expulsa nada (un servidor de larga duración pierde memoria),
y detrás de N workers tu tasa de aciertos efectiva se divide entre N. El lru_cache(maxsize=1000) de la capa 2 resuelve el primer problema; solo un almacenamiento compartido resuelve el segundo — o tu propio Redis, o el hook de cache global de LangChain, langchain_core.globals.set_llm_cache(...), apuntado a un backend compartido.
La defensa del instructor es que el nombre es aspiracional a propósito:
«Está pensada para ampliarse con embeddings. Así que la versión de coincidencia exacta es el punto de partida.» 04:03:41
El salto a una cache semántica de verdad
La receta es un comentario al final del fichero, y es lo último que dice el capítulo 18 antes de quedarse sin cinta:
# production-course-main-code/cost_optimization.py — lines 294-297
    # Production version would:
# 1. Embed the query into a vector
# 2. Search the cache by vector similarity
# 3. Return if similarity > threshold (e.g., 0.95)
Tres pasos, y ya sabes construirlos todos con lo visto en las Partes 4 a 6: haz el embedding de la query, busca en un vector store pequeño de preguntas cacheadas y devuelve la respuesta guardada si la similitud más alta supera el umbral.
Mide antes de construir
monitoring.py ya te da el instrumento:
# production-course-main-code/monitoring.py — lines 106-111
        cache_hit_rate = (
            self.metrics["cache_hits"]
            / (self.metrics["cache_hits"] + self.metrics["cache_misses"])
            if (self.metrics["cache_hits"] + self.metrics["cache_misses"]) > 0
            else 0
        )
MetricsCollector.get_summary() lo integra en una cadena cache_hit_rate junto a la tasa de errores y la latencia media, así que la cifra aparece en el mismo resumen que todo lo demás.
Ejecuta primero una cache que no hace nada — hashea cada query, registra acierto o fallo y llama siempre al LLM. Al cabo de una semana conoces tu tasa de repetición real y, por tanto, según el modelo del capítulo 16, conoces tu ahorro exacto antes de haber escrito una sola línea de lógica de caching. El mismo instrumento responde a la pregunta del dimensionamiento de la sección siguiente; no es casualidad, es la razón de que la Parte 7 venga antes que esta.
Qué base de datos vectorial, según la escala del corpus
El capítulo 16 acaba en una tabla de consulta indexada por un solo número: cuántos vectores tienes.
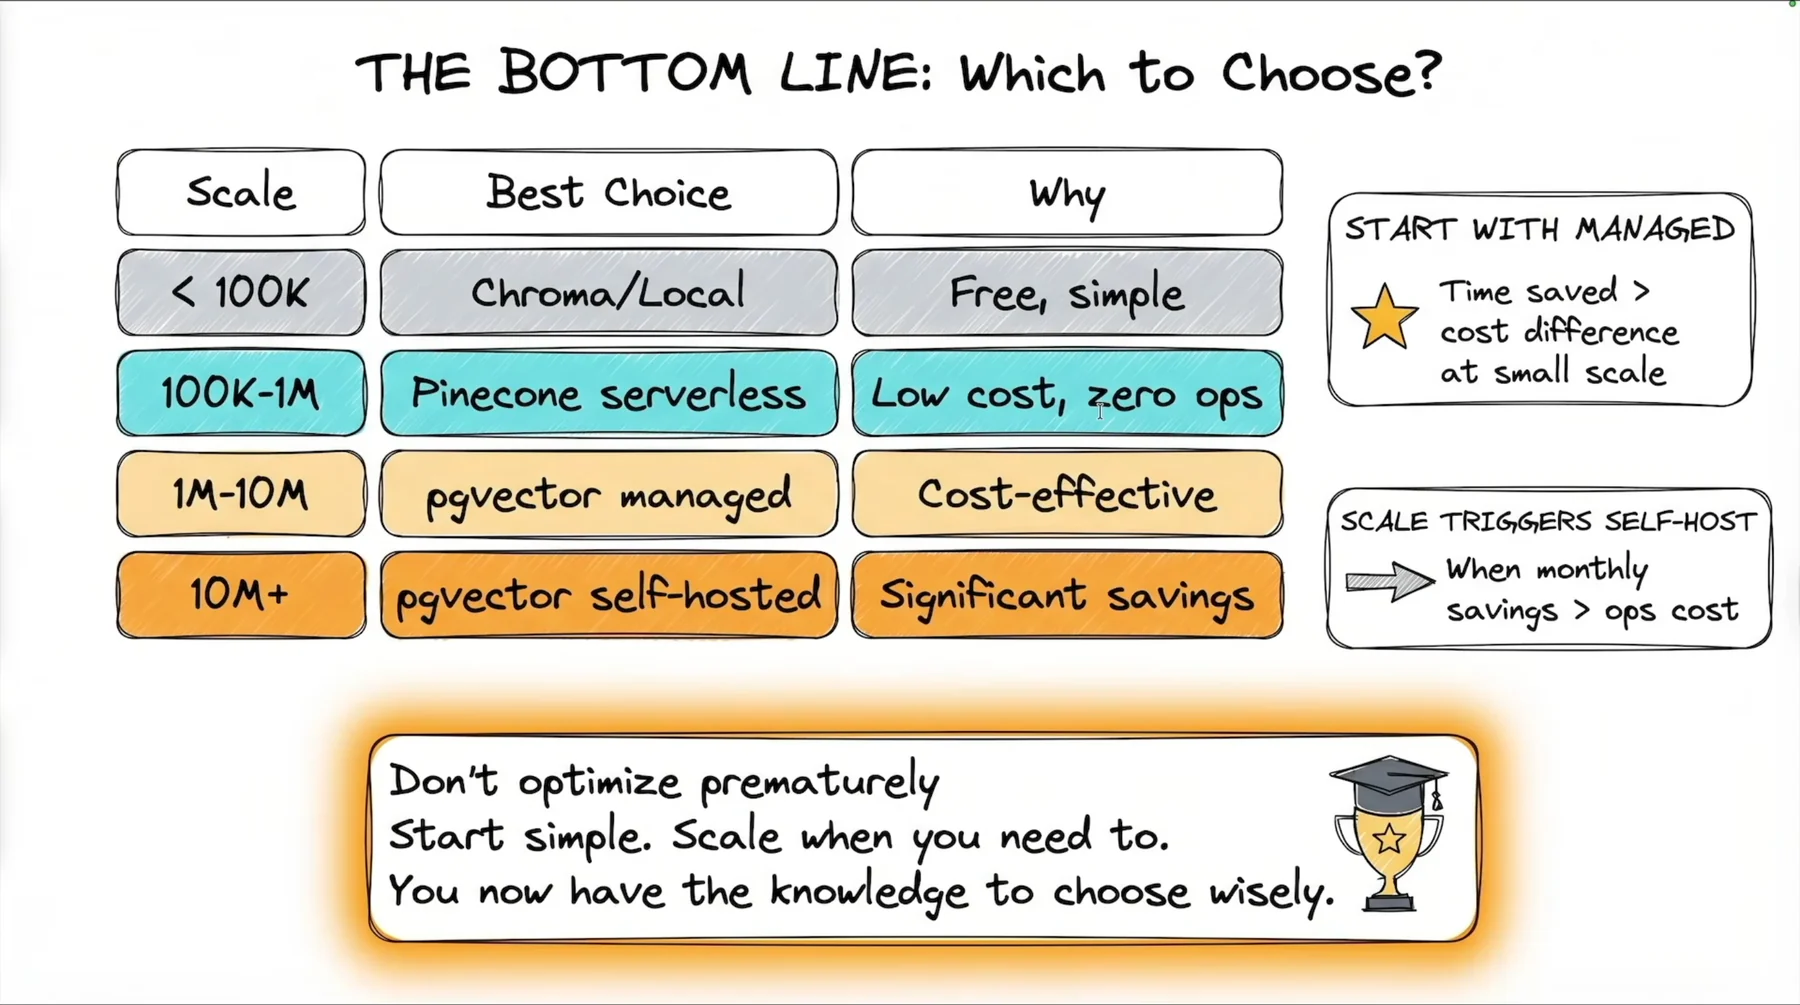
| Escala | Mejor opción | Por qué |
|---|---|---|
| < 100K | Chroma / local | Gratis, sencillo — y, como mostró la Parte 4, rápido 03:32:10 |
| 100K – 1M | Pinecone serverless | Coste bajo, cero ops |
| 1M – 10M | pgvector managed | Buena relación coste-eficacia |
| 10M+ | pgvector self-hosted | Ahorro significativo |
Y las dos reglas laterales que de verdad gobiernan la decisión:
- START WITH MANAGED (empieza con managed) — «A pequeña escala, el tiempo ahorrado > la diferencia de coste.» 03:32:40 En la
parte baja de la curva, la diferencia en dólares es menor que el valor de las horas de ingeniería que quemarías manteniendo tu propio Postgres.
- SCALE TRIGGERS SELF-HOST (la escala dispara el self-hosting) — «Cuando el ahorro mensual > el coste de ops.» Este recuadro aparece
solo en la diapositiva; el instructor nunca lo lee en voz alta, lo que hace que sea fácil pasarlo por alto, y es la frase más importante de la página.
La instrucción final es la que más dinero ahorra en la práctica:
«No optimices antes de tiempo. Empieza simple. Escala cuando lo necesites.» (diapositiva, 03:32:05)
La versión hablada añade la recompensa, y es la lectura correcta de toda esta parte: aprender a hacer self-hosting no sirve para hacerlo ahora — sirve para que «cuando llegues a la escala, donde los costes importan, tengas los conocimientos de este curso para hacer self-hosting con eficacia» 03:32:58. El capítulo se despide como final del arco que lleva la base de datos vectorial a producción 03:33:08.
Dos referencias cruzadas para que puedas actuar sobre esta tabla. El ajuste del índice que decide si necesitas siquiera el siguiente nivel — M y ef de HNSW, escalado vertical frente a horizontal — está en la Parte 8. Los SKUs concretos de hosting que hay detrás de la fila «pgvector managed» — Supabase, Neon, AWS RDS, con precios mensuales reales — están en la Parte 10.
El presupuesto de latencia
El dinero se lleva un capítulo entero; la latencia, frases sueltas. Júntalas tú, porque tus usuarios notan la latencia y el coste solo lo nota tu director financiero.
En los tres capítulos que hay detrás de esta parte, la fuente da exactamente una cifra de latencia concreta: la búsqueda híbrida añade ~20–50 ms, porque estás ejecutando literalmente dos retrievals en lugar de uno 02:12:09. Todo lo demás es cualitativo, así que la tabla de abajo mezcla cifras con fuente y derivaciones marcadas explícitamente. No trates ninguna fila sin marcar como medida — mídela tú:
| Etapa | Aportación a la latencia | Fuente |
|---|---|---|
| Barrera del presupuesto de tokens | ~0 (un .split() y una comparación) | derivado |
| Acierto en la cache de respuestas | ~0 — «es gratis. Prácticamente no hay latencia» | 04:01:37 |
| Embedding de la query | un viaje de ida y vuelta a la API | no cuantificado en la fuente |
| Búsqueda vectorial | crece con el tamaño del índice y con ef | Parte 8 |
| + rama BM25 (híbrida) | +20–50 ms | 02:12:09 |
| + Reranking | una pasada del modelo sobre k candidatos | Parte 6 |
| + Clasificador de enrutamiento | un viaje de ida y vuelta completo extra al LLM | 02:20:25 |
| Generación del LLM | dominante; crece con los tokens de entrada y de salida | derivado |
De esa tabla salen tres reglas.
Ordena el pipeline de lo más barato a lo más caro. El pipeline de requests de producción de la Parte 1 — Cliente → Rate limiter → Seguridad → Cache → Modelo (+retry +fallback) → Validación de la salida → Métricas → Respuesta — es un orden de latencia y de coste tanto como de seguridad. Primero los rechazos baratos, al final la inferencia cara. Una barrera de presupuesto de tokens colocada después de la llamada de retrieval ya se ha gastado tu dinero y tus milisegundos.
Algunas optimizaciones de coste empeoran la latencia. El enrutamiento de modelos ahorra dinero y añade un viaje de ida y vuelta completo al LLM a cada request 02:20:25. La búsqueda híbrida compra precisión y gasta 20–50 ms. La memoria con resumen acota el coste en tokens y añade una llamada extra al LLM en cada desbordamiento. Aquí no hay nada gratis — es el invariante 5, cada capa es un «elige 2», expresado en milisegundos.
Algunas mejoran ambas cosas. El caching es la única victoria sin ambigüedad: un acierto cuesta cero dólares y cero milisegundos. Por eso el caching, pese a su valoración de esfuerzo medio y a su discreta franja de ahorro del 10–40%, suele ser lo primero que se construye después de dimensionar bien.
Y la fila de Pods de la tabla de precios anterior es la única partida de toda esta parte que es puramente una compra de latencia: 2–5× el precio de Serverless, sin comprar nada más que una garantía de latencia de cola 03:24:14. Si tienes un SLA de p99, ese sobreprecio no es un despilfarro; si no lo tienes, sí.
Ponerle cifra: un modelo de costes trabajado
El curso nunca multiplica entre sí sus propias constantes. Hacerlo es la forma más rápida de ver qué palanca importa. La aritmética de abajo es derivada, no citada — pero cada constante que usa es una cifra documentada, y cada una lleva su fuente.
La carga de trabajo es la base del capítulo 16 03:24:02: 500K vectores, 10,000 queries/día. La forma de la request es la que el propio curso modela en su calculadora de contexto largo frente a RAG (Parte 14): 4 chunks recuperados × 500 tokens de contexto, una query de 100 tokens y una respuesta de 500 tokens — 2,100 tokens de entrada, 500 de salida. Los precios son text-embedding-3-small a $0.02/1M tokens (Parte 4), la entrada de gpt-4o-mini a $0.15/1M ($0.00015/1K, fijado en el código de cost_optimization.py) y gpt-4o a $2.50/1M de entrada y $10.00/1M de salida (las constantes de la calculadora del curso).
En indexación, una sola vez. 500K chunks × 500 tokens = 250M tokens → $5.00 por embeber todo el corpus. Una vez. Es el invariante 3 hecho concreto: la cifra que preocupa a todo el mundo es la más barata de la página — hasta que cambias tu chunker, y entonces la vuelves a pagar.
Embedding en tiempo de query. 100 tokens × 10,000/día × 30 = 30M tokens/mes ≈ $0.60/mes. Despreciable — y precisamente por eso elegir las dimensiones es una decisión de almacenamiento y latencia, no de factura de embeddings.
Base de datos vectorial. La base del capítulo 16: 20–30 $/mes en Pinecone Serverless, 15–$20 con self-hosting.
Generación, por request, 2,100 de entrada + 500 de salida:
- Con
gpt-4o: 2,100 × $2.50/1M = $0.00525 de entrada, más 500 × $10.00/1M = $0.00500 de salida →
$0.01025 por request. Con 10,000 queries/día son $102.50/día — la cifra exacta que imprime 01_long_context_vs_rag.py en su propio bloque «at 10,000 queries/day» → ~$3,075/mes.
- Con
gpt-4o-mini: el repo solo pone precio a la entrada — 2,100 × $0.15/1M = $0.000315 por request →
~$95/mes, y eso es un mínimo. La tarifa de salida de mini no aparece en ninguna parte de la fuente.
Vuelve a leer la primera viñeta: con esta forma los tokens de salida cuestan tanto como los de entrada, aunque la entrada es cuatro veces mayor, porque la salida tiene un precio por token 4× más alto. Cualquier modelo de costes que solo ponga precio a la entrada — y el propio ModelRouter del curso hace exactamente eso — se equivoca aproximadamente en un factor de dos.
| Medidor | Mensual con 500K / 10K queries al día | Proporción |
|---|---|---|
| Embedding del corpus ($5.00 una vez, amortizado en un año) | ~$0.42 | <1% |
| Embedding de las queries | ~$0.60 | <1% |
| Base de datos vectorial (Pinecone Serverless) | $20–30 | ~24% |
Generación (gpt-4o-mini, solo entrada) | ~$95 | ~75% |
Las proporciones se calculan con los $30 del extremo superior del rango de la base de datos vectorial; con $20, la proporción de la generación sube al 82%. Con gpt-4o la comparación deja de serlo: ~$3,075 de generación frente a 20–$30 de base de datos es una factura de infraestructura del 1%.
Tres salvedades, dichas en lugar de enterradas. (1) Esto supone una llamada al LLM por query — multi-query, reranking, un clasificador de enrutamiento o un bucle de agente multiplican cada uno la fila de generación, y ninguno toca la fila de la base de datos. (2) Los precios son los del repo y las diapositivas en el momento de la grabación y cambiarán; mantén tu propia tabla de precios y versiónala. (3) La fila de la base de datos es la que se vuelve superlineal: a 50M vectores son más de $1,500/mes, mientras que la fila de generación por request no se ha movido. El orden de esta tabla depende de tu escala, así que vuelve a calcularla a 10× antes de actuar.
Ahora aplica las palancas. Una tasa de aciertos del 40% en la cache de respuestas elimina el 40% de ambas filas, la de generación y la de embedding de queries: ~$95 → ~$57 con mini, ~$3,075 → ~$1,845 con gpt-4o. Es la única palanca que toca la fila más grande. Enrutar la mitad de tu tráfico de gpt-4o a gpt-4o-mini lleva la mitad de entrada de la factura de ~$1,575 a ~$835, menos el coste por request del propio clasificador. Reducir dimensiones no toca ninguna de estas filas salvo la de 20–30 $ — y aun así vale la pena hacerlo, porque esa es la fila que se convierte en más de $1,500 a 50M vectores.
Decisiones que tomar
Avanza de arriba abajo. Cada punto es una decisión con un valor por defecto, no una tarea.
- ¿Cuál es tu carga de trabajo, en dos números? Número de vectores y queries/día. Apúntalos. Todos los
precios de esta parte carecen de sentido sin ambos. Vuelve a calcular el precio a 10× y a 100× tus cifras actuales antes de elegir proveedor — el ranking se invierte.
- ¿Qué nivel de base de datos vectorial? <100K → Chroma/local. 100K–1M → Pinecone serverless. 1M–10M → pgvector
managed. 10M+ → pgvector self-hosted. Por defecto, managed mientras seas pequeño, y migra según la desigualdad ahorro mensual > coste de ops, no por alcanzar un número de vectores.
- ¿Cuál es la dimensión de tus embeddings, y la elegiste tú? 1536 es un valor por defecto, no una decisión.
512 ahorra un 30–60% con esfuerzo bajo, pero cuesta matiz semántico y no se puede cambiar sin un re-embed completo. Decide antes de tu primera ingesta en producción. Haz un A/B del recall en tu propio corpus.
- ¿Hay una barrera de tokens previa en cada endpoint de cara al usuario?
TokenBudgetcon un
max_tokens_per_request que hayas justificado de verdad (el valor por defecto del código es 4,000). La comprobación debe ejecutarse antes de la llamada a la API. Añade un segundo límite independiente a los tokens de salida, y sustituye también .split() por una protección por longitud en caracteres, o un payload sin espacios pasará sin más.
- ¿Tus contadores de tokens están desglosados por usuario, hora y endpoint? Si no puedes responder «quién está
disparando mi coste», no puedes aplicar rate limiting, cobrar ni negociar. Factura a partir de AIMessage.usage_metadata, nunca de una estimación words × 1.3; reserva la estimación para la barrera, donde todavía no existe respuesta.
- ¿Conoces tu tasa de repetición de queries? Instrumenta una cache que no haga nada durante una semana antes de construir una
de verdad. Ahorro ≈ tasa de repetición. Espera un 30–50% en tráfico de soporte/FAQ y casi cero en tráfico de tipo investigación.
- ¿Qué capas de cache tienes en marcha? Cache de embeddings (store persistente, namespace por modelo
y por dimensions, key_encoder="sha256", query_embedding_cache=True si quieres ahorro en el lado de las queries), cache de retrieval (lru_cache(maxsize=1000), clave normalizada, devuelve una copia), cache de respuestas (normalizar → hashear → store acotado). Nunca un dict sin límite a pelo en un servidor con varios workers — usa un backend compartido, con tu propio Redis o con langchain_core.globals.set_llm_cache.
- ¿Tu cache «semántica» es semántica de verdad? Si es la
SemanticCachedel curso, es
coincidencia exacta tras .lower().strip() — ponle un nombre honesto, o implementa la mejora: embed → búsqueda vectorial → devolver por encima de un umbral. Empieza con la cifra más alta de la fuente (0.95, no el 0.9 del constructor), registra el score de similitud de cada acierto y bájalo solo con pruebas.
- ¿Has puesto límite al crecimiento de la conversación? Elige entre recortar / ventana / resumir y ten claro qué destruye
cada uno. Recortar y la ventana pierden hechos antiguos en silencio; resumir los conserva, cuesta una llamada extra al LLM por desbordamiento y acumula deriva. Registra el resumen en cualquier caso.
- ¿El enrutamiento de modelos se paga solo, y hacia qué lado falla? El clasificador es una llamada completa al LLM
por request. Compara cada mes el gasto del clasificador con el ahorro del enrutamiento, prueba antes un clasificador heurístico y haz que el modelo barato sea el fallback para cualquier clasificación no reconocida — la versión del curso hace lo contrario.
- ¿Haces batching donde el SDK lo soporta? Confirma el soporte antes de diseñar en torno a él.
embed_documents([...]) ya es un batch en el servidor; el .batch() de un Runnable es solo concurrencia en el cliente; index.query(queries, batch=True) puede existir o no en tu cliente.
- ¿Cuándo es tu revisión mensual de costes? Dimensionar bien da un 20–50% con esfuerzo bajo y es la palanca
que la gente se salta porque nunca termina. Instancia pequeña → monitorizar → escalar ante límites reales → revisar cada mes → repetir.
- ¿Has puesto por escrito el presupuesto de latencia? Una fila por etapa, un margen de p95 en cada una y luego un
temporizador en cada fila (Parte 7). Publica la tabla antes de optimizar nada — la híbrida cuesta 20–50 ms, el enrutamiento cuesta un viaje de ida y vuelta completo, un acierto de cache no cuesta nada, y la fila que te está mintiendo nunca es la que sospechas.
- ¿Has vuelto a pasar toda esta lista a 10× tu escala actual? Todos los rankings de esta parte dependen
de la carga de trabajo: la base de datos vectorial es ~24% de la factura con 500K vectores y la partida dominante con 50M, mientras que el coste de generación por request no se mueve. Pon esa revisión en la misma entrada del calendario que la revisión mensual de costes.