
Recuperació avançada: context llarg, recuperació contextual i chunking tardà
Context llarg i RAG, recuperació contextual i late chunking: millora què representa cada fragment.
Tot el que hem fet fins aquí ha tractat de fer funcionar un pipeline convencional: dividir bé, generar embeddings coherents, recuperar amb amplitud, reordenar, observar, desar en memòria cau i publicar. En aquesta part, el curs gira cap a la frontera de 2026 i comença qüestionant la premissa de tota la guia.
Tres tècniques, tres caselles diferents del model mental:
- El context llarg pregunta si cal que existeixi la fase A (índex). Si el model pot
llegir un milió de tokens, per què dividir, generar embeddings i emmagatzemar res? La resposta és aritmètica, no ideologia.
- La recuperació contextual modifica el pas
[Contextualize]de la fase A — l'única casella del
diagrama que havia estat buida fins ara. Canvia el text del qual generes l'embedding.
- El chunking tardà modifica l'ordre
Split → Embedde la fase A. Canvia **quan es
calcula l'embedding**.
Totes tres es regeixen per la invariant 3: el cost d'indexació és únic i s'amortitza; el de consulta es repeteix a cada petició. La recuperació contextual i el chunking tardà són apostes pures per aquesta invariant — gasten molt al camí d'escriptura i res al de lectura. El context llarg és l'aposta contrària: saltar-se del tot el camí d'escriptura i pagar per sempre al de lectura. Aquest és tot l'argument d'aquesta part en tres frases.
El codi viu al segon repositori, fcc-production-rag-part-6 (les lliçons 6.1–6.3 d'«Advanced RAG 2026»): 01_long_context_vs_rag.py, 02_contextual_retrieval.py, 03_late_chunking.py. Els capítols 24, 25 i 26 de la font les cobreixen de 06:06:09 a 06:42:04. Tres files de la taula de sis files de la part 6 del README del repositori corresponen a aquesta part:
| Tècnica | Què resol | Millora declarada |
|---|---|---|
| Context llarg enfront de RAG | Quan fer servir finestres d'1M de tokens en lloc de recuperació | Optimització de costos |
| Recuperació contextual | Fragments que perden el context del document | 67% menys de fallades de recuperació |
| Chunking tardà | Context entre fragments que es perd als embeddings | Millora de precisió del 10–12% |
Pren aquests dos percentatges amb cautela. Al final d'aquesta part sabràs d'on surt cadascun, quina configuració mesura realment i per què el mateix formador del curs et diu dues vegades que els ignoris i mesuris els teus.
1. RAG ha mort? La qüestió del context llarg
1.1 La pregunta i el replantejament
06:06:15 El capítol comença a mitja frase amb la pregunta més habitual que rep el formador: amb models com Gemini que ofereixen finestres d'un milió de tokens, encara necessitem RAG? La seva resposta és negar-se a respondre la pregunta tal com està formulada, repetit tres vegades en vuit minuts:
«No en descartis un en favor de l'altre. Esbrina quan cal fer servir cadascun.» 06:11:20
El mateix script imprimeix el replantejament com a capçalera abans de fer res més:
# fcc-production-rag-part-6/01_long_context_vs_rag.py — __main__ banner
print("\nThe question isn't 'Is RAG dead?'")
print("It's 'When should I use RAG vs Long Context?'")
Defineix els termes amb precisió, perquè altrament la comparació no té sentit. Context llarg, tal com s'utilitza aquí, vol dir ficar tot el corpus a la finestra del prompt a cada consulta, sense cap pas de recuperació — sense divisor, embeddings ni magatzem vectorial. RAG vol dir recuperar de quatre a vuit fragments (~2K tokens) i enviar només això. És una comparació de dues arquitectures, no de dos models.
1.2 La taula comparativa tal com s'explica oralment
| Dimensió | RAG | Context llarg |
|---|---|---|
| Cost per consulta | no es diu cap xifra — «molt insignificant per consulta» | ~$0.10 |
| Latència | ~1 segon | ~45 segons |
| Escalat | «il·limitat, de debò» | límit de ~1M de tokens |
| Titular | «RAG és més de 1,200 vegades més barat» 06:06:15 | — |
No hi ha cap captura del capítol 24 — INDEX.md l'enumera explícitament a «capítols sense captura» —; per tant, totes les xifres anteriors provenen de la transcripció automàtica, i la cel·la del cost de RAG no es llegeix mai en veu alta. Aquesta xifra s'ha perdut. La parella 1 s enfront de 45 s i la proporció 1,200× deriven de la transcripció i no tenen citació; pren-les com a orientatives.
«És la diferència entre tenir un producte viable i la fallida.» 06:07:16
1.3 L'aritmètica del cost, i per què imprimeix 25× i no 1,200×
calculate_costs() és aritmètica pura. No fa cap crida d'API. Això importa: pots executar-la, canviar-ne les constants i raonar sobre les teves pròpies xifres sense gastar ni un cèntim.
# fcc-production-rag-part-6/01_long_context_vs_rag.py — calculate_costs(), abridged:
# the print() calls that only echo these values are omitted.
# Docstring pricing: GPT-4o (April 2026) — input $2.50 / 1M, output $10.00 / 1M.

# Scenario: Query against 100K tokens of documentation
doc_tokens = 100_000
query_tokens = 100
output_tokens = 500

# Long Context approach - stuff everything
long_context_input = doc_tokens + query_tokens
long_context_cost = (long_context_input * 2.50 / 1_000_000) + (
    output_tokens * 10.00 / 1_000_000
)

# RAG approach - retrieve 4 chunks of ~500 tokens each
rag_chunks = 4
tokens_per_chunk = 500
rag_input = (rag_chunks * tokens_per_chunk) + query_tokens
rag_cost = (rag_input * 2.50 / 1_000_000) + (output_tokens * 10.00 / 1_000_000)

print(f"RAG is {long_context_cost / rag_cost:.0f}x cheaper per query!")

queries_per_day = 10_000
print(
    f"  Monthly savings with RAG: ${(long_context_cost - rag_cost) * queries_per_day * 30:.2f}"
)
Calcula-ho a mà, perquè l'aritmètica és la lliçó:
| Magnitud | Context llarg | RAG (4 × 500) |
|---|---|---|
| Tokens d'entrada | 100,100 | 2,100 |
| Cost d'entrada a $2.50/1M | $0.25025 | $0.00525 |
| Cost de sortida (500 tokens a $10/1M) | $0.00500 | $0.00500 |
| Cost per consulta | $0.25525 | $0.01025 |
| Amb 10,000 consultes/dia | $2,552.50/dia | $102.50/dia |
| Diferència mensual (×30) | — | $73,500.00 d'estalvi |
06:11:20 Llegeix la línia impresa en pantalla: «RAG és 25x més barat per consulta» (0.25525 / 0.01025 = 24.9, formatat amb :.0f). Però la diapositiva que havia mostrat cinc minuts abans deia més de 1,200×. Totes dues xifres es diuen en els mateixos vuit minuts i no es reconcilien mai.
Dos paranys més d'aquesta funció que el lector trobarà al cap d'un minut d'executar-la:
1.4 La demostració de latència, i per què no l'hauries de citar
compare_latency() és l'única funció del fitxer que fa crides reals a l'API. Cronometra dues crides llm.invoke(), una amb un context d'una frase i una amb la mateixa frase repetida 50 vegades.
# fcc-production-rag-part-6/01_long_context_vs_rag.py — compare_latency()
small_context = (
    "The company's return policy allows returns within 30 days with receipt."
)
large_context = (small_context + "\n\n") * 50  # ~2500 tokens

query = "What is the return policy?"

start = time.time()
response_small = llm.invoke(f"Context: {small_context}\n\nQuestion: {query}")
small_time = time.time() - start

start = time.time()
response_large = llm.invoke(f"Context: {large_context}\n\nQuestion: {query}")
large_time = time.time() - start

print(f"\nSmall context (~50 tokens): {small_time:.2f}s")
print(f"Large context (~2500 tokens): {large_time:.2f}s")
print(
    f"Difference: {large_time - small_time:.2f}s ({large_time/small_time:.1f}x slower)"
)
print("\nNote: At 100K+ tokens, latency difference is much more dramatic!")
L'execució en directe 06:12:23 ha produït 1.45 s amb el petit i 1.16 s amb el gran — una diferència de −0.29 s i un missatge imprès de «0.8x més lent». Les xifres de la mateixa demostració diuen que el context llarg ha estat més ràpid.
1.5 El sostre de fiabilitat: una finestra d'1M no són 1M de tokens utilitzables
06:07:16 L'afirmació no monetària més important del capítol:
«Aquests models es tornen poc fiables al voltant del 60 al 70% d'aquest límit.» 06:07:16
La capacitat efectiva i fiable és aproximadament el 60–70% de la finestra anunciada — uns 600K–700K tokens en un model d'1M de tokens. Més enllà, la recuperació dins del context es degrada: la família de fallades de «pèrdua al mig» o deteriorament del context, en què es demostra que el model deixa de prestar atenció a material que ha rebut. El seu plantejament: «això no és només qüestió de diners o d'economia» — fins i tot amb un pressupost infinit, la precisió tota sola ja desaconsella omplir el prompt ingènuament.
Ho afirma com un «fet conegut» i no esmenta cap article ni cap prova comparativa. És coherent amb la literatura publicada sobre context llarg, però, tal com es presenta al curs, és una afirmació sense citació. Pren el 60–70% com una heurística de planificació, no una especificació: una finestra d'un milió de tokens et compra 600–700K tokens d'atenció fiable; per tant, pressuposta amb el límit efectiu, no amb el de màrqueting.
Les llistes orals — on guanya realment cada enfocament
Abans del marc imprès, narra dues llistes informals. En alguns punts difereixen del requadre imprès de l'script, i val la pena tenir-les totes dues.
On guanya realment el context llarg 06:07:16 — «siguem justos, hi ha casos en què els models de context llarg són realment bons»:
- Documents petits — documents més petits en conjunt.
- Menys de 100K tokens — *«si tens menys de 100k tokens, és una bona manera de
tractar-ho»*. (El requadre imprès diu <50K. Totes dues xifres són a la lliçó.)
- Tasques estàtiques i acotades — una tasca amb una entrada que no creix i un abast fix.
- Necessites tot el context alhora — raonament sobre el document sencer en què qualsevol límit de fragment
destruiria la resposta: resumeix aquest contracte, troba contradiccions al llarg de tot el document.
On guanya RAG 06:08:17:
- Base de coneixement gran — *«molts documents, molta informació que poses
en una base de dades vectorial»*.
- Contingut dinàmic i actualitzat sovint — «RAG és realment bo en això». (Contradiu el
requadre imprès; consulta el requadre explicatiu següent.)
- Eficiència de costos — «si el sistema és sensible al cost, RAG és el camí».
- Precisió — *«si vols un sistema molt precís i molt específic, llavors
RAG guanya clarament» — amb la condició crucial «si tot està muntat correctament»*.
1.6 El marc de decisió
print_decision_framework() imprimeix un requadre ASCII — és una instrucció print de l'script, no una diapositiva —, i és l'artefacte reutilitzable de tot el capítol. Reproduït fidelment, amb les variants orals indicades:
| Fes servir context llarg quan | Fes servir RAG quan |
|---|---|
| El corpus és petit (<50K tokens) — diu <100K en veu alta a 06:07:16 | El corpus és gran (>100K tokens) |
| El volum de consultes és baix (<100 consultes/dia) | El volum de consultes és alt (1000s/dia) — diu «centenars» en veu alta a 06:13:23 |
| Necessites analitzar el document SENCER | Els usuaris pregunten sobre temes concrets, no fan anàlisi del document sencer |
| Els documents canvien sovint (sense sobrecàrrega d'embeddings) | Els documents són relativament estables |
| Simplicitat > optimització del cost | El cost i la latència importen |
| — | Necessites citacions / seguiment de les fonts |
Sobrecàrrega d'embeddings, definida: el cost, la latència i la càrrega operativa de generar embeddings i indexar cada versió d'un document al magatzem vectorial — i repetir-ho sempre que canvia un document. És l'única cosa que el context llarg et permet evitar del tot.
Dues asimetries més que val la pena exposar clarament, perquè el requadre imprès només les suggereix:
- Les citacions són estructuralment gratuïtes a RAG i estructuralment difícils amb context llarg. A RAG
saps quin fragment ha produït la resposta perquè l'hi has posat tu. Introdueix 100K tokens en un sol bloc i l'atribució es converteix en una segona tasca d'LLM poc fiable.
- La precisió de RAG és condicional. *«RAG aporta molta precisió **si tot està
muntat correctament**»* 06:08:17. Aquesta condició són les parts 3 a 9 d'aquesta guia. RAG no guanya en precisió per defecte; hi guanya quan el pipeline està ben construït.
1.7 L'enfocament híbrid: RAG selecciona, el context llarg llegeix
La síntesi, presentada al límit del capítol 06:14:29:
«No separis les dues coses — RAG contra context llarg. Digues RAG I context llarg.»
I la frase amb què acaba: «Al capdavall, RAG no ha mort.» El mecanisme té dos passos i és l'estructura cap a la qual haurien de convergir la majoria de sistemes reals:
- RAG recupera documents candidats — no fragments a partir dels quals respondre, sinó documents per llegir.
- Carrega aquests documents complets a la finestra de context per elaborar la resposta detallada.
L'estructura de consulta que necessita totes dues coses: «parla'm de X, Y i Z, i després analitza a fons aquesta part del corpus». RAG redueix el corpus de deu mil documents a un; després, el context llarg llegeix amb cura el que ha sobreviscut.
demo_hybrid_approach() és la quarta crida de __main__; per tant, sí que s'executa — però la narració s'atura després del marc de decisió i no en parla mai, de manera que aquest és l'únic lloc on el lector la veurà explicada. El detall fonamental és k=1:
# fcc-production-rag-part-6/01_long_context_vs_rag.py — demo_hybrid_approach()
# Step 1: Create vector store for RAG retrieval
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vectorstore = Chroma.from_documents(
    documents=documents, embedding=embeddings, collection_name="hybrid_demo"
)

query = "What's the policy on working from home and what equipment do I get?"

# Step 3: RAG retrieves relevant document
retriever = vectorstore.as_retriever(search_kwargs={"k": 1})
relevant_docs = retriever.invoke(query)
print(f"Retrieved: {relevant_docs[0].metadata['source']}")

# Step 4: Load FULL document into context (hybrid part)
full_doc = relevant_docs[0].page_content

prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            """You are a helpful HR assistant. Use the full policy document
        below to give a comprehensive answer. Include all relevant details from
        the document.

        Policy Document:
        {document}""",
        ),
        ("human", "{query}"),
    ]
)

chain = prompt | llm
response = chain.invoke({"document": full_doc, "query": query})

# Cleanup
vectorstore.delete_collection()
k=1 fa una cosa poc habitual i deliberada: aquí la recuperació tria el document, no la resposta. Els tres documents de demostració estan escrits com a polítiques completes amb seccions 1–4 (remote_work_policy.pdf, expense_policy.pdf, pto_policy.pdf), tots etiquetats doc_type: "policy"; per tant, «carregar el document complet» és una acció amb sentit. La consulta — *treballar des de casa i quin equip rebo* — abasta deliberadament la secció 2 i la secció 3 d'un document, exactament la pregunta que una recuperació dels primers k fragments respon malament i una lectura del document sencer respon perfectament.
El corpus sintètic de recursos humans, per si vols reproduir l'execució
Són valors de les dades de prova, no paràmetres RAG — però reprodueix-los exactament si vols el mateix comportament de recuperació.
- Política de teletreball — elegibilitat després d'un període de prova de 90 dies (temps parcial cas per
cas); teletreball fins a 3 dies/setmana; horari de presència obligatòria 10am–3pm local; portàtil i monitor proporcionats, l'empleat paga internet, assignació anual de $500 per a l'oficina a casa; localitzable per Slack durant l'horari obligatori, vídeo activat a les reunions d'equip, expectativa de resposta de 30 minuts.
- Política de reemborsament de despeses — les despeses superiors a $500 necessiten aprovació prèvia del responsable,
els viatges superiors a $2,000 necessiten aprovació de vicepresidència; rebuts obligatoris per sobre de $25 (s'accepten digitals, no n'hi ha prou amb extractes de targeta); presentar en 30 dies, fora de termini cal aprovació de direcció; reemborsament en 10 dies laborables per ingrés directe.
- Política de vacances i permisos — 15 dies de permís retribuït/any, +1 dia per any de servei fins a
25; 10 dies de baixa per malaltia, no acumulables, justificant mèdic per sobre de 3 dies; 10 festius retribuïts; permís no retribuït de fins a 12 setmanes per motius familiars o mèdics, amb les regles FMLA aplicables.
Fixa't en vectorstore.delete_collection() al final. Totes les demostracions d'aquesta part eliminen la col·lecció de Chroma, i és un hàbit que val la pena copiar: aquests scripts fixen els collection_name al codi, i una caiguda a mitja execució deixa una col·lecció poblada a la qual l'execució següent afegeix dades, corrompent silenciosament la comparació.
Els beneficis impresos: 1. RAG troba ràpidament el document CORRECTE. 2. El context del document complet garanteix que no es perdi res. 3. Continua sent més barat que introduir TOTS els documents. 4. Ideal per a: «Trobar el document rellevant i després analitzar-lo a fons.»
1.8 La lliçó de fons: pensa a escala, no amb la mida del prototip
06:12:23 és el paràgraf que diu que és «exactament el que us vull mostrar»: quan comences a construir RAG, els volums de dades són minúsculs i totes les xifres semblen trivials; per tant, no t'adones mai de l'arquitectura amb què t'estàs comprometent.
«Per tant, pensa sempre en l'escalat, no en xifres petites.» 06:12:23
S'aplica dues vegades en aquest capítol, i val la pena interioritzar totes dues aplicacions:
- Cost. $0.255 enfront de $0.010 per consulta sembla res. Multiplica-ho per 10,000 consultes/dia
i 30 dies i són $73,500/mes de despesa evitable.
- Latència. Una demostració de 2,500 tokens no mostra cap diferència (fins i tot en dona una de negativa). Amb 100K+
tokens es converteix en l'1 s enfront dels 45 s de la taula inicial.
Idees clau, tal com les imprimeix l'script:
- RAG NO ha mort — és qüestió de cost i latència a escala.
- El context llarg guanya amb documents petits, poc volum i anàlisi de documents complets.
- RAG guanya amb corpus grans, molt volum i consultes concretes.
- Enfocament híbrid: RAG per trobar documents, context llarg per analitzar-los.
- El futur és fer servir TOTS DOS estratègicament.
2. Recuperació contextual: arregla el fragment abans de generar-ne l'embedding
2.1 El problema
La part 3 ha establert que el chunking és arquitectura. Aquesta n'és la continuació: fins i tot un fragment dividit correctament pot ser irrecuperable, perquè dividir separa el fragment del document que li donava significat.
«Quan fragmentes, cadascun d'aquests fragments perd el context.» 06:15:33
El seu exemple canònic: un fragment que diu «la política de l'empresa estableix…» — quina empresa? quina política? La documentació interna del fitxer ho formula com «L'empresa es va fundar el 1994» — Quina empresa? De quin document prové? El fragment és factualment cert i completament impossible d'atribuir.
La fallada és mecànica, no misteriosa. 06:20:42 Un usuari pregunta «Quins són els ingressos d'ACME?» El fragment que conté la resposta diu:
«Els ingressos de l'exercici fiscal 2025 van arribar a $4.2 mil milions, un augment del 15% respecte de l'any anterior.»
El token ACME no apareix mai. Ni la coincidència lèxica ni la semàntica no tenen res on agafar-se. Els pronoms i les descripcions definides — «l'empresa», «ells», «això» — són la forma general d'aquest error, i són pertot arreu als corpus reals: informes anuals, manuals de polítiques, documentació tècnica, qualsevol text amb un títol que el cos no repeteix mai.
demonstrate_context_loss() mostra el problema sense cap crida d'API: un informe anual 2025 d'ACME Corporation amb tres seccions (Visió general de l'empresa / Dades financeres destacades / Perspectives de futur), reduït a tres fragments deliberadament orfes:
- «L'empresa s'especialitza en la fabricació d'equipament industrial per al sector miner.»
→ quina empresa?
- *«Els ingressos de l'exercici fiscal 2025 van arribar a $4.2 mil milions, un augment del 15% respecte de l'
any anterior.»* → de quina empresa?
- «L'empresa preveu expandir-se cap a l'equipament d'energies renovables el 2026.» → plans de quina
empresa?
Els dos documents de demostració, complets — reprodueix-los per obtenir les mateixes xifres
Document 1 — l'informe anual 2025 d'ACME Corporation (utilitzat per demonstrate_context_loss(), demonstrate_contextual_retrieval() i compare_retrieval()):
ACME Corporation Annual Report 2025

Company Overview:
ACME Corporation was founded in 1994 in San Francisco. The company
specializes in manufacturing industrial equipment for the mining sector.

Financial Highlights:
Revenue for fiscal year 2025 reached $4.2 billion, representing a 15%
increase from the previous year. The company's profit margin improved
to 18%, up from 14% in 2024.

Future Outlook:
The company plans to expand into renewable energy equipment in 2026.
A new manufacturing facility will open in Austin, Texas. The company
expects revenue growth of 20% in the coming fiscal year.
(El «ingressos de l'exercici fiscal 2005» de la transcripció és una interpretació errònia de 2025.)
Document 2 — el comunicat de premsa de la sèrie B de TechStartup Inc. (utilitzat per demo_production_pipeline(), metadata={"title": "TechStartup Inc. Series B Announcement", "source": "press_release.pdf"}): una empresa d'infraestructura d'IA amb seu a Seattle tanca una sèrie B de $45 milions liderada per Sequoia Capital amb participació d'Andreessen Horowitz; la directora general Jane Smith preveu duplicar la plantilla abans d'acabar el 2026; el producte estrella AIFlow ajuda empreses a desplegar i gestionar LLM en producció i dona servei a 200+ clients empresarials.
Fixa't en com s'han escrit tots dos documents: el nom de l'entitat apareix una sola vegada, al primer paràgraf, i totes les frases següents diuen «l'empresa». No és un artifici — és com s'escriuen realment els informes anuals, els comunicats de premsa i els manuals de polítiques.
2.2 El mecanisme, i les dues paraules importants
La recuperació contextual la va publicar Anthropic a finals de 2024 06:17:36. La tècnica cap en una frase:
«Fes servir un LLM per anteposar context a cadascun d'aquests fragments abans de generar l'embedding. Les paraules clau són abans de generar l'embedding.» 06:16:35
Aquest és tot el detall fonamental de la lliçó. El context afegit és:
- generat per un LLM, no construït amb una plantilla a partir de metadades — el model llegeix tot el document
i escriu una frase que situa el fragment;
- concatenat al text del fragment abans de la crida d'embedding, perquè el vector mateix
codifiqui els fets a escala de document.
Què conté el prefix: informació del document (títol, nom de l'informe, any, organització) i de la secció (en quina part del document se situa el fragment), més la resolució de les entitats a què apunten els pronoms del fragment. Ara la unitat recuperable respon «quina empresa?» tota sola.
2.3 La funció central, completa
Aquesta és tota la tècnica. És una plantilla de prompt i una cadena LCEL de dos nodes — aquí no hi ha cap subsistema a mida.
# fcc-production-rag-part-6/02_contextual_retrieval.py — add_contextual_prefix()
def add_contextual_prefix(
    chunk: str, full_document: str, document_title: str, llm: ChatOpenAI
) -> str:
    """
    Use LLM to generate a contextual prefix for a chunk.

    This is the core of Contextual Retrieval:
    - Give the LLM the full document and the specific chunk
    - Ask it to write a brief context that situates the chunk
    - Prepend this context to the chunk before embedding
    """

    prompt = ChatPromptTemplate.from_messages(
        [
            (
                "system",
                """You are an expert at adding context to document chunks.

Given a document and a specific chunk from that document, write a SHORT
context (1-2 sentences) that helps situate the chunk within the document.

The context should include:
- The document title/source if relevant
- Key entities mentioned earlier in the document
- Any important context that helps understand this chunk

Keep it brief - just enough to disambiguate the chunk.
Output ONLY the contextual prefix, nothing else.""",
            ),
            (
                "human",
                """Document Title: {title}

Full Document:
{document}

Chunk to contextualize:
{chunk}

Write a brief contextual prefix for this chunk:""",
            ),
        ]
    )

    chain = prompt | llm
    response = chain.invoke(
        {"title": document_title, "document": full_document, "chunk": chunk}
    )

    return response.content
Hi ha tres coses fonamentals en aquell prompt que val la pena adoptar literalment:
- «1-2 frases» i «Sigues breu» — el prefix engrandeix cada fragment; per tant, la seva
longitud és un cost que pagues per sempre (consulta §2.7).
- «Entitats clau esmentades abans al document» — aquesta és la instrucció que
fa la resolució de coreferències. Per això «l'empresa» es converteix en «ACME Corporation».
- «Retorna NOMÉS el prefix contextual, res més.» — sense això, un model xerraire
retorna «És clar! Aquí tens un context per a aquest fragment:», i aquest preàmbul queda incorporat com a soroll a l'embedding, permanentment, dins de l'índex.
Totes dues instàncies de ChatOpenAI del fitxer fan servir model="gpt-4o-mini", temperature=0. El determinisme importa aquí: generar context és una tasca d'extracció, no creativa, i temperature=0 fa que reindexar el mateix corpus produeixi prefixos gairebé idèntics en lloc d'un conjunt de vectors nou cada vegada.
I l'única línia que és la tècnica — apareix dues vegades al fitxer, una a la demostració (línia 201, com a contextualized) i una a la funció de producció (línia 330, com a contextualized_content):
# fcc-production-rag-part-6/02_contextual_retrieval.py:201
contextualized = f"{context_prefix} {chunk}"
La frase original no es reescriu ni es destrueix mai. El prefix és purament additiu — això és el que fa que tot plegat sigui auditable.
Executar-ho sobre els fragments d'ACME produeix prefixos com aquests 06:20:42:
- Fragment 1 → *«A la secció de visió general de l'empresa de l'informe anual 2025 d'ACME Corporation,
el document presenta ACME…»* + text original
- Fragment 2 → «…secció de dades financeres destacades d'ACME Corporation…» + text original
- Fragment 3 → «A la secció de perspectives de futur de l'informe anual d'ACME Corporation…» + text
original
2.4 La funció de producció
create_contextual_chunks() és el substitut directe del pas de divisió. És el que realment poses en servei.
# fcc-production-rag-part-6/02_contextual_retrieval.py — create_contextual_chunks()
def create_contextual_chunks(
    documents: list[Document],
    llm: ChatOpenAI,
    chunk_size: int = 500,
    chunk_overlap: int = 100,
) -> list[Document]:
    """
    Production-ready function to create contextualized chunks.

    This is the function you'd use in a real RAG pipeline.
    Note: This adds latency and cost during indexing, but it's a one-time cost.
    """

    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=chunk_size,
        chunk_overlap=chunk_overlap,
        separators=["\n\n", "\n", ". ", " ", ""],
    )

    contextualized_docs = []

    for doc in documents:
        full_content = doc.page_content
        doc_title = doc.metadata.get(
            "title", doc.metadata.get("source", "Unknown Document")
        )

        chunks = text_splitter.split_text(full_content)

        for i, chunk in enumerate(chunks):
            context_prefix = add_contextual_prefix(
                chunk=chunk,
                full_document=full_content,
                document_title=doc_title,
                llm=llm,
            )

            contextualized_content = f"{context_prefix} {chunk}"

            contextualized_docs.append(
                Document(
                    page_content=contextualized_content,
                    metadata={
                        **doc.metadata,
                        "chunk_index": i,
                        "original_chunk": chunk,
                        "context_prefix": context_prefix,
                    },
                )
            )

    return contextualized_docs
Llegeix amb cura el diccionari metadata — és la bona idea menys explicada del capítol:
| Clau | Per què existeix |
|---|---|
**doc.metadata | el source, el page i el title del document pare es conserven a cada fragment (invariant de la part 2: semàntica de split_documents, feta a mà aquí) |
chunk_index | posició dins del document pare, per ordenar i ampliar amb fragments veïns |
original_chunk | el text sense prefix — perquè puguis generar l'embedding de la versió contextualitzada, però mostrar i citar l'original |
context_prefix | la cadena exacta que ha inventat l'LLM — perquè la puguis auditar, comparar entre reindexacions i detectar un model que ha començat a al·lucinar la procedència |
Fixa't en la cadena d'alternatives per al títol: metadata["title"] → metadata["source"] → "Unknown Document". Si el carregador no estableix cap de les dues claus, tots els prefixos de l'índex es generaran amb la cadena «Unknown Document» — una regressió silenciosa de qualitat sense cap error associat.
Els valors per defecte són chunk_size=500, chunk_overlap=100 (un solapament net del 20%, que concorda amb la regla del 10–20% de la part 3). La demostració de producció la crida amb chunk_size=200, chunk_overlap=50 sobre un únic comunicat de premsa de la sèrie B de TechStartup Inc. i produeix 7 fragments 06:23:45. Fixa't en la jerarquia del divisor ["\n\n", "\n", ". ", " ", ""] — paràgrafs, línies, frases, paraules, caràcters —, el valor recursiu per defecte de la part 3.
La recuperació no canvia gens:
# fcc-production-rag-part-6/02_contextual_retrieval.py — demo_production_pipeline()
contextualized_docs = create_contextual_chunks(
    documents=documents, llm=llm, chunk_size=200, chunk_overlap=50
)
print(f"Created {len(contextualized_docs)} contextualized chunks")

vectorstore = Chroma.from_documents(
    documents=contextualized_docs,
    embedding=embeddings,
    collection_name="contextual_demo",
)

query = "How much funding did the Seattle AI company raise?"
results = vectorstore.similarity_search(query, k=2)
La consulta està ben triada: «l'empresa d'IA de Seattle» no anomena ni l'empresa ni la ronda. Només un fragment contextualitzat pot establir el vincle.
La recuperació contextual és un canvi a la tasca d'indexació, no al recorregut de consulta. Tots els recuperadors, reordenadors, cadenes i prompts posteriors queden intactes.
2.5 L'A/B mesurat, i com llegir les puntuacions
compare_retrieval() construeix dues col·leccions de Chroma amb els mateixos tres fragments d'ACME — una en brut, una contextualitzada — i executa les mateixes tres consultes contra totes dues amb k=1.
# fcc-production-rag-part-6/02_contextual_retrieval.py — compare_retrieval()
orig_results = vs_original.similarity_search_with_score(query, k=1)
orig_doc, orig_score = orig_results[0]

ctx_results = vs_contextual.similarity_search_with_score(query, k=1)
ctx_doc, ctx_score = ctx_results[0]

# Lower score = better match in Chroma
if ctx_score < orig_score:
    improvement = ((orig_score - ctx_score) / orig_score) * 100
    print(f"\n  -> Contextual retrieval {improvement:.1f}% better match!")
| Consulta | Puntuació original | Puntuació contextual | Millora |
|---|---|---|---|
| «Quins són els ingressos d'ACME?» | ≈1.14 (oralment: «una mica més d'un») | 0.5 | 56% |
| «Què fabrica ACME Corporation?» | 1.33 | ≈0.51 (deduïda) | 61.4% |
| «Quins són els plans d'expansió d'ACME?» | ≈1.42 (deduïda) | 0.7 | 50.6% |
Dues de les sis cel·les de puntuació no es van llegir mai en veu alta i s'han calculat a partir dels percentatges impresos — estan marcades com a deduïdes, no llegides de la pantalla. Torna a executar l'script si necessites valors exactes.
El patró que vol que recordis no és un únic rescat espectacular: totes tres consultes han millorat un 50–61%, incloses les dues amb fragments objectiu que ja compartien vocabulari amb la consulta («manufacture»/«manufacturing», «expansion plans»/«plans to expand»). Afegir els noms del document i la secció ajuda fins i tot quan ja hi havia solapament lèxic.
2.6 Les xifres de les proves comparatives, i la correcció que el curs no fa
06:17:36 Dues xifres atribuïdes a la recerca d'Anthropic:
- Recuperació contextual sola: reducció del 49% de les fallades de recuperació entre els primers 20 resultats.
- Recuperació contextual + reranking: reducció del 67%.
Fallada de recuperació entre els primers 20 resultats, definida: el passatge correcte no apareix enlloc dels primers 20 resultats recuperats. Els percentatges són reduccions de la taxa d'aquest esdeveniment, no puntuacions de precisió.
Matisa les xifres dues vegades, deliberadament, i el matís és la lliçó més valuosa:
«Recordeu que aquestes xifres són proves comparatives que han fet ells. Podrien ser més altes o més baixes.» 06:19:40
«Només són proves comparatives. Per tant, ho heu de provar vosaltres.» 06:24:26
2.7 Consideracions de producció: el camí d'escriptura ho paga tot
L'script n'imprimeix quatre, i són la comptabilitat honesta dels costos de la tècnica:
| Consideració | Xifra | On recau |
|---|---|---|
| Cost | $0.01–$0.05 per document per generar context | una sola vegada, indexació |
| Latència | 1–2 s per fragment durant la indexació | una sola vegada, indexació — processament per lots fora de línia |
| Latència de consulta | cap impacte | camí de lectura intacte |
| Emmagatzematge | els fragments són ~20–30% més grans | «impacte mínim en els costos de la base de dades vectorial» |
«És un cost únic en indexar, molt més barat que les fallades de recuperació.» 06:23:45
L'argument econòmic és correcte: pagues una vegada per document, per sempre, en lloc de pagar repetidament en respostes equivocades, incidències de suport escalades i confiança erosionada. I l'asimetria és total — tot el cost i tota la latència recauen al camí d'escriptura.
Sobre el creixement del 20–30% 06:24:26: l'LLM afegeix text literalment; per tant, els fragments creixen. L'emmagatzematge creix; la dimensionalitat de l'embedding — que és el que domina el cost de la base de dades vectorial — no. Per això qualifica de mínim l'impacte en l'emmagatzematge. El que no esmenta és el cost del prompt: una recuperació dels primers 5 resultats ara introdueix ~25% més de text en cada prompt de resposta, a cada petició, per sempre. Aquest cost sí que acaba al camí de lectura.
2.8 Quan activar-la
Tres desencadenants 06:24:26. Si qualsevol és cert, la recuperació contextual probablement compensa la crida a l'LLM per fragment; si no se'n compleix cap, probablement no.
- El context important és a les capçaleres o els títols — noms d'informe, encapçalaments de secció, dates —
que el cos del fragment no repeteix mai.
- Les entitats es referencien amb pronoms o descripcions definides: «l'empresa»,
«ells», «això».
- Els documents provenen de diverses fonts; per tant, un fragment tot sol no pot identificar la seva pròpia
procedència i els resultats de corpus diferents es confonen.
Les sis idees clau impreses (et diu que aturis el vídeo i les llegeixis):
- Els fragments perden context quan se separen dels documents.
- La recuperació contextual afegeix context ABANS de generar l'embedding.
- Fes servir un LLM per generar un prefix contextual d'1–2 frases.
- Cost únic en indexar, millora permanent de la recuperació.
- Anthropic informa d'un 67% menys de fallades de recuperació.
- Combina-la amb cerca híbrida BM25 per obtenir els millors resultats.
La idea clau 6 apunta directament a la part 6. Al disseny original d'Anthropic, la tècnica és «Embeddings contextuals + BM25 contextual» — indexes el text contextualitzat tant lèxicament com vectorialment. Si has construït el recuperador híbrid de la part 6, alimenta totes dues branques amb el text contextualitzat; això és el que mesura realment la xifra del 49%.
3. Chunking tardà: primer genera embeddings, després divideix
3.1 La inversió
«El chunking tardà és una tècnica més nova que inverteix el chunking tradicional.» 06:25:30
Aquesta és tota la idea, i val la pena apreciar com n'és de petita:
- Chunking primerenc / tradicional: dividir el text → generar l'embedding de cada fragment independentment.
- Chunking tardà: generar els embeddings del document sencer en una sola passada endavant → després dividir els
embeddings de tokens resultants per posició → agregar cada tram en un vector de fragment.
No canvia res més. Mateix magatzem vectorial, mateix recuperador, mateix k, mateix reordenador, mateixos prompts. Fins i tot l'índex té el mateix aspecte — mateix nombre de vectors, mateixes dimensions. Només difereixen els nombres dins dels vectors.
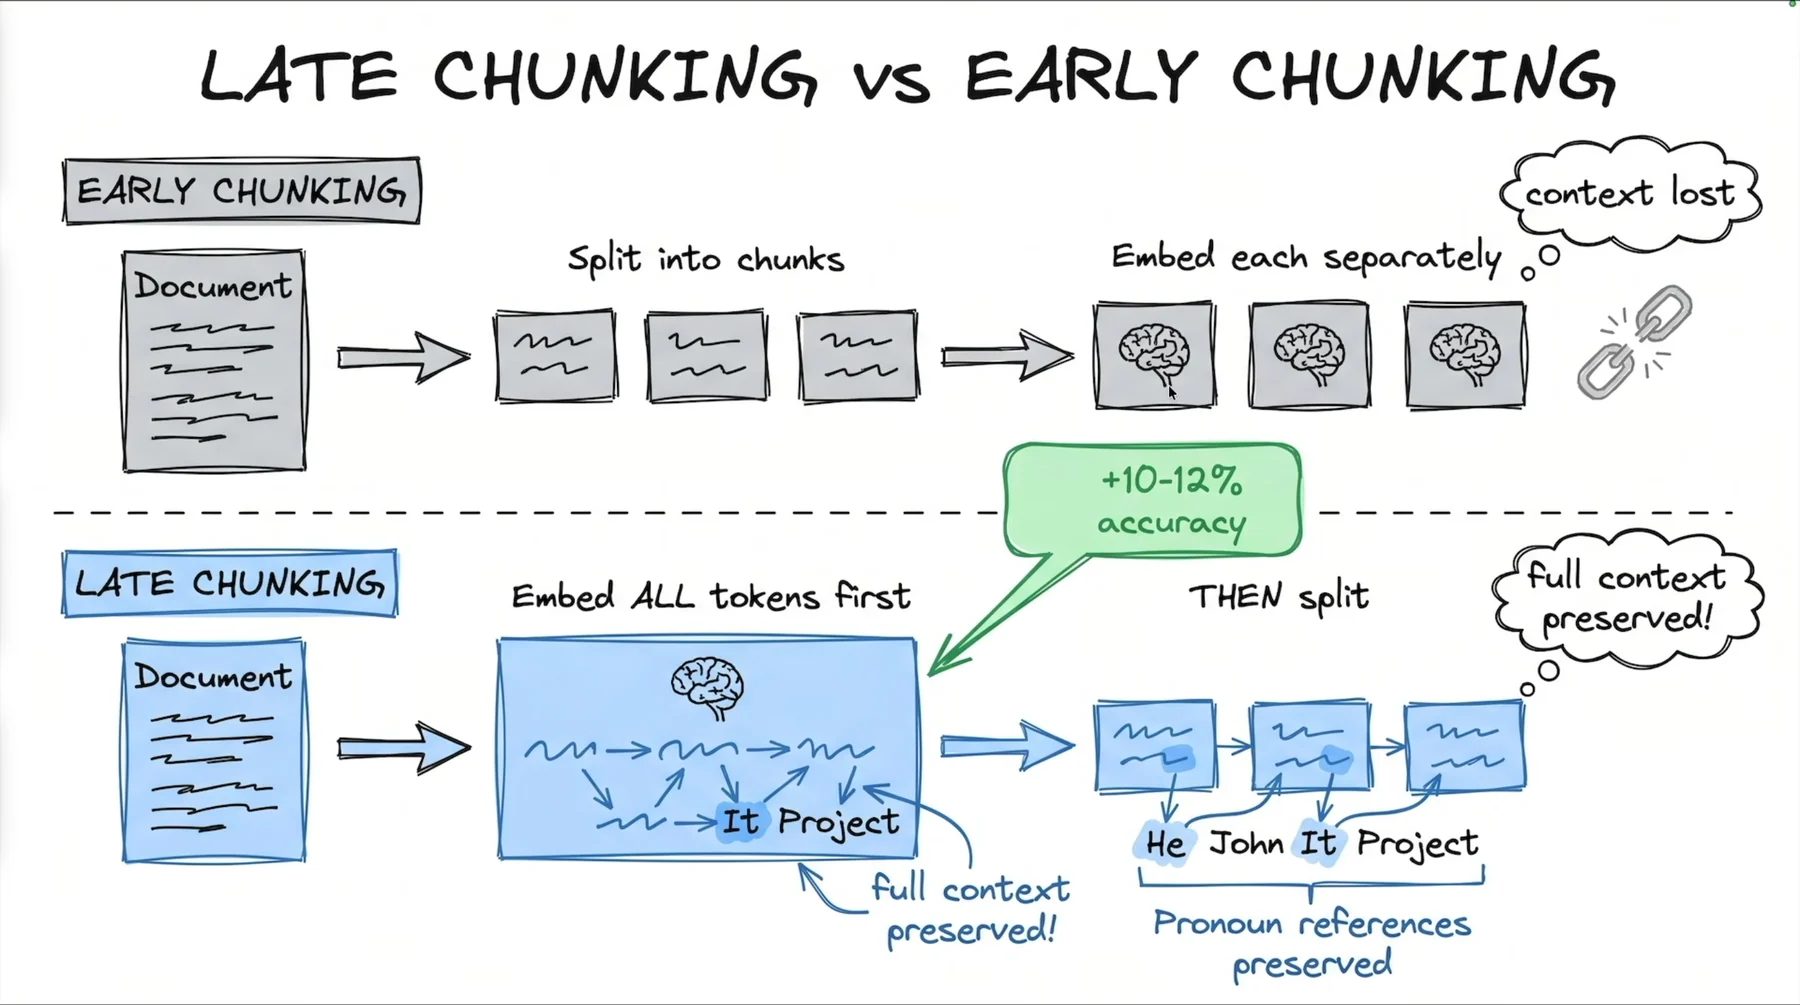
He / John / It / Project sota els fragments dividits n'és el benefici: coreferència resolta abans de dividir, de manera que sobreviu a la divisió.Per què funciona es resumeix en una frase de mecànica dels transformers. Quan el model fa una passada endavant sobre tot el document, l'atenció permet que cada token vegi tots els altres. El token «He» del tercer paràgraf es calcula en presència de «Steve Jobs» al primer; per tant, el seu vector ja porta aquesta associació. Divideix després aquests vectors de tokens i el vector agregat de cada fragment hereta context de tot el document que un embedding independent del mateix text no podria tenir mai.
«Cadascun d'aquests fragments o vectors, perquè ara són embeddings, coneix tot el document.» 06:33:38
Calen dos termes, perquè el curs els fa servir sense definir-los. Els embeddings a escala de token són els vectors per token que un transformer produeix internament, abans que el model els agregui en el vector únic que retorna una API d'embeddings. El pooling és aquesta reducció: fer la mitjana (o combinar d'una altra manera) dels vectors dels tokens que cauen dins del tram d'un fragment per obtenir un vector de fragment. Al diagrama ASCII de l'script, els fragments tardans porten les etiquetes Vector 1 (pooled), Vector 2 (pooled), Vector 3 (pooled) — la divisió produeix embeddings, i cada grup s'agrega fins a un únic vector de fragment, que és el que arriba a la base de dades.
El benefici declarat: +10–12% de precisió en tasques de recuperació. Aquesta xifra apareix al requadre verd de la diapositiva, a la documentació interna del mòdul, a la taula comparativa i a la idea clau #4. A 06:27:31 diu «del 10 al 20%» una vegada — un lapsus que contradiu tots els artefactes escrits, probablement una barreja amb el +15–20% de la recuperació contextual. Fes servir 10–12%.
3.2 La fallada que resol, feta comptable
El millor recurs d'aquest capítol és una demostració que evidencia la fallada amb una comprovació de subcadena i zero crides d'API. El document de prova és una biografia de Steve Jobs preparada perquè el paràgraf 1 l'anomeni i els paràgrafs 2–4 comencin tots amb «He».
# fcc-production-rag-part-6/03_late_chunking.py — demonstrate_early_chunking_problem()
# (the document literal keeps the source file's 4-space indentation — those spaces are
#  part of the text and they count toward chunk_size)
document = """
    Steve Jobs was born in San Francisco in 1955. He was adopted
    by Paul and Clara Jobs shortly after birth.

    He co-founded Apple Computer in 1976 with Steve Wozniak.
    The company started in his parents' garage. He served as CEO
    until 1985 when he was ousted from the company he created.

    He then founded NeXT Computer and acquired Pixar Animation Studios.
    These ventures would later prove instrumental in his return to Apple.

    He returned to Apple in 1997 and transformed it into one of the
    most valuable companies in the world. He introduced the iPod, iPhone,
    and iPad, revolutionizing multiple industries.
    """

# Simulate early chunking
splitter = RecursiveCharacterTextSplitter(
    chunk_size=200,
    chunk_overlap=0,  # No overlap to show the problem clearly
    separators=["\n\n", "\n", ". ", " "],
)

chunks = splitter.split_text(document)

for i, chunk in enumerate(chunks, 1):
    # Check if "Steve Jobs" appears in this chunk
    has_name = "Steve Jobs" in chunk
    pronoun_count = chunk.lower().count(" he ")

    print(f"\nChunk {i}:")
    print(f'  "{chunk.strip()[:80]}..."')
    print(
        f"  Contains 'Steve Jobs': {'Yes' if has_name else 'NO - Just pronouns!'}"
    )
    print(f"  Pronoun 'he' count: {pronoun_count}")
L'execució produeix quatre fragments 06:30:34–06:31:35:
| Fragment | Text inicial | Conté «Steve Jobs» | Recompte de " he " |
|---|---|---|---|
| 1 | «Steve Jobs was born in San Francisco in 1955…» | Sí | 1 |
| 2 | «He co-founded Apple Computer in 1976 with Steve Wozniak…» | NO – Només pronoms! | 3 |
| 3 | «He then founded NeXT Computer and acquired Pixar…» | NO | 0 |
| 4 | «He returned to Apple in 1997…» | NO | 1 |
Tres de quatre fragments no es poden trobar pel nom. L'argument imprès:
Chunks 2, 3, 4 only contain "he" - no "Steve Jobs"!

When embedding these chunks separately:
- Query: "What companies did Steve Jobs found?"
- Chunk 2 mentions "co-founded Apple" but says "He co-founded"
- Embedding of "He co-founded" won't match "Steve Jobs founded"

The pronoun "he" loses its referent when chunked separately.
La informació és dins del corpus i, tot i així, no es pot recuperar. És la fallada silenciosa de la invariant 4 en la forma més pura: res no dona error, res no queda registrat, l'usuari simplement obté una resposta pitjor. La versió genèrica que narra a 06:26:31 — només oral, sense cap artefacte al darrere — és un comunicat corporatiu dividit de manera que un fragment comença «Va dir que entraria en vigor immediatament» mentre que el director general que ho va dir és al fragment anterior. Mateix error, i és l'estructura que produeixen la majoria de corpus reals.
3.3 Els dos fluxos, de costat
visualize_chunking_approaches() imprimeix la diapositiva com una parella de diagrames de flux ASCII. Aquí es condensen en una línia per etapa — les etiquetes són literals de l'script; el dibuix de les caselles no:
ASCII original
EARLY CHUNKING (Traditional):
Full Document ─► [Split Text] ─► Chunk 1 | Chunk 2 | Chunk 3
                                    │        │        │
                                 [Embed]  [Embed]  [Embed]
                                    ▼        ▼        ▼
                                Vector 1 | Vector 2 | Vector 3

"Each chunk embedded INDEPENDENTLY - no cross-chunk context!"

LATE CHUNKING (Context-Preserving):
Full Document ─► [Embed FULL Document]
                      ▼
        Full Document Token Embeddings
        [tok1] [tok2] [tok3] ... [tok_n]
        "Each token has FULL document context via attention"
                      ▼
        [Split Embeddings by Position]
                      ▼
          Vector 1  |  Vector 2  |  Vector 3
          (pooled)     (pooled)     (pooled)

"Each chunk vector KNOWS about the whole document!"
"'He' in chunk 2 is embedded with knowledge that 'He' = 'Steve Jobs'"
«Cada fragment, com dic aquí, és una entitat pròpia. Se'n genera l'embedding independentment. Per tant, no hi ha context entre fragments.» 06:32:36
L'aïllament és la causa arrel i és estructural. Cap millora de recuperació — ni reordenador, ni reescriptura de consultes, ni k=50 — arregla un embedding calculat a cegues. Torna a ser la invariant 1: la qualitat s'hereta cap endavant i no es recupera mai més avall.
La llei general que en dedueix, en dues citacions breus 06:27:31:
«Tot està lligat al context perquè els grans models de llenguatge necessiten context.»
«Tant és com de superior sigui el model: sempre acabaràs amb resultats subòptims.»
La qualitat del model no substitueix la qualitat del context. I el model mental que cal retenir: «pensa-hi com tenir les idees correctes, els pensaments complets, a cada fragment».
3.4 La simulació, i què demostra i què no
Aquí el curs topa amb una limitació estricta i — cal reconèixer-ho — ho diu en veu alta. L'API d'embeddings d'OpenAI no exposa embeddings a escala de token. Obtens un vector agregat per cadena d'entrada. Per tant, és impossible fer-hi chunking tardà real. Així, l'script simula l'efecte anteposant una cadena de context i tornant a generar l'embedding:
# fcc-production-rag-part-6/03_late_chunking.py — simulate_late_chunking()
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

chunk1 = "Steve Jobs was born in San Francisco in 1955. He was adopted by Paul and Clara Jobs shortly after birth."
chunk2 = "He co-founded Apple Computer in 1976 with Steve Wozniak. The company started in his parents' garage."

query = "What company did Steve Jobs found?"

# Early chunking: embed chunks separately
chunk2_embedding_early = embeddings.embed_query(chunk2)
query_embedding = embeddings.embed_query(query)
similarity_early = np.dot(chunk2_embedding_early, query_embedding)

# Late chunking simulation: embed chunk WITH context prepended
chunk2_with_context = (
    f"[Context: This is about Steve Jobs, founder of Apple] {chunk2}"
)
chunk2_embedding_late = embeddings.embed_query(chunk2_with_context)
similarity_late = np.dot(chunk2_embedding_late, query_embedding)

improvement = ((similarity_late - similarity_early) / similarity_early) * 100
print(f"\nImprovement: {improvement:.1f}%")

print("NOTE: This is a SIMULATION using context prepending.")
print("True late chunking uses token-level embeddings from")
print("models like Jina that support this natively.")
El resultat 06:34:39: 0.6857 → 0.6871, imprès com a Millora: 0.2%.
«Té una petita millora. Tot i així, continua sent una millora del 0.2%.» 06:34:39
(La funció també defineix una cadena document i un chunk1 i no fa servir cap dels dos — són decorat. Només es generen embeddings de chunk2 i query.)
El seu plantejament del guany real, a 06:33:38: la consulta deia «Steve Jobs», no «he» — i la recuperació ha trobat igualment la coincidència perquè el vector del fragment sap que «he» es refereix a Steve Jobs.
3.5 Implementar-ho de debò
show_implementation_options() imprimeix quatre opcions. Dues tenen problemes reals amb les versions actuals de les biblioteques i una no és chunking tardà — per tant, llegeix el codi i després les correccions.
Opció 1 — embeddings de Jina, chunking tardà natiu. Tal com ho imprimeix l'script:
# fcc-production-rag-part-6/03_late_chunking.py — OPTION 1, AS PRINTED (see warning below)
from langchain_community.embeddings import JinaEmbeddings

embeddings = JinaEmbeddings(
    model_name="jina-embeddings-v3",
    late_chunking=True  # Enable late chunking
)
Avantatges: suport natiu, millor qualitat. Inconvenients: model diferent, pot necessitar una clau d'API.
Fixa't també en la restricció que el capítol no exposa mai:
Opció 2 — recuperació contextual (§2 d'aquesta part), reproduïda aquí com a alternativa independent del model: context = generate_context(chunk, full_document), contextualized_chunk = f"{context} {chunk}", generar-ne l'embedding. Avantatges: funciona amb qualsevol model d'embeddings. Inconvenients: cost addicional d'LLM en indexar.
Opció 3 — recuperador de documents pare. El fragment imprès té una importació desactualitzada:
# fcc-production-rag-part-6/03_late_chunking.py — OPTION 3, AS PRINTED. Import is WRONG for LangChain 1.x
from langchain.retrievers import ParentDocumentRetriever
A LangChain 1.2.7, el paquet langchain només exposa agents, chat_models, embeddings, messages, rate_limiters, tools — no hi ha langchain.retrievers. La importació funcional i una construcció funcional provenen de l'altre repositori:
# production-course-main-code/advanced_rag.py — the CORRECT import and a real working setup
from langchain_classic.retrievers import ParentDocumentRetriever
from langchain_classic.storage import InMemoryStore

parent_splitter = RecursiveCharacterTextSplitter(chunk_size=800, chunk_overlap=100)
child_splitter = RecursiveCharacterTextSplitter(chunk_size=200, chunk_overlap=20)

vectorstore = Chroma(
    collection_name="parent_child_demo",
    embedding_function=OpenAIEmbeddings(model="text-embedding-3-small"),
)
store = InMemoryStore()

retriever = ParentDocumentRetriever(
    vectorstore=vectorstore,
    docstore=store,
    child_splitter=child_splitter,
    parent_splitter=parent_splitter,
)

retriever.add_documents([long_doc])

# Search finds a SMALL child chunk...
child_docs = vectorstore.similarity_search(query, k=1)
# ...but the retriever returns the LARGE parent
parent_docs = retriever.invoke(query)
Els fills petits donen coincidències precises; el pare gran dona a l'LLM espai per raonar. La seva descripció 06:37:42: el recuperador recorre la jerarquia pare→fill i retorna el pare, que porta el context més complet. (Ho anomena «arbre»; la implementació de LangChain és realment un magatzem de documents amb l'identificador del pare com a clau, no una estructura d'arbre.)
Opció 4 — solapament + capçaleres de resum. La versió econòmica, i la que ja hauries d'estar aplicant:
# fcc-production-rag-part-6/03_late_chunking.py — OPTION 4
splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=100  # Overlap captures some context
)

# Add document summary to each chunk
for chunk in chunks:
    chunk.page_content = f"[From: {doc_title}] {chunk.page_content}"
Avantatges: simple, sense cost addicional. Inconvenients: preservació limitada del context. Fixa't que això és recuperació contextual amb una plantilla en lloc d'un LLM — introdueix el títol del document al vector de franc, i res més. Val la pena fer-ho des del primer dia de qualsevol projecte, perquè costa donar format a una cadena i resol la meitat del problema corresponent a «quin document?».
4. La taula de resultats: cinc enfocaments i l'argument per combinar-los
4.1 La taula comparativa
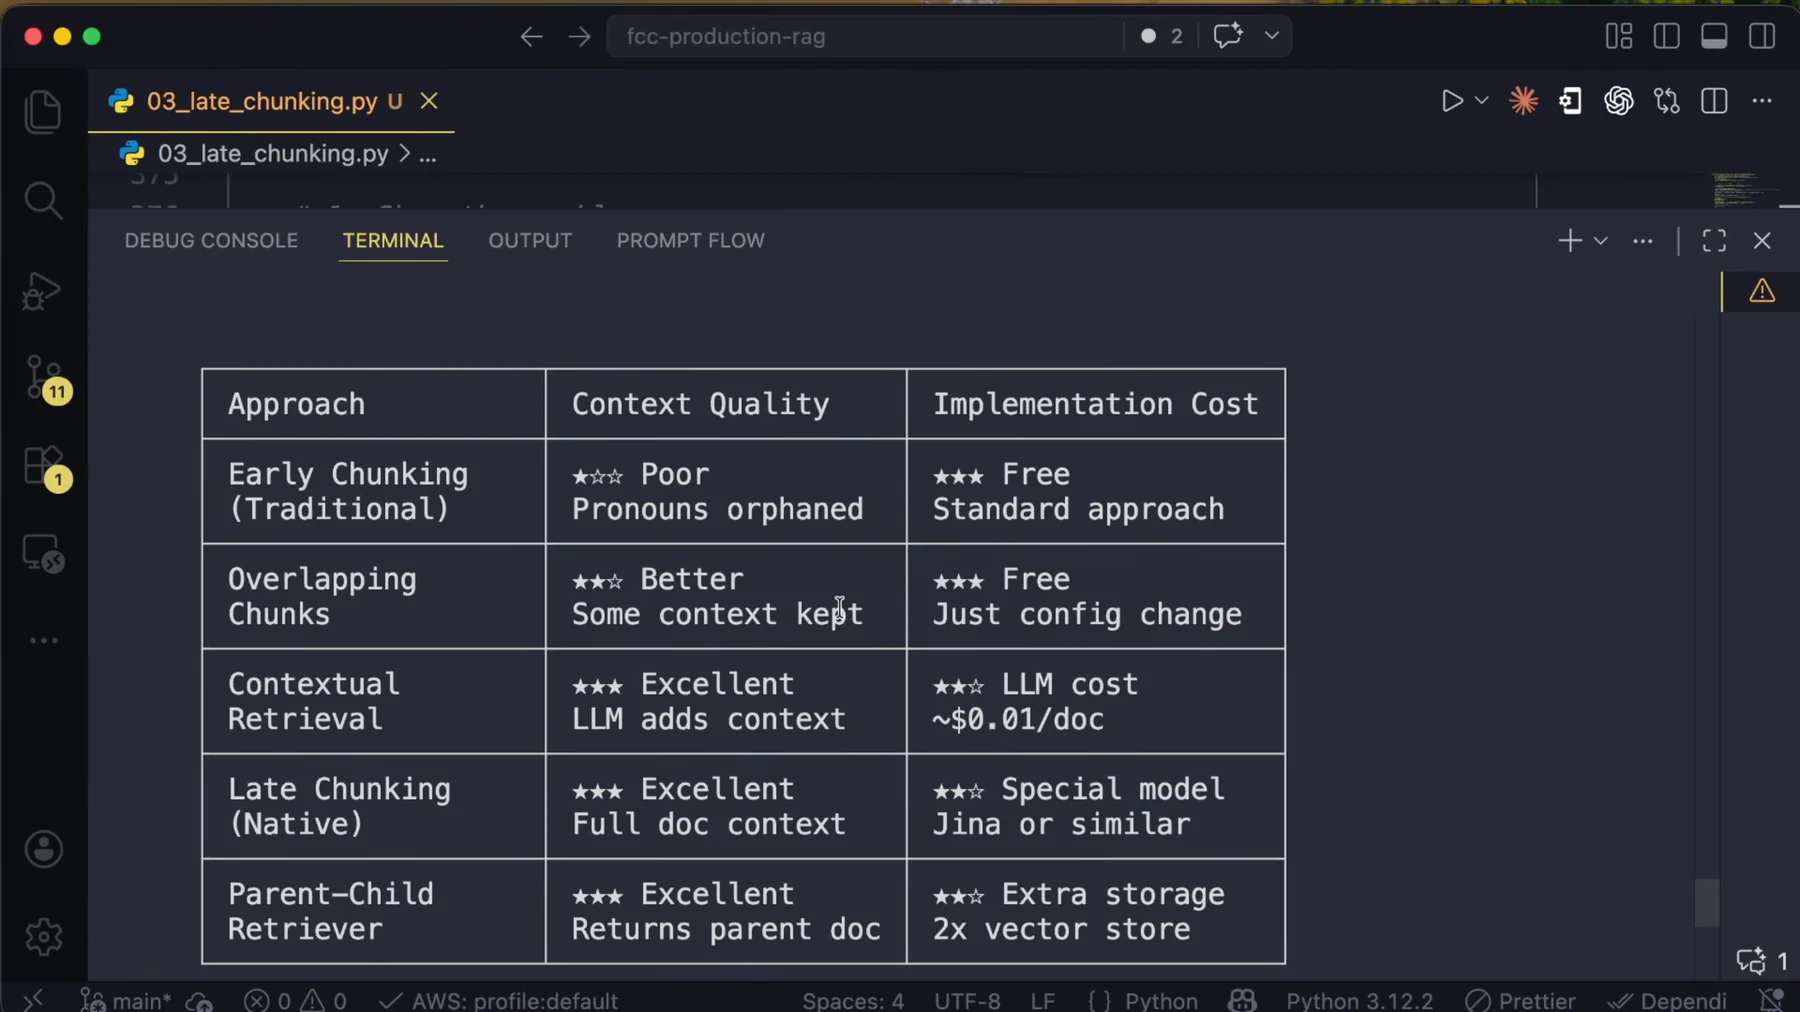
print_comparison(), no una diapositiva — per això la pots reproduir localment amb uv run python 03_late_chunking.py. Llegeix les dues columnes com a qualitat enfront de tipus de cost: les tres últimes files obtenen totes tres estrelles en qualitat i només difereixen en la moneda que et cobren — dòlars per document, dependència d'un model o emmagatzematge.| Enfocament | Qualitat del context | Cost d'implementació |
|---|---|---|
| Chunking primerenc (tradicional) | ★☆☆ Baixa — pronoms orfes | ★★★ Gratuït — enfocament estàndard |
| Fragments solapats | ★★☆ Millor — es conserva part del context | ★★★ Gratuït — només un canvi de configuració |
| Recuperació contextual | ★★★ Excel·lent — l'LLM afegeix context | ★★☆ Cost d'LLM ~$0.01/document |
| Chunking tardà (natiu) | ★★★ Excel·lent — context del document complet | ★★☆ Model especial — Jina o similar |
| Recuperador pare-fill | ★★★ Excel·lent — retorna el document pare | ★★☆ Emmagatzematge addicional — 2× el magatzem vectorial |
La seva explicació d'orfes 06:36:42: «no estan vinculats a un pare… no tenen cap correlació que apunti a l'altra dada amb què estan connectats contextualment». Sobre els fragments solapats: «És millor perquè conservem part del context. El cost d'implementació també és gratuït — només cal configurar unes quantes coses.» Sobre la columna de cost del chunking tardà: el preu és la dependència d'un model, no els dòlars.
4.2 La taula de precisió
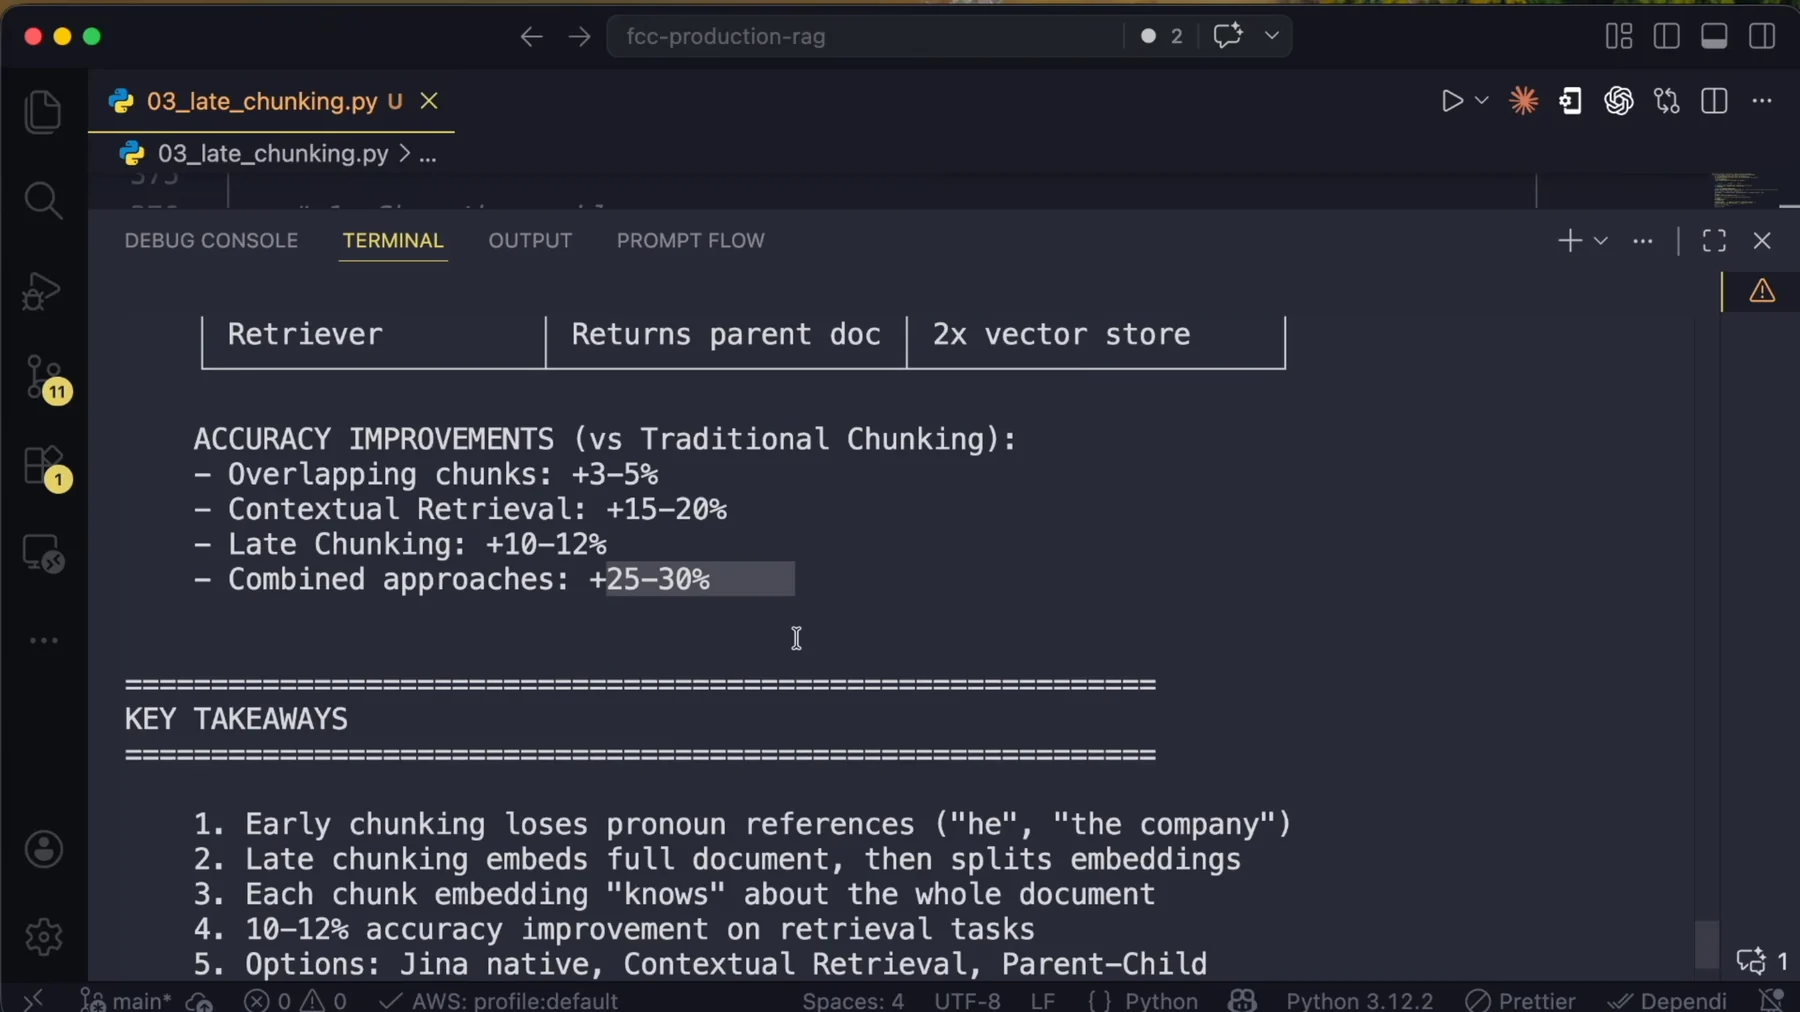
| Tècnica | Millora de precisió respecte del chunking tradicional |
|---|---|
| Fragments solapats | +3–5% |
| Recuperació contextual | +15–20% |
| Chunking tardà | +10–12% |
| Enfocaments combinats | +25–30% |
Fixa't que el +15–20% d'aquí és superior a tot el que el capítol 25 explicava sobre recuperació contextual — les dues lliçons citen mètriques diferents (allà, reducció de fallades de recuperació; aquí, guany de precisió) i no les reconcilien mai. Dues observacions que el curs no fa explícitament i que canvien què hauries de construir:
4.3 Combina, no triïs
«No es tracta simplement de triar una estratègia o un enfocament i tirar-hi endavant.» 06:38:42
06:38:42 La seva idea estratègica: en producció vols adoptar totes aquestes estratègies per acabar amb un sistema híbrid que les faci servir totes. La fila de +25–30% n'és l'argument.
L'ordre de recomanació del mateix codi — l'artefacte més directament aplicable del capítol:
- Comença per la recuperació contextual (lliçó 6.2) — funciona amb qualsevol model d'embeddings.
- Si fas servir Jina, activa el chunking tardà natiu.
- Combina-ho amb el recuperador de documents pare per obtenir els millors resultats.
- Fes servir sempre un solapament significatiu entre fragments (10–20%).
Llegeix-ho com un ordre de construcció, no com un menú. El pas 4 és gratuït i ja l'hauries de tenir de la part 3. El pas 1 és un canvi a la tasca d'indexació. El pas 3 és un canvi al recuperador. El pas 2 és un canvi de proveïdor d'embeddings — el canvi més invasiu de la llista, i per això és condicional i el penúltim.
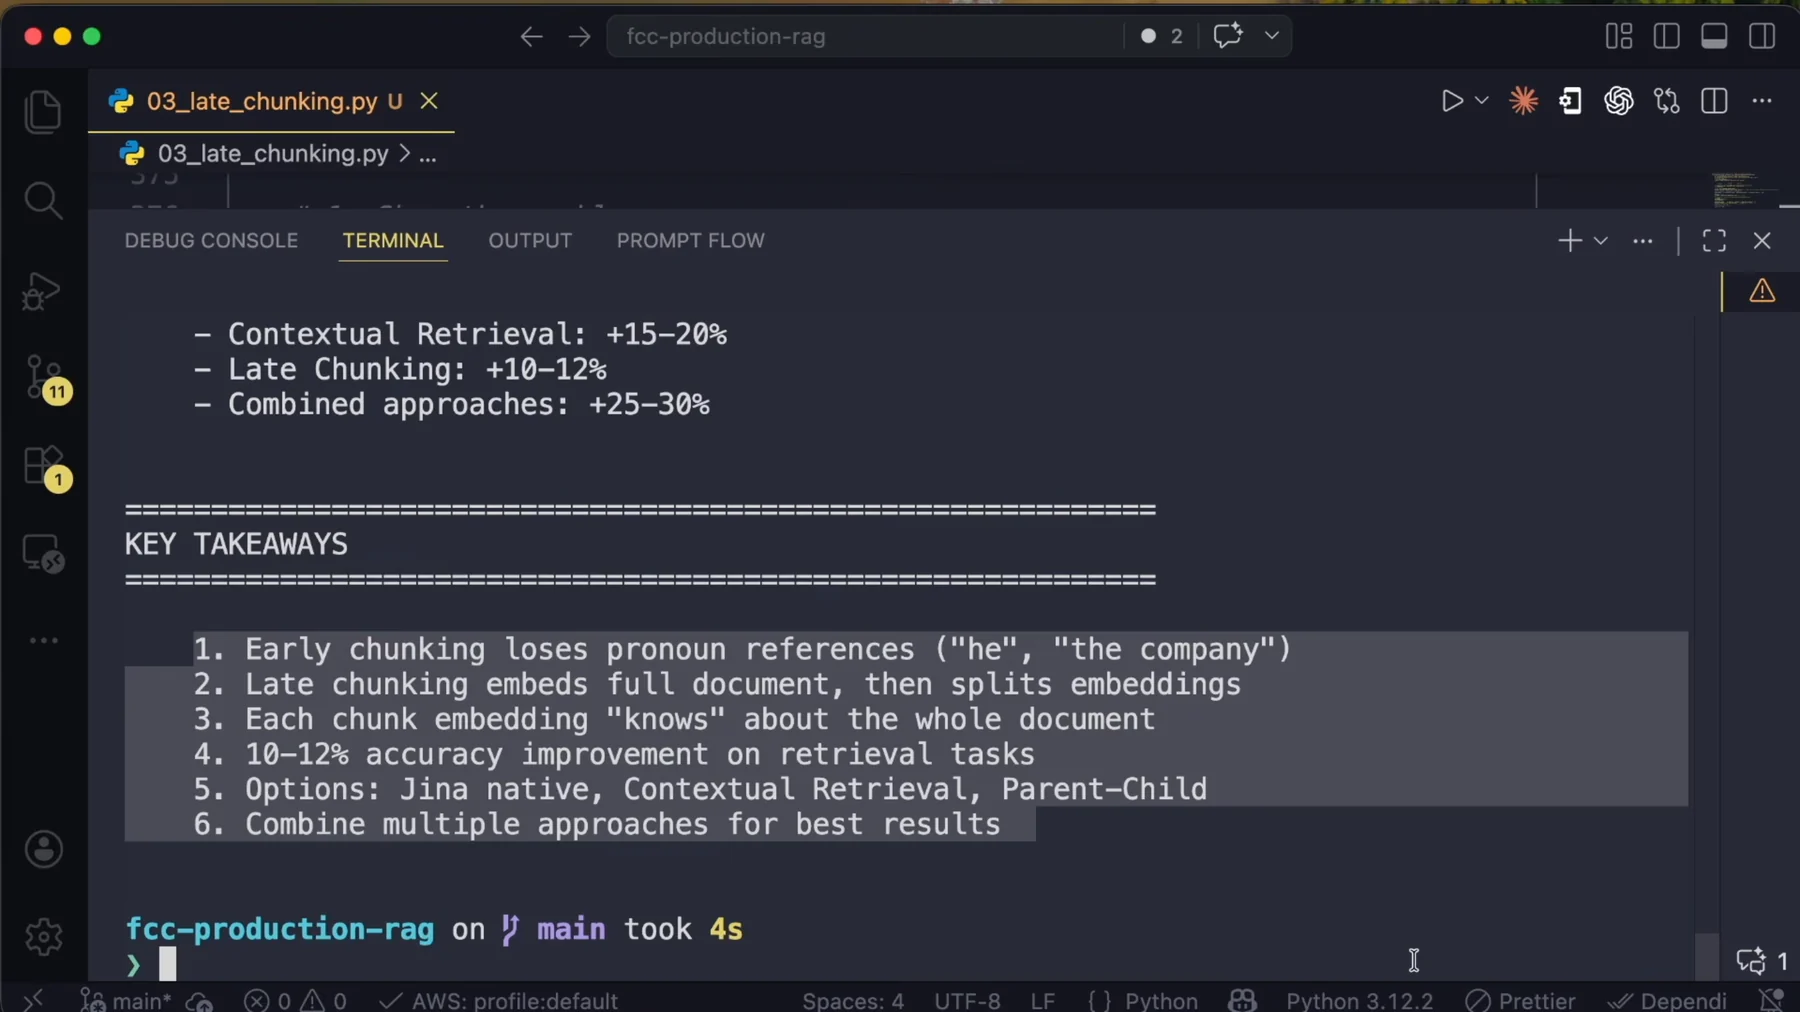
fcc-production-rag on main took 4s — tota aquesta lliçó s'executa en quatre segons perquè només simulate_late_chunking() toca una API. La lliçó anterior de recuperació contextual ha trigat 19s, i aquesta diferència és el perfil de cost de la tècnica en miniatura.Les sis idees clau, literals de la pantalla:
- El chunking primerenc perd les referències pronominals («ell», «l'empresa»).
- El chunking tardà genera els embeddings del document complet i després els divideix.
- Cada embedding de fragment «coneix» tot el document.
- Millora de precisió del 10–12% en tasques de recuperació.
- Opcions: Jina natiu, recuperació contextual, pare-fill.
- Combina diversos enfocaments per obtenir els millors resultats.
4.4 On dona pas al següent tema
El capítol original s'allarga més enllà del seu propi tema: els últims dos minuts i mig del capítol 26 (06:39:44–06:42:04) ja mostren la diapositiva conceptual de RAG amb agents, i es talla a mitja frase — «Quan arriba la consulta, el…» —, que continua al capítol següent. Aquest material correspon a les parts d'agents d'aquesta guia, no aquí, i val la pena retenir l'avanç d'una línia:
«Actualment, RAG en producció no és només un pipeline fix que va d'A a B a C… ara al centre de tot hi ha un agent.» 06:39:44
Tot el que hi ha a la part 14 continua sent un pipeline fix: decideixes en indexar quina tècnica aplicar, i el recorregut de consulta executa els mateixos passos cada vegada. La frontera següent és un bucle de recuperació que avalua els seus propis resultats i torna a consultar quan són dolents — i és cap aquí on va ara la guia.
5. Diagnòstics que pots executar aquesta setmana
Dos procediments, tots dos barats i tots dos amb evidències en lloc de sensacions.
5.1 Compta els orfes del teu propi corpus
Generalitzat a partir de la demostració de Steve Jobs. No costa res — cap crida d'API.
- Divideix un document representatiu amb la configuració del divisor de producció (no amb el
chunk_overlap=0 de la demostració).
- Per a cada fragment, comprova si hi apareix el nom canònic de l'entitat.
- Compta pronoms i referències definides en columnes separades:
he,him,his,she,
her, they, them, it, the company, the report. Fes servir expressions regulars amb límits de paraula, no count(" he ") — consulta l'error de §3.2.
- Qualsevol fragment amb pronoms però sense nom és un fragment que els embeddings no poden trobar pel nom.
A la demostració són 3 de 4. Si és una proporció significativa del corpus, la recuperació contextual s'amortitzarà.
5.2 Simula el benefici abans de comprar un model d'embeddings nou
- Tria un fragment que comenci amb un pronom i una consulta que anomeni l'entitat.
- Genera els embeddings de la consulta i del fragment independent; calcula'n el producte escalar → referència inicial.
- Anteposa-hi una cadena de context d'una línia, torna a generar l'embedding i calcula de nou el producte escalar.
improvement = ((late - early) / early) * 100.- Espera una xifra petita (0.2% a l'execució del curs). Això només demostra la direcció. Si
vols la magnitud, executa una avaluació real de recuperació sobre un conjunt etiquetat de consultes i passatges — la disciplina de mesura de la part 7 —, no el producte escalar d'una sola parella.
5.3 Reprodueix les tres lliçons
cd fcc-production-rag-part-6           # requires OPENAI_API_KEY in .env
uv run python 01_long_context_vs_rag.py   # cost math, latency, framework, hybrid demo
uv run python 02_contextual_retrieval.py  # ~19s, real LLM + embedding calls
uv run python 03_late_chunking.py         # ~4s, three embed_query calls in the simulation
Entorn, a partir de les metadades del repositori i no del README (que afirma Python 3.10+ i s'equivoca): .python-version = 3.13 i pyproject.toml requires-python >= 3.13, fixant langchain>=1.2.0,<2.0.0, langchain-openai>=1.1.0, langchain-chroma>=1.1.0, langchain-text-splitters>=1.1.2, openai>=2.32.0, tiktoken>=0.12.0, networkx, python-dotenv. requirements.txt afegeix allò que omet pyproject.toml — chromadb>=1.5.0, langchain-classic>=1.0.0, langgraph>=1.1.0 — i porta la regla de capçalera «fes servir langchain-chroma, NO langchain-community» per al magatzem vectorial. L'enregistrament mostra Python 3.12.2 a VS Code; per tant, el README, pyproject.toml i l'entorn enregistrat discrepen tots. Confia en pyproject.toml.
6. Decisions que cal prendre
Recorre aquesta llista en ordre. Cada fila és una decisió amb una opció per defecte, no un suggeriment.
| # | Decisió | Opció per defecte / desencadenant |
|---|---|---|
| 1 | RAG o context llarg per a aquest corpus? | Corpus <50K tokens i <100 consultes/dia i preguntes sobre documents sencers → context llarg. Altrament, RAG. Qualsevol cas ambigu → RAG, perquè es degrada de manera gradual a mesura que creix el corpus. |
| 2 | Fes els càlculs d'escala abans de comprometre-t'hi. | Calcula el cost/consulta i després ×volum×30. Si la diferència mensual és menor que una hora d'enginyeria, tots dos dissenys van bé; quan deixa de ser-ho, l'arquitectura és una decisió financera, no de gust. |
| 3 | Pressuposta segons el límit de context *efectiu*. | 60–70% de la finestra anunciada. En un model d'1M, planifica per a 600–700K. |
| 4 | Afegeix el patró de selector híbrid. | Si els usuaris fan preguntes sobre el document sencer d'un document entre molts: recuperació k=1 → carregar el document complet → respondre. El gran guany més barat d'aquesta part. |
| 5 | Executa el recompte d'orfes (§5.1). | Si una minoria considerable de fragments conté pronoms sense el seu referent, activa la recuperació contextual. Mesura'n la proporció; no l'endevinis. |
| 6 | Activa la recuperació contextual si es compleix qualsevol desencadenant. | Context a capçaleres o títols · entitats referenciades amb pronoms · corpus de diverses fonts. |
| 7 | Pressuposta la contextualització honestament. | $0.01–$0.05/document és un mínim. Cost real ≈ fragments × longitud del document en tokens d'entrada. Afegeix memòria cau de prompts i API per lots abans d'executar-ho sobre un corpus gran — el curs no cobreix cap de les dues coses. |
| 8 | Fes la contextualització asíncrona. | 1–2 s/fragment. Posa-la en una cua. No l'executis mai directament dins d'una petició de càrrega. |
| 9 | Persisteix original_chunk i context_prefix a les metadades. | Genera l'embedding del text contextualitzat, cita l'original, audita el prefix. No és negociable. |
| 10 | Defineix title o source a cada document carregat. | create_contextual_chunks() recorre a la cadena literal «Unknown Document» i genera tots els prefixos a partir d'ella. Silenciós, i enverina tot l'índex. |
| 11 | Indexa també el text contextualitzat a BM25. | Idea clau #6. La xifra del 49% d'Anthropic correspon a embeddings + BM25 contextual, no a embeddings sols. |
| 12 | Preveu un creixement dels fragments del 20–30%. | L'impacte en l'emmagatzematge és mínim; en el prompt, no. Una recuperació dels primers 5 resultats ara introdueix ~25% més de text a cada prompt de resposta. Revisa el pressupost de tokens de la part 9. |
| 13 | Chunking tardà: només amb un model que l'admeti realment. | Verifica que el cos de la petició contingui realment late_chunking. L'embolcall comunitari de LangChain el descarta silenciosament. |
| 14 | Comprova que els documents càpiguen a la finestra del model d'embeddings. | El chunking tardà necessita el document sencer en una passada endavant. Llegeix la fitxa del model per saber el límit real; més enllà, tornes a segmentar i a triar límits de segments. |
| 15 | Afegeix pare-fill damunt de l'opció que hagis triat. | Resol un eix diferent (què es retorna) i costa 2× d'emmagatzematge vectorial. Fes servir langchain_classic.retrievers, no langchain.retrievers. |
| 16 | Mantén sempre un solapament entre fragments del 10–20%. | +3–5% amb un canvi de configuració. No hi ha cap argument en contra. |
| 17 | Mesura les teves pròpies xifres. | Totes les xifres d'aquesta part — 1,200×, 25×, 49%, 67%, +10–12%, +15–20%, +25–30% — són orientatives. «Només són proves comparatives. Per tant, ho heu de provar vosaltres.» 06:24:26 |
Les tres tècniques d'aquesta part compren el mateix: un fragment que es pugui trobar amb una pregunta formulada com la formularia una persona. El context llarg ho compra sense dividir mai. La recuperació contextual, escrivint-hi les paraules que falten. El chunking tardà, generant els embeddings abans de dividir. Tria pel cost i les restriccions, no per la novetat — i recorda que l'opció gratuïta i avorrida, el solapament del 10–20%, ja és a la taula de resultats.