
Observabilidad: traces, métricas y evals
Tracing, métricas y evals: el marco alrededor del pipeline que no cambia nada y lo revela todo.
Todas las demás partes de esta guía cambian una caja dentro del pipeline. Esta construye el marco que la rodea.
En el modelo mental de la Parte 1, la observabilidad es la banda dibujada alrededor de ambas fases:
ASCII original
        ┌──────────────────────────────────────────────────────────┐
        │  OBSERVABILITY  (traces · metrics · evals · JSON logs)    │
        │  wraps everything, changes nothing            ch12,13,19  │
        └──────────────────────────────────────────────────────────┘
Está colocada aquí a propósito, antes de las partes de escalado y coste, y ese orden es una corrección al curso original, que la enseña más tarde. La razón es sencilla: cada disparador de las partes que siguen es una medición. «Escala cuando la latencia p95 del retrieval supere los 100 ms.» «Enruta a un modelo más barato cuando la pregunta sea trivial.» «Añade una cache cuando la tasa de aciertos superaría X.» Ninguna de esas frases significa nada para un equipo que no puede ver un p95, un coste por query o una tasa de aciertos. Enseñar optimización antes que instrumentación le da al lector umbrales que no tiene forma de evaluar.
Esta parte es también donde el invariante 4 (los fallos son silenciosos) y el invariante 6 (la monitorización observa y nunca debe cambiar el comportamiento) reciben su tratamiento completo. Son la misma idea vista desde dos extremos: como nada lanza excepciones, tienes que añadir los ojos tú mismo; y como los ojos son aditivos, nunca deben formar parte del flujo de control.
Una nota de enfoque antes de empezar. El material original narra todo este módulo en términos de un sistema de investigación multiagente con LangGraph —supervisores, handoffs, agentes en paralelo, equipos jerárquicos, bucles de calidad—, no de un retriever. Ese segmento está sacado del material de LangChain/LangGraph del instructor y metido en un curso de RAG. Todos los argumentos siguen siendo válidos, porque retrieve → filter → rerank → assemble → generate no es más que otro grafo de varios pasos con las mismas propiedades: múltiples puntos candidatos de fallo, ninguna excepción, corrupción en cascada. Pero cuando el original dice «qué agente falló», lee «qué etapa falló»; los ejemplos de esta parte traducen el vocabulario de agentes al vocabulario de RAG allí donde importa.
La caja negra que acabas de poner en producción
El escenario con el que abre el original no es, a propósito, «tu código está roto» 02:21:11. El código funciona. El grafo se ejecuta de principio a fin. Los supervisores despachan, los agentes devuelven resultados, el informe se escribe. Y aun así no puedes explicar ni una sola respuesta incorrecta.
El instructor plantea una pregunta de culpa a tres bandas: cuando el resultado es incorrecto, ¿fue el investigador que encontró datos malos, el redactor que los malinterpretó o el supervisor que enrutó al departamento equivocado? No puedes saberlo por el resultado. Ese es todo el problema, dicho en una frase:
«Tu sistema es una caja negra. Metes una pregunta, sale una respuesta y, si algo va mal, estás adivinando.» 02:21:11
Compáralo con el ciclo de depuración que ya conoces. Software tradicional: bug → stack trace → «el problema está en la línea 47» → lo arreglas → listo. El original lo llama «un camino claro». El software con LLM te da un párrafo malo y nada más.
«No hay stack trace para las respuestas malas.» 02:22:12
Y «basta con leer el código» no escala, porque el número de puntos candidatos de fallo crece con el grafo. El sistema de ejemplo tiene 5+ nodos, 3 agentes en paralelo, bucles de calidad y 8+ llamadas al LLM por ejecución 02:22:12. Cuando el informe final es incorrecto, ¿cuál de esas ocho o más llamadas produjo el primer token erróneo? Ninguna se anuncia.
La traducción a RAG es exacta. Una sola query en producción pasa por: el reescritor de queries, la llamada de embedding, la búsqueda vectorial, la rama BM25, el paso de fusión, el filtro de metadatos, el reranker, el ensamblador de contexto y el generador. Son nueve lugares donde puede nacer una respuesta incorrecta, y ocho de ellos devolverán tan tranquilos un resultado sintácticamente perfecto que es semánticamente erróneo.
Sin instrumentación, el procedimiento de diagnóstico que tienes a tu alcance es este, y el original lo enumera en orden precisamente para que te reconozcas en él:
- Lee el resultado final.
- Decide que está mal.
- Adivina qué componente lo causó.
- Vuelve a ejecutarlo y reza para que se reproduzca.
«Eso no es ingeniería. Eso es pura esperanza.» 02:24:17
Por qué depurar LLM es difícil: las cuatro razones estructurales
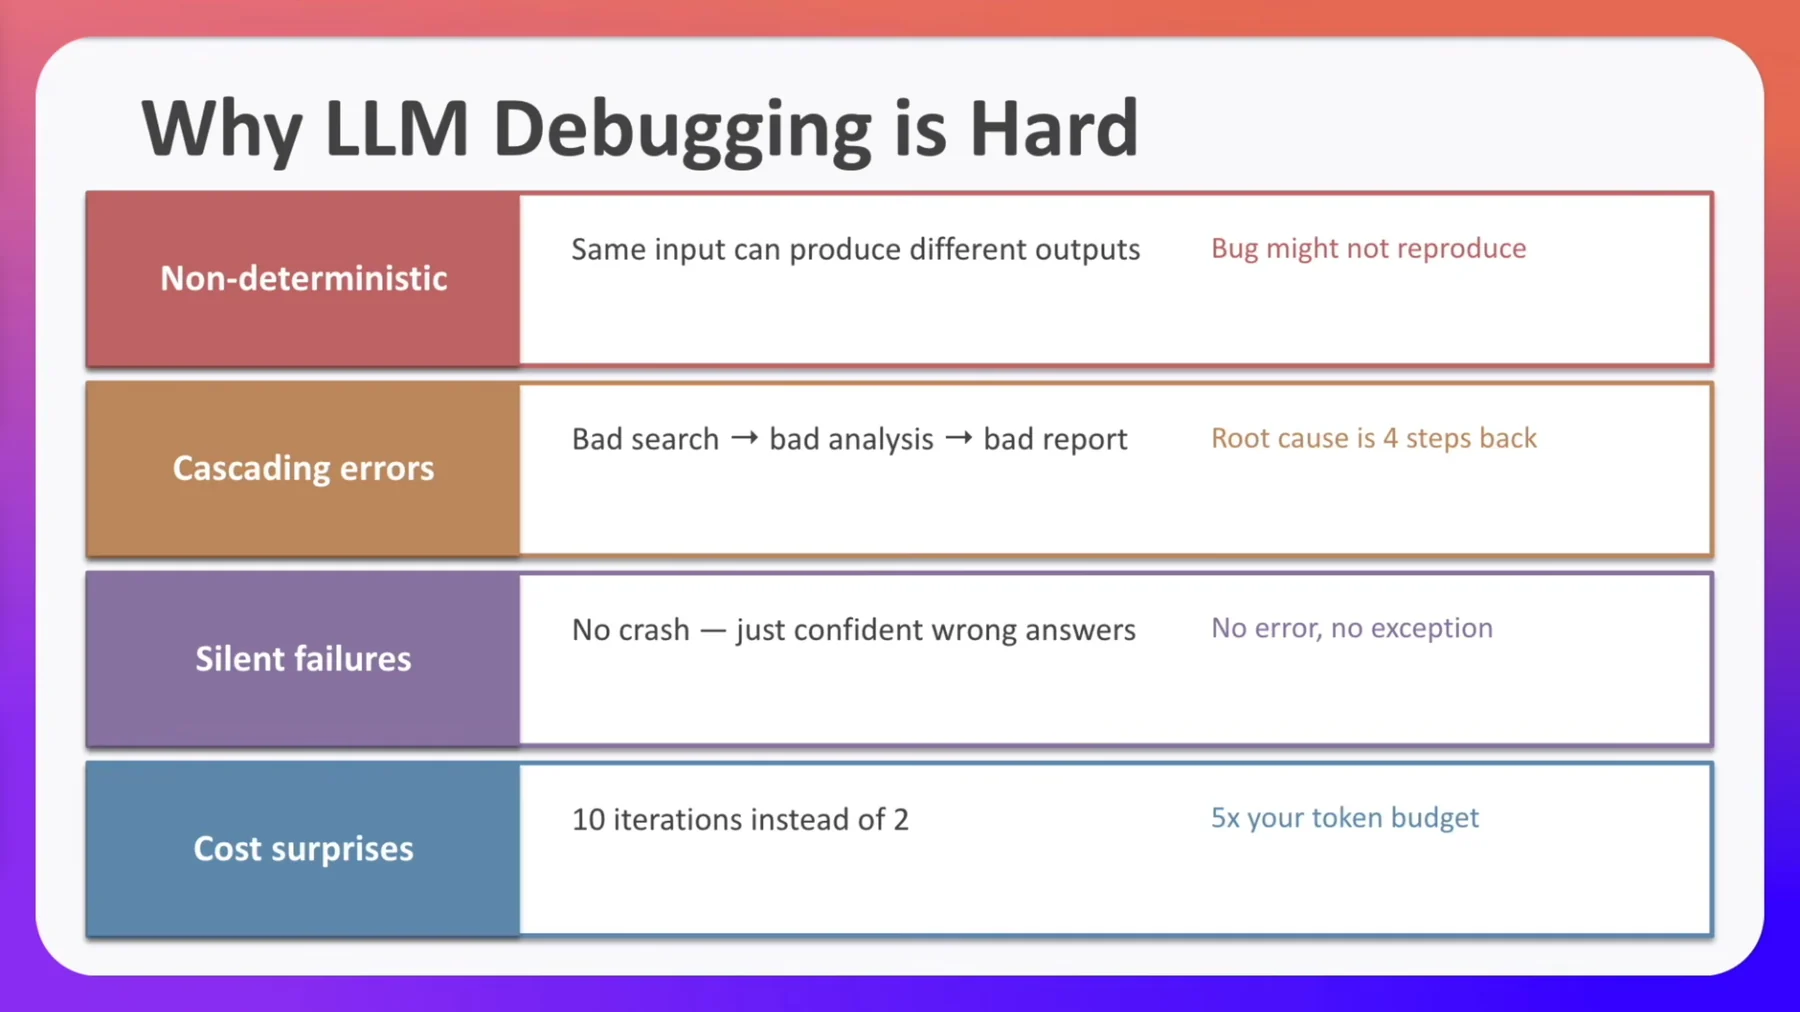
La diapositiva es la columna vertebral conceptual de esta parte 02:22:12–02:24:17. Aquí la tienes con la traducción a RAG añadida, porque el original solo da la versión de agentes.
| Razón | Planteamiento del original | Consecuencia (diapositiva) | Cómo se ve en RAG |
|---|---|---|---|
| No determinista | La misma entrada puede producir salidas distintas | «Puede que el bug no se reproduzca» | Dos preguntas idénticas devuelven respuestas distintas; un chunk que ayer quedaba 3.º hoy queda 11.º tras reconstruir el índice |
| Errores en cascada | Búsqueda mala → análisis malo → informe malo | «La causa raíz está 4 pasos atrás» | Chunking malo → embedding malo → top-k erróneo → respuesta errónea y segura de sí misma. Parece que el generador está roto; lo que está roto es el splitter |
| Fallos silenciosos | Sin caída, solo respuestas erróneas dichas con seguridad | «Ni error ni excepción» | similarity_search devuelve 5 documentos, todos irrelevantes, HTTP 200, cero excepciones |
| Sorpresas de coste | 10 iteraciones en lugar de 2 | «5x tu presupuesto de tokens» | Un retriever que devuelve 20 chunks en lugar de 5 cuadruplica los tokens del prompt en cada request, para siempre |
Dos de ellas merecen desarrollarse más allá de la diapositiva.
El no determinismo te quita tu palanca principal. El original deja claro que volver a preguntar no es una técnica de depuración: la variación es precisamente para lo que sirve el modelo, así que una segunda ejecución no te dice nada sobre la primera:
«Ese no es el propósito de los grandes modelos de lenguaje.» 02:23:14
El no determinismo es una característica del medio y, al mismo tiempo, lo que destruye el workflow de reproducir y luego arreglar. Fijar temperature=0 reduce la varianza —por eso los dos ficheros de observabilidad de esta parte, langsmith_setup.py y monitoring.py, lo fijan—, pero no hace que el sistema sea determinista de extremo a extremo, porque el retrieval, el desempate, el estado del índice y el enrutamiento del lado del proveedor se mueven por debajo de ti.
Las sorpresas de coste son bugs de flujo de control disfrazados de factura. Un bucle de supervisor que ejecuta 10 iteraciones en lugar de 2 quema 5× el presupuesto de tokens previsto 02:24:17. Nada da error, nada es lo bastante lento como para notarse y el sobrecoste es proporcional a tu tráfico: cuanto mejor le va a tu funcionalidad, mayor es la factura que acaba sacándolo a la luz.
Qué es realmente la observabilidad
La definición que da el original 02:24:17 es la clásica de la teoría de control, sin cambios:
«La observabilidad es la capacidad de entender qué está haciendo tu sistema internamente observando sus salidas.» 02:24:17
El giro específico de los LLM está en el matiz que añade la diapositiva: todo el recorrido, no solo la respuesta final. Las «salidas» que instrumentas son registros por paso, no el cuerpo de la respuesta. Si la única salida que puedes ver es lo que ve el usuario, no eres observable: solo estás leyendo el mismo párrafo del que el usuario ya se ha quejado.
El capítulo 19 da una versión más directa y operativa de la misma definición 04:04:43: la observabilidad es «una forma de mirar con atención dentro de nuestros workflows y ver los logs y todo eso». La misma idea, empezando por la fontanería. Y arranca con el fallo que existe para detectar: las llamadas a la API se ven pasar, el tráfico fluye, vuelven 200 y eso no te dice nada sobre si las respuestas son correctas, si el retrieval está recuperando de verdad o si el modelo está alucinando. Estar en marcha no es ser correcto.
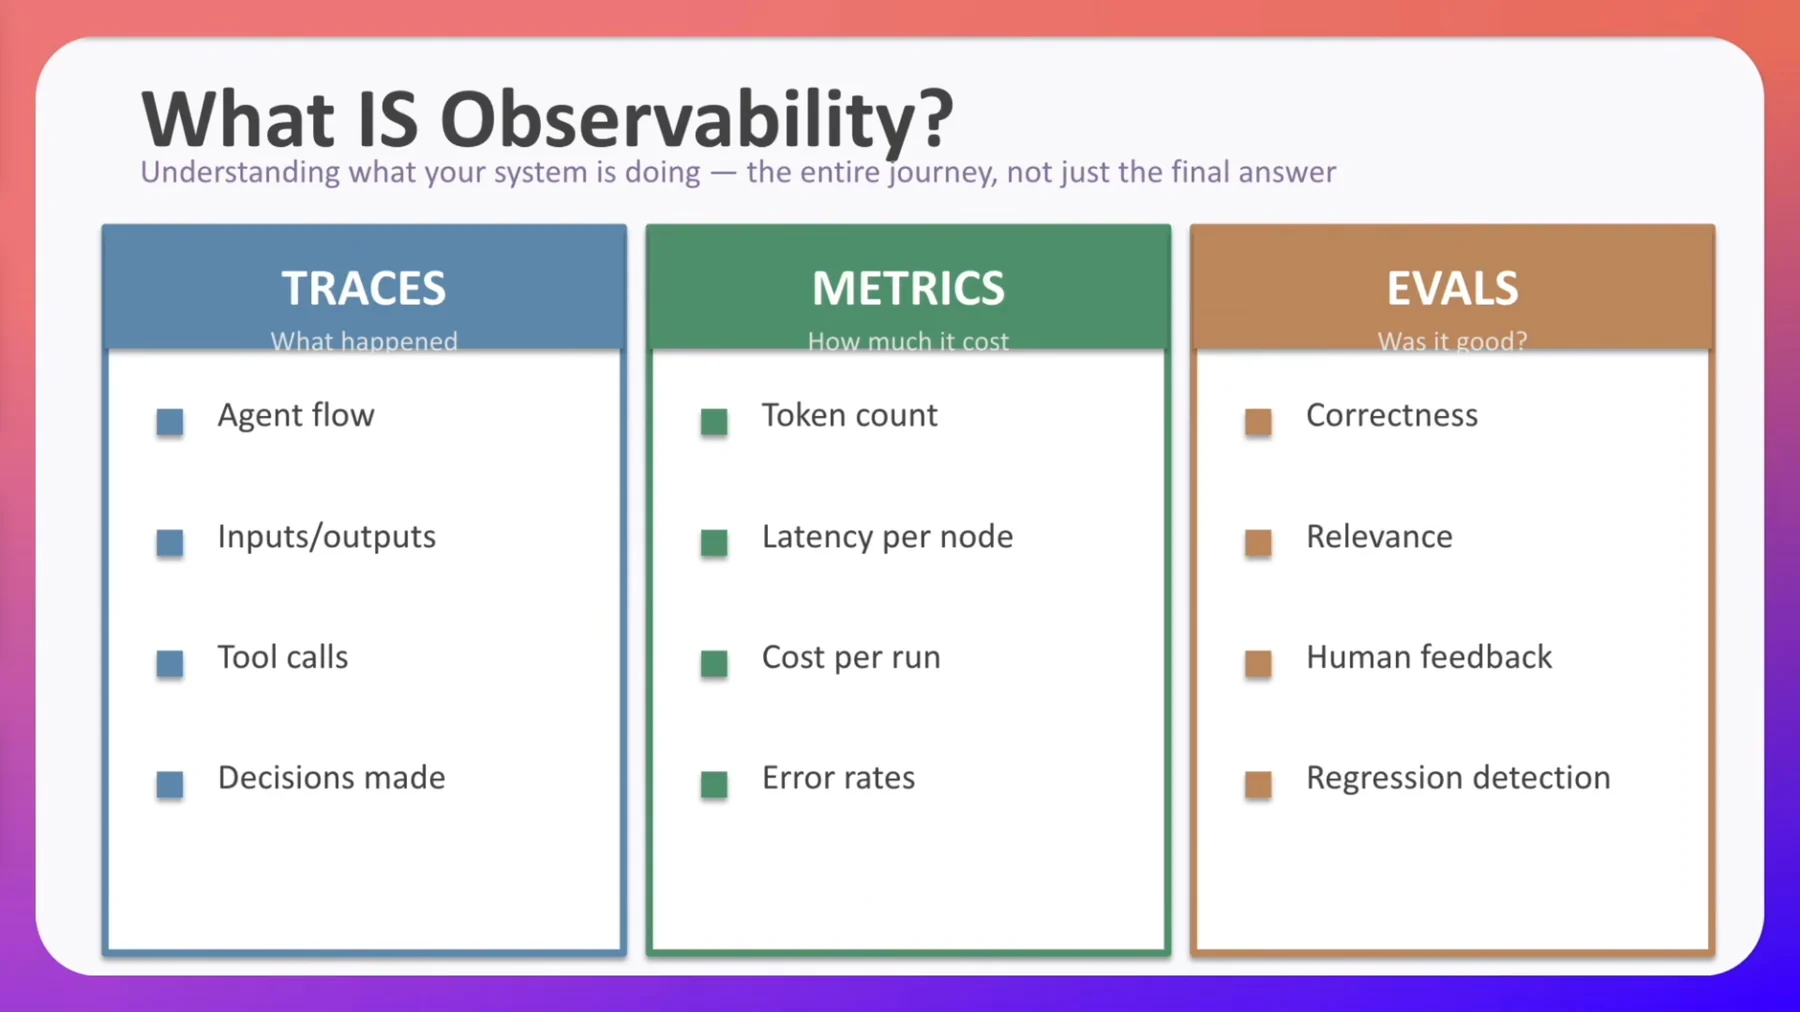
| Pilar | La pregunta que responde | Qué contiene (literal de la diapositiva) |
|---|---|---|
| TRACES | «Qué pasó» | Flujo de agentes · Entradas/salidas · Llamadas a herramientas · Decisiones tomadas |
| METRICS | «Cuánto costó» | Número de tokens · Latencia por nodo · Coste por ejecución · Tasas de error |
| EVALS | «¿Estuvo bien?» | Corrección · Relevancia · Feedback humano · Detección de regresiones |
Los tres pilares no son intercambiables, y la forma más clara de verlo es mapearlos sobre las cuatro razones de fallo de arriba:
| Razón de fallo | Pilar que lo detecta | Por qué los otros dos no |
|---|---|---|
| Errores en cascada | Traces | Las métricas muestran que la ejecución tuvo un coste normal; las evals muestran que la respuesta era mala, pero no dónde |
| Sorpresas de coste | Métricas | Los traces muestran un bucle de aspecto válido; las evals puede que incluso puntúen bien la salida |
| Fallos silenciosos | Evals | Tanto los traces como las métricas parecen perfectamente sanos: esa es la definición de silencioso |
| No determinismo | Los tres, a lo largo del tiempo | Una sola ejecución no te dice nada; necesitas la distribución |
Qué captura realmente un trace
Un trace mira «cada paso, cada entrada, cada salida, cada milisegundo» de la ejecución 02:25:18. El original recorre uno completo para el pipeline de investigación multiagente:
- El supervisor planifica 3 queries
- Búsqueda 1 → 3 hallazgos
- Búsqueda 2 → 2 hallazgos
- Búsqueda 3 → 3 hallazgos
- El analista sintetiza
- El redactor escribe un borrador
- Puntuación de calidad = 0.6 → se dispara una revisión
- Puntuación revisada = 0.88 → aprobado, la ejecución termina
Esa es la forma de multi_agent_research_system.py en el repo, nodo por nodo, y la correspondencia se puede comprobar en vez de darse por sentada: el fichero registra exactamente cinco nodos (supervisor, search_agent, analyst, report_writer, quality_checker), su prompt de supervisor pide «exactamente 3» queries de búsqueda, las reparte mediante la API Send de LangGraph para que las tres búsquedas se ejecuten en paralelo, y a cada agente de búsqueda se le pide que devuelva «2-3 hallazgos clave». El trace narrado es ese grafo ejecutándose una vez.
Después el original hace zoom en un nodo —«Search Agent 1»— y lee el span campo a campo 02:26:20:
| Campo del span | Valor mostrado |
|---|---|
| Entrada | la query de búsqueda |
| Herramienta | se llamó a web_search |
| Latencia | 1.2 segundos para la llamada a la herramienta |
| Salida | 3 resultados con resumen |
| Tokens | entrada 45, salida 890 |
| Coste | se muestra en pantalla, no se lee en voz alta |
Dos notas de honestidad sobre esa tabla, porque el original no señala ninguna de las dos.
El argumento de la recompensa es breve y correcto 02:26:20. Una vez que tienes entrada, herramienta, latencia, tokens y coste por nodo, puedes (1) ahorrar dinero, (2) fiarte de tu propio sistema y (3) saber exactamente cuándo intervenir.
«No vuelas a ciegas. Vuelas con datos.» 02:26:20
Cómo leer un trace cuando algo va mal. Este es el procedimiento que sustituye al stack trace, y merece la pena memorizarlo porque no es obvio:
- Abre la ejecución de nivel superior (el grafo entero / la request entera).
- Despliega nodo a nodo en orden de ejecución.
- En cada nodo lee: entrada, herramienta llamada, latencia, salida, tokens de entrada, tokens de salida, coste.
- Compara la salida de cada nodo con lo que necesitaba el nodo siguiente.
- El primer desajuste es el defecto. Detente ahí. No sigas avanzando hasta el nodo que
produjo el síntoma visible: con errores en cascada, ese nodo está cuatro pasos aguas abajo del bug real y se está comportando correctamente dada la basura que recibe.
En una request de RAG, el paso 4 tiene una forma concreta. Esto es lo que debes mirar, etapa a etapa; es la traducción a RAG del recorrido nodo a nodo del original, y es lo más útil que puedes interiorizar de esta sección:
| Etapa | La pregunta que le haces a su span | Cómo se ve «aquí ya está mal» |
|---|---|---|
| Reescritura / expansión de la query | ¿La query reescrita sigue significando lo que preguntó el usuario? | «¿Cómo cancelo?» se convirtió en silencio en «¿Cómo borro mi cuenta?» |
| Embedding de la query | ¿Es el mismo modelo y la misma versión que se usó al indexar? | Nada visible: es el fallo que no tiene síntomas hasta que el recall se desploma (invariante 2) |
| Búsqueda vectorial | ¿Cuáles son los ids y scores del top-k? | El mejor score es 1.34 y lo estás tratando como una similitud (la trampa de distancia frente a similitud de la Parte 4) |
| Filtro de metadatos | ¿Cuántos sobrevivieron al filtro? | Pides k=5 y vuelven 4, o cero. k es un techo, no una cuota, y el código posterior que asuma lo contrario se rompe |
| Fusión / rerank | ¿El chunk correcto subió o bajó? | El chunk correcto estaba en la posición 7 antes del rerank y en la 9 después: tu reranker te está perjudicando |
| Ensamblado del contexto | ¿Cuántos tokens entraron en el prompt y se truncó algo? | El chunk que contenía la respuesta fue justo el que se cortó |
| Generación | ¿La respuesta está respaldada por el contexto que tiene encima? | Fluida, segura y ausente del contexto: alucinación |
Si tu trace no te permite responder a esas siete preguntas, todavía no está instrumentado con suficiente profundidad.
Por qué ahora, y no después del incendio
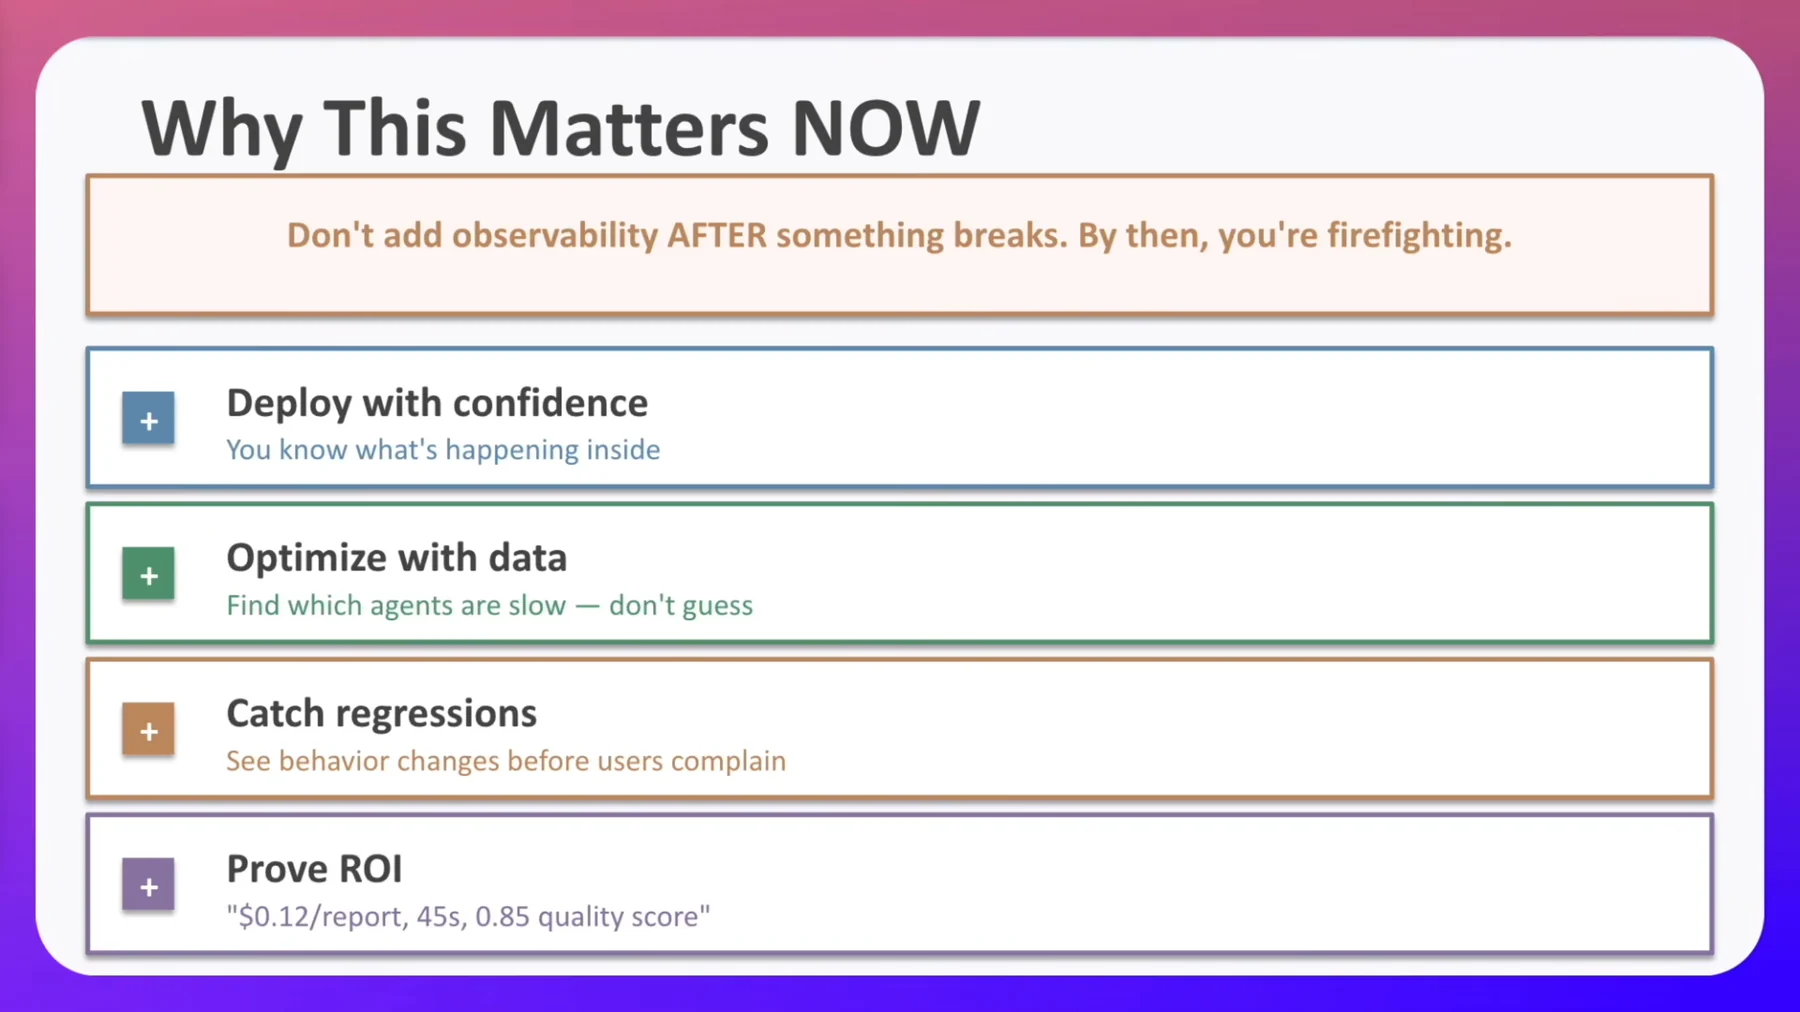
El error que nombra el original 02:27:22 es que la mayoría de desarrolladores creen que la observabilidad es algo que se añade después de que algo se rompa. Para entonces:
«Estás apagando incendios. Solo estás apagando fuegos. No estás haciendo ingeniería de verdad.» 02:27:22
Los cuatro beneficios de la diapositiva, con las cifras intactas:
- Haz deploy con confianza: «sabes lo que está pasando dentro».
- Optimiza con datos: «no con esperanzas ni con impresiones». En concreto: averigua qué etapas
son lentas y luego elimínalas o arréglalas. La diapositiva lo formula así: «Find which agents are slow — don't guess» (averigua qué agentes son lentos, no lo adivines).
- Detecta regresiones: «Ve los cambios de comportamiento antes de que los usuarios se quejen.»
- Demuestra el ROI: cítale
$0.12/report, 45s, 0.85 quality scorea tu dirección. El
instructor es explícito sobre el público: «puedes dárselo a tus managers o a tus superiores».
Ese cuarto beneficio está infravalorado por los ingenieros y es la razón por la que la observabilidad sobrevive a la revisión de presupuesto. Una funcionalidad con LLM sin instrumentación no puede responder a «¿cuánto cuesta esto por unidad de valor?», y una funcionalidad que no puede responder a esa pregunta es una funcionalidad que se recorta cuando llega la factura de la API.
El bucle de la sorpresa de coste, en código
El aviso de «10 iteraciones en lugar de 2 = 5× el presupuesto de tokens» no es hipotético, y la solución es una cláusula extra en el propio sistema de investigación del repo. Así es un bucle acotado:
# /home/oriol/lab/rag/code/production-course-main-code/multi_agent_research_system.py
def quality_gate(state: ResearchState) -> Literal["report_writer", "end"]:
    """Route back to writer if quality is insufficient."""
    if state["quality_score"] >= 0.7 or state["iteration"] >= 2:
        return "end"
    return "report_writer"
Dos condiciones de salida independientes: un umbral de calidad de 0.7 y un tope estricto de 2 iteraciones. El umbral es el que quieres que salte; el tope es el que te salva cuando el umbral no salta nunca. El mismo fichero lo refuerza por partida doble dentro del propio nodo verificador:
# /home/oriol/lab/rag/code/production-course-main-code/multi_agent_research_system.py
# Force approve after 2 iterations to prevent infinite loops
approved = review.approved or state["iteration"] >= 2
Ese es todo el contenido de la lección sobre sorpresas de coste expresado como código, y se generaliza directamente a RAG: cualquier bucle de retrieval que se autocorrige (retrieve → grade → rewrite → volver a hacer retrieve, el patrón de agentic RAG de la Parte 15) necesita la misma segunda condición de salida. La salida basada en calidad es una heurística, y las heurísticas fallan; el contador no.
LangSmith: tracing (casi) sin cambios de código
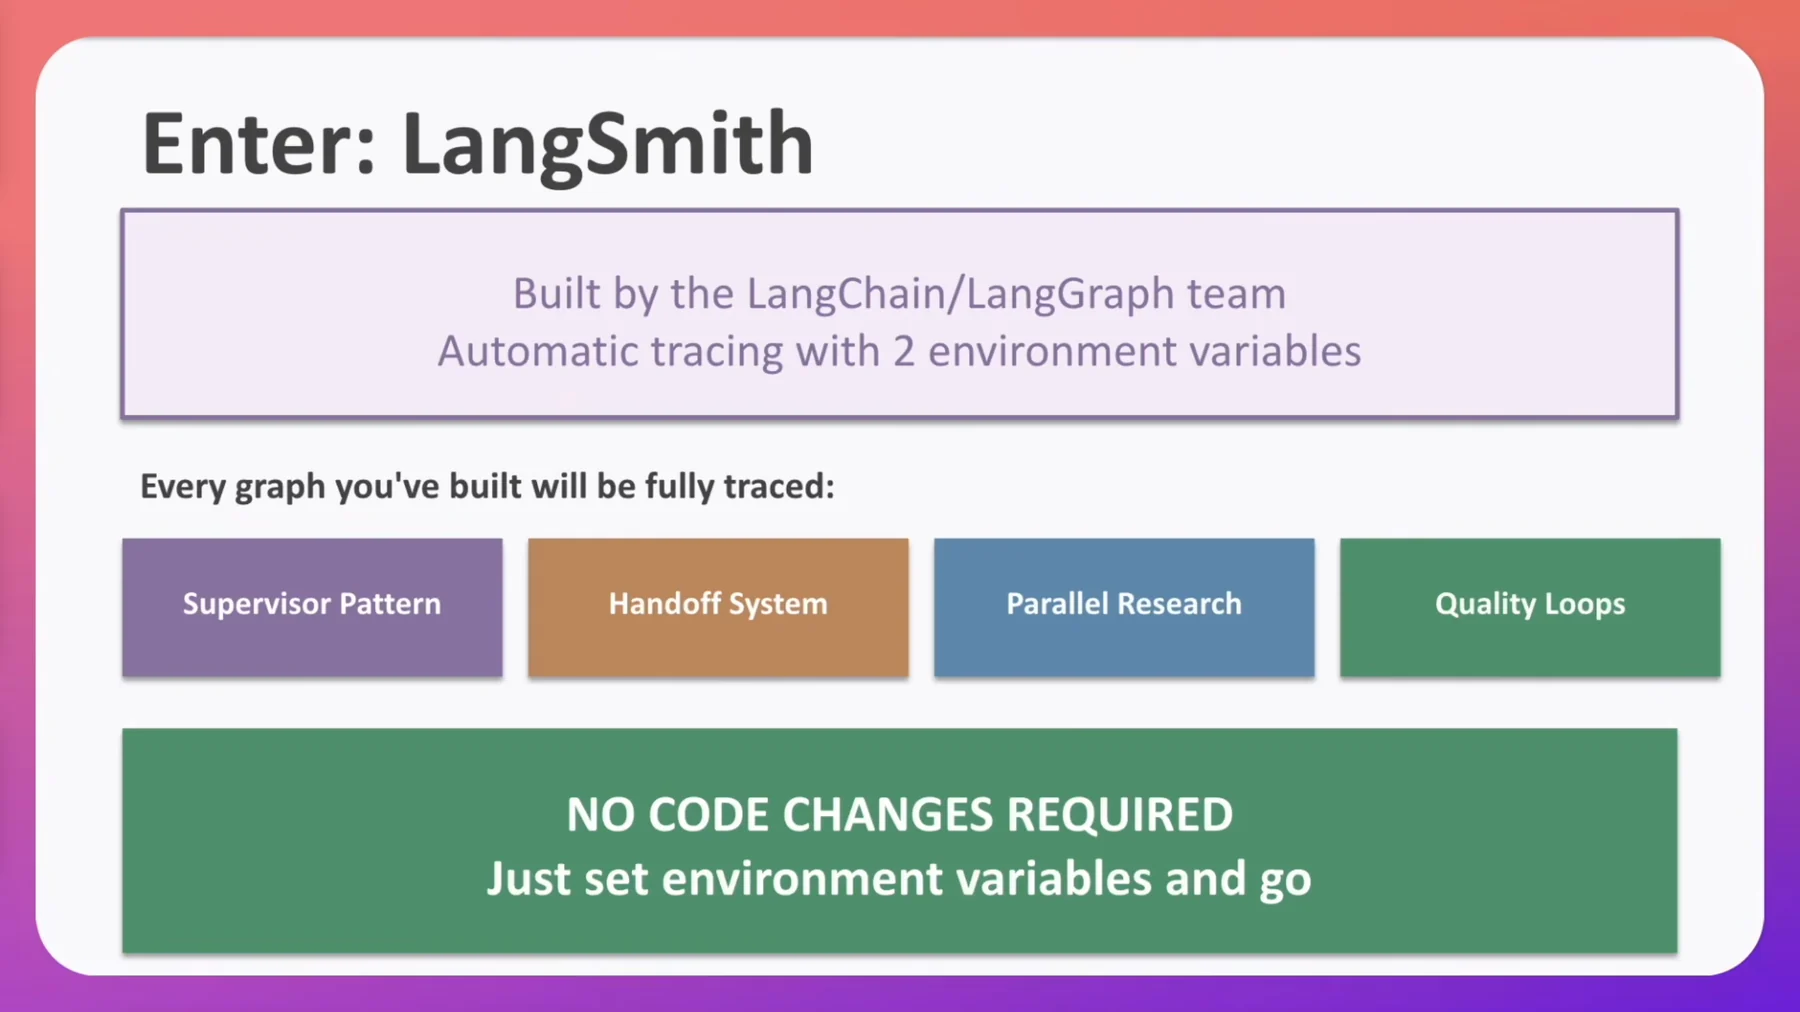
@traceable. Las dos mitades de esa distinción importan cuando estimas el trabajo.Hay muchas herramientas de observabilidad. El original elige LangSmith por tres razones declaradas 02:28:22: es más fácil, lo construye el equipo de LangChain/LangGraph y puede trazar sistemas enteros con dos variables de entorno. El capítulo 13 añade el posicionamiento del propio proveedor: LangSmith es «una plataforma agnóstica de framework para desarrollar, depurar y desplegar agentes de IA y aplicaciones con LLM» 02:29:56. No necesitas estar en LangChain para usarlo; simplemente tienes el camino más cómodo si lo estás, y la página de primeros pasos se ramifica por framework para que elijas la integración que encaja con el stack que ya usas.
La diapositiva dimensiona la ventaja con cuatro cajas bajo el titular «Every graph you've built will be fully traced» (cada grafo que has construido quedará trazado por completo): Supervisor Pattern, Handoff System, Parallel Research, Quality Loops. Lee el equivalente en RAG: cada chain LCEL, cada retriever, cada nodo de LangGraph que ya has escrito empieza a emitir spans sin reescribirse. Esa afirmación es real, y es específicamente una afirmación sobre objetos del framework, no sobre tus propias funciones.
Sus dos capacidades estrella son trazar requests y evaluar salidas. El curso solo ejercita la primera. Merece la pena señalarlo ahora en vez de descubrirlo más tarde: las evals se nombran como pilar y no se demuestran en ningún sitio.
Lo que obtienes en cuanto activas el tracing, según el propio resumen del capítulo 02:28:22–02:29:23:
- el prompt exacto enviado (no la plantilla, sino la cadena renderizada, con el contexto recuperado
interpolado en ella)
- la respuesta del modelo
- el número de tokens y el coste al que equivale
- un desglose de latencia por paso
- la capacidad de seguir el trace por todos los pasos de una ejecución
El recorrido introductorio por la interfaz lo concreta 02:29:23: entrada «what is the weather», un nodo de llamada al LLM que al desplegarse muestra el modelo GPT-4o, una duración de ~0.8 segundos y luego la salida. «Así que ahora ya no estás ciego.» (Tanto GPT-4o como el 0.8 son reconstrucciones a partir de un subtítulo automático destrozado —la transcripción dice «GPT40» y «about8 seconds»— y el repo usa gpt-4o-mini en todas partes, así que trata el sufijo exacto del modelo como no confirmado.)
Conseguir una cuenta y una clave 02:29:56–02:30:59:
- Ve a
smith.langchain.com. No hace falta tarjeta de crédito. - Inicia sesión con GitHub, email o Google.
- Espera un dashboard vacío. *«En tu caso probablemente no verás gran cosa si es
la primera vez, y no pasa nada.»* Una vista de Tracing vacía no significa que la configuración esté rota.
- Ve a Settings → API keys (no a la vista del proyecto).
- Crea una personal access key en tu workspace personal default. Con eso basta;
no necesitas claves con ámbito de servicio ni de organización para esto.
- La descripción es obligatoria: el formulario no te deja continuar hasta que escribas una. El instructor
usa «My testing playground».
- Copia la clave inmediatamente. Solo se muestra una vez. No puedes recuperarla después, solo generar
una nueva, y las claves son ilimitadas («siempre puedes volver aquí y crear tantas como necesites»), así que genera una por máquina o por proyecto en lugar de reutilizar la misma en todas partes. El instructor dice que «deberías obtener, creo, dos» valores al crearla; se le nota que no está seguro, y el diálogo actual muestra una clave más el contexto del workspace. No tomes «dos claves» como un hecho; simplemente guarda todo lo que te muestre el diálogo.
Instalar y configurar:
uv add langsmith
Una precisión por si vas a mirarlo: el pyproject.toml que se entrega nunca llega a tener una línea langsmith; el paquete llega de forma transitiva a través de langchain-core, y uv.lock lo fija en la 0.6.6 sobre Python ≥3.12. Ejecutar uv add langsmith de todos modos es lo correcto, porque convierte en explícita una dependencia que ahora importas directamente (from langsmith import traceable), en lugar de dejarla a merced de una actualización de LangChain.
# .env — never commit this file
OPENAI_API_KEY=sk-...
ANTHROPIC_API_KEY=sk-ant-...        # unused here; harmless to keep
LANGSMITH_API_KEY=lsv2_pt_...
LANGSMITH_TRACING=false             # the source ships false and overrides it in code
                                    # — set it to true here and delete the override
LANGSMITH_PROJECT=multi-agent research
| Variable | ¿Obligatoria? | Qué hace |
|---|---|---|
LANGSMITH_API_KEY | Sí | Autentica el SDK contra tu workspace |
LANGSMITH_TRACING | Sí | El interruptor general de encendido/apagado. "true" activa el tracing global; con cualquier otro valor, las funciones decoradas siguen ejecutándose pero no emiten nada |
LANGSMITH_PROJECT | Opcional | El contenedor en el que se escriben los traces. Muy recomendable: sin él, todo acaba en un único montón indiferenciado |
El .gitignore del repo empieza con el comentario adecuado justo por este motivo: # Environment variables — NEVER commit these.
@traceable: toda la API de instrumentación
La conclusión más importante del capítulo práctico es que la instrumentación es un decorador sobre una función corriente 02:33:02.
«Fíjate en que todas son simplemente funciones. Lo único es que luego les añadimos
@traceable.» 02:33:02
Aquí tienes la línea que lo activa y la primera demo, literales del repo:
# /home/oriol/lab/rag/code/production-course-main-code/langsmith_setup.py
import os
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langsmith import traceable
from langsmith.run_trees import RunTree
from dotenv import load_dotenv

load_dotenv()

# Enable tracing
os.environ["LANGSMITH_TRACING"] = "true"


@traceable(name="basic_chaining")
def demo_basic_tracing():
    """Basic LangSmith tracing."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    prompt = ChatPromptTemplate.from_template("Explain {topic} in one sentence.")

    chain = prompt | llm | StrOutputParser()

    print("Basic Tracing Demo:\n")
    print("Running chain with LangSmith tracing enabled...")

    result = chain.invoke({"topic": "machine learning"})

    print(f"Result: {result}")
    print("\nCheck LangSmith dashboard for trace details.")
Tres propiedades de ese decorador hacen todo el trabajo:
- Funciona sobre funciones de Python normales, no solo sobre runnables de LangChain. Puedes instrumentar
cualquier lógica de negocio: tu chunker, tu wrapper del reranker, tu formateador de citas.
- El anidamiento es automático. En cuanto la función exterior es traceable, el prompt, la llamada al LLM y
el parser de salida que contiene se recogen como ejecuciones hijas. No decoras tú las llamadas internas. (El instructor llama «LangGraph» a lo que hace la captura en 02:33:02; es el SDK de LangSmith. No propagues el lapsus.)
name=le da a la ejecución una identidad legible. Sin él obtienes el nombre en bruto de la función
de Python. Las ejecuciones con nombre son la forma de encontrar algo más tarde.
Un detalle muerto que conviene conocer para no perseguirlo: RunTree se importa y nunca se usa en el fichero que se entrega. No forma parte de la lección.
La escalera didáctica son tres funciones con tres niveles de instrumentación:
| Nivel | Decorador | Qué ganas |
|---|---|---|
| 1 | @traceable(name="basic_chaining") | Una ejecución con nombre en el dashboard |
| 2 | @traceable(name="named_runs_demo", tags=["production", "summarization"]) | Filtrable por entorno y por tipo de carga |
| 3 | @traceable(name="trace_with_metadata_demo", tags=["metadata", "filtering"]) sobre una función que recibe user_id / request_type | Atribución por usuario y por tipo de request: los argumentos se convierten automáticamente en metadatos del trace |
El nivel 3 es el que importa en producción, y su mecanismo es deliciosamente barato: la forma de meter la atribución por usuario en LangSmith es simplemente pasar esos valores como argumentos a la función trazada. La demo lo ilustra casi demasiado bien: request_type se declara, nunca se referencia en el cuerpo y existe únicamente para que aparezca en la ejecución. Ese es el patrón: un argumento que nunca usas sigue siendo un filtro por el que puedes segmentar el dashboard.
La otra cara es una restricción de privacidad que deberías decidir de forma deliberada. Si los argumentos se convierten automáticamente en metadatos del trace, todo lo que pases a una función trazada sale de tu proceso y acaba en el almacenamiento de un proveedor, incluida la pregunta en bruto del usuario y, en un sistema RAG, los chunks recuperados. Pasa un user_id opaco, no un email; aplica tu enmascarado de PII (Parte 12) antes de la frontera trazada, no después.
# /home/oriol/lab/rag/code/production-course-main-code/langsmith_setup.py
@traceable(name="trace_with_metadata_demo", tags=["metadata", "filtering"])
def demo_trace_with_metadata(user_id: str, request_type: str):
    """Add metadata to traces for filtering."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    # Metadata is automatically captured
    result = llm.invoke(f"Hello from user {user_id}")

    return result.content
El langsmith_setup.py completo, las 74 líneas
"""
LangSmith Setup and Observability
Production monitoring for LangChain/LangGraph
"""

import os
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langsmith import traceable
from langsmith.run_trees import RunTree
from dotenv import load_dotenv

load_dotenv()

# Enable tracing
os.environ["LANGSMITH_TRACING"] = "true"


@traceable(name="basic_chaining")
def demo_basic_tracing():
    """Basic LangSmith tracing."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    prompt = ChatPromptTemplate.from_template("Explain {topic} in one sentence.")

    chain = prompt | llm | StrOutputParser()

    print("Basic Tracing Demo:\n")
    print("Running chain with LangSmith tracing enabled...")

    result = chain.invoke({"topic": "machine learning"})

    print(f"Result: {result}")
    print("\nCheck LangSmith dashboard for trace details.")


@traceable(name="named_runs_demo", tags=["production", "summarization"])
def demo_named_runs():
    """Name your runs for easier identification."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    prompt = ChatPromptTemplate.from_template("Summarize: {text}")

    chain = prompt | llm | StrOutputParser()

    print("\nNamed Runs Demo:\n")

    result = chain.invoke(
        {"text": "LangSmith provides observability for LLM applications."}
    )

    print(f"Result: {result}")
    print("Run tagged with 'production', 'summarization'")


@traceable(name="trace_with_metadata_demo", tags=["metadata", "filtering"])
def demo_trace_with_metadata(user_id: str, request_type: str):
    """Add metadata to traces for filtering."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    # Metadata is automatically captured
    result = llm.invoke(f"Hello from user {user_id}")

    return result.content


if __name__ == "__main__":
    demo_basic_tracing()
    demo_named_runs()
    demo_trace_with_metadata(user_id="user_123", request_type="greeting")
Leer el dashboard
Ejecuta las tres demos y el proyecto muestra número de traces = 3 con columnas de latencia, tokens totales y coste 02:34:02. Si entras en la ejecución con metadatos, obtienes el registro completo 02:35:02:
| Campo | Valor en la demo |
|---|---|
| Nombre de la ejecución | trace_with_metadata_demo |
| Metadatos | user_id: user_123, request_type: greeting |
| Entrada / Salida | entra el prompt, sale «hello user how can I assist you today» |
| Estado | success |
| Tokens totales | 26; pasa el cursor por encima para ver el reparto: 20% entrada / 80% salida |
| Latencia | 1.15 s |
| Tipo | chain: «el tipo es chain porque estamos usando chains» |
| Tags | metadata, filtering |
Dentro de esa ejecución padre hay un span hijo para la invocación del modelo que muestra la entrada human y la salida ai literales. Esa es la promesa de «ver el prompt exacto enviado, ver la respuesta exacta del modelo» hecha realidad, y en un sistema RAG es la vista más valiosa que tienes, porque es el único sitio donde puedes leer el contexto completamente ensamblado que vio de verdad el modelo, frente al contexto que crees que ensambló tu código.
El tipo de ejecución se infiere, y debería importarte cuál obtienes. La explicación del instructor es una sola frase —«el tipo es chain porque estamos usando chains» 02:35:02—, pero la clasificación es crítica cuando empiezas a filtrar. LangSmith agrupa las ejecuciones por tipo: un pipeline LCEL se registra como chain, una llamada al modelo como llm y un retriever como retriever. Esto último es la razón por la que a un servicio RAG le conviene envolver el retrieval en un objeto retriever de LangChain en vez de en una función a secas: obtienes un tipo de ejecución de primera clase por el que puedes filtrar y agregar, en lugar de un span chain anónimo que tienes que reconocer por el nombre. Cada ejecución lleva además sus timestamps de inicio y fin junto con el coste y los tags, así que las preguntas de orden («¿el rerank ocurrió antes o después del filtro?») se pueden responder solo con el trace.
Tres trampas del dashboard del mismo recorrido:
- Una función trazada que devuelve
Noneregistraoutput: null. Dos de las tres demos solo
hacen print; sus traces muestran la entrada vacía y la salida a null 02:36:04 y parecen rotos, pero no lo están. @traceable registra los argumentos de entrada y el valor de retorno. Si quieres un trace útil, recibe argumentos y devuelve un valor: es una restricción de diseño de tus funciones instrumentadas, no una rareza de la interfaz.
- La interfaz no se actualiza en vivo: recárgala. Campos que parecían vacíos se rellenaron tras recargar
el navegador 02:36:04. No te pongas a depurar tu instrumentación por esto.
- La segunda ejecución informa de una latencia de
135sin que se diga la unidad; casi seguro que son 135 ms,
dado que la ejecución hermana tardó 1.15 s. Se señala como reconstrucción.
LangSmith tiene más superficie que el tracing: el original señala Monitoring (dashboards), Automations, Evaluators y Threads sin enseñar ninguno 02:37:05, y admite con honestidad que la pestaña Monitoring no muestra prácticamente nada cuando tienes tres traces. Tres traces no son un dataset de monitorización. No juzgues la funcionalidad por una ejecución de juguete.
Tres pilares de la visibilidad en producción
Hasta ahora, todo el trabajo lo ha hecho una herramienta alojada. El resto de esta parte es lo que construyes tú, en tu propio proceso, y existe porque un almacén de traces alojado no es un agregador de logs ni un backend de métricas.
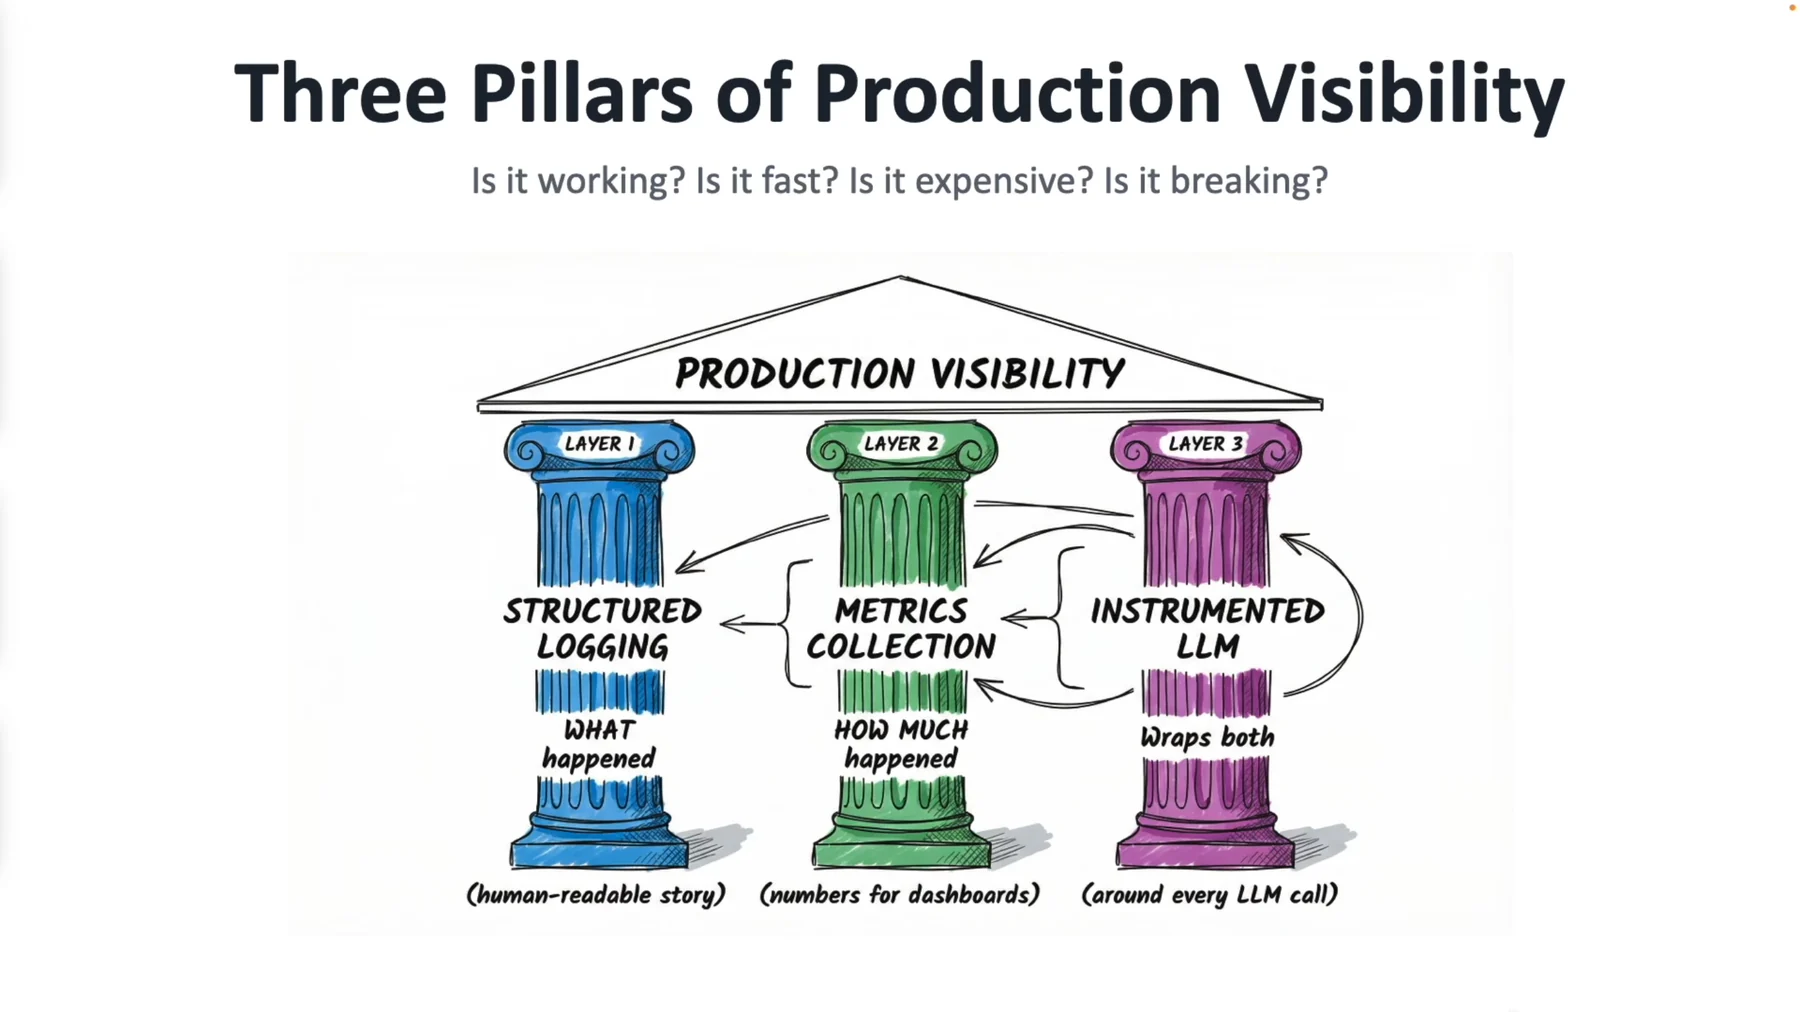
El subtítulo es el mejor resumen en cuatro preguntas de la visibilidad en producción de todo el original:
«¿Funciona? ¿Es rápido? ¿Es caro? ¿Se está rompiendo?» 04:04:43
| Pregunta | La responde | En concreto |
|---|---|---|
| ¿Funciona? | Logging estructurado + traces | Una línea JSON por request y un span por etapa |
| ¿Es rápido? | Métricas de latencia | latency_sum / latency_count |
| ¿Es caro? | Contadores de tokens + tasa de cache hits | tokens_input, tokens_output, cache_hits |
| ¿Se está rompiendo? | Contadores de errores | errors_total / requests_total |
Y las tres capas en sí:
| Capa | Nombre | Responde a | Leyenda de la diapositiva |
|---|---|---|---|
| 1 | Logging estructurado | QUÉ pasó | (relato legible por humanos) |
| 2 | Recogida de métricas | CUÁNTO pasó | (cifras para dashboards) |
| 3 | LLM instrumentado | envuelve a ambas | (alrededor de cada llamada al LLM) |
«…es lo que nos permitirá responder a esto y verlo en la realidad, no solo imaginarlo esperando que las cosas funcionen de verdad por dentro.» 04:04:43
Dónde encaja la monitorización: la jerarquía de capas
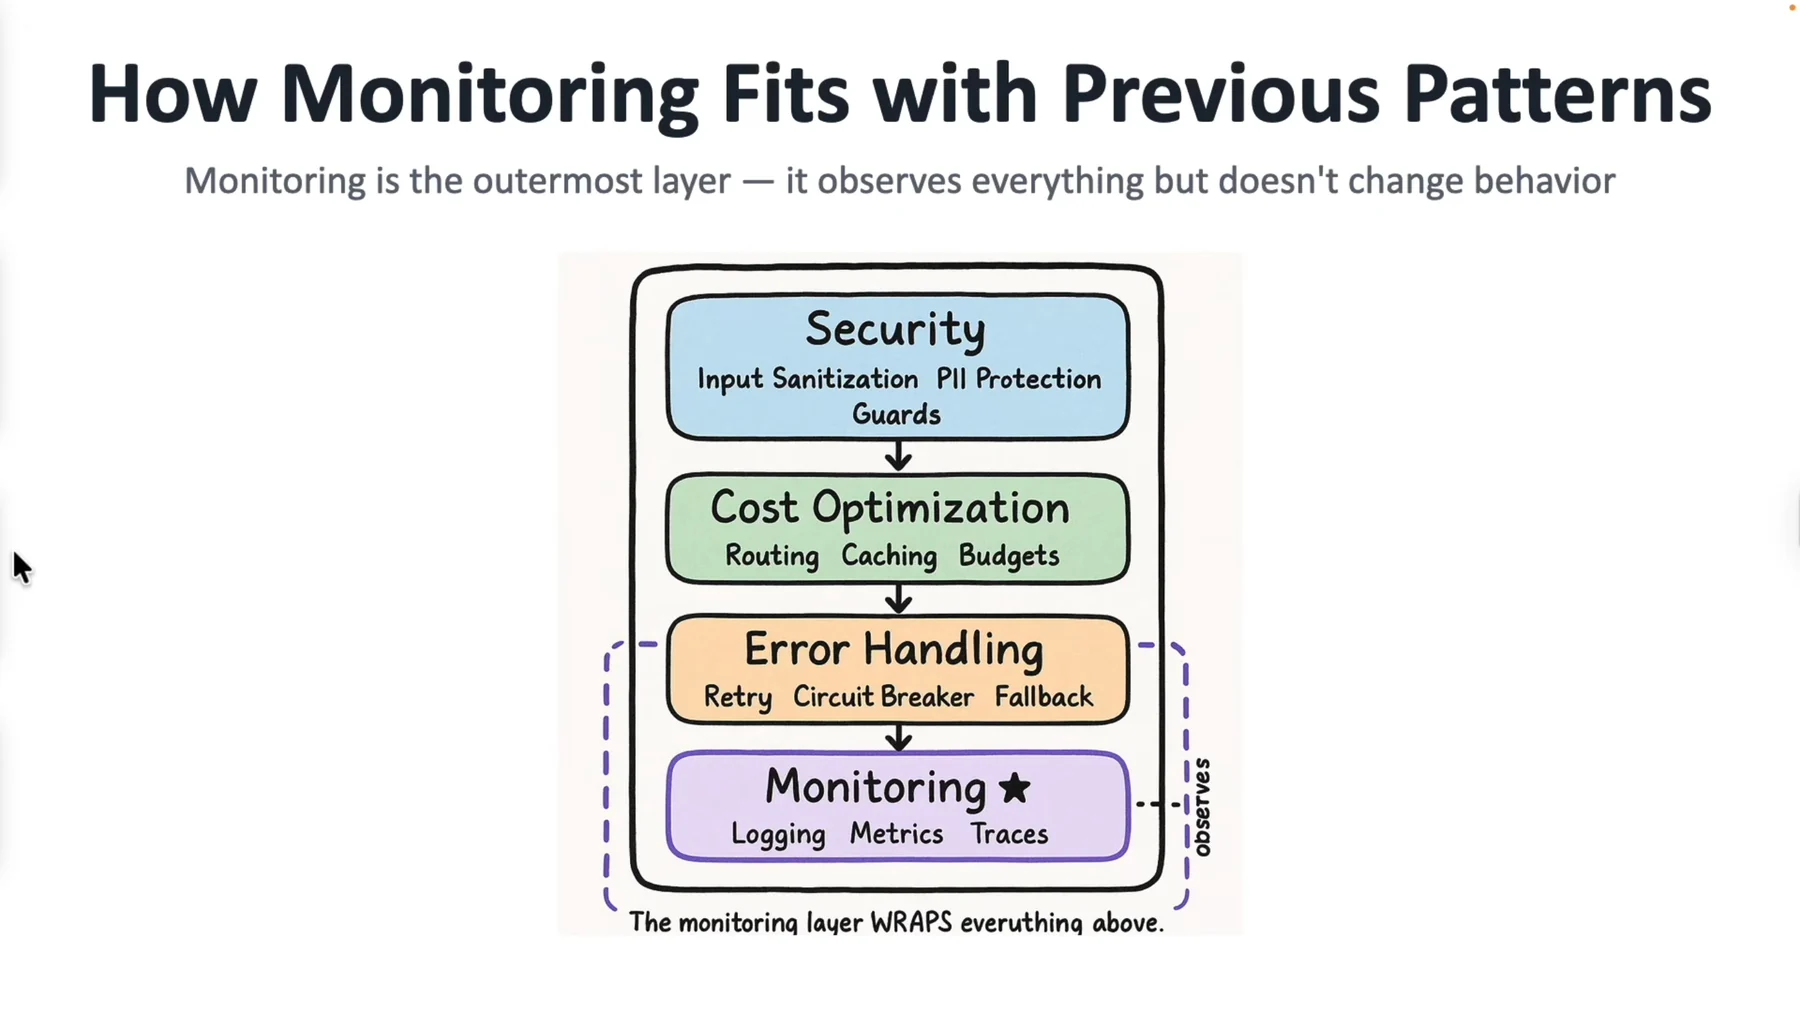
| Orden | Capa | Subtécnicas de la diapositiva | ¿Cambia el comportamiento? |
|---|---|---|---|
| 1 (se ejecuta primero) | Seguridad | Saneamiento de la entrada · Protección de PII · Guards | Sí: bloquea o reescribe la entrada |
| 2 | Optimización de costes | Routing · Caching · Presupuestos | Sí: reenruta a un modelo más barato, sirve desde la cache |
| 3 | Gestión de errores | Retry · Circuit Breaker · Fallback | Sí: reintenta, salta, recurre al fallback |
| 4 (la más externa) | Monitorización ★ | Logging · Métricas · Traces | No, y esa es la clave |
La diapositiva lo dice dos veces —una como subtítulo y otra como leyenda bajo el dibujo— y es el invariante 6 de esta guía:
«La monitorización es la capa más externa: lo observa todo, pero no cambia el comportamiento.» 04:06:43
«La capa de monitorización ENVUELVE todo lo que hay por encima.» 04:06:43
Esa es la propiedad que la distingue. Las otras tres capas hacen algo: bloquean, reenrutan, reintentan, recurren al fallback. La monitorización es la única cuyo criterio de corrección es que quitarla no cambia nada de lo que devuelve el sistema. El original no deja lugar a dudas de que el orden no es opcional 04:07:44: «en aplicaciones con LLM en producción, tienes que tener esta jerarquía: la seguridad arriba, la optimización de costes, la gestión de errores y, lo más importante, la monitorización».
Es la misma imagen que el pipeline de requests en producción de la Parte 1 —Client → Rate limiter → Security → Cache → Model (+retry +fallback) → Output validation → Metrics/logging → JSON response—, con las capas nombradas en lugar de secuenciadas. Primero los rechazos baratos, al final la inferencia cara, y un grabador envolviéndolo todo.
Pilar 1: logging estructurado
La objeción se anticipa con honestidad 04:07:44: «podemos usar logs normales, ¿no?». La respuesta es un argumento de escala, no de pureza, y es la mejor frase del capítulo:
«Está bien usar logs cuando los lees en tu terminal. Y son totalmente inútiles cuando tienes 10,000 requests por hora.» 04:07:44
Tres consultas concretas que los logs de texto plano no pueden responder:
- *Muéstrame todas las requests de más de 1 segundo.*
- Muéstrame todos los errores del agente de facturación. (filtrar por módulo/componente)
- Muéstrame todas las requests de un usuario concreto. (filtrar por id de usuario)
El logging estructurado consiste en emitir cada línea de log como un objeto JSON con campos tipados en lugar de como una frase en prosa, para que un agregador de logs pueda indexar y consultar los campos. Datadog, Elasticsearch y CloudWatch lo ingieren directamente 04:09:48. Las dos consultas de ejemplo que desbloquea son «muéstrame todos los logs donde latency_ms fue mayor que 1,000» y «cuenta los errores por módulo»: ambas triviales sobre campos JSON y, como dice el original, imposibles sobre texto plano 04:09:48. La diferencia no es cosmética: una frase en prosa registra que algo pasó; un objeto JSON registra qué valores tenía, y solo lo segundo se puede contar.
«Así que cada línea de log es un objeto JSON.» 04:09:48
Todo este pilar y los dos siguientes viven en un único fichero de 212 líneas. Sus imports te dicen de qué está hecho: la biblioteca estándar, dos piezas de LangChain y el decorador de LangSmith:
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
import logging
import json
import time
from datetime import datetime, timezone
from functools import wraps
from typing import Any, Callable
from langchain_openai import ChatOpenAI
from langchain_core.callbacks import BaseCallbackHandler
from langchain_core.messages import HumanMessage
from langsmith import traceable
from dotenv import load_dotenv

load_dotenv()
wraps, Any, Callable, HumanMessage y BaseCallbackHandler se importan y nunca se usan. El último es el interesante, porque nombra el camino que este fichero no toma: LangChain expone una interfaz de callbacks (BaseCallbackHandler, con los hooks on_llm_start / on_llm_end / on_llm_error) que te permite enganchar instrumentación a cada llamada al modelo dentro de una chain sin envolver el modelo en una clase propia. El enfoque del wrapper que se muestra aquí es más fácil de leer y te da un punto de llamada explícito; el enfoque de callbacks se compone mejor cuando el LLM está enterrado tres capas por debajo dentro de una chain LCEL que no has escrito tú. Debes saber que existen los dos.
Aquí está la implementación completa del pilar 1. Es una subclase de logging.Formatter que sobrescribe un método:
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
class JSONFormatter(logging.Formatter):
    """Format logs as JSON for log aggregation."""

    def format(self, record):
        log_obj = {
            "timestamp": datetime.now(timezone.utc).isoformat(),
            "level": record.levelname,
            "message": record.getMessage(),
            "module": record.module,
            "function": record.funcName,
        }

        if hasattr(record, "extra_data"):
            log_obj.update(record.extra_data)

        return json.dumps(log_obj)


def setup_logging():
    """Setup structured JSON logging."""

    logger = logging.getLogger("langgraph_app")
    logger.setLevel(logging.INFO)

    handler = logging.StreamHandler()
    handler.setFormatter(JSONFormatter())
    logger.addHandler(handler)

    return logger
El veredicto del instructor —«muy sencillo pero útil» 04:08:46— es justo. Cinco campos base en cada línea y una vía de escape. Dos decisiones de configuración de setup_logging() merecen una lectura atenta. El logger tiene nombre ("langgraph_app") en lugar de ser el logger raíz, lo cual es correcto: formatear en JSON el logger raíz reescribiría cada línea que emita cualquier biblioteca de terceros. Y el handler es un StreamHandler a secas con nivel INFO, que escribe en stderr, porque ese es el comportamiento por defecto de StreamHandler cuando no le pasas ningún stream. Si tu despliegue espera los logs de la aplicación en stdout (la mayoría de drivers de logs de contenedores tratan stderr como canal de errores y pueden marcar cada línea como error), es un arreglo de un argumento que deberías hacer antes de entregar: logging.StreamHandler(sys.stdout).
| Campo | Origen |
|---|---|
timestamp | datetime.now(timezone.utc).isoformat(): ISO-8601, UTC, con zona horaria |
level | record.levelname |
message | record.getMessage() |
module | record.module |
function | record.funcName |
La vía de escape extra_data es el mecanismo que hace útil todo esto. Quien llama pasa extra={"extra_data": {...}} a logger.info(...), y esas claves se fusionan en el nivel superior del objeto JSON: así es como latency_ms, input_tokens y output_tokens acaban siendo campos consultables de primera clase en lugar de quedar interpolados en una frase.
La prueba de humo (que se entrega comentada al final del fichero):
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py  (lines 210-211)
logger = setup_logging()
logger.info("Logging setup complete", extra={"extra_data": {"app": "langgraph"}})
produce una línea con timestamp, level: INFO, message: "Logging setup complete", module: monitoring, function: <module> y app: langgraph. Ese <module> es un detalle accesorio pero instructivo: funcName es real y dinámico, y aquí pone <module> solo porque la llamada se hace a nivel de módulo. En la demo en vivo, el mismo campo pone invoke.
Pilar 2: recogida de métricas
El contraste más claro del original 04:10:48:
- Un log es un evento individual: *«la request X tardó 453 milisegundos».*
- Una métrica es un agregado: *«la latencia media fue de 320 milisegundos».*
«Los logs y las métricas son cosas distintas, pero juntos cuentan una historia mejor.» 04:10:48
Necesitas ambos porque responden a preguntas distintas. El log te habla de esa request: qué usuario, qué query, qué ids de documento. La métrica te habla de la población: si hoy va peor que ayer. Ninguno sustituye al otro, y un sistema que solo tiene métricas puede decirte que algo se ha vuelto más lento sin decirte nunca qué request mirar.
Los ocho contadores. El instructor los cuenta en voz alta en directo y los presenta como «todo lo que necesitas para entender la salud de tu aplicación con LLM», aunque añade «y tantos como queramos añadir». Tómalo como un mínimo, no como un máximo.
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
class MetricsCollector:
    """Collect and aggregate metrics."""

    def __init__(self):
        self.metrics = {
            "requests_total": 0,
            "errors_total": 0,
            "latency_sum": 0,
            "latency_count": 0,
            "tokens_input": 0,
            "tokens_output": 0,
            "cache_hits": 0,
            "cache_misses": 0,
        }

    def record_request(
        self,
        latency_ms: float,
        input_tokens: int,
        output_tokens: int,
        error: bool = False,
        cache_hit: bool = False,
    ):
        self.metrics["requests_total"] += 1
        self.metrics["latency_sum"] += latency_ms
        self.metrics["latency_count"] += 1
        self.metrics["tokens_input"] += input_tokens
        self.metrics["tokens_output"] += output_tokens

        if error:
            self.metrics["errors_total"] += 1

        if cache_hit:
            self.metrics["cache_hits"] += 1
        else:
            self.metrics["cache_misses"] += 1
| # | Contador | Significado |
|---|---|---|
| 1 | requests_total | cuántas llamadas |
| 2 | errors_total | cuántas fallaron |
| 3 | latency_sum | suma acumulada de milisegundos |
| 4 | latency_count | recuento acumulado de mediciones |
| 5 | tokens_input | tokens de prompt acumulados |
| 6 | tokens_output | tokens de completion acumulados |
| 7 | cache_hits | hits acumulados |
| 8 | cache_misses | misses acumulados |
Cinco cosas por llamada al LLM, un solo método 04:11:49: cuánto tardó, cuántos tokens entraron, cuántos tokens salieron, si falló y si venía de la cache.
«Así que una sola llamada a un método lo captura todo.» 04:11:49
Es una regla de diseño que merece la pena formular explícitamente: no repartas cinco incrementos de contadores por todo tu código. Canalízalos en un único record_request, para que añadir una novena métrica sea una sola edición y no un ejercicio de arqueología. Fíjate también en que cache_hits y cache_misses son mutuamente excluyentes e incondicionales, así que hits + misses siempre es igual a requests: un invariante gratuito que puedes comprobar en los tests.
Dos límites de esta clase que el original no menciona y con los que te toparás el día que la pongas detrás de un servidor web. self.metrics[k] += 1 es una lectura-modificación-escritura, no una operación atómica, así que en un servidor con hilos las requests concurrentes perderán de vez en cuando un incremento; y los contadores viven en un dict normal, así que se reinician en cada arranque y no se pueden sumar entre réplicas. Ninguno de los dos importa en una demo. Los dos importan en cuanto el número se usa para tomar una decisión, y por eso la respuesta de producción es un cliente de métricas de verdad —contadores de Prometheus, o el equivalente de tu plataforma— con record_request como único punto de llamada delante.
get_summary() es donde se hace la derivación, con una protección en cada división para que un colector en frío devuelva 0 en lugar de lanzar ZeroDivisionError:
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
    def get_summary(self) -> dict:
        avg_latency = (
            self.metrics["latency_sum"] / self.metrics["latency_count"]
            if self.metrics["latency_count"] > 0
            else 0
        )
        error_rate = (
            self.metrics["errors_total"] / self.metrics["requests_total"]
            if self.metrics["requests_total"] > 0
            else 0
        )
        cache_hit_rate = (
            self.metrics["cache_hits"]
            / (self.metrics["cache_hits"] + self.metrics["cache_misses"])
            if (self.metrics["cache_hits"] + self.metrics["cache_misses"]) > 0
            else 0
        )

        return {
            "total_requests": self.metrics["requests_total"],
            "total_errors": self.metrics["errors_total"],
            "error_rate": f"{error_rate:.2%}",
            "avg_latency_ms": round(avg_latency, 2),
            "total_input_tokens": self.metrics["tokens_input"],
            "total_output_tokens": self.metrics["tokens_output"],
            "cache_hit_rate": f"{cache_hit_rate:.2%}",
        }
| Clave del resumen | Formato |
|---|---|
total_requests | int |
total_errors | int |
error_rate | f"{error_rate:.2%}": cadena de porcentaje, 2 decimales |
avg_latency_ms | round(avg_latency, 2): float, 2 decimales |
total_input_tokens | int |
total_output_tokens | int |
cache_hit_rate | f"{cache_hit_rate:.2%}": cadena de porcentaje, 2 decimales |
Fíjate en el cambio de nombre deliberado entre almacenamiento y presentación: requests_total pasa a ser total_requests. Los nombres internos de los contadores y la forma del informe externo pueden diferir, y mantenerlos separados significa que puedes cambiar uno sin romper el otro.
Pilar 3: el LLM instrumentado
La capa 3 es el wrapper que hace automáticas las capas 1 y 2. Un invoke, tres señales: una fila de métricas, una línea de log JSON y un span de LangSmith.
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
class InstrumentedLLM:
    """LLM with full instrumentation."""

    def __init__(self):
        self.llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
        self.metrics = MetricsCollector()
        self.logger = setup_logging()

    @traceable(name="instrumented_invoke")
    def invoke(self, query: str) -> str:
        start_time = time.time()
        error = False

        try:
            response = self.llm.invoke(query)
            result = response.content

            # Estimate tokens
            input_tokens = len(query.split()) * 4 // 3
            output_tokens = len(result.split()) * 4 // 3

            self.metrics.record_request(
                latency_ms=(time.time() - start_time) * 1000,
                input_tokens=input_tokens,
                output_tokens=output_tokens,
                error=False,
                cache_hit=False,
            )

            self.logger.info(
                "LLM request completed",
                extra={
                    "extra_data": {
                        "latency_ms": (time.time() - start_time) * 1000,
                        "input_tokens": input_tokens,
                        "output_tokens": output_tokens,
                    }
                },
            )

            return result

        except Exception as e:
            error = True
            self.metrics.record_request(
                latency_ms=(time.time() - start_time) * 1000,
                input_tokens=0,
                output_tokens=0,
                error=True,
                cache_hit=False,
            )

            self.logger.error(
                f"LLM request failed: {e}", extra={"extra_data": {"error": str(e)}}
            )

            raise
Lee con atención el camino de fallo, porque es el invariante 6 expresado en doce líneas:
- La latencia se registra también cuando hay fallo. La latencia de un timeout es un dato real; posiblemente la
latencia más interesante que tienes. Descartarla sesga tu media a la baja justo cuando las cosas van mal.
- Los tokens se registran como 0 cuando hay fallo, lo cual es honesto, pero significa que
tokens_inputse queda corto respecto al
gasto real si el proveedor te cobró una request que luego falló aguas abajo.
raiserelanza la excepción. La monitorización observa; no se traga nada. Unreturn Noneaquí
convertiría un fallo ruidoso en uno silencioso: exactamente la enfermedad que esta parte existe para tratar.
La heurística de estimación de tokens y por qué tienes que sustituirla.
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py  (lines 145-146)
            # Estimate tokens
            input_tokens = len(query.split()) * 4 // 3
            output_tokens = len(result.split()) * 4 // 3
palabras × 4 ÷ 3 ≈ 1.333 tokens por palabra, redondeado hacia abajo a entero. Es una comodidad de demo, no la verdad de la facturación. Se desviará mucho con código, con texto que no esté en inglés, con palabras largas, con cualquier cosa con mucha puntuación y —algo crítico en RAG— con el contexto recuperado, que es justo la parte de tu prompt que domina tu factura. El original no lo advierte; debería advertirse.
La corrección es leer el uso real que devuelve el proveedor en lugar de adivinarlo a partir de la cadena. LangChain lo expone en el mensaje de respuesta. Esto no está en el fichero que se entrega —es el parche que deberías aplicar—, así que verifica la forma exacta con tu proveedor y tu versión de LangChain antes de fiarte de las cifras:
# Suggested replacement for the estimate — NOT in the shipped monitoring.py.
# ChatOpenAI returns an AIMessage carrying provider usage; prefer it over a word-count guess.
response = self.llm.invoke(query)
result = response.content

usage = getattr(response, "usage_metadata", None) or {}
input_tokens = usage.get("input_tokens")
output_tokens = usage.get("output_tokens")

if input_tokens is None or output_tokens is None:      # provider didn't report usage
    input_tokens = len(query.split()) * 4 // 3         # fall back to the estimate
    output_tokens = len(result.split()) * 4 // 3
Tres pequeños code smells del fichero que se entrega, nombrados para que no los copies:
time.time() - start_timese calcula dos veces en el camino feliz (una para las métricas y otra
para el log), así que los dos números difieren en unos microsegundos. Calcúlalo una vez en una variable local.
- La variable local
errorse asigna en ambas ramas y nunca se lee. Código muerto. cache_hit=Falseestá escrito a fuego en ambas ramas, y por eso la demo siempre informa de una
tasa de cache hits del 0%. El campo existe para que puedas conectar la cache semántica de la parte de caching de esta guía; simplemente la fontanería todavía no está conectada.
La ejecución de la demo y lo que te dicen realmente sus cifras
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
def demo_monitoring():
    """Demonstrate monitoring."""

    llm = InstrumentedLLM()

    print("Monitoring Demo:\n")

    queries = [
        "What is Python?",
        "Explain machine learning.",
        "What is 2 + 2?",
    ]

    for query in queries:
        result = llm.invoke(query)
        print(f"Query: {query[:30]}... -> {result[:30]}...")

    print("\nMetrics Summary:")
    summary = llm.metrics.get_summary()
    for key, value in summary.items():
        print(f"  {key}: {value}")
Por cada request obtienes una línea JSON con timestamp, level, message: "LLM request completed", module: monitoring, function: invoke, más los tres campos de extra_data: latency_ms, input_tokens, output_tokens 04:13:53.
Y al final, el agregado 04:14:54:
| Métrica | Valor en la demo |
|---|---|
| total de requests | 3 |
| total de errores | 0 |
| tasa de errores | 0% |
| latencia media | ≈8,000 ms |
| total de tokens de entrada | 14 |
| total de tokens de salida | 876 |
| tasa de cache hits | 0% |
Mientras tanto, LangSmith muestra 3 ejecuciones llamadas instrumented_invoke, una por query, en el proyecto que el instructor llama «multi-agent» (el capítulo 13 lo llamó multi-agent research; la discrepancia es suya, no tuya: elige un nombre y mantenlo), con la latencia visible directamente en la lista de ejecuciones. Una ejecución tardó 17 segundos, "Explain machine learning.", porque generó una respuesta larga.
Ahora lee esa tabla como leerías un dashboard real, porque es una pequeña clase magistral sobre por qué las cifras en bruto necesitan interpretación:
- Una tasa de errores del 0% aquí no significa nada. Tres requests correctas. Es exactamente la estadística
que sigue en verde mientras tus respuestas son basura.
- Una latencia media de 8,000 ms es alarmante y es un artefacto de n=3. Haz la cuenta: una
ejecución de 17 segundos más dos de unos 3.5 s suman unos 24 s, y 24 / 3 = 8. La media describe una request que nunca ocurrió. Es la gemela de la lección «no puedes promediar promedios» —tampoco puedes fiarte de una media sin una distribución detrás—, y un p50 de ~3.5 s habría contado una historia completamente distinta, y más honesta.
- 14 tokens de entrada para tres queries cortas es exactamente lo que la heurística
words × 4 // 3
predice: 3 palabras → 4, 3 palabras → 4, 5 palabras → 6. Lo cual es también la prueba de que es un contador de palabras y no un tokenizador. No ve la sobrecarga de la plantilla de chat —marcadores de rol y delimitadores de mensaje— que el proveedor cobra en cada llamada por corta que sea tu cadena, así que se queda corta en una cantidad fija por request, para siempre.
- La tasa de cache hits del 0% está escrita a fuego, no medida.
LangSmith no es tu agregador de logs
Este es el aviso con el que cierra el capítulo 04:15:57 y el punto operativo más importante de esta parte.
«Son dos sistemas separados: datos complementarios.» 04:15:57
| LangSmith | Datadog / CloudWatch / Elasticsearch | |
|---|---|---|
| Recibe | Traces / spans | Líneas de log JSON estructuradas |
| De | (a) el decorador @traceable y (b) la instrumentación integrada de LangChain | tu StreamHandler escribiendo la salida de JSONFormatter en los streams estándar del proceso |
| Bueno en | Estructura causal por ejecución: spans anidados, prompts, completions, tokens/coste por nodo | Búsqueda y agregación en toda la flota, alertas, retención, correlación con servicios que no son LLM |
| Malo en | Ser tu sistema de referencia para todo lo demás que hace tu servicio | Reconstruir la forma de un grafo de llamadas anidadas al LLM |
Dos fuentes de traces, un destino de traces; una fuente de logs, un destino de logs distinto. Entregar uno no te da el otro. La implicación práctica para un servicio RAG en producción es que ejecutas los dos: LangSmith para «por qué esta respuesta estaba mal» y tu agregador para «cuántas requests del tenant X superaron 1 segundo el martes pasado».
Evals: el pilar que el original nunca demuestra
Dilo claramente, porque es el mayor agujero del material original. Las evals se nombran como uno de los tres pilares y no se demuestran en ningún sitio. El capítulo 12 las define (corrección, relevancia, feedback humano, detección de regresiones). El capítulo 13 señala de pasada la pestaña Evaluators de LangSmith en una frase y sigue adelante 02:37:05. El capítulo 19 ni las menciona. Cada cifra que te da el original sobre evals —incluido el 0.85 quality score de la diapositiva del ROI— sale de un nodo verificador de calidad dentro de un grafo de demo, no de un arnés de evaluación.
Eso importa porque las evals son el único pilar que detecta el modo de fallo con el que se abrió toda esta parte. Los traces te muestran una ejecución de aspecto sano. Las métricas te muestran un coste y una latencia de aspecto sano. Los fallos silenciosos son invisibles para ambos por construcción. Un sistema con traces y métricas pero sin evals es un sistema que te dirá con total seguridad que está bien mientras devuelve respuestas incorrectas, que es exactamente la situación descrita en 04:04:43: las llamadas a la API se están produciendo y sigues sin saber si funciona.
Lo que de verdad necesitas, formulado como requisitos en lugar de fingir que el original lo cubrió:
- Un golden set. Entre cincuenta y unos cientos de tripletas (pregunta, respuesta esperada, chunk fuente esperado)
sacadas de tu corpus real y de las preguntas de tus usuarios reales. Esta es la parte cara y no hay forma de evitarla.
- Métricas de retrieval, medidas por separado de la generación. Recall@k y MRR contra la
columna del chunk fuente esperado responden a «¿ha vuelto siquiera el chunk correcto?». Es el invariante 1 hecho medible —la calidad se hereda hacia delante, así que mides primero la etapa más temprana— y es la razón por la que la Parte 4 insiste en que pruebes el retrieval por separado antes de culpar al modelo. Si el recall@k es bajo, ningún cambio de prompt te salvará.
- Métricas de generación. Groundedness (¿cada afirmación está respaldada por el contexto recuperado?)
y relevancia (¿responde a la pregunta que se hizo?). En la práctica son scores de LLM-as-judge, lo que significa que tu evaluador es en sí mismo un sistema no determinista y necesita su propia comprobación puntual contra etiquetas humanas.
- Captura de feedback humano. Un pulgar arriba/abajo en cada respuesta, escrito en el mismo almacén que
tus traces, para poder saltar de una queja a la ejecución exacta.
- Una puerta de regresión. La suite de evals se ejecuta en CI con cada cambio de prompt, de chunker, de embedding model o
de k, y hace fallar el build si hay una caída. Sin este paso, los otros cuatro son un proyecto de ciencias, porque la promesa de la diapositiva —«ve los cambios de comportamiento antes de que los usuarios se quejen»— es la puerta, no el dataset.
Los patrones de implementación de la mitad de CI de esto llegan en la parte de testing de esta guía; los patrones de LLM-as-judge y de retrieval que se autocorrige llegan en la parte de agentic RAG. Lo que corresponde aquí es la contabilidad honesta: el original resuelve los traces y las métricas; las evals te las deja a ti.
Qué instrumentar en un pipeline RAG, en concreto
El original instrumenta un único llm.invoke. Una request de RAG tiene más superficie. Esta tabla es la traducción: aplica @traceable en cada una de estas fronteras y registra estos campos en extra_data:
| Span | Qué registrar | Por qué lo querrás a las 3 de la madrugada |
|---|---|---|
rag_request (el más externo) | user_id, tenant, request_type, latencia total, coste total | La clave de unión para todo lo demás; la unidad a la que se refiere tu cifra de ROI |
rewrite_query | query original, query reescrita | Te dice si una respuesta incorrecta estaba respondiendo a otra pregunta |
embed_query | nombre del modelo y versión, dimensión, latencia | Auditoría del invariante 2: la única forma de detectar una deriva entre el modelo del índice y el de la query |
vector_search | k, dict de filtros, ids devueltos, scores en bruto, nombre del store | La polaridad de los scores depende de cada store; registra el valor en bruto y la polaridad |
keyword_search | k, ids devueltos, scores BM25 | Necesario para atribuir un resultado de la fusión a una rama |
fuse / rerank | posición antes, posición después, modelo usado | Demuestra si tu reranker se gana la latencia que cuesta |
assemble_context | número de chunks, tokens de contexto, si hubo truncado | El término dominante de tu factura y la causa habitual de «la respuesta estaba ahí, en algún sitio» |
generate | modelo, tokens de prompt, tokens de completion, finish reason | Atribución de costes y detección de truncados |
validate_output | resultado de la validación, flag de rechazo | Distingue «el modelo se negó correctamente» de «el modelo falló» |
Checklist y decisiones que tomar
Checklist bloqueante para entregar: nada de esto es opcional antes de tener usuarios reales:
uv add langsmith;LANGSMITH_API_KEYyLANGSMITH_TRACINGen.env;.enven
.gitignore.
- Decide quién es el dueño del interruptor de tracing:
.envoos.environen el código, nunca los dos. En
producción, debería ganar .env, para que puedas desactivar el tracing sin un deploy.
LANGSMITH_PROJECTcon un valor significativo, con proyectos separados por entorno.- Comprueba que ves tus propios traces en el dashboard. Una vez, a conciencia, antes de seguir
adelante. Recarga el navegador antes de concluir que está roto.
@traceableen el handler de request más externo y en cada frontera de etapa de la tabla
de arriba. Cada función trazada recibe argumentos y devuelve un valor; si no, el trace registra una entrada vacía y una salida null.
user_id/tenant/request_typepasados como argumentos para que se conviertan en metadatos
filtrables.
- Logging estructurado JSON (
JSONFormatter) en un logger con nombre, con la protección dehandlers
aplicada, un stream explícito (StreamHandler(sys.stdout); por defecto es stderr) y un destino decidido: Datadog, CloudWatch o Elasticsearch.
- Un
MetricsCollector(o su equivalente en Prometheus) que registre los cinco datos por llamada
mediante un único método: latencia, tokens de entrada, tokens de salida, error, cache hit.
latency_sumylatency_countguardados por separado. Los ratios se derivan al leer, nunca
se guardan ya promediados.
- El uso real de tokens del proveedor conectado, con la heurística
words × 4 // 3relegada a
fallback y etiquetada como estimación allí donde aparezca.
- Cada
exceptdel camino de monitorización termina enraise. Búscalo con grep; es una revisión de una línea
que detecta toda la clase de «la monitorización tumbó producción».
- Cada bucle tiene un tope estricto de iteraciones además de su salida por calidad, y el número de iteraciones se
registra como métrica para que la deriva aparezca antes que la factura.
- Alertas conectadas de verdad, no solo métricas recogidas: el propio docstring del fichero del original
promete «logging estructurado, métricas y alertas» y no incluye ninguna alerta. Como mínimo: tasa de errores en una ventana móvil, latencia en el percentil que elijas, coste por request frente a su mediana reciente y caída del score de las evals entre deploys.
- Un golden set de al menos veinte preguntas con sus chunks fuente esperados, y un script que
imprima el recall@k.
- La prueba de pasividad se supera. Borra la capa de monitorización en una rama, ejecuta tu suite
de tests y confirma que cada respuesta es idéntica byte a byte. Si no lo es, la monitorización está en tu flujo de control y has entregado un nuevo modo de fallo en lugar de visibilidad sobre los antiguos.
Decisiones que tomar, y cómo tomarlas:
| Decisión | Elige la opción fácil cuando… | Elige la opción difícil cuando… |
|---|---|---|
| Tracing alojado (LangSmith) frente a OTEL self-hosted | Estás en LangChain/LangGraph, haciendo prototipos o en un equipo pequeño: dos variables de entorno ganan a una semana de fontanería de colectores | Los prompts o los documentos recuperados no pueden salir de tu infraestructura, o ya tienes un stack OTEL/Grafana con el que debes correlacionar |
| Trazarlo todo frente a muestrear | Desarrollo, y cualquier volumen en el que el coste y el almacenamiento sean irrelevantes | Volumen alto: entonces muestrea las ejecuciones correctas y conserva el 100% de los errores y de las ejecuciones con score de eval bajo, que es donde está la información |
| Tokens estimados frente a uso del proveedor | Nunca, si hay dinero de por medio. Solo para una prueba de humo local | Siempre, para cualquier cosa a partir de la cual alguien vaya a tomar una decisión |
| Latencia media frente a percentiles | El primer día, n es pequeño y necesitas un número | En cuanto tengas tráfico real: una media con un valor atípico de 17 segundos (mira la demo) engaña activamente |
| Métricas en el proceso frente a un backend de verdad | Un solo proceso, una demo, un contenedor | Más de una réplica: un dict en el proceso se reinicia en cada arranque y no se puede agregar entre instancias |
| Construir las evals ahora frente a más adelante | Nunca «más adelante»: veinte preguntas son una tarde | Siempre ahora. Es el único pilar que mide la corrección, y es el que el original te deja construir a ti |