
El pressupost de cost i latència
Quantització, batching, tres capes de memòria cau i un model de costos resolt per reduir la despesa.
Totes les parts anteriors han gastat diners per comprar qualitat. El chunking semàntic ha pagat una crida d'embeddings per frase. La cerca híbrida executa dues recuperacions en lloc d'una. La multiconsulta dispara tres reformulacions. El reranking afegeix un model. Cadascuna s'ha justificat en els seus propis termes i cadascuna ha augmentat silenciosament la factura per petició i el p95.
Aquesta és la part on recuperes els diners.
Recorda el model mental de la part 1: el pipeline es regeix per tres pressupostos en tensió permanent: QUALITAT, LATÈNCIA, DINERS. Les parts 3 a 6 han optimitzat la qualitat. La part 7 t'ha donat la instrumentació per veure tots tres. La part 8 ha fet que l'índex sobrevisqui a l'escala. Aquesta part s'ocupa dels altres dos pressupostos i fa una afirmació per sobre de totes les altres: el cost no és una partida que descobreixes a final de mes. És un paràmetre de disseny, establert en quatre comptadors concrets del pipeline; si no l'estableixes tu, el pipeline ho fa per tu. Aquests quatre comptadors són la taula següent.
Les fonts del capítol són tres: la meitat de pressupost de tokens del capítol 11 (02:13:12–02:21:10), tot el capítol 16 sobre els costos reals de la cerca vectorial (03:23:35–03:33:17) i la meitat de memòria cau del capítol 18 (03:54:27–04:04:41). Dues de les tres són meitats òrfenes: els marcadors de capítol del curs no coincideixen amb els límits de les lliçons, de manera que el pressupost de tokens està grapat al final d'un capítol de cerca híbrida i la memòria cau al final d'un de Supabase. Es troben a una hora i mitja de distància a la cronologia i no es presenten mai l'una a l'altra. Juntes són una pila completa de control de costos, i aquesta part és on finalment es troben.
On van realment els diners
L'invariant 3 de la part 1 és tot el marc: el cost d'indexació és únic; el de consulta es repeteix per petició. Cada optimització d'aquesta part aplica aquesta frase. Abans d'optimitzar res, has de saber quin dels quatre comptadors llegeixes.
| Comptador | Fase | Es factura per | Escala amb | Es tracta a |
|---|---|---|---|---|
| Tokens d'embeddings (corpus) | Indexació, únic | tokens dels quals es genera l'embedding | mida del corpus × nombre de reindexacions | Part 4 |
| Emmagatzematge + RAM de l'índex | Indexació, recurrent | vectors mantinguts | nombre de vectors × dimensions × bytes/dimensió | Part 8, aquesta part |
| Embedding de consulta + cerca vectorial | Consulta, per petició | una crida d'embeddings + una (o dues) cerques | consultes/dia | aquesta part |
| Tokens d'entrada + sortida de l'LLM | Consulta, per petició | mida del context + mida de la resposta | consultes/dia × k × mida del fragment | aquesta part |
De la taula es desprenen directament dues conseqüències.
Primer, l'índex és una compra de capacitat i el camí de consulta és una compra de consum. Responen a eines d'ajust completament diferents. Reduir els vectors de 1536 a 512 dimensions resol permanentment la segona fila i no fa absolutament res per a la quarta. Desar respostes a la memòria cau resol la quarta fila i no fa res per a la segona.
Segon —i això sorprèn molta gent—, en un sistema RAG típic, la base de dades vectorial no és la part cara. L'LLM sí. RAG existeix per omplir un prompt amb text recuperat; aquesta és tota la seva funció. Una recuperació amb k=4 de fragments de 500 tokens afegeix 2,000 tokens d'entrada a cada petició, per sempre. Farem explícitament aquests càlculs al final de la part.
Mode de fallada #4: desbordament del context i la petició que es menja el dia
El capítol 11 passa a 02:13:12 de la cerca híbrida al quart dels cinc modes de fallada anomenats a la part 1: el desbordament del context. El plantejament prioritza la qualitat —es lliura a l'LLM més context del que realment pot fer servir i comença a ignorar-ne la meitat—, però el mecanisme que ensenya l'instructor és financer, i ho diu immediatament:
«tot gira al voltant dels tokens quan parlem d'un LLM. De fet, així és com se'ns cobra la inferència.» 02:13:12
Els tokens són simultàniament la unitat de degradació de qualitat i la de facturació. Aquesta coincidència és el que fa útil un sol control per a tots dos problemes.
L'exemple resolt té la forma d'una incidència real de producció. Un usuari enganxa un contracte de 200 pàgines al quadre de xat i escriu «Resumeix això». Aquesta petició són 50,000+ tokens d'entrada i uns 2,000 tokens de sortida 02:14:13.
«una petició t'acaba de costar el mateix que 100 peticions normals. Sense límits, una petició dolenta pot fer saltar el pressupost diari.» 02:14:13
Observa què no falla aquí. L'usuari no ha fet res maliciós. El codi no ha donat error. La recuperació era bona. Totes les capes s'han comportat exactament com s'havien dissenyat: és l'invariant 4, les fallades són silencioses, aplicat als diners en lloc de la correcció. L'únic rastre és una línia d'una factura que llegiràs tres setmanes després.
El pressupost de tokens: un porter, no un comptable
La solució és un control d'admissió que s'executa abans de la crida a l'API. Aquest ordre és tot el valor del patró i l'instructor hi insisteix:
«cap crida a l'API, cap cost.» 02:16:18
Un comptador que s'executa després de la crida et dona una entrada de log preciosa i una factura real. Una comprovació que s'executa abans et dona un rebuig i zero dòlars 02:14:13.
La implementació són dues classes petites a cost_optimization.py. Primer, el registre comptable:
# production-course-main-code/cost_optimization.py — lines 203-233
class TokenBudget:
    """Track and limit token usage."""

    def __init__(self, max_tokens_per_request: int = 4000):
        self.max_per_request = max_tokens_per_request
        self.usage = {"total_input": 0, "total_output": 0, "requests": 0}

    def estimate_tokens(self, text: str) -> int:
        """Rough token estimation (actual would use tiktoken)."""
        return int(len(text.split()) * 1.3)

    def check_budget(self, text: str) -> tuple[bool, int]:
        """Check if request is within budget."""
        tokens = self.estimate_tokens(text)
        return tokens <= self.max_per_request, tokens

    def record_usage(self, input_tokens: int, output_tokens: int):
        """Record token usage."""
        self.usage["total_input"] += input_tokens
        self.usage["total_output"] += output_tokens
        self.usage["requests"] += 1

    def get_stats(self) -> dict:
        return {
            **self.usage,
            "total_tokens": self.usage["total_input"] + self.usage["total_output"],
            "avg_per_request": (
                (self.usage["total_input"] + self.usage["total_output"])
                / max(self.usage["requests"], 1)
            ),
        }
Tres comptadors —total_input, total_output, requests— més dues estadístiques derivades, total_tokens i avg_per_request 02:14:13. És la telemetria mínima viable de costos, i max(self.usage["requests"], 1) al denominador és el petit detall defensiu que permet cridar get_stats() abans de la primera petició.
L'estimador és deliberadament rudimentari. words × 1.3 02:15:17. La mateixa docstring ho reconeix: «el real faria servir tiktoken». La defensa de l'instructor és la millor frase del segment: això és un porter, no un comptable. La seva feina no és la precisió, és rebutjar.
«per a un control de protecció, una aproximació ja està bé.» 02:15:17
Ara l'embolcall que ho fa complir:
# production-course-main-code/cost_optimization.py — lines 236-264
class BudgetedLLM:
    """LLM with token budgeting."""

    def __init__(self, max_tokens: int = 4000):
        self.llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
        self.budget = TokenBudget(max_tokens_per_request=max_tokens)

    @traceable(name="budgeted_invoke")
    def invoke(self, query: str) -> str:
        # Check budget
        within_budget, tokens = self.budget.check_budget(query)

        if not within_budget:
            raise ValueError(
                f"Query exceeds token budget: {tokens} > {self.budget.max_per_request}"
            )

        # Execute
        response = self.llm.invoke(query)
        result = response.content

        # Record usage
        output_tokens = self.budget.estimate_tokens(result)
        self.budget.record_usage(tokens, output_tokens)

        return result

    def get_stats(self) -> dict:
        return self.budget.get_stats()
El flux, exposat clarament 02:16:18: estimar → supera el pressupost? rebutjar, cap crida a l'API, $0 → si no, cridar → registrar → retornar. El límit predeterminat és de 4,000 tokens per petició; la demostració el baixa a 100 perquè sigui fàcil activar el control.
La demostració executable i l'aritmètica exacta del rebuig
# production-course-main-code/cost_optimization.py — lines 267-286
def demo_token_budgeting():
    """Demonstrate token budgeting."""

    llm = BudgetedLLM(max_tokens=100)

    queries = [
        "What is AI?",  # Within budget
        "Explain " + "very " * 100 + "complex topic",  # Over budget
    ]

    print("\nToken Budgeting Demo:\n")

    for query in queries:
        try:
            result = llm.invoke(query)
            print(f"✅ {query[:40]}... -> {result[:30]}...")
        except ValueError as e:
            print(f"❌ {query[:40]}... -> {e}")

    print(f"\nUsage: {llm.get_stats()}")
La consulta allargada és "Explain " + "very " × 100 + "complex topic". Això es divideix en 1 + 100 + 2 = 103 paraules, i int(103 × 1.3) = 133. El control compara 133 > 100 i llança ValueError("Query exceeds token budget: 133 > 100") 02:17:18. Cap petició no arriba mai a OpenAI.
La consulta admesa "What is AI?" té 3 paraules → 3 tokens estimats d'entrada. Quan acaba, les estadístiques mostrades en pantalla són total_input = 3, total_output = 282, requests = 1, total_tokens = 285, avg_per_request = 285 02:18:19.
Observa que demo_token_budgeting() és l'única demostració que queda descomentada sota __main__ al fitxer distribuït. Si vols la demostració de memòria cau de més endavant en aquesta part, descomenta demo_caching().
Els rebutjos són esdeveniments d'observabilitat, no excepcions
invoke porta @traceable(name="budgeted_invoke"). Aquest decorador —el mateix de la part 7— fa que el ValueError llançat es capturi com una traça de primer ordre de LangSmith. Obre l'execució i hi veuràs el nom budgeted_invoke, l'entrada, una sortida null i tota la traça d'excepció amb el motiu 02:18:19. Una crida amb èxit en la mateixa vista també porta la seva xifra de latència 02:18:19.
Un rebuig que només existeix com un HTTP 400 en un log d'nginx és invisible. Un rebuig que apareix al mateix arbre de traces que les peticions amb èxit respon tant «per què això no ha funcionat?» com «amb quina freqüència rebutgem i de qui és el trànsit?», de franc.
Quatre llocs, tres fórmules, cap de correcta
El repositori compta tokens en quatre llocs i no coincideix amb si mateix en cap. Tingues present que existeixen tots quatre per no sumar accidentalment dues de les seves sortides:
| Fitxer font | Fórmula | Resultat |
|---|---|---|
cost_optimization.py:212 (TokenBudget.estimate_tokens) | int(len(text.split()) * 1.3) | int, 1.3 tokens/paraula |
cost_optimization.py:67 (ModelRouter.invoke) | len(query.split()) * 1.3 | float: mateixa proporció, sense truncament |
monitoring.py:145 (InstrumentedLLM) | len(query.split()) * 4 // 3 | int, ≈1.333 tokens/paraula |
conversation_memory.py:190 | token_counter=llm a trim_messages | depèn del proveïdor |
Són prou propers entre si per ser indistingibles en una demostració i prou allunyats de la veritat per ser inútils en una factura. La resposta real és que els models de xat moderns retornen el recompte: llm.invoke(...) retorna un AIMessage amb usage_metadata que conté input_tokens, output_tokens i total_tokens directament del proveïdor. Registra això. Fes servir l'heurística words × 1.3 només per al control previ, on encara no tens cap resposta ni alternativa.
Dos paranys més que convé anomenar abans de posar aquesta classe en producció. estimate_tokens fa servir .split(), de manera que compta paraules separades per espais en blanc: un bloc JSON de 50,000 caràcters sense espais s'estima com aproximadament un token i passa sense problemes. I TokenBudget és un objecte per procés: darrere d'un servidor d'API amb múltiples processos de treball, cadascun manté els seus comptadors, de manera que get_stats() informa de la porció d'un procés, no de la despesa del sistema.
Del control de protecció a la imputació de costos
El pas de producció no és un pressupost global: és l'atribució:
«en producció el que faríeu seria registrar aquestes estadístiques per usuari, per hora, per endpoint.» 02:19:23
Quan els comptadors porten aquestes tres dimensions pots dir «l'usuari X ha consumit 50,000 tokens avui» 02:19:23, que és la frase que obre totes les respostes comercials: limitar-ne la freqüència, facturar-li, passar-lo a un pla superior o parlar-hi. El plantejament de l'instructor és directe: esbrinar «qui impulsa el teu cost» 02:19:23.
Quan afegir pressupost de tokens 02:20:25: quan tens entrades d'usuaris, quan la longitud d'entrada és impredictible o quan necessites seguiment per usuari / endpoint per imputar costos i prevenir abusos. Dit d'una altra manera: gairebé sempre i, sens dubte, abans d'exposar un endpoint a la internet pública.
«Això no és per jugar. És cost real i us hauríeu de plantejar seriosament implementar aquestes estratègies.» 02:20:25
Els tres patrons del costat de l'LLM es componen en una sola pila
El capítol 11 tanca el segment B anomenant el conjunt complet 02:19:23:
pressupost de tokens + memòria cau + encaminament de models = control de costos d'LLM.
No són alternatives. Ataquen parts diferents de la mateixa factura i s'apilen en un ordre concret al llarg del camí de petició que, com formalitzarà la part 11, és primer els rebutjos barats, al final la inferència cara:
- Pressupost de tokens: rebutja allò que no hauries de pagar mai. Cost: zero.
- Memòria cau: retorna allò que ja has pagat. Cost: una consulta a un diccionari.
- Encaminament de models: paga el mínim pel que queda.
L'encaminador és al mateix fitxer:
# production-course-main-code/cost_optimization.py — lines 47-70
    @traceable(name="routed_query")
    def invoke(self, query: str) -> tuple[str, str, float]:
        """
        Route and invoke query.
        Returns: (response, model_used, estimated_cost)
        """
        complexity = self.classify_complexity(query)

        if complexity == "simple":
            model = self.cheap_model
            model_name = "gpt-4o-mini"
            cost_per_1k = 0.00015  # Input cost
        else:
            model = self.expensive_model
            model_name = "gpt-4o"
            cost_per_1k = 0.0025  # Input cost

        response = model.invoke(query)

        # Estimate cost (rough)
        tokens = len(query.split()) * 1.3  # Rough token estimate
        estimated_cost = (tokens / 1000) * cost_per_1k

        return response.content, model_name, estimated_cost
Dos preus, fixats al codi: gpt-4o-mini a $0.00015 per 1K tokens d'entrada i gpt-4o a $0.0025 per 1K tokens d'entrada, una diferència de 16.7×. Aquesta proporció és tot l'argument econòmic de l'encaminament. classify_complexity és una tercera instància de ChatOpenAI(model="gpt-4o-mini", temperature=0) —l'encaminador manté cheap_model, expensive_model i classifier— amb un prompt que acaba «Respon només: simple o complex». Retorna response.content.strip().lower(), i després invoke bifurca segons aquesta cadena.
Tres defectes més que cal corregir abans de producció. Els preus són constants literals que queden obsoletes tan bon punt un proveïdor canvia les tarifes: posa'ls en una taula de preus pròpia i versionada. L'estimació ignora completament els tokens de sortida, que són la part cara de la factura. I prompt.format(query=query) renderitza un ChatPromptTemplate com una cadena simple abans de lliurar-la al model i llença l'estructura de missatges; prompt.invoke({...}) o la canonada prompt | llm la conserven.
Retallar el que envies: la meitat conversacional del pressupost de tokens
Un pressupost que només rebutja és una eina poc refinada. La mesura complementària és fer les peticions més petites perquè mai no s'acostin al límit. En una aplicació RAG de xat, allò que creix sense límit no és el context recuperat: és l'historial de conversa, que es torna a enviar complet en cada torn. conversation_memory.py inclou tres estratègies amb corbes de cost realment diferents. (Procedència: aquest fitxer és al repositori del curs, però no s'explica davant la càmera en cap capítol. El codi següent se'n cita i està verificat; l'anàlisi és d'aquesta guia.)
Estratègia 1 — Retallar fins a un màxim de tokens. El trim_messages de LangChain fa els càlculs per tu:
# production-course-main-code/conversation_memory.py — lines 186-193
    trimmed = trim_messages(
        messages,
        max_tokens=60,
        strategy="last",
        token_counter=llm,
        include_system=True,  # Always keep system message
        allow_partial=False,
    )
strategy="last" conserva els missatges més recents; include_system=True fixa el prompt de sistema perquè les instruccions contra les al·lucinacions de la part 1 mai no siguin el que es descarta; allow_partial=False impedeix tallar un missatge per la meitat. Observa el parany de token_counter=llm: aquí llm és el init_chat_model("gpt-4o-mini") de nivell de mòdul. trim_messages crida el get_num_tokens_from_messages() del model, que per als models de xat d'OpenAI és un recompte local amb tiktoken, però que ChatAnthropic implementa cridant l'API de recompte de tokens d'Anthropic. Canvia de proveïdor i el mecanisme de control de costos començarà a fer un intercanvi de xarxa en cada retallada. Passa una funció de recompte explícita si vols predictibilitat.
Estratègia 2 — Una finestra fixa. Crea una subclasse de l'objecte historial i retalla:
# production-course-main-code/conversation_memory.py — lines 210-226
    class WindowedChatHistory(InMemoryChatMessageHistory):
        """Chat history that keeps only last k message pairs."""

        k: int = 3  # Pydantic field - number of exchange pairs to keep

        def add_messages(self, messages):
            super().add_messages(messages)
            # Keep only last k pairs (2k messages: human + ai)
            if len(self.messages) > self.k * 2:
                self.messages = self.messages[-(self.k * 2) :]

    store: Dict[str, WindowedChatHistory] = {}

    def get_session_history(session_id: str) -> BaseChatMessageHistory:
        if session_id not in store:
            store[session_id] = WindowedChatHistory(k=2)
        return store[session_id]
La demostració executa cinc intercanvis amb k=2 i després mostra, amb les paraules del mateix fitxer, exactament què ha destruït: Lost: name (Paulo), city (Seattle), AND job (AI engineer) en una línia i Kept: cats + the 'remember' question a la següent. La frase de resum del fitxer és l'exposició honesta del compromís:
«Aquest és el compromís: memòria fixa = cost predictible, però es perd el context antic.»
Tres coses que cal corregir si ho copies. El retall compta missatges, no torns: assumeix que cada intercanvi és exactament un missatge Human més un AI; per tant, tan bon punt un torn emet una crida a eina o una resposta de diverses parts, la finestra talla una parella per la meitat i deixa un historial que comença amb un missatge d'assistent, cosa que alguns proveïdors rebutgen directament. El valor predeterminat de classe k: int = 3 no es fa servir mai (get_session_history construeix WindowedChatHistory(k=2)), de manera que la xifra de la docstring i la de producció discrepen. I si mai deses un missatge de sistema dins de l'historial —aquesta demostració no ho fa, el prompt de sistema és al ChatPromptTemplate—, el retall cec l'expulsarà amb tota la resta.
Estratègia 3 — Resum acumulatiu. Conserva literalment els últims MAX_RECENT = 4 missatges i comprimeix tot el que és més antic en un resum que s'actualitza:
Memòria amb resum acumulatiu: tota la branca de desbordament
# production-course-main-code/conversation_memory.py — lines 349-379
        # 2. Add this exchange to recent messages
        recent_messages.append(HumanMessage(content=user_input))
        recent_messages.append(AIMessage(content=response))

        # 3. If recent messages exceed limit, summarize the oldest ones
        if len(recent_messages) > MAX_RECENT:
            # Take the oldest messages that will be summarized away
            messages_to_summarize = recent_messages[:-MAX_RECENT]
            formatted = "\n".join(
                f"{'Human' if isinstance(m, HumanMessage) else 'AI'}: {m.content}"
                for m in messages_to_summarize
            )

            # Update the running summary
            running_summary = summarize_chain.invoke(
                {
                    "current_summary": (
                        running_summary if running_summary else "None yet."
                    ),
                    "new_messages": formatted,
                }
            )

            # Keep only the most recent messages
            recent_messages = recent_messages[-MAX_RECENT:]

            print(
                f"  >>> Summarized! Compressed {len(messages_to_summarize)} old messages"
            )
            print(f"  >>> Summary: {running_summary}")
            print(f"  >>> Recent buffer: {len(recent_messages)} messages")
Val la pena copiar literalment el prompt de resum. Resumir implica pèrdua per definició; el que fa aquest prompt és dirigir la pèrdua cap a la prosa en lloc dels fets: «Conserva tots els fets clau sobre l'usuari» és la clàusula que fa la feina:
# production-course-main-code/conversation_memory.py — lines 308-314
    summarize_prompt = ChatPromptTemplate.from_template(
        "Condense the current summary and new messages into a single updated summary "
        "(2-3 sentences). Preserve all key facts about the user.\n\n"
        "Current summary:\n{current_summary}\n\n"
        "New messages:\n{new_messages}\n\n"
        "Updated summary:"
    )
El fitxer fa servir dos models expressament: summary_llm amb temperature=0 (compressió determinista) i chat_llm amb temperature=0.7 (conversa natural). El mateix truc de separació de responsabilitats de la part 5: feines diferents, mostreig diferent.
El veredicte del mateix fitxer després de cinc intercanvis: ALL facts preserved (name, city, job, cats, course) / But token cost stays bounded -- old messages are compressed, not deleted! És l'afirmació de la demostració, no una mesura; en una conversa més llarga, el resum és precisament on els fets desapareixen silenciosament, i per això el requadre següent et demana que el registris.
| Estratègia | Cost de tokens | Fidelitat | Cost ocult |
|---|---|---|---|
| Retallar fins a N tokens | Límit estricte | Només recent | El comptador de tokens pot costar una crida a l'API |
| Finestra (últimes k parelles) | Límit estricte, trivialment predictible | Es perden els fets antics, silenciosament | Assumeix 2 missatges per torn; pot dividir una parella |
| Resum acumulatiu | Acotat, no fix | Tots els fets, amb pèrdua | Una crida addicional a l'LLM per desbordament, i els resums acumulen deriva |
Observa també que store: Dict[str, ...] = {} no expulsa mai res. En un servidor és una fuga de memòria per sessió sense límit, i és per procés; per tant, falla tan bon punt executes més d'una rèplica. Dona-li suport amb Redis o SQL: SQLChatMessageHistory(session_id=..., connection=f"sqlite:///{db_path}") és la variant persistent del mateix fitxer.
Els costos reals de la cerca vectorial
El capítol 16 canvia el tema dels tokens a la infraestructura i comença amb el punt metodològic correcte, expressat com una fanfarronada:
«Us mostraré una cosa que els proveïdors no volen que vegeu: les factures reals.» 03:23:37
La substància sota el màrqueting és real: el preu a partir de d'un proveïdor descriu un índex buit sense trànsit. Un preu sense càrrega de treball no és un preu. La promesa del capítol té deliberadament dues parts 03:23:47: què costa la cerca vectorial a escales diferents i com retallar aquest cost sense sacrificar qualitat. Quatre de les cinc eines d'ajust següents compleixen la segona clàusula perquè intercanvien bytes i intercanvis de xarxa en lloc d'exhaustivitat. De la cinquena (quantització), s'afirma que no té cost de qualitat i no es mesura mai; s'assenyala allà on apareix.
Pas 1 — Defineix la càrrega de treball
Tota la primera meitat del capítol s'ancora exactament en un escenari 03:24:02:
500K documents/vectors, volum moderat de consultes = 10,000 consultes/dia. (títol de la diapositiva, 03:24:22)
Totes les xifres en dòlars següents volen dir «amb aquella càrrega de treball» i no signifiquen res en cap altre context.
Pas 2 — Calcula el preu de cada opció per a aquesta càrrega, amb l'atribut no monetari associat
Calcula el preu de tots els candidats per a la mateixa càrrega de treball. La manera més habitual d'equivocar-se no és fer malament els càlculs, sinó comparar el pla d'entrada d'un proveïdor amb el de producció d'un altre: una fila de pla gratuït i una de capacitat reservada no pertanyen a la mateixa columna.
| Opció | Cost/mes amb 500K + 10K consultes/dia | Què inclou |
|---|---|---|
| Pinecone Serverless | $20–30 | Zero càrrega operativa |
| Pinecone Pods | $70–140 | Latència garantida |
| pgvector (RDS) | $32 | Càrrega operativa baixa |
| pgvector (autoallotjat) | $15–20 | Càrrega operativa mitjana |
La diapositiva no dona mai una xifra sola: cada fila associa dòlars a un atribut no monetari, i aquesta associació és la lliçó real. Tres dels quatre atributs són càrrega operativa, una segona moneda denominada en el teu temps; el quart és una garantia de latència, que és una tercera. Tot l'interval va de $15 a $140/mes, dibuixat en un gràfic de barres amb marques etiquetades que s'aturen a $125. La conclusió de la mateixa diapositiva: «A aquesta escala, les diferències són petites. Pinecone serverless és competitiu!» 03:24:34
La fila de Pinecone Pods és la diferent i mereix un moment. Costa 2–5× Serverless i l'únic que compra el suplement és latència garantida 03:24:14: capacitat reservada, de manera que la latència de cua esdevé contractual en lloc d'una esperança. Pagues per capacitat inactiva. És una compra del pressupost de latència que arriba a la factura del pressupost de diners, i és l'exemple més clar del curs de dos pressupostos que s'intercanvien recursos.
Pas 3 — Torna a calcular els preus a 10× i 100× i mira'n la forma
Aquest és el visual central del capítol, «COSTOS A ESCALA: la divergència»: tres proveïdors, tres punts d'escala i tres corbes que se separen.
| Escala | Pinecone | pgvector (gestionat) | pgvector (autoallotjat) | Pinecone ÷ autoallotjat |
|---|---|---|---|---|
| 500K | $30 | $35 | $20 | 1.5× |
| 5M | $400 | $100 | $75 | 5.3× |
| 50M | $1,500+ | $400 | $300 | 5×+ i creixent |
Quatre coses que cal extreure d'aquesta taula.
L'ordre s'inverteix. Amb 500K, pgvector gestionat ($35) és més car que Pinecone ($30) 03:24:59. La creença popular que l'autogestió sempre és més barata és simplement falsa al començament de la corba. No assumeixis ordenacions monòtones.
500K → 5M és molest; 5M → 50M és estructural. L'instructor anomena la diferència de 5M «considerable, però no una bogeria» 03:25:52: $75 contra $400 és 5×, però només ~$325/mes en termes absoluts, menys d'un dia d'enginyer de feina operativa. Amb 50M, la diferència és de ~$1,200/mes, que són ~$14,400/any 03:26:20. El peu de la diapositiva: «A gran escala, l'autoallotjament estalvia MILERS al mes.»
Les corbes continuen divergint més enllà del gràfic. La línia de Pinecone és visiblement superlineal; la de pgvector és més propera a lineal. L'extrapolació explícita és a 100 milions de vectors, on la discrepància continua creixent 03:26:46. La diferència que pots veure amb 50M és un mínim, no un màxim.
D'aquí el parany. La història de fallada s'explica com un monòleg interior:
«Faré servir Pinecone perquè només són $30 al mes. És gestionat. Ja estic bé.» 03:27:06
…i aleshores arribes a 50M vectors i la factura és 50× més gran, i migrar un índex d'aquesta mida és un projecte, no una tarda. Triar un proveïdor és una decisió de cost de migració, no de preu 03:27:00.
Cinc eines d'ajust, ordenades per estalvi per unitat d'esforç
Sigui quin sigui el desplegament que hagis triat, s'hi apliquen les mateixes cinc optimitzacions 03:27:45. El que fa que aquesta diapositiva valgui la pena memoritzar-la no és la llista: és que cada entrada porta dues valoracions, estalvi i esforç, perquè puguis prioritzar per proporció i no per magnitud.
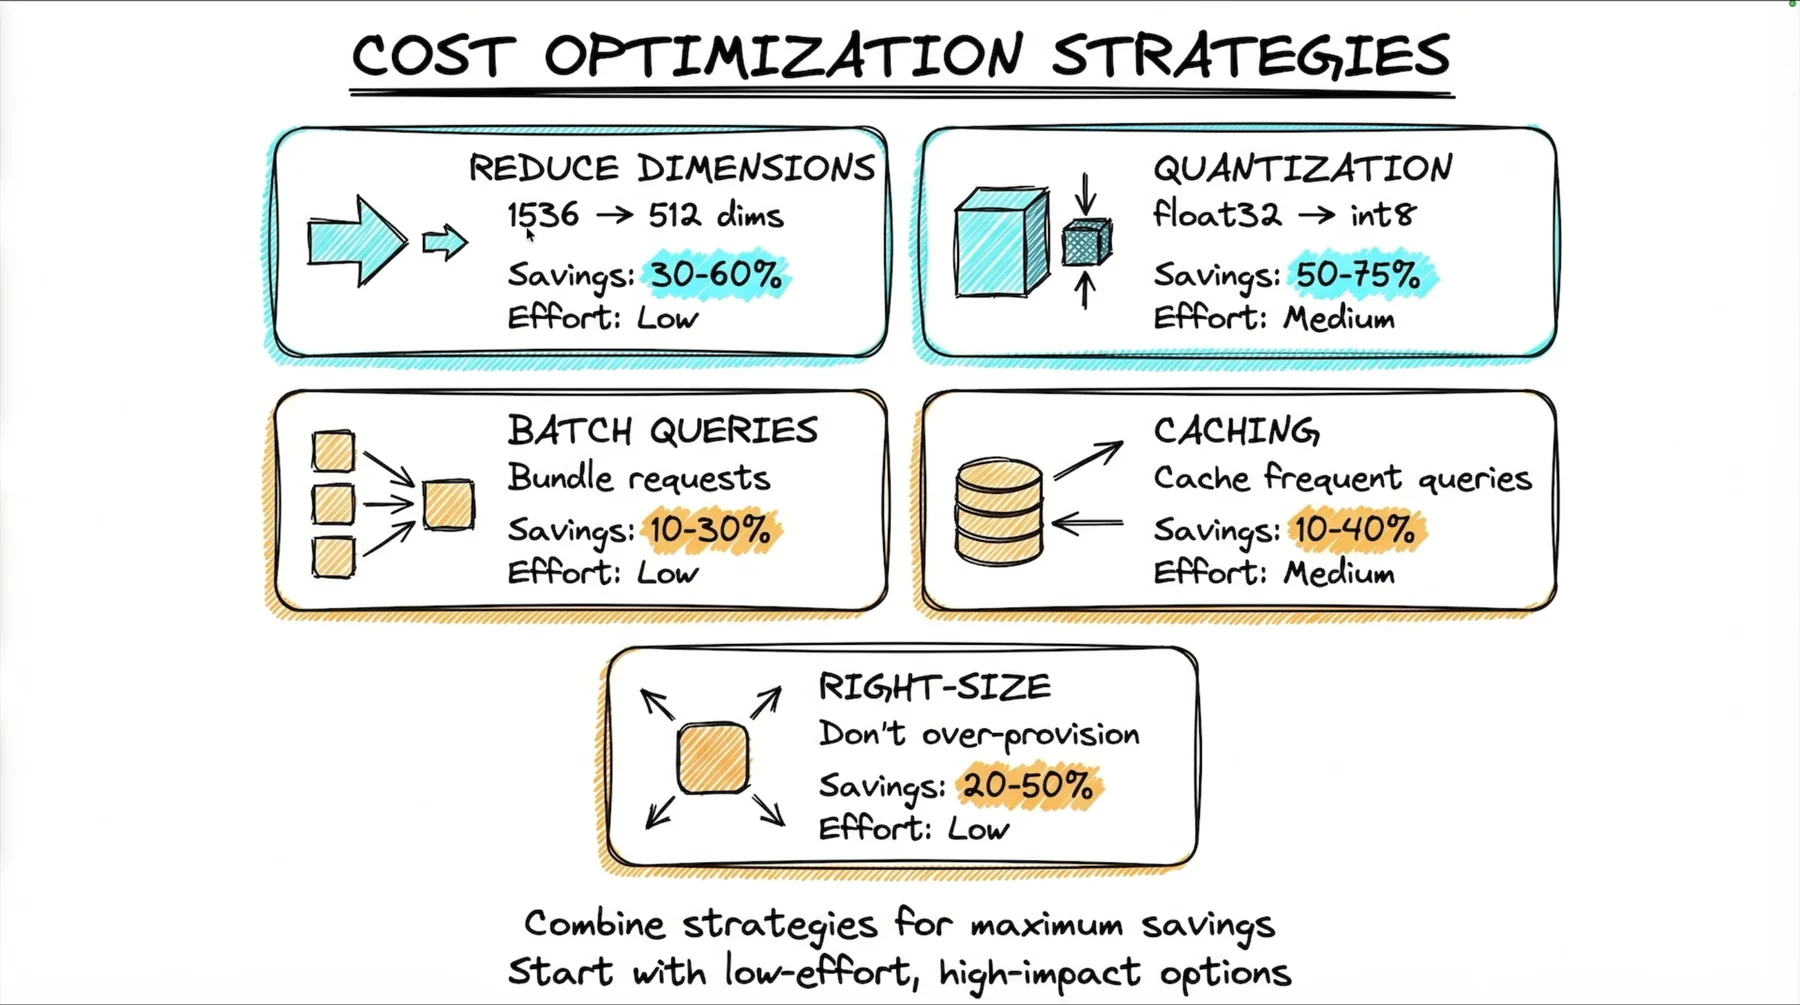
| # | Estratègia | Estalvi | Esforç | Veredicte de la proporció |
|---|---|---|---|---|
| 1 | Reduir dimensions (1536 → 512) | 30–60% | Baix | Fes això primer |
| 5 | Dimensionar correctament (no sobreaprovisionar) | 20–50% | Baix | Fes això en segon lloc, per sempre |
| 3 | Agrupar consultes en lots (agrupar peticions) | 10–30% | Baix | Fes això en tercer lloc |
| 2 | Quantització (float32 → int8) | 50–75% | Mitjà | El que més estalvia, feina real |
| 4 | Memòria cau (desar les consultes freqüents) | 10–40% | Mitjà | Depèn completament de la taxa de repetició |
La instrucció de la diapositiva: «Combina estratègies per aconseguir el màxim estalvi. Comença per opcions de poc esforç i gran impacte.»
Eina 1 — Reduir dimensions (1536 → 512)
L'emmagatzematge, la mida de l'índex, el consum de RAM i el càlcul de distància per consulta escalen linealment amb el nombre de nombres de coma flotant per vector. La majoria d'equips fan servir les 1536 dimensions predeterminades d'OpenAI i no toquen mai la configuració. Baixar a 512 és una reducció de 3× en les dades del vector per a un estalvi del 30–60% amb esforç baix: la millor proporció de la taula.
«Això és una cosa de què la gent no parla.» 03:28:12
Amb l'SDK directe d'OpenAI és un argument amb nom:
# Slide only, [03:28:35] — this exact snippet is NOT in either course repo.
response = client.embeddings.create(
    model='text-embedding-3-small',
    input='Your text',
    dimensions=512  # Reduced from 1536
)
I és persistent: tot el que es produeixi a través d'aquell model instanciat surt amb 512 dimensions a partir d'aleshores 03:28:38. L'equivalent de LangChain és un argument del constructor —OpenAIEmbeddings(model="text-embedding-3-small", dimensions=512)— i només es respecta en models text-embedding-3 i posteriors; per tant, text-embedding-ada-002 no es pot reduir així. La línia 8 d'embeddings_deep.py del repositori és la imatge d'«abans»: OpenAIEmbeddings(model="text-embedding-3-small") sense argument dimensions, és a dir, el valor predeterminat de 1536 dimensions.
Sigues precís sobre quin comptador modifica això. Les API d'embeddings facturen per tokens d'entrada, no per nombres de coma flotant de sortida; per tant, demanar 512 dimensions en lloc de 1536 no abarateix la crida d'embeddings ni un cèntim. El que redueix és la fila d'emmagatzematge, el consum de RAM de l'índex i el càlcul de distància per consulta: files 2 i 3 de la taula del començament d'aquesta part. Per això la franja d'estalvi se cita respecte del cost d'infraestructura i per això l'eina compensa més com més gran és el corpus.
La meitat de cost del compromís és el que et dona el capítol 16. La meitat de qualitat es va establir a la part 4: menys dimensions significa menys matisos semàntics, amb un punt òptim per a la majoria de casos d'ús de 768–1536. 512 queda per sota d'aquesta franja. El capítol 16 afirma l'estalvi i no mesura mai la diferència d'exhaustivitat; per tant, tracta «redueix a 512» com una hipòtesi per comparar amb A/B sobre el teu corpus amb la teva prova de recuperació (metodologia de la part 3: mesura la recuperació de principi a fi, no inspeccionis mai els vectors a ull).
Eina 2 — Quantització (float32 → int8)
On la reducció de dimensions retalla el nombre de dimensions, la quantització retalla els bytes per dimensió 03:28:47. float32 → int8 són 4 bytes → 1 byte, una reducció de 4×; la quantització binària va més enllà. Valorada amb un estalvi del 50–75% i esforç mitjà.
Les dues eines són ortogonals i es poden combinar: 1536→512 és 3×, float32→int8 és 4× i, apilades, donen aproximadament vectors 12× més petits. (L'instructor no fa mai aquesta multiplicació; la frase «combina estratègies» de la diapositiva és la mateixa afirmació en prosa. L'aritmètica és d'aquesta guia, i és un límit superior d'estalvi d'emmagatzematge, no una promesa sobre l'exhaustivitat.)
Eina 3 — Agrupar consultes en lots
L'antipatró és l'hàbit predeterminat de programar —un bucle for sobre les consultes—, i això és el que el fa perillós:
«si teniu 10,000 crides a l'API fent això, és una bogeria. Són moltes.» 03:29:42
# Slide only, [03:29:52] — generic vector-DB SDK, illustrative.
# Bad: 10,000 API calls
for query in queries:
    results = index.query(query)

# Good: Batched queries (if supported)
results = index.query(queries, batch=True)
El bucle for no és lògica incorrecta, és economia incorrecta amb tarifes per petició. El mecanisme s'exposa exactament una vegada i és tot el model:
«menys intercanvis de xarxa, cosa que significa menys costos amb tarifes basades en l'ús. Aquesta és la clau.» 03:29:59
Estalvi del 10–30%, i l'esforç es descriu com «extremament baix» 03:29:14.
I no confonguis el .batch() de LangChain amb això. Tots els Runnable —inclosos els recuperadors— exposen .batch([...]), i la implementació predeterminada executa invoke una vegada per entrada en un pool de fils: N crides concurrents, no una sola crida. Ho diu la mateixa docstring, i afegeix que les subclasses «han de redefinir aquest mètode si poden agrupar en lots amb més eficiència». Per tant, .batch() retalla el temps transcorregut i no retalla res de la factura basada en ús tret que la integració concreta l'hagi redefinit. Els lots al servidor són una propietat de l'API del proveïdor, no de la capa d'orquestració: comprova-ho per component, no ho assumeixis mai.
Tanmateix, probablement ja agrupes en lots al costat d'indexació sense adonar-te'n. embeddings_model.embed_documents([...]) rep una llista i l'empaqueta en peticions de fins a chunk_size peces cadascuna (el valor predeterminat de LangChain per a OpenAIEmbeddings és 1000): això és un lot real al servidor, i per això la ingesta massiva és barata. embed_query(text) rep una cadena única i és pel que pagues una petició en cada pregunta. L'asimetria és estructural: el camí d'indexació es pot agrupar en lots per construcció, el de consulta no, perquè la consulta no existeix fins que l'usuari l'escriu. On sí que pots agrupar realment en lots al camí de lectura és en feina fora de línia: execucions d'avaluació, noves puntuacions nocturnes, reprocessaments de dades històriques.
Eina 4 — Memòria cau, quantificada en una frase
«si el 20% de les consultes són repeticions, estalvies el 20% en càlcul» 03:30:13
El percentatge d'estalvi és la taxa de repetició. Aquest és tot el model econòmic, i vol dir que la decisió de construir una memòria cau és empírica: mesura primer la taxa de repetició. Interval de la diapositiva: estalvi del 10–40%, esforç mitjà.
L'escenari canònic és un bot de suport 03:30:20: el trànsit de suport i preguntes freqüents té una gran concentració inicial en què un grapat de preguntes domina el volum, exactament la distribució que premia una memòria cau LRU. Una eina de recerca sobre un corpus de documents únics té la distribució contrària i una memòria cau allà és pes mort.
Es poden desar dues coses a la memòria cau, en dues capes diferents 03:30:32:
- el resultat de recuperació: evitar consultar la base de dades vectorial
- la resposta: evitar també la crida a l'LLM
La memòria cau té una secció completa pròpia més avall, perquè el capítol 18 construeix totes dues capes adequadament.
Eina 5 — Dimensionar correctament, el que ningú no fa
Estalvi del 20–50% amb esforç baix, i és l'estratègia que la gent se salta perquè no s'acaba mai. El cicle 03:31:24:
- Comença amb una instància petita.
- Monitoritza l'ús.
- Escala només quan arribis a límits reals, no segons projeccions.
- Revisa els costos mensualment.
- Repeteix per sempre.
«Aquesta és la qüestió, d'acord? És un procés.» 03:31:39
Un dimensionament puntual queda desactualitzat tan bon punt canvia la forma del trànsit 03:31:53. És l'eina que depèn més directament de la part 7: sense mètriques d'ús, el pas 2 és fer suposicions i el 3 és superstició.
Memòria cau, ben feta: tres capes, tres implementacions
El capítol 18 canvia de tema a 03:54:27, de Supabase (part 10) a memòria cau, i construeix dues de les tres capes amb codi real. Combinades amb la memòria cau de recuperació del capítol 16, tens la pila completa.
| Capa | Què evita | Clau | Taxa típica d'encerts | On s'ensenya |
|---|---|---|---|---|
| Memòria cau d'embeddings | la crida a l'API d'embeddings | text del fragment (amb hash) | ~100% en una nova ingesta sense canvis | capítol divuit 03:54:27 |
| Memòria cau de recuperació | la cerca vectorial | consulta (MD5) | = taxa de repetició | capítol setze 03:30:32 |
| Memòria cau de respostes | tota la crida a l'LLM | consulta normalitzada (MD5) | 30–50% | capítol divuit 03:58:32 |
Es poden combinar. Una resposta a la memòria cau evita tot el que té al darrere; una recuperació a la memòria cau encara paga la generació; un embedding a la memòria cau només estalvia la crida d'embeddings. Ordena les comprovacions començant per la capa més externa.
Capa 1 — La memòria cau d'embeddings
«La memòria cau és molt important, especialment amb embeddings, perquè evita crides redundants a l'API.» 03:54:27
La lògica és indiscutible: generar embeddings és una crida d'inferència, es factura per tokens (part 4) i un text idèntic sempre produeix un vector idèntic. Generar l'embedding del mateix text dues vegades és malbaratament pur. Compensa sempre que el mateix text de fragment passi dues vegades pel generador d'embeddings: tornar a executar una ingesta que ha fallat a mig camí, reconstruir un índex en un magatzem nou, tornar a ingerir un corpus on només han canviat uns quants documents o l'hàbit de demostracions en bucle de la part 4, en què cada execució torna a generar tots els embeddings.
Però coneix-ne el límit, perquè és fàcil sobreestimar-lo. La clau es deriva del text; per tant, canviar el segmentador invalida tota la memòria cau: límits diferents vol dir cadenes diferents, vol dir claus diferents. La reindexació que més vols que sigui gratuïta és precisament la que no ho és.
La resposta de LangChain és un decorador al voltant de qualsevol model d'embeddings, amb suport de qualsevol magatzem de bytes:
# production-course-main-code/embeddings_deep.py — lines 69-97
def embedding_caching():
    from langchain_classic.embeddings.cache import CacheBackedEmbeddings

    from langchain_classic.storage import LocalFileStore
    import tempfile

    with tempfile.TemporaryDirectory() as tempdir:
        store = LocalFileStore(root_path=tempdir)

        cached_embeddings = CacheBackedEmbeddings.from_bytes_store(
            underlying_embeddings=embeddings_model,
            document_embedding_cache=store,
            namespace="exercise",
        )

        text = "What is Reinforcement Learning?"

        # First call - hits API
        print("First call (API):")
        vectors1 = cached_embeddings.embed_documents([text])
        print(f"  Embedded {len(vectors1)} documents")

        # Second call - from cache
        print("\nSecond call (Cache):")
        vectors2 = cached_embeddings.embed_documents([text])
        print(f"  Embedded {len(vectors2)} documents")

        # Verify same results
        print(f"\nSame vectors: {np.allclose(vectors1[0], vectors2[0])}")
Executa-ho amb uv run embeddings_deep.py i l'última línia mostra Same vectors: True 03:58:32. Observa el mètode de verificació: compara els vectors, no els temps. Els temps són sorollosos i depenen de la màquina; la igualtat de vectors és una prova. Observa també què no demostra l'exemple: totes dues crides informen de Embedded 1 documents, de manera que els recomptes mostrats són idèntics tant si s'ha activat la memòria cau com si no. Només np.allclose et diu alguna cosa.
La interfície de magatzem és deliberadament mínima: segons la docstring en pantalla, «funciona amb qualsevol magatzem que implementi la interfície abstracta de magatzem que accepta claus de tipus str i valors de llista de nombres de coma flotant» 03:58:20. LocalFileStore és una implementació d'aquest ByteStore; un magatzem amb suport de Redis, S3 o una base de dades hi encaixa sense canvis, i això fa compartible aquest patró entre processos de treball.
namespace no és decoració. 03:56:30 La clau de memòria cau es deriva del text, no del model. Desa vectors de text-embedding-3-small i text-embedding-3-large per a la mateixa cadena sense espai de noms i serviràs un vector de 3072 dimensions a un índex de 1536: l'invariant 2 vulnerat silenciosament per la teva mateixa memòria cau. La docstring de LangChain diu que s'estableixi al nom del model d'embeddings utilitzat; com que les dimensions formen part de la identitat del model, defineix l'espai de noms per model i per dimensions. El namespace="exercise" de la demostració és un nom didàctic, no un patró per copiar.
Un altre valor predeterminat que convé conèixer abans de comptar l'estalvi: from_bytes_store rep query_embedding_cache, i és False. D'entrada això només desa a la memòria cau els embeddings dels documents: la crida embed_query per petició, la que és al camí de més activitat, no té cap memòria cau. Passa query_embedding_cache=True per reutilitzar el mateix magatzem per a consultes, que és el que realment compensa quan arriba dues vegades la mateixa pregunta.
Val la pena llegir l'avís de SHA-1 en lloc de descartar-lo. El llança _warn_about_sha1_encoder() i s'informa al punt de crida, langchain_classic/embeddings/cache.py:58. Diu, en essència: SHA-1 no és resistent a col·lisions, un atacant motivat pot construir dues càrregues diferents que corresponguin a la mateixa clau de memòria cau, proporciona un codificador més fort mitjançant l'argument key_encoder i, si canvies el codificador, crea una memòria cau nova per evitar col·lisions amb les claus existents. key_encoder accepta un invocable o un dels literals "sha1", "blake2b", "sha256", "sha512".
El consell de l'instructor és:
«Rebreu aquest avís, però podeu ignorar tot això.» 03:58:32
Això està bé per a una demostració local d'un sol usuari i és incorrecte per a una memòria cau compartida o multiusuari amb organitzacions separades, on una col·lisió construïda vol dir que a una organització client se li serveix el vector d'una altra. Passa key_encoder="sha256" i continua; no costa res.
Capa 2 — La memòria cau de recuperació
El capítol 16 la mostra en una diapositiva, s'equivoca, se n'adona durant l'enregistrament i ho corregeix, cosa que la fa un recurs didàctic millor que una versió neta.
«M'adono que tinc un petit error aquí.» 03:31:11
# Slide v1, [03:31:20] — BROKEN, shown here as the trap.
import hashlib
from functools import lru_cache

@lru_cache(maxsize=1000)
def cached_search(query_hash):          # `query` is not in scope
    return vectorstore.similarity_search(query)

def search(query):
    query_hash = hashlib.md5(query.encode()).hexdigest()
    return cached_search(query_hash)
# Slide v2, [03:31:24] — the corrected version.
import hashlib
from functools import lru_cache

@lru_cache(maxsize=1000)
def cached_search(query_hash, query):
    return vectorstore.similarity_search(query)

def search(query):
    query_hash = hashlib.md5(query.encode()).hexdigest()
    return cached_search(query_hash, query)
El cos de la v1 referencia query, que no és cap paràmetre. En el millor dels casos és un NameError; en el pitjor, captura silenciosament un query de nivell de mòdul i retorna resultats per a la pregunta equivocada: una memòria cau que respon amb confiança i incorrectament, la pitjor fallada possible en un sistema RAG.
Dues coses que la versió corregida et dona de franc. functools.lru_cache(maxsize=1000) proporciona expulsió acotada dels elements utilitzats menys recentment sense infraestructura: sense Redis, sense servei, sis línies 03:31:20. I MD5 es fa servir exclusivament com a empremta de contingut de longitud fixa 03:31:02, cosa que manté uniforme la clau independentment de la longitud de consulta. Aquí no és una primitiva de seguretat i no s'ha de reutilitzar mai com a tal.
Capa 3 — La memòria cau de respostes
La tesi és una frase 03:58:32:
«No paguis dues vegades per la mateixa resposta.»
Dos passos per consulta: normalitzar i després fer el hash. (L'instructor ho anomena una «memòria cau de dues capes». Es refereix als dos passos anteriors, no a dues de les tres capes de memòria cau de la taula. Mateixa paraula, eix diferent; no deixis que et confongui.)
# production-course-main-code/cost_optimization.py — lines 101-133
class SemanticCache:
    """Cache responses with semantic similarity matching."""

    def __init__(self, similarity_threshold: float = 0.9):
        self.cache = {}
        self.threshold = similarity_threshold
        self.embedder = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    def _hash_query(self, query: str) -> str:
        """Create hash of normalized query."""
        normalized = query.lower().strip()
        return hashlib.md5(normalized.encode()).hexdigest()

    def get(self, query: str) -> Optional[str]:
        """Get cached response if similar query exists."""
        query_hash = self._hash_query(query)

        # Exact match
        if query_hash in self.cache:
            return self.cache[query_hash]["response"]

        # Could add embedding-based similarity here
        # For demo, just use exact match

        return None

    def set(self, query: str, response: str):
        """Cache a response."""
        query_hash = self._hash_query(query)
        self.cache[query_hash] = {"query": query, "response": response}

    def stats(self) -> dict:
        return {"cached_queries": len(self.cache)}
El pas 1 és query.lower().strip() 03:58:32: guanys barats, perquè els usuaris escriuen la mateixa pregunta amb majúscules/minúscules diferents i espais sobrers. El pas 2 és MD5 en un resum hexadecimal de longitud fixa 03:59:33, «també molt ràpid».
L'embolcall afegeix els comptadors i les traces:
# production-course-main-code/cost_optimization.py — lines 145-174
    @traceable(name="cached_invoke")
    def invoke(self, query: str) -> tuple[str, bool]:
        """
        Invoke with caching.
        Returns: (response, from_cache)
        """
        # Check cache
        cached = self.cache.get(query)
        if cached:
            self.cache_hits += 1
            return cached, True

        # Call LLM
        self.cache_misses += 1
        response = self.llm.invoke(query)
        result = response.content

        # Cache result
        self.cache.set(query, result)

        return result, False

    def get_stats(self) -> dict:
        total = self.cache_hits + self.cache_misses
        hit_rate = self.cache_hits / total if total > 0 else 0
        return {
            "hits": self.cache_hits,
            "misses": self.cache_misses,
            "hit_rate": f"{hit_rate:.1%}",
        }
Tres detalls de disseny que val la pena adoptar. invoke retorna una tupla (result, from_cache: bool) 04:00:34 perquè qui crida pugui saber d'on ha vingut la resposta: això permet que la demostració mostri [CACHE] o [LLM] i que una API real adjunti una capçalera X-Cache: HIT o una mètrica cache_hit=True. El camí de memòria cau continua tenint traces (@traceable(name="cached_invoke")) 04:00:34: memòria cau i observabilitat no són alternatives; vols els encerts a les traces precisament per poder calcular la taxa d'encerts des de la mateixa font de veritat que tota la resta. I en un encert la resposta torna «instantàniament. Per tant, és gratuït. Essencialment no hi ha latència». 04:01:37: és una optimització de latència disfressada d'optimització de costos.
La demostració i la xifra que produeix
# production-course-main-code/cost_optimization.py — lines 177-197
def demo_caching():
    """Demonstrate caching."""

    llm = CachedLLM()

    queries = [
        "What is Python?",
        "What is JavaScript?",
        "What is Python?",  # Cache hit
        "What is python?",  # Cache hit (normalized)
        "What is Rust?",
    ]

    print("\nCaching Demo:\n")

    for query in queries:
        result, from_cache = llm.invoke(query)
        source = "CACHE" if from_cache else "LLM"
        print(f"[{source}] {query} -> {result[:30]}...")

    print(f"\nStats: {llm.get_stats()}")
Cinc consultes, i la quarta és la interessant: "What is python?" només encerta per la .lower() d'_hash_query. El resultat mostrat 04:03:00:
Stats: {'hits': 2, 'misses': 3, 'hit_rate': '40.0%'}«Una taxa d'encerts del 40% vol dir que s'ha eliminat el 40% de les crides a l'LLM. Dues de les cinc consultes ens han costat zero.» 04:02:40
⚠️ Per reproduir-ho has d'editar el fitxer. El bloc __main__ distribuït té demo_caching() comentat i executa demo_token_budgeting() en lloc d'això. Descomenta'l i després fes uv run cost_optimization.py, l'ordre utilitzada en pantalla.
Nota de procedència. En pantalla, en el moment de l'enregistrament, el fitxer acabava just després de demo_caching(): el comentari «Production version would…» era a les línies 205–208, no 294–297. Tota la secció # === Token Budgeting === (TokenBudget, BudgetedLLM, demo_token_budgeting) es va afegir al repositori després d'enregistrar aquest capítol, i per això les dues meitats d'aquesta part provenen de capítols separats per una hora i mitja però es troben en un sol fitxer. ModelRouter ja hi era i simplement no se'n va parlar. La demostració de memòria cau també es va enregistrar en un espai de treball diferent (langc-course, Python 3.12.2) del de la meitat de Supabase del mateix capítol.
Preveu taxes d'encerts del 30–50% en producció 04:02:40, perquè el trànsit real és repetitiu: els exemples de l'instructor són «Com restableixo la contrasenya?» i «Quin és el vostre horari?». Això estalvia diners i latència: «els usuaris reben la resposta immediatament».
Què no és aquesta memòria cau
La classe s'anomena SemanticCache i no és semàntica. L'instructor ho diu ell mateix 04:02:40: després de normalitzar, continua sent una prova d'igualtat de cadenes. «Què és Python» i «Parla'm de Python» signifiquen el mateix i tenen hashes diferents; per tant, no encerten.
El fitxer conté quatre artefactes més que confondran qualsevol persona que l'ampliï:
self.embedder = ChatOpenAI(model="gpt-4o-mini", temperature=0): un model de xat assignat a
una variable anomenada embedder que no es fa servir mai. Una implementació real necessita OpenAIEmbeddings. És la línia més enganyosa del capítol.
similarity_threshold(valor predeterminat0.9) es desa i no es llegeix mai. Cap camí del codi no consumeix
self.threshold 03:59:33.
if cached:confon «absent» amb «buit».SemanticCache.get()retornaNoneen una fallada de memòria cau,
però l'embolcall comprova el valor de veritat; per tant, una resposta de cadena buida a la memòria cau es tracta com una fallada i es torna a facturar en cada petició per sempre. Comprova is not None.
self.cache = {}no té límit i és per procés. No expulsa mai res (un servidor de llarga durada té una fuga),
i darrere de N processos de treball la taxa efectiva d'encerts es divideix per N. El lru_cache(maxsize=1000) de la capa 2 resol el primer problema; només un magatzem de suport compartit resol el segon: el teu Redis o el punt global de memòria cau de LangChain, langchain_core.globals.set_llm_cache(...), apuntant a un backend compartit.
La defensa de l'instructor és que el nom és aspiracional expressament:
«Està construït per ampliar-lo amb embeddings. Per tant, la versió de coincidència exacta és el punt de partida.» 04:03:41
El pas a una memòria cau semàntica real
La recepta és un comentari al final del fitxer, i és l'últim que diu el capítol 18 abans d'acabar-se l'enregistrament:
# production-course-main-code/cost_optimization.py — lines 294-297
    # Production version would:
# 1. Embed the query into a vector
# 2. Search the cache by vector similarity
# 3. Return if similarity > threshold (e.g., 0.95)
Tres passos que ja saps construir a partir de les parts 4 a 6: generar l'embedding de la consulta, cercar en un magatzem vectorial petit de preguntes a la memòria cau i retornar la resposta emmagatzemada si la similitud més alta supera el llindar.
Mesura abans de construir
monitoring.py ja et dona l'instrument:
# production-course-main-code/monitoring.py — lines 106-111
        cache_hit_rate = (
            self.metrics["cache_hits"]
            / (self.metrics["cache_hits"] + self.metrics["cache_misses"])
            if (self.metrics["cache_hits"] + self.metrics["cache_misses"]) > 0
            else 0
        )
MetricsCollector.get_summary() ho integra en una cadena cache_hit_rate juntament amb la taxa d'errors i la latència mitjana, de manera que la xifra arriba al mateix resum que tota la resta.
Executa primer una memòria cau sense efecte: fes el hash de cada consulta, registra encert o fallada i crida sempre l'LLM. Al cap d'una setmana sabràs la taxa real de repetició i, per tant, segons el model del capítol 16, sabràs l'estalvi exacte abans d'haver escrit una línia de lògica de memòria cau. El mateix instrument respon la pregunta de dimensionament de la secció següent; no és una coincidència, és el motiu pel qual la part 7 ve abans d'aquesta.
Quina base de dades vectorial, segons l'escala del corpus
El capítol 16 acaba en una taula de consulta indexada per una xifra: quants vectors tens.
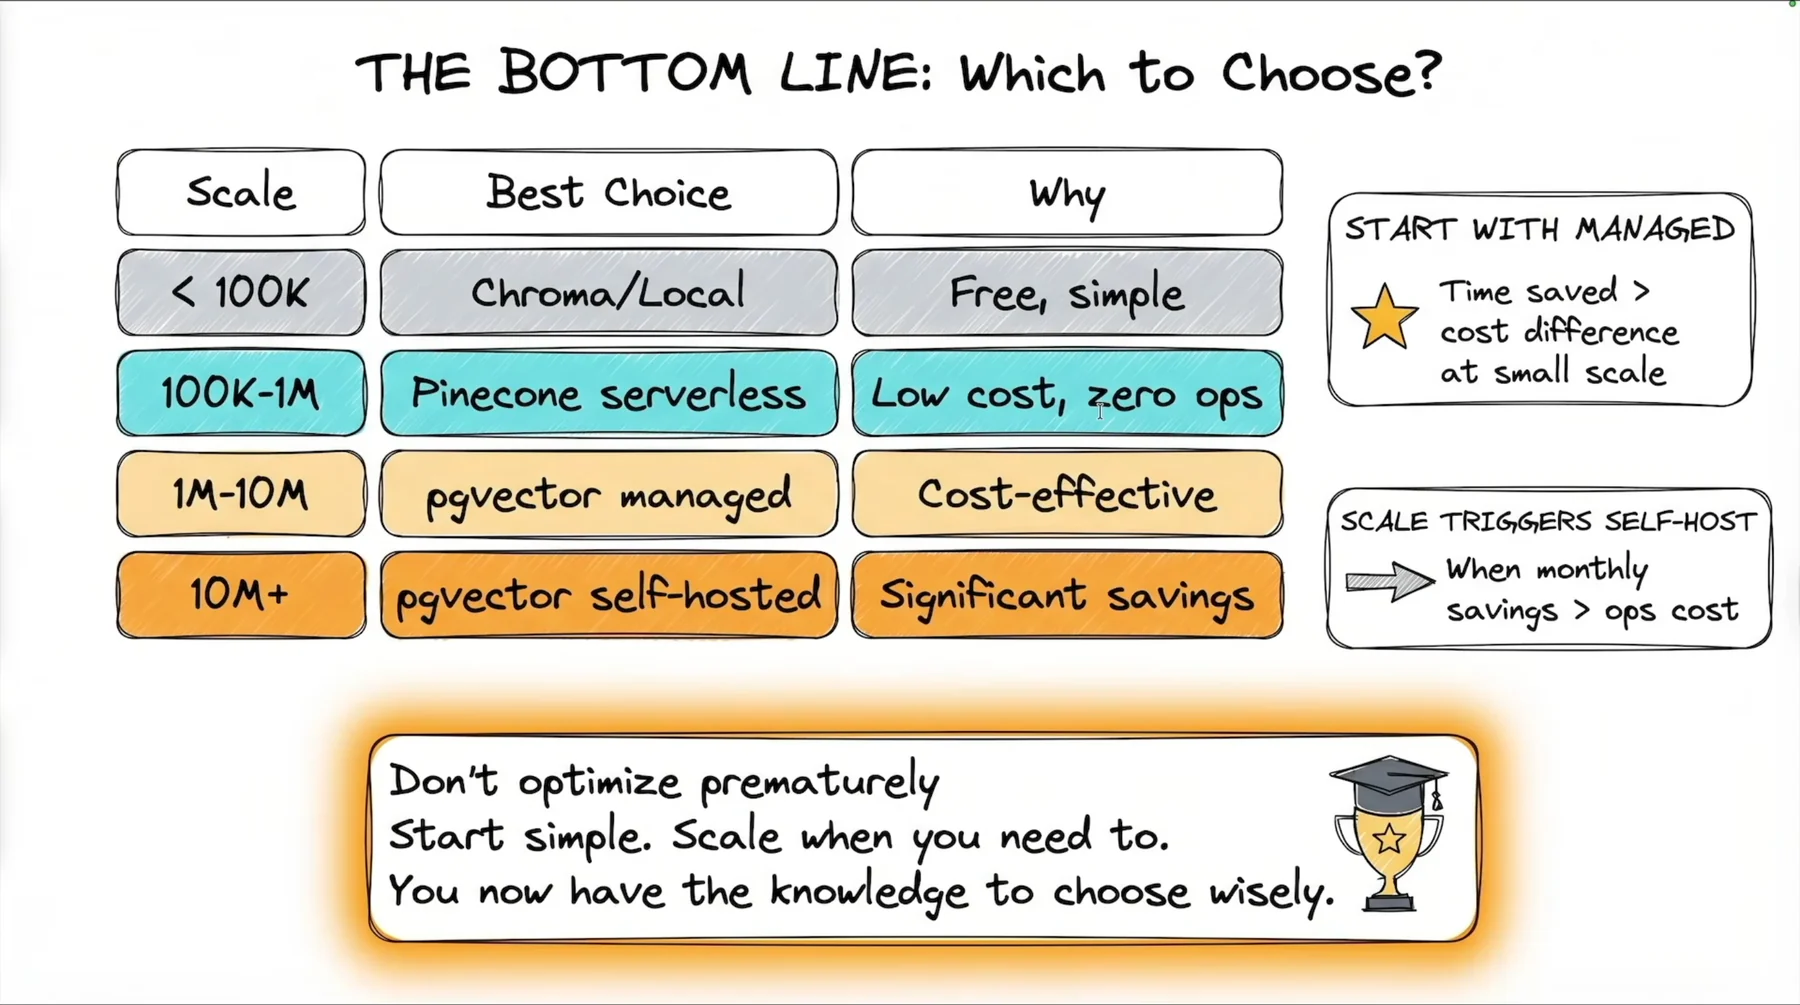
| Escala | Millor tria | Per què |
|---|---|---|
| < 100K | Chroma / local | Gratuït, senzill i, com ha mostrat la part 4, ràpid 03:32:10 |
| 100K – 1M | Pinecone serverless | Cost baix, zero càrrega operativa |
| 1M – 10M | pgvector gestionat | Bona relació cost/benefici |
| 10M+ | pgvector autoallotjat | Estalvi significatiu |
I les dues regles laterals que realment governen la decisió:
- COMENÇA AMB GESTIONAT: «Temps estalviat > diferència de cost a petita escala.» 03:32:40 Al
començament de la corba, la diferència en dòlars és més petita que el valor de les hores d'enginyeria que gastaries operant el teu Postgres.
- L'ESCALA ACTIVA L'AUTOALLOTJAMENT: «Quan l'estalvi mensual > cost operatiu.» Aquest requadre només apareix a la diapositiva;
l'instructor no el llegeix mai en veu alta, cosa que fa fàcil passar-lo per alt, i és la frase més important de la pàgina.
La instrucció final és la que estalvia més diners a la pràctica:
«No optimitzis prematurament. Comença senzill. Escala quan ho necessitis.» (diapositiva, 03:32:05)
La versió oral hi afegeix el benefici, i és la lectura correcta de tota aquesta part: l'objectiu d'aprendre a autoallotjar no és autoallotjar ara, sinó que «quan arribis a escala, on els costos importen, tindràs el coneixement d'aquest curs per autoallotjar amb eficàcia» 03:32:58. El capítol es tanca com el final de l'arc de base de dades vectorial a producció 03:33:08.
Dues referències creuades perquè puguis actuar sobre aquesta taula. L'ajust de l'índex que decideix si realment necessites el nivell següent —HNSW M i ef, escalat vertical o horitzontal— és la part 8. Les modalitats concretes d'allotjament darrere de la fila «pgvector gestionat» —Supabase, Neon, AWS RDS, amb preus mensuals reals— són la part 10.
El pressupost de latència
Els diners tenen tot un capítol; la latència té frases disperses. Munta-les tu mateix, perquè els usuaris senten la latència i només el director financer sent el cost.
Al llarg dels tres capítols en què es basa aquesta part, la font dona exactament una xifra estricta de latència: la cerca híbrida afegeix ~20–50 ms, perquè literalment executes dues recuperacions en lloc d'una 02:12:09. Tota la resta és qualitativa; per tant, la taula següent barreja xifres de la font amb derivacions marcades explícitament. No tractis cap fila sense marcar com a mesurada: mesura-la tu mateix:
| Etapa | Contribució de latència | Font |
|---|---|---|
| Control de pressupost de tokens | ~0 (un .split() i una comparació) | derivat |
| Encert de memòria cau de respostes | ~0: «és gratuït. Essencialment no hi ha latència» | 04:01:37 |
| Embedding de consulta | un intercanvi amb l'API | no quantificat a la font |
| Cerca vectorial | creix amb la mida de l'índex i ef | Part 8 |
| + Branca BM25 (híbrida) | +20–50 ms | 02:12:09 |
| + Reranking | una passada del model sobre k candidats | Part 6 |
| + Classificador d'encaminament | una anada i tornada addicional completa a l'LLM | 02:20:25 |
| Generació de l'LLM | dominant; creix amb els tokens d'entrada i de sortida | deduït |
D'aquesta taula se'n desprenen tres regles.
Ordena el pipeline començant pel que costa menys. El pipeline de peticions de producció de la part 1 — Client → Limitador de freqüència → Seguretat → Memòria cau → Model (+reintent +alternativa) → Validació de la sortida → Mètriques → Resposta — estableix un ordre de latència i cost tant com de seguretat. Primer, els rebutjos econòmics; al final, la inferència costosa. Si situes un control del pressupost de tokens després de la crida de recuperació, ja has gastat els diners i els mil·lisegons.
Algunes optimitzacions del cost empitjoren la latència. L'encaminament de models estalvia diners i afegeix una anada i tornada completa a l'LLM a cada petició 02:20:25. La cerca híbrida compra precisió i gasta 20–50 ms. La memòria de resum acota el cost en tokens i afegeix una crida addicional a l'LLM cada vegada que es desborda. Res no surt de franc — és la invariant 5, a cada capa has de «triar-ne 2», expressada en mil·lisegons.
Algunes milloren totes dues coses. La memòria cau és l'únic guany inequívoc: un encert costa zero dòlars i zero mil·lisegons. Per això, tot i tenir un esforç qualificat de mitjà i una franja d'estalvi poc espectacular del 10–40%, la memòria cau acostuma a ser el primer que cal implementar després d'ajustar la infraestructura a les necessitats.
I la fila dels Pods de la taula de preus anterior és l'única partida de tota aquesta part que compra exclusivament latència: entre 2–5× el preu de Serverless, a canvi únicament d'una garantia de latència a la cua de la distribució 03:24:14. Si tens un SLA de p99, aquest sobrecost no és un malbaratament; si no en tens, sí que ho és.
Posar-hi xifres: un model de costos resolt
El curs no arriba a multiplicar les seves pròpies constants. Fer-ho és la manera més ràpida de veure quina palanca importa. Els càlculs següents són deduccions, no citacions — però totes les constants són xifres documentades, i cadascuna indica la seva font.
La càrrega de treball és el cas de referència del capítol 16 03:24:02: 500K vectors, 10,000 consultes/dia. L'estructura de la petició és la que el curs modela a la seva calculadora de context llarg enfront de RAG (part 14): 4 fragments recuperats × 500 tokens de context, una consulta de 100 tokens, una resposta de 500 tokens — 2,100 tokens d'entrada, 500 de sortida. Els preus són text-embedding-3-small a $0.02/1M tokens (part 4), l'entrada de gpt-4o-mini a $0.15/1M ($0.00015/1K, fixat al codi de cost_optimization.py), i gpt-4o a $2.50/1M d'entrada, $10.00/1M de sortida (les constants de la calculadora del curs).
En indexar, una sola vegada. 500K fragments × 500 tokens = 250M tokens → $5.00 per generar els embeddings de tot el corpus. Una vegada. És la invariant 3 feta realitat: la xifra que preocupa tothom és la més barata de la pàgina — fins que canvies el fragmentador, moment en què la tornes a pagar.
Embedding en temps de consulta. 100 tokens × 10,000/dia × 30 = 30M tokens/mes ≈ $0.60/mes. Negligible — i precisament per això l'elecció de la dimensionalitat és una decisió d'emmagatzematge i latència, no de factura d'embeddings.
Base de dades vectorial. Cas de referència del capítol 16: $20–30/mes a Pinecone Serverless, $15–20 amb allotjament propi.
Generació, per petició, 2,100 d'entrada + 500 de sortida:
- Amb
gpt-4o: 2,100 × $2.50/1M = $0.00525 d'entrada, més 500 × $10.00/1M = $0.00500 de sortida →
$0.01025 per petició. Amb 10,000 consultes/dia, són $102.50/dia — la xifra exacta que 01_long_context_vs_rag.py imprimeix al seu bloc «amb 10,000 consultes/dia» → ~$3,075/mes.
- Amb
gpt-4o-mini: el repositori només calcula el preu de l'entrada — 2,100 × $0.15/1M = $0.000315 per petició →
~$95/mes, i això és un mínim. La tarifa de sortida de mini no apareix enlloc a la font.
Torna a llegir el primer punt: amb aquesta estructura, els tokens de sortida costen tant com els d'entrada, tot i que l'entrada és quatre vegades més gran, perquè cada token de sortida costa 4× més. Qualsevol model de costos que només compti l'entrada — i el mateix ModelRouter del curs fa exactament això — s'equivoca aproximadament per un factor de dos.
| Concepte facturable | Cost mensual amb 500K / 10K consultes al dia | Proporció |
|---|---|---|
| Embeddings del corpus ($5.00 una vegada, amortitzats durant un any) | ~$0.42 | <1% |
| Embeddings de les consultes | ~$0.60 | <1% |
| Base de dades vectorial (Pinecone Serverless) | $20–30 | ~24% |
Generació (gpt-4o-mini, només entrada) | ~$95 | ~75% |
Les proporcions es calculen amb els $30 de l'extrem superior de l'interval de la base de dades vectorial; amb $20, la proporció de la generació puja al 82%. Amb gpt-4o, la comparació deixa de tenir sentit: ~$3,075 de generació davant de $20–30 de base de dades deixen la infraestructura en un 1% de la factura.
Tres advertiments, explícits i sense amagar-los. (1) Això suposa una crida a l'LLM per consulta — les consultes múltiples, el reranking, un classificador d'encaminament o un bucle d'agent multipliquen cadascun la fila de generació i cap d'ells no afecta la fila de la base de dades. (2) Els preus són els del repositori i les diapositives en el moment de l'enregistrament i canviaran; mantén una taula de preus pròpia i versiona-la. (3) La fila de la base de dades és la que creix de manera superlineal: amb 50M vectors són $1,500+/mes, mentre que la fila de generació per petició no ha canviat. L'ordre d'aquesta taula depèn de la teva escala; per tant, torna a calcular-la amb 10× abans d'actuar.
Ara aplica les palanques. Una taxa d'encerts del 40% a la memòria cau de respostes elimina el 40% de totes dues files, la de generació i la d'embeddings de consulta: ~$95 → ~$57 amb mini, ~$3,075 → ~$1,845 amb gpt-4o. És l'única palanca que afecta la fila més gran. Encaminar la meitat del trànsit de gpt-4o a gpt-4o-mini redueix la meitat de la factura corresponent a l'entrada de ~$1,575 a ~$835, descomptant el cost per petició del mateix classificador. Reduir la dimensionalitat no afecta cap d'aquestes files tret de la de $20–30 — i continua valent la pena, perquè és la fila que es converteix en $1,500+ amb 50M vectors.
Decisions que cal prendre
Treballa de dalt a baix. Cada punt és una decisió amb una opció per defecte, no una tasca.
- Quina és la teva càrrega de treball, en dues xifres? Nombre de vectors i consultes/dia. Anota-les. Cap
preu d'aquesta part no té sentit sense totes dues. Torna a calcular els preus amb 10× i 100× les xifres actuals abans de triar proveïdor — l'ordre s'inverteix.
- Quin nivell de base de dades vectorial? <100K → Chroma/local. 100K–1M → Pinecone serverless. 1M–10M → pgvector
gestionat. 10M+ → pgvector amb allotjament propi. Tria un servei gestionat per defecte mentre l'escala sigui petita, i migra quan es compleixi la desigualtat estalvi mensual > cost d'operacions, no quan arribis a un nombre de vectors.
- Quina dimensionalitat d'embedding tens, i l'has triada tu? 1536 és un valor per defecte, no una decisió.
512 estalvia un 30–60% amb un esforç baix, però sacrifica matisos semàntics i no es pot canviar sense regenerar tots els embeddings. Decideix-ho abans de la primera ingesta de producció. Compara la sensibilitat de recuperació amb una prova A/B sobre el teu corpus.
- Hi ha un control previ de tokens a tots els endpoints de cara a l'usuari?
TokenBudgetamb un
max_tokens_per_request que hagis justificat realment (el valor per defecte del codi és 4,000). La comprovació s'ha d'executar abans de la crida a l'API. Afegeix un segon límit independent als tokens de sortida i substitueix també .split() per un control de longitud en caràcters; altrament, un contingut sense espais passa de llarg sense cap impediment.
- Els comptadors de tokens es desglossen per usuari, hora i endpoint? Si no pots respondre «qui està
disparant el meu cost», no pots limitar la freqüència, facturar ni negociar. Factura a partir de AIMessage.usage_metadata, mai d'una estimació de words × 1.3; reserva l'estimació per al control previ, on encara no hi ha resposta.
- Coneixes la taxa de repetició de les consultes? Instrumenta durant una setmana una memòria cau que no actuï abans d'implementar-ne una
de real. Estalvi ≈ taxa de repetició. Espera un 30–50% en trànsit de suport o de preguntes freqüents, i gairebé zero en trànsit de recerca.
- Quines capes de memòria cau tens en funcionament? Memòria cau d'embeddings (emmagatzematge persistent, amb espais de noms segons el model
i dimensions, key_encoder="sha256", query_embedding_cache=True si vols estalviar en les consultes), memòria cau de recuperació (lru_cache(maxsize=1000), clau normalitzada, retorna una còpia), memòria cau de respostes (normalització → hash → emmagatzematge acotat). Mai un diccionari sense límits en un servidor amb diversos processos de treball — fes servir un backend compartit, amb un Redis propi o langchain_core.globals.set_llm_cache.
- La teva memòria cau «semàntica» és realment semàntica? Si és el
SemanticCachedel curs, fa
una coincidència exacta després de .lower().strip() — posa-li un nom honest, o implementa la millora: embedding → cerca vectorial → retorn si se supera un llindar. Comença per la xifra més alta de la font (0.95, no el 0.9 del constructor), registra la puntuació de similitud de cada encert i abaixa el llindar només si les dades ho justifiquen.
- Has limitat el creixement de les converses? Tria entre retallada, finestra o resum i tingues clar què destrueix cada
opció. La retallada i la finestra perden fets antics silenciosament; el resum els conserva, costa una crida addicional a l'LLM per desbordament i acumula desviacions. En qualsevol cas, registra el resum.
- L'encaminament de models compensa el seu cost, i com es comporta quan falla? El classificador implica una crida completa a l'LLM
per petició. Compara mensualment la despesa del classificador amb l'estalvi de l'encaminament, prova primer un classificador heurístic i fes que el model barat sigui l'alternativa davant de qualsevol classificació no reconeguda — la versió del curs fa el contrari.
- Processes per lots allà on l'SDK ho admet? Confirma que ho admeti abans de basar-hi el disseny.
embed_documents([...]) ja és un lot al servidor; el .batch() d'un Runnable només aporta concurrència al client; index.query(queries, batch=True) pot existir o no al teu client.
- Quan fas la revisió mensual de costos? Ajustar la infraestructura a les necessitats aporta un 20–50% amb un esforç baix i és la palanca
que la gent es deixa perquè no s'acaba mai. Instància petita → monitoratge → escalat quan s'arriba als límits reals → revisió mensual → repetició.
- Has escrit el pressupost de latència? Una fila per etapa, una assignació de p95 a cadascuna i després un
temporitzador a cada fila (part 7). Posa la taula en servei abans d'optimitzar res — la cerca híbrida costa 20–50 ms, l'encaminament costa una anada i tornada completa, un encert de memòria cau no costa res i la fila que et menteix no és mai la que sospites.
- Has tornat a passar tota aquesta llista amb 10× l'escala actual? Tots els ordres de prioritat d'aquesta part depenen de la
càrrega de treball: la base de dades vectorial representa ~24% de la factura amb 500K vectors i és la partida dominant amb 50M, mentre que el cost de generació per petició no varia. Programa aquesta nova comprovació a la mateixa cita del calendari que la revisió mensual de costos.