
Escalat: ajust de l'índex, HNSW i quan fragmentar en shards
Els paràmetres M i ef de HNSW, recall i latència, escalat vertical i quan cal distribuir l'índex.
Tot el que hem fet fins aquí ha fet que el sistema sigui bo. Aquesta part fa que sobrevisqui al creixement, i comença amb l'observació que el creixement trenca RAG d'una manera que no veuràs a la bateria de proves.
La seqüència de fallada sempre és la mateixa 03:12:59. Desenvolupes amb uns quants milers de documents. Les consultes tornen instantàniament. Publiques. En producció hi ha cent mil documents, o un milió, o deu milions —la resposta del mateix instructor a «quants?» és «qui ho sap?»— i dues coses van malament alhora:
- Les consultes es tornen lentes. Els mil·lisegons es converteixen en segons.
- Les consultes es tornen incorrectes —l'«o pitjor» de l'instructor— perquè l'índex mai no s'ha
configurat per a aquesta escala.
La segona és la que et costarà un trimestre. Un índex aproximat insuficientment ajustat no llança cap excepció, no registra cap avís i no retorna menys resultats. Retorna k documents amb exactament la forma de la resposta adequada, però que simplement no són els veritables veïns més propers. És l'invariant 4 del model mental —les fallades són silencioses— apareixent a la capa d'infraestructura, i és el motiu pel qual aquesta part ve després de l'observabilitat (part 7) en lloc d'abans: tots els criteris d'activació d'aquesta part són xifres que ja has d'estar mesurant.
En l'esquema de dues fases, aquesta part modifica exactament dues caselles: Emmagatzematge + Índex a la fase A i Recuperació a la fase B. No canvia el chunking, els embeddings ni els prompts. Precisament això és el que la fa perillosa: pots degradar la qualitat de recuperació sense tocar ni una línia de codi d'aplicació.
Ajustar l'índex és l'única optimització d'aquesta guia que pot empitjorar les respostes mentre tots els quadres de comandament continuen en verd.
Generar embeddings no és indexar
Ara cal recuperar la llavor plantada a la part 1, perquè sense això la resta d'aquesta part és inintel·ligible. Un magatzem vectorial fa dues coses independents, i la gent les confon habitualment:
- La generació d'embeddings decideix on cau un vector a l'espai. És una propietat del model.
- La indexació decideix com trobes els veïns d'un punt un cop tots són en aquell
espai. És una propietat de l'estructura de dades construïda sobre els vectors.
Són ortogonals. Pots tenir embeddings perfectes i un índex mal ajustat (geometria correcta, veïns equivocats retornats) o embeddings inútils i un índex perfecte (recuperes els veritables veïns més propers d'un punt sense sentit, impecablement). Els dos modes de fallada semblen idèntics des de fora —«no s'ha recuperat el fragment adequat»— i tenen solucions completament diferents.
| Propietat | Decideix | S'estableix en | Cost de canviar-la | Signatura de fallada |
|---|---|---|---|---|
| Model d'embeddings | on és cada vector | el moment de la indexació; després queda congelat per sempre | tornar a generar els embeddings de tot el corpus: factura completa d'API + reconstrucció completa | incomparabilitat silenciosa (invariant 2); dimensions incompatibles fallen de manera evident, mateixes dimensions amb model diferent fallen silenciosament |
| Tipus d'índex + M | el graf pel qual cerques | el moment de construir l'índex | reconstruir el graf sobre els vectors existents: sense regenerar embeddings, sense cost d'API | exhaustivitat silenciosament per sota del 100%; resultats plausibles però no òptims |
| Esforç de cerca (ef) | quant d'esforç dediques a buscar en aquesta consulta | el moment de la consulta a pgvector, a nivell de col·lecció a Chroma | de gratuït a barat: canviar una configuració, sense reconstruir | l'exhaustivitat cau a mesura que creix el corpus, sense cap canvi de codi |
Aquesta tercera fila és tot el motiu pel qual val la pena llegir aquesta part. Hi ha un paràmetre en tota la pila de recuperació que no costa res canviar, no requereix reconstrucció i mou la precisió diversos punts. La majoria d'equips no el toquen mai perquè no saben que existeix.
HNSW, amb el nivell de detall que realment necessites
La majoria de bases de dades vectorials indexen amb HNSW —grafs Hierarchical Navigable Small World— o alguna cosa estretament relacionada. L'instructor n'anomena quatre: Pinecone, pgvector, Chroma i Qdrant 03:12:59. (Qdrant s'anomena exactament una vegada en les set hores i mitja de curs i no s'hi torna mai.)
La idea essencial: en lloc de comparar la consulta amb cada vector emmagatzemat —exacte però O(n), inutilitzable amb un milió de vectors—, HNSW construeix un graf on cada vector és un node connectat a un grapat de veïns, disposats en capes. Una cerca entra per la capa superior dispersa, avança voraçment cap a la consulta, baixa una capa, torna a avançar i acaba amb un recorregut detallat a la capa inferior. Visites uns centenars de nodes en lloc d'un milió.
El preu és al nom de la família: ANN — veí més proper aproximat. El recorregut del graf pot quedar atrapat en un veïnat local i passar per alt un vector realment més proper que és a una aresta inexplorada de distància. L'aproximació no és un error que puguis eliminar: és el compromís que acceptes a canvi d'una cerca sublineal. El que fan els dos paràmetres és recuperar precisió, un amb memòria i l'altre amb temps.
El curs és explícit i, crec, encertat sobre l'abast:
«No cal que entengueu l'algoritme en profunditat… Però sí que heu d'entendre els dos paràmetres que ho controlen tot.» 03:12:59
Pren-ho al peu de la lletra amb un advertiment: l'abstracció de dos paràmetres és suficient per operar un índex. No és suficient per depurar una exhaustivitat patològica, on comencen a importar coses com la mètrica de distància, la normalització dels vectors i la probabilitat d'assignació a capes. M i ef cobreixen més del noranta per cent de l'ajust de producció.
Paràmetre 1 — M, el nombre d'amics que té cada vector
M és el nombre màxim de connexions (arestes) per node del graf. Imagina l'espai vectorial com un graf de nodes amb arestes entre ells; M és quantes arestes rep cada node.
L'analogia del curs és la que val la pena memoritzar:
«penseu-hi com una xarxa social. Una m baixa… vol dir que tothom coneix vuit persones. Una m alta vol dir que tothom en coneix 64.» 03:15:03
Més amics vol dir que pots arribar a qualsevol objectiu amb menys salts, de manera que el recorregut voraç troba el veïnat real amb més fiabilitat. També vol dir que emmagatzemes totes aquestes arestes a la RAM, per sempre, per a cada vector del corpus. I construir el graf és més lent, perquè cada inserció ha de triar i mantenir més connexions.
| Franja de M | Valors | Mida de l'índex | Velocitat de construcció | Precisió |
|---|---|---|---|---|
| Baixa | 8–16 | més petita | construccions més ràpides | més baixa |
| Predeterminada | 16 | equilibrada | equilibrada | equilibrada |
| Alta | 32–64 | més gran | construccions més lentes | més alta |
La diapositiva 11 dibuixa M com un selector amb marques a 8 / 16 / 32 / 64 i encercla 16 com a valor predeterminat, sota la llei d'una línia:
«Més M = més connexions = més memòria = millor precisió.» — diapositiva, 3:13:45
Observa que augmentar M et costa dues vegades: un índex resident més gran i una construcció o reindexació més lenta 03:14:01. Aquest doble cost és el motiu pel qual el consell d'ajust de més avall mou primer ef i deixa M per al final.
Paràmetre 2 — ef, quant s'esforça la cerca
ef és la mida de la llista dinàmica de candidats que es manté durant una cerca 03:15:03. Quan el recorregut avança pel graf, manté un conjunt de treball amb els millors candidats trobats fins aleshores i continua expandint a partir d'ells; ef és la mida màxima que pot assolir aquest conjunt de treball abans que la cerca es doni per acabada. Una llista més gran vol dir explorar més graf, més oportunitats d'escapar d'un òptim local i millor exhaustivitat, però també més càlculs de distància per consulta.
| Franja d'ef | Valors | Velocitat de cerca | Precisió |
|---|---|---|---|
| Baixa | 32–64 | més ràpida | més baixa |
| Predeterminada | 64–128 | equilibrada («aquest bon efecte d'equilibri») | equilibrada |
| Alta | 200+ | més lenta | més alta |
El selector d'ef de la diapositiva 11 va per 32 / 64 / 128 / 256, amb la zona 64–128 encerclada, i enuncia la franja superior com «Alta (200+): més precisió». La narració diu «entre 200 i 500» 03:15:03. En realitat no es contradiuen: la franja de la diapositiva és oberta i el selector simplement deixa de dibuixar-se a 256. La xifra que importa és 200, perquè és la que fa servir la configuració predefinida d'alta precisió; considera qualsevol valor més enllà de 256 com a territori fora del selector on només entres amb una mesura d'exhaustivitat a la mà.
«Més ef = més esforç de cerca = més lent = millor precisió.» — diapositiva, 3:13:45
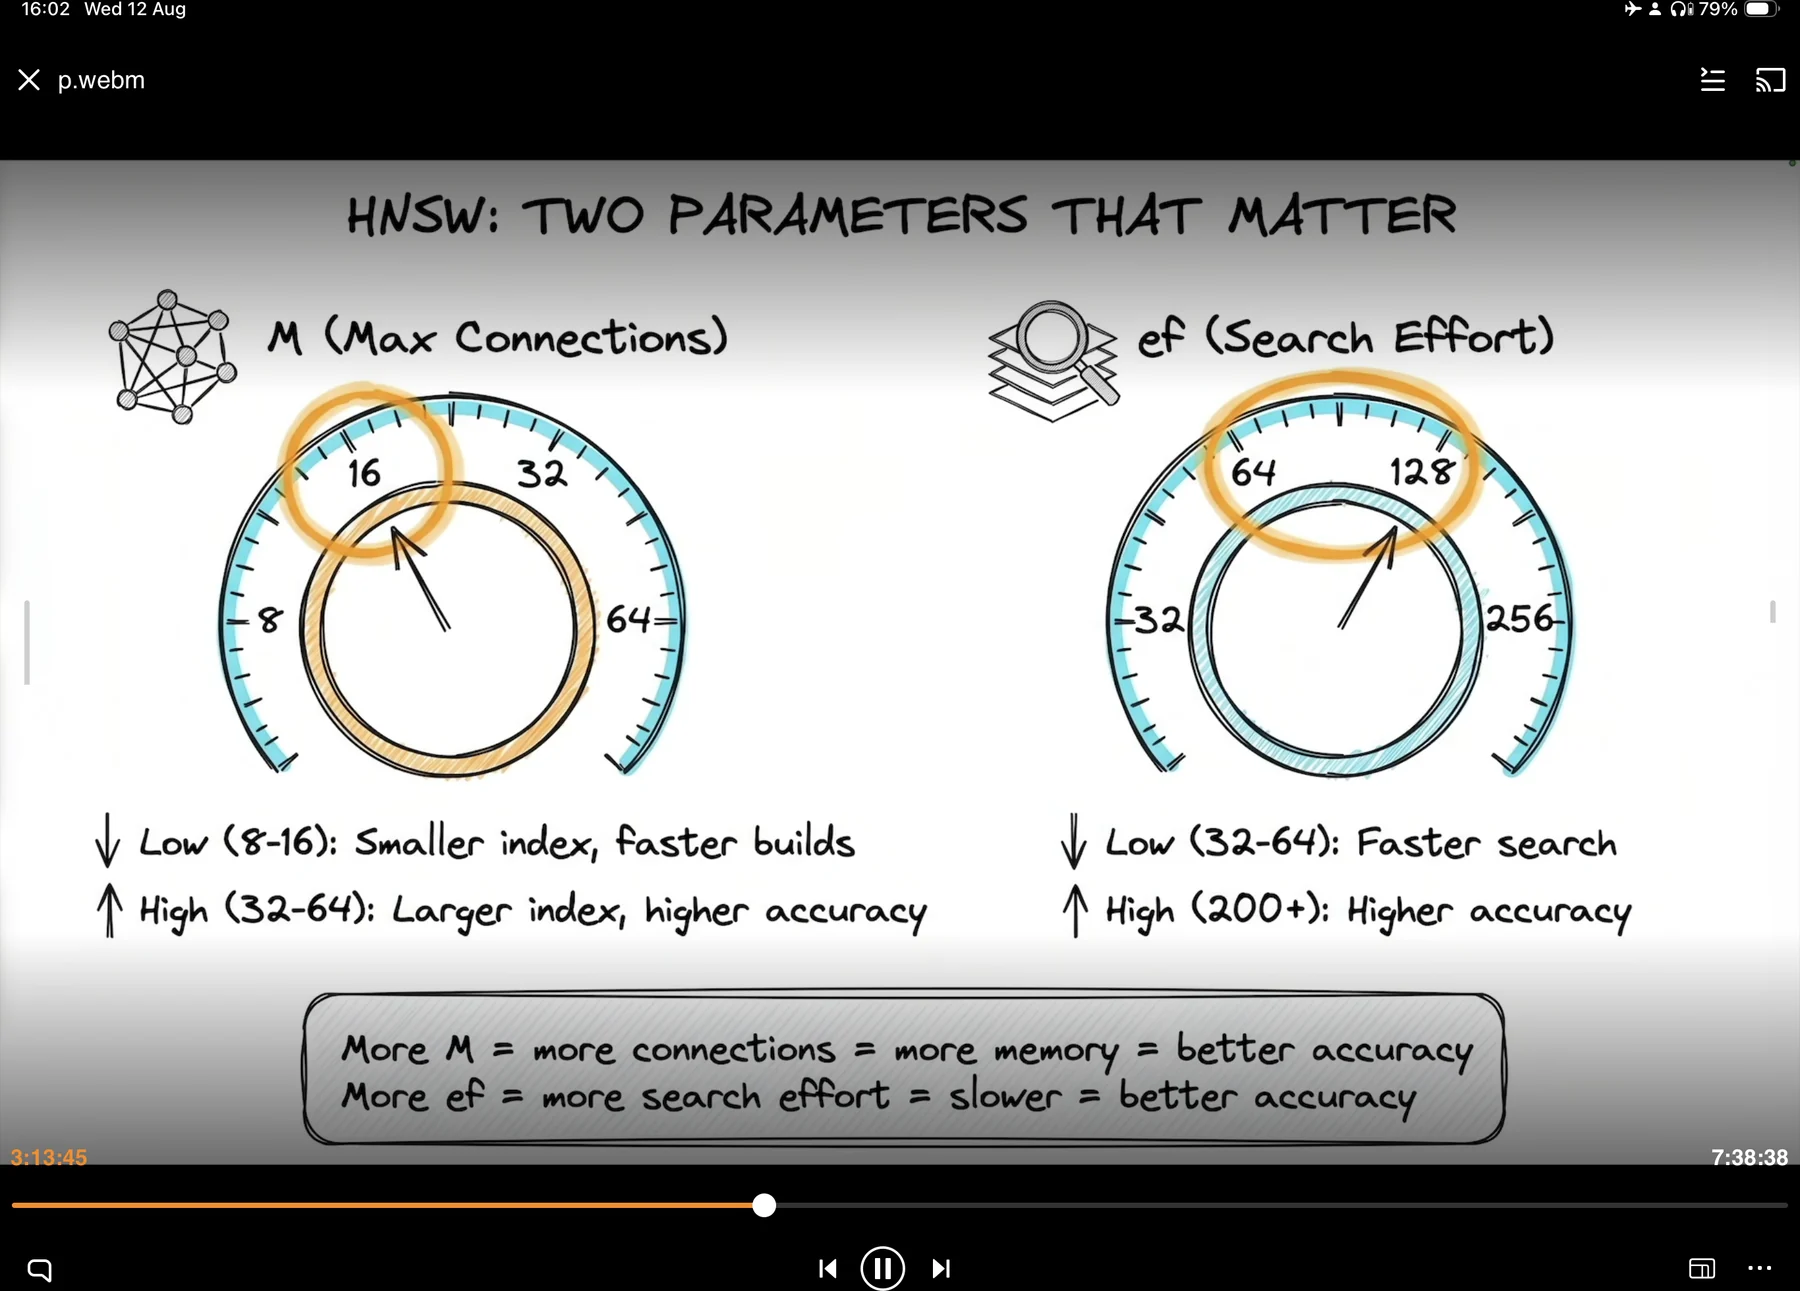
L'asimetria que ho governa tot
La diapositiva dibuixa M i ef com dos selectors idèntics. No ho són, i la diferència és el més útil per actuar de tot aquest capítol:
- M queda fixat en el moment de la construcció. Canviar-lo implica reconstruir l'índex.
- ef no. S'estableix quan el graf ja existeix i es pot augmentar sense tornar a generar l'embedding
de res.
Com de barat és «no quedar fixat» depèn del magatzem, i val la pena saber-ho abans de planificar-hi al voltant:
- pgvector: realment per petició.
SET hnsw.ef_searchés una configuració de sessió, de manera que consultes
diferents en connexions diferents poden fer servir valors diferents.
- Chroma: una configuració de nivell de col·lecció. La tries en crear la col·lecció i, en les
versions actuals, la pots canviar després amb collection.modify(...). El que no pots fer és variar-la per consulta.
- Pinecone: no s'exposa en absolut.
Per tant, quan falti precisió, augmenta primer ef. És reversible, barat de provar i no requereix regenerar embeddings. Augmenta M —i paga una reconstrucció més RAM permanent— només quan ef tot sol no et permeti arribar-hi.
Tres paràmetres amb dos noms
El parany de noms més problemàtic d'aquest material. «ef» a la diapositiva vol dir esforç de cerca, però l'exemple de pgvector següent estableix ef_construction, i l'«ef» de la taula de configuracions predefinides és un valor de cerca. Tres coses diferents:
| Paràmetre | Quan s'aplica | Efecte | Reversible? |
|---|---|---|---|
m | construcció | arestes per node; densitat del graf | requereix reconstrucció |
ef_construction | construcció | quant s'esforça el constructor en cercar mentre insereix cada vector: qualitat del graf, permanentment | requereix reconstrucció |
ef_search | cerca | quant s'esforça el recorregut a buscar | sí, sense reconstrucció |
ef_construction no és un paràmetre de rendiment per als usuaris; és un paràmetre de qualitat del graf mateix. Si el poses massa baix, produeixes un graf permanentment mediocre que cap quantitat d'ef en el moment de la cerca no pot rescatar del tot. Si el poses alt, pagues una vegada, en construir, en temps transcorregut.
El compromís de producció: tria'n dos
«malauradament no podeu tenir tots tres funcionant alhora» 03:16:04
Tres vèrtexs —Precisió, Velocitat, Memòria— i les paraules del mig de la diapositiva són TRIA'N 2. És l'invariant 5 del model mental concretat a la capa d'índex, i els tres vèrtexs es corresponen un a un amb els tres pressupostos de la guia: la precisió és el pressupost de qualitat, la velocitat és el de latència i la memòria és el de diners (la RAM és la partida que llogues per mesos). Cada decisió d'índex d'aquesta part és una transferència entre aquests tres comptes.
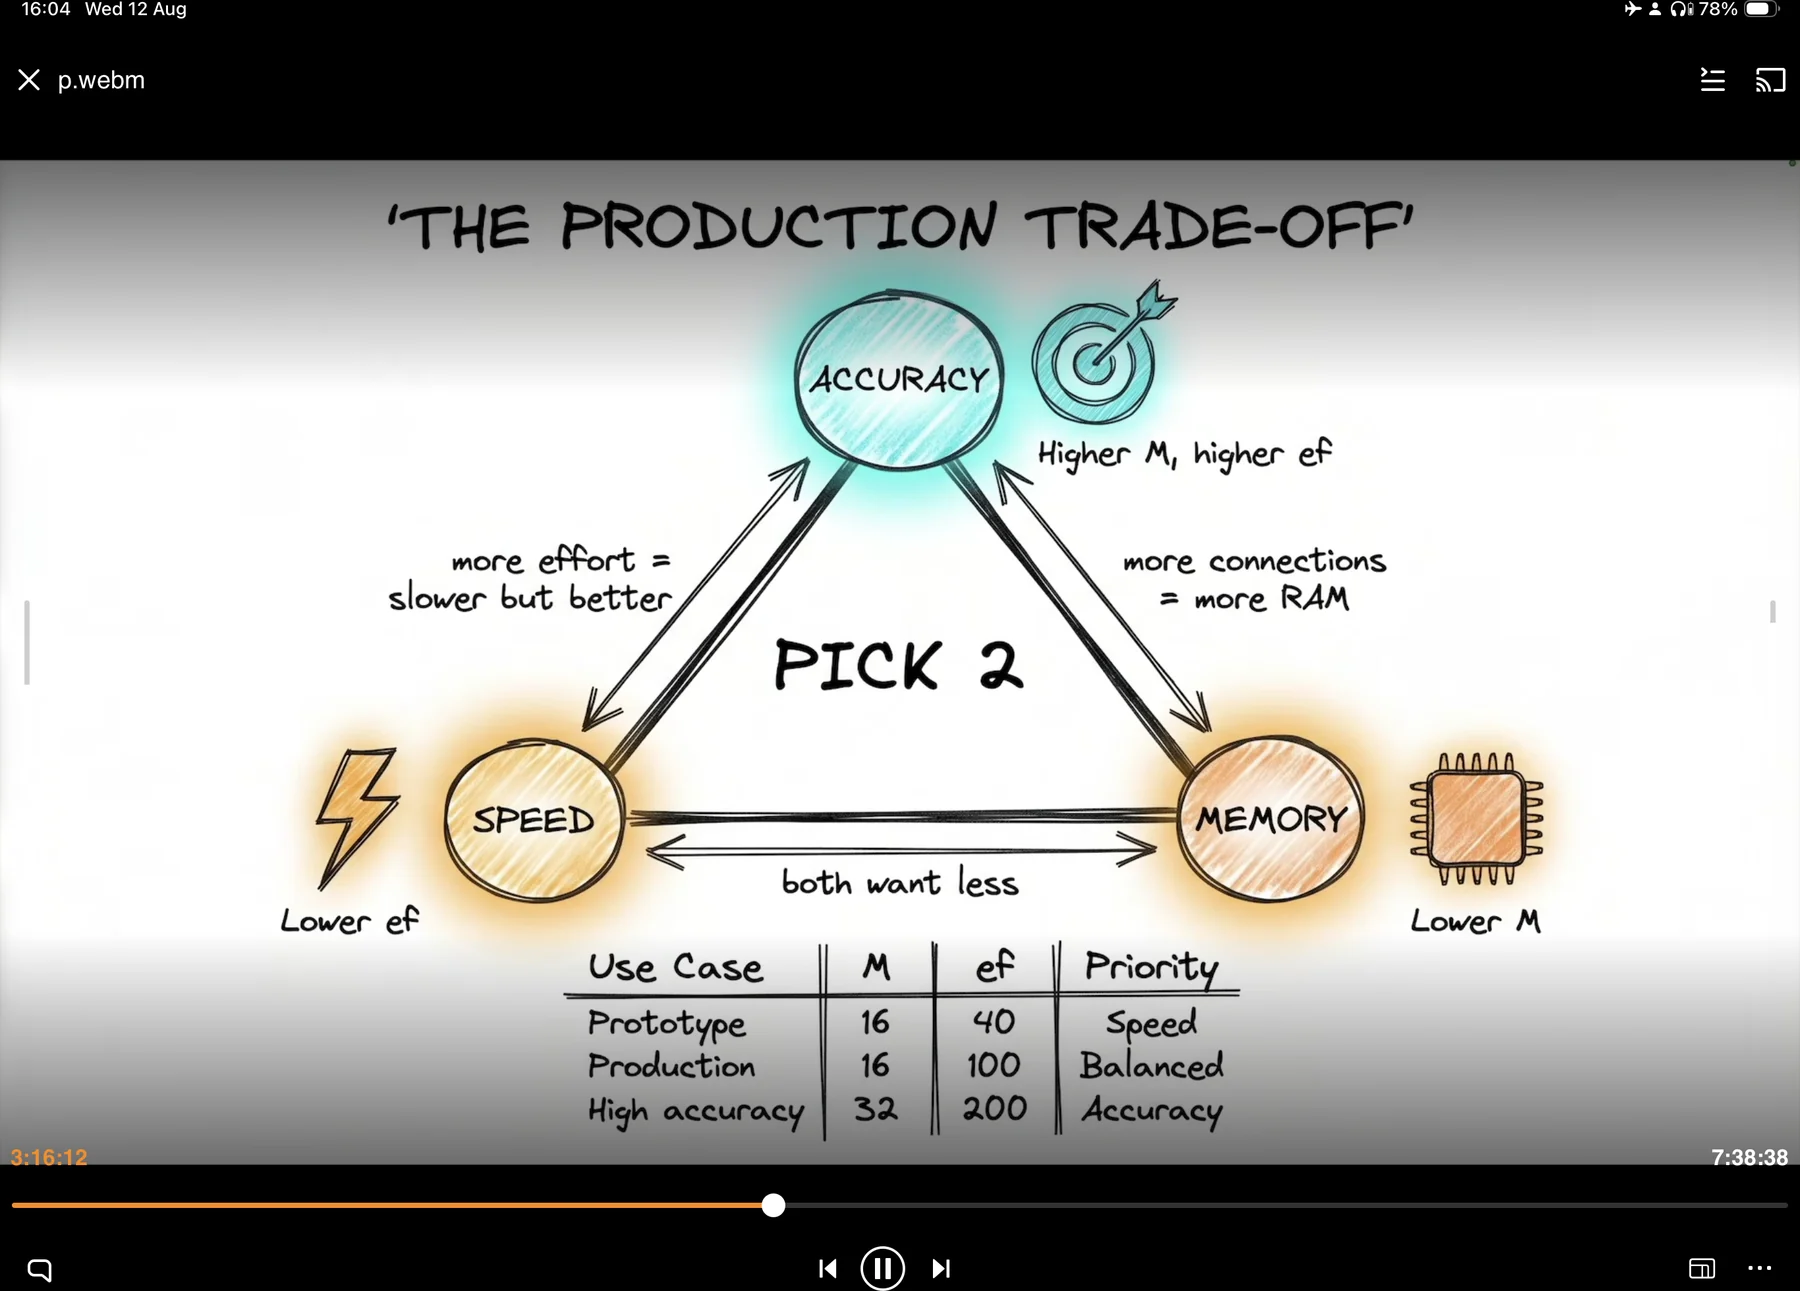
Les tres eines d'ajust, exposades com si-aleshores-paga 03:16:04:
| El teu objectiu | Acció | El preu que pagues |
|---|---|---|
| Precisió elevada | augmentar tant M com ef | memòria i velocitat |
| Consultes més ràpides | reduir ef | precisió |
| Índex més petit | reduir M | precisió |
Les etiquetes d'arestes i vèrtexs de la diapositiva codifiquen la geometria, i val la pena llegir-les amb atenció:
- Velocitat ↔ Precisió: «més esforç = més lent però millor» (aquesta aresta és ef; el vèrtex VELOCITAT està
anotat amb «ef més baix»)
- Memòria ↔ Precisió: «més connexions = més RAM» (aquesta aresta és M; el vèrtex MEMÒRIA està
anotat amb «M més baix»)
- Velocitat ↔ Memòria: «totes dues en volen menys»
- I al costat de PRECISIÓ: «M més alt, ef més alt», l'únic vèrtex que et costa tots dos recursos
Aquesta tercera aresta és la idea clau. La velocitat i l'estalvi de memòria no estan en tensió entre si: tots dos volen configuracions més petites i barates. La tensió real és d'un contra dos: precisió contra la parella. Això reformula tot l'exercici: no equilibres tres coses, sinó que decideixes quanta velocitat i RAM estàs disposat a gastar per comprar exhaustivitat.
«normalment trieu-ne dos, no podeu triar-ne tres.» 03:16:04
Les tres configuracions predefinides
Aquest és el resultat pràctic del capítol: la taula al peu de la diapositiva 12, també llegida en veu alta 03:16:04–03:17:04:
| Cas d'ús | M | ef | Prioritat |
|---|---|---|---|
| Prototip | 16 | 40 | Velocitat |
| Producció | 16 | 100 | Equilibri |
| Precisió elevada | 32 | 200 | Precisió |
Mira la forma d'aquest consell en lloc de les xifres. M passa de 16 → 16 → 32. ef passa de 40 → 100 → 200. En tot l'interval, del prototip d'un sol ús al sistema amb precisió crítica, M canvia exactament una vegada i ef canvia per un factor de 5×. Les configuracions predefinides són en si mateixes un argument a favor d'«ajusta ef, deixa M en pau», que és exactament el que prediu l'asimetria entre construcció i cerca.
Dues notes sobre les xifres:
- ef = 40 per al prototip se situa dins de la franja baixa declarada (32–64), però no és una de les marques del
selector. Llegeix-ho com «deliberadament barat», no com una constant màgica.
- L'instructor ho matisa explícitament: són «punts de partida molt bons» 03:17:04 que cal
comprovar amb el teu cas d'ús, no respostes. Valors des d'on mesurar.
Establir els paràmetres, per base de dades
Tres proveïdors, tres interfícies realment diferents, i un no té cap interfície d'ajust.
pgvector — SQL, dues vegades
Ho escrius una vegada en construir, en DDL, i una en consultar:
-- build time: M and ef_construction are baked into the index
CREATE INDEX ON documents
  USING hnsw (embedding vector_cosine_ops)
  WITH (m = 16, ef_construction = 64);

-- query time: raise search effort for higher accuracy (slower)
SET hnsw.ef_search = 100;
vector_cosine_ops és la classe d'operadors de distància del cosinus: la classe ha de coincidir amb l'operador de distància amb què realment cerques (<=> per al cosinus), o el planificador ignorarà l'índex i recorrerà la taula seqüencialment. Observa també que els m = 16, ef_construction = 64 del DDL són els valors predeterminats de pgvector; per tant, aquesta instrucció documenta una intenció més que no pas canvia el comportament; la línia que el canvia és la segona.
La segona instrucció és un GUC de sessió: s'aplica a les consultes posteriors d'aquella connexió. En una aplicació amb pool de connexions, això és un parany: estableix-lo una sola vegada a l'arrencada i s'aplicarà silenciosament a la connexió que casualment s'hagi obtingut en aquell moment i a cap altra. Estableix-lo cada vegada que obtinguis una connexió o limita'l a la transacció amb SET LOCAL hnsw.ef_search = 100 dins de la transacció que executa la cerca. (El punt del pool i el de la classe d'operadors són meus, no del curs; el del pool és la manera més habitual com aquesta configuració no s'arriba a aplicar en producció.)
Chroma — Un diccionari de metadades en crear la col·lecció
Chroma exposa els paràmetres HNSW com entrades amb prefix hnsw: al diccionari de metadades de la col·lecció, establertes quan es crea:
# Chroma native client — HNSW settings live in collection metadata
collection = client.create_collection(
    name="my_collection",
    metadata={
        "hnsw:space": "cosine",
        "hnsw:M": 16,
        "hnsw:construction_ef": 100,
        "hnsw:search_ef": 100,
    },
)
I a través de l'embolcall de LangChain que fa servir realment tot el curs:
from langchain_chroma import Chroma

vectorstore = Chroma.from_documents(
    documents=docs,
    embedding=embeddings_model,
    persist_directory="./chroma_db/",
    collection_metadata={
        "hnsw:space": "cosine",
        "hnsw:M": 16,
        "hnsw:construction_ef": 100,
        "hnsw:search_ef": 100,
    },
)
Tres coses sobre això que la font no t'explica i que valen més que el mateix fragment. Totes tres s'han comprovat amb les versions que fixa el repositori d'aquesta guia, chromadb 1.4.1 / langchain-chroma 1.1.0:
1. Els valors predeterminats de Chroma ja són la configuració de producció, tret de la mètrica. Una col·lecció creada sense cap metadada HNSW resulta en {space: "l2", ef_construction: 100, ef_search: 100, max_neighbors: 16, …}. max_neighbors és M. Per tant, la fila de producció del curs (M = 16, ef = 100) no és un canvi a Chroma, sinó una reformulació del que ja fa Chroma. L'única cosa que val la pena establir explícitament és hnsw:space, que té com a valor predeterminat L2, no cosinus. Amb els embeddings d'OpenAI normalitzats a la unitat, L2 i cosinus ordenen idènticament, de manera que això no trenca l'ordenació, però sí que canvia l'escala de puntuacions; precisament per això la part 4 insisteix que un llindar de distància mai no es pot traslladar entre magatzems.
2. Pots tornar a llegir què ha construït realment Chroma. No confiïs que la configuració s'hagi aplicat: verifica-ho:
# Verified on chromadb 1.4.1: legacy hnsw:* keys are translated into the modern config
print(vectorstore._collection.configuration_json["hnsw"])
# {'space': 'cosine', 'ef_construction': 100, 'ef_search': 100, 'max_neighbors': 16, ...}
3. Una clau mal escrita falla de dues maneres completament diferents. Una clau dins de l'espai de noms hnsw: que Chroma no reconeix —hnsw:m en minúscula, o hnsw:ef_search quan el nom antic és hnsw:search_ef— fa que create_collection llanci InvalidArgumentError: Failed to parse hnsw parameters from segment metadata. Una clau que omet completament el prefix —"M": 16— s'accepta, es desa com a metadada ordinària de col·lecció i no fa absolutament res. La fallada evident és la que et dona sort.
El Chroma més recent també accepta una configuració estructurada en lloc de les claus antigues de metadades, que langchain_chroma exposa com collection_configuration=. Són les mateixes tres xifres amb noms millors i, a diferència del diccionari de metadades, es poden actualitzar en una col·lecció existent:
# modern equivalent; max_neighbors is M, and modify() works after creation
collection = client.create_collection(
    name="my_collection",
    configuration={"hnsw": {"space": "cosine", "ef_construction": 100,
                            "max_neighbors": 16, "ef_search": 100}},
)
collection.modify(configuration={"hnsw": {"ef_search": 300}})  # no rebuild
Aquesta crida modify és el més a prop que Chroma arriba al SET per petició de pgvector: canvia l'esforç de cerca d'una col·lecció existent sense regenerar cap embedding. També és l'única manera admesa de canviar ef després: reobrir una col·lecció amb metadades diferents no funciona, que és el requadre següent.
Pinecone — Sense paràmetres d'ajust
«no us heu de preocupar d'això, però podeu controlar el nombre de resultats. En aquest cas, top K.» 03:18:05
Pinecone ajusta automàticament HNSW segons el teu tipus de pod. Tu tries el pod; Pinecone tria M i ef. Tota la interfície d'ajust d'aquesta part se substitueix per dues decisions: quin pod i quin top_k.
Això es ven com a comoditat, i en gran part ho és. Però observa què costa: estàs gastant la columna de control del compromís entre servei gestionat i autoallotjat. Si necessites un comportament d'índex determinista i reproduïble —per exemple, un benchmark d'exhaustivitat en una bateria d'avaluació que no pot canviar sota els teus peus entre execucions—, l'ajust automàtic és una limitació, no només una funcionalitat. I observa que el plantejament de pods descriu el nivell de Pinecone basat en pods; el nivell serverless que la mateixa escala de recomanacions de la part 9 tria per a 100 K–1 M vectors no té cap pod per dimensionar, cosa que redueix encara més la interfície a només top_k.
| Proveïdor | Interfície en construir | Interfície d'esforç de cerca | Qui tria |
|---|---|---|---|
| pgvector | WITH (m=…, ef_construction=…) al DDL | SET hnsw.ef_search = …, per sessió o per transacció | tu, plenament |
| Chroma | collection_metadata={"hnsw:M": …, "hnsw:construction_ef": …} en crear | hnsw:search_ef en crear, o modify(configuration=…) després: mai per consulta | tu, en crear |
| Pinecone | cap: tipus de pod | cap: només top_k | Pinecone |
| Qdrant | Configuració HNSW (anomenada una vegada a la font, mai desenvolupada) | — | tu |
El codi que el curs no va escriure mai
Un fet contundent que convé dir clarament: cap repositori del curs no conté ni una sola configuració HNSW. Cercar hnsw, ef_search, ef_construction, collection_metadata i create index tant a production-course-main-code/ com a fcc-production-rag-part-6/ no retorna res. Aquest capítol és 100% diapositives: no s'obre cap editor, no s'executa res.
Per tant, aquest és el fitxer que hauria d'haver editat. Totes les construccions de Chroma del repositori funcionen amb els valors predeterminats originals:
# production-course-main-code/vector_stores.py:50-58, as shipped
def chroma_basics():
    with tempfile.TemporaryDirectory() as tmpdir:
        # create vector store from documents
        vectorstore = Chroma.from_documents(
            documents=SAMPLE_DOCS, embedding=embeddings_model, persist_directory=tmpdir
        )
        print(
            f"Vector store created {vectorstore._collection.count()} documents and persisted."
        )
Sense collection_metadata: per tant, tots els magatzems de chroma_basics(), similarity_search_with_scores(), metadata_filtering(), as_retriever(), persist_chroma() i de l'exercici del final del fitxer es construeixen amb M = 16, ef_construction = 100, ef_search = 100 i L2. Amb vuit documents de mostra és un comportament del tot correcte: el graf és molt més petit que la llista de candidats, de manera que cada cerca és efectivament exhaustiva i l'exhaustivitat és 1.0 per construcció. També és el motiu pel qual mai no observaràs un problema d'ajust d'índexs en aquest repositori, que és precisament el parany de «el desenvolupament és una mentida» amb què comença el capítol.
La versió ajustada de la mateixa funció: la diferència d'una línia:
# vector_stores.py, tuned: the production preset stated explicitly at collection creation
def chroma_basics_tuned():
    with tempfile.TemporaryDirectory() as tmpdir:
        vectorstore = Chroma.from_documents(
            documents=SAMPLE_DOCS,
            embedding=embeddings_model,
            persist_directory=tmpdir,
            collection_metadata={          # <-- the whole of Part 8, in one kwarg
                "hnsw:space": "cosine",
                "hnsw:M": 16,
                "hnsw:construction_ef": 100,
                "hnsw:search_ef": 100,
            },
        )
        cfg = vectorstore._collection.configuration_json["hnsw"]
        print(f"{vectorstore._collection.count()} docs indexed with {cfg}")
k no és ef, i ef ha de ser ≥ k
La font no ho diu i causa problemes. El k del recuperador i l'ef de l'índex són xifres diferents en capes diferents:
# vector_stores.py:129-131 — k is an application-layer setting
retriever = vectorstore.as_retriever(
    search_type="similarity", search_kwargs={"k": 3}
)
k és quants documents vols rebre. ef és quants candidats pot considerar el recorregut del graf per trobar-los. La llista de candidats ha de ser almenys tan gran com el conjunt de resultats; per tant, ef_search ≥ k sempre, i fer que ef_search sigui significativament més gran que k és d'on prové realment la precisió. Si fas servir el recuperador MMR del mateix fitxer, observa que fetch_k augmenta la demanda real del conjunt de resultats:
# vector_stores.py:141-144 — MMR fetches 5, returns 3 diverse
mmr_retriever = vectorstore.as_retriever(
    search_type="mmr",
    search_kwargs={"k": 3, "fetch_k": 5},  # fetch 5 docs and return 3 diverse
)
Amb fetch_k=5, l'índex ha de produir cinc candidats; per tant, ef_search=40 dona un marge còmode de 8× i ef_search=100 en dona un de 20×. On això va malament és a l'altre extrem: un pipeline de reranking (part 6) que recupera k=100 per reduir després a 5 demana a l'índex 100 resultats amb una llista de candidats de 100, una proporció d'1.0, que és la pitjor configuració possible d'exhaustivitat. Si fas reranking, augmenta ef.
Mesura-ho tu mateix: un entorn de proves d'exhaustivitat que no necessita clau d'API
El capítol afirma que ef compra precisió i no ho mostra mai. Això sí que ho fa, fora de línia, en uns trenta segons. DeterministicFakeEmbedding substitueix un model d'embeddings real perquè l'índex sigui l'única variable, i un recorregut de cosinus per força bruta sobre els mateixos vectors proporciona la referència real contra la qual es puntua el resultat ANN.
# Original: an offline recall harness. Needs chromadb + langchain-chroma + numpy.
import tempfile

import numpy as np
from langchain_chroma import Chroma
from langchain_core.embeddings import DeterministicFakeEmbedding

PRESETS = {
    "prototype":     {"hnsw:space": "cosine", "hnsw:M": 16, "hnsw:construction_ef": 100, "hnsw:search_ef": 40},
    "production":    {"hnsw:space": "cosine", "hnsw:M": 16, "hnsw:construction_ef": 100, "hnsw:search_ef": 100},
    "high_accuracy": {"hnsw:space": "cosine", "hnsw:M": 32, "hnsw:construction_ef": 200, "hnsw:search_ef": 200},
}


def effective_hnsw_config(vectorstore: Chroma) -> dict:
    """Read back what Chroma built, not what you asked for."""
    return vectorstore._collection.configuration_json["hnsw"]


def recall_at_k(vectorstore, embeddings, texts, queries, k=5) -> float:
    matrix = np.array(embeddings.embed_documents(texts))
    matrix /= np.linalg.norm(matrix, axis=1, keepdims=True)
    hits = 0
    for query in queries:
        qv = np.array(embeddings.embed_query(query))
        qv /= np.linalg.norm(qv)
        exact = {texts[i] for i in np.argsort(-(matrix @ qv))[:k]}  # brute force = ground truth
        approx = {d.page_content for d in vectorstore.similarity_search(query, k=k)}
        hits += len(exact & approx)
    return hits / (k * len(queries))


embeddings = DeterministicFakeEmbedding(size=1536)
texts = [f"document number {i}" for i in range(2000)]
queries = texts[::200]

for name, preset in PRESETS.items():
    with tempfile.TemporaryDirectory() as tmpdir:
        store = Chroma.from_texts(
            texts=texts, embedding=embeddings,
            persist_directory=tmpdir, collection_metadata=preset,
        )
        cfg = effective_hnsw_config(store)
        print(
            f"{name:14s} M={cfg['max_neighbors']:3d} ef_search={cfg['ef_search']:4d} "
            f"recall@5={recall_at_k(store, embeddings, texts, queries):.2f}"
        )
Sortida típica amb 2 000 vectors (chromadb 1.4.1; les xifres exactes es mouen un punt o dos entre execucions):
prototype      M= 16 ef_search=  40 recall@5=0.90
production     M= 16 ef_search= 100 recall@5=0.97
high_accuracy  M= 32 ef_search= 200 recall@5=1.00
Tres coses que n'has d'extreure. Primer, les configuracions predefinides són reals: l'ordre és exactament el que afirma la diapositiva. Segon —i aquest és l'objectiu de tota la part—, totes tres execucions han retornat cinc documents i no han llançat res. La configuració de prototip ha perdut un veí real de cada deu i no te n'ha dit res. Tercer, observa com de sorollós és 10 consultes × k = 5: cinquanta judicis no són suficients per distingir un canvi de dos punts d'exhaustivitat, que és la primera lliçó sobre la mida del conjunt de referència. Els vectors gaussians aleatoris en 1536 dimensions també són un cas deliberadament difícil per a ANN; per tant, llegeix aquestes xifres com un límit inferior, no com una previsió per al teu corpus.
Quan escalar: quatre símptomes, quatre diagnòstics
Abans de comprar res, anomena el símptoma. La taula del curs 03:18:05–03:19:07:
| Símptoma | Causa probable | Solució |
|---|---|---|
| Les consultes triguen ≥ 100 ms | l'índex és massa gran per a la memòria | afegeix més RAM o distribueix-lo en shards |
| Pics de latència d'inserció | coll d'ampolla d'escriptura | escala les escriptures per separat |
| Errors de memòria esgotada | l'índex no s'ajusta al que estàs fent | instància més gran o distribució en shards |
| Caiguda de precisió | ef_search massa baix per a la nova escala | augmenta ef o distribueix en shards |
Tres observacions que la taula no fa per tu.
El llindar de 100 ms és de cerca vectorial, no de principi a fi. El p95 dels usuaris està dominat per la generació, que es mesura en segons. Per tant, un pas de recuperació de 100 ms no és una emergència de latència per a l'usuari: és un diagnòstic que l'índex ha deixat de cabre còmodament a la RAM. Tracta'l com una alarma de memòria disfressada de latència.
La fila 4 és la important i és fàcil passar-la per alt. Un ef_search que era correcte amb 100 K vectors no és correcte amb 10 M vectors. Una llista fixa de candidats explora una fracció cada vegada més petita d'un graf creixent, de manera que l'exhaustivitat decau silenciosament a mesura que creix el corpus. No ha canviat res al codi. Res no dona error. Les respostes simplement empitjoren una mica cada setmana.
El creixement degrada per si sol la qualitat de recuperació. Torna a ajustar ef quan creixi el corpus; la configuració d'ahir no és cap prova sobre la d'avui.
La fila 2 és l'única solució que no tracta de RAM. «Escala les escriptures per separat» apunta a separar lectura i escriptura —un camí d'escriptura dedicat, rèpliques per a lectures, insercions per lots—, i la font ho anomena i no ho desenvolupa mai. No es dona cap topologia de rèpliques, disseny de cues ni orientació sobre lots enlloc del capítol. Tracta-ho com una indicació, no com un disseny. L'única implicació pràctica sobre la qual pots actuar avui és mesurar la latència d'inserció en una sèrie pròpia, perquè un coll d'ampolla d'escriptura és invisible en un quadre de latència de consultes.
No pots actuar sobre res d'això sense instrumentació
Cada fila anterior és una mesura. Per això la part 7 ve abans de la 8 en aquesta guia, encara que el curs les ordeni a l'inrevés: els criteris d'activació són inútils si no els pots veure. El col·lector de mètriques del repositori té la forma correcta i l'abast equivocat:
# production-course-main-code/monitoring.py:95-105 — the summary the repo produces
    def get_summary(self) -> dict:
        avg_latency = (
            self.metrics["latency_sum"] / self.metrics["latency_count"]
            if self.metrics["latency_count"] > 0
            else 0
        )
        error_rate = (
            self.metrics["errors_total"] / self.metrics["requests_total"]
            if self.metrics["requests_total"] > 0
            else 0
        )
Dos buits per als nostres propòsits. Primer, InstrumentedLLM cronometra la crida a l'LLM, no la crida de recuperació: el senyal de 100 ms que necessites li és invisible. Segon, informa d'avg_latency_ms, i una mitjana amaga precisament la cua que busques: un índex que ha quedat mig fora de la RAM mostra una mitjana bona i un p95 catastròfic.
Instrumenta el recuperador mateix i conserva percentils:
# Original: retrieval-only timing, built on the repo's MetricsCollector shape.
# Wrap the retriever, not the chain — the index signal lives here.
import time
from collections import deque
from statistics import quantiles


class TimedRetriever:
    def __init__(self, retriever, window: int = 2000):
        self.retriever = retriever
        self.samples_ms: deque[float] = deque(maxlen=window)

    def invoke(self, query: str):
        start = time.perf_counter()
        docs = self.retriever.invoke(query)          # never swallow: no try/except here
        self.samples_ms.append((time.perf_counter() - start) * 1000)
        return docs

    def p95_ms(self) -> float:
        if len(self.samples_ms) < 20:
            return 0.0                                # too few samples to have a tail
        return quantiles(self.samples_ms, n=20)[-1]   # 19th cut point = 95th percentile
Alerta quan p95_ms() >= 100. És el criteri d'escalat del curs, fet mesurable. La deque acotada importa més del que sembla: una llista de mostres sense límit en un procés d'API de llarga durada és una fuga lenta de memòria dins del detector de pressió de memòria.
I per a la fila 4 —decaïment de precisió— no hi ha cap senyal temporal. Necessites reproduir de manera programada el conjunt de referència de la part 7 (pregunta → fragment esperat), seguint recall@k com a sèrie temporal i connectant-lo al control de regressió de CI de la part 13. Sense això, la fila 4 és indetectable per construcció; l'entorn de proves desplegable anterior és la versió més petita que es pot executar.
Vertical abans que horitzontal
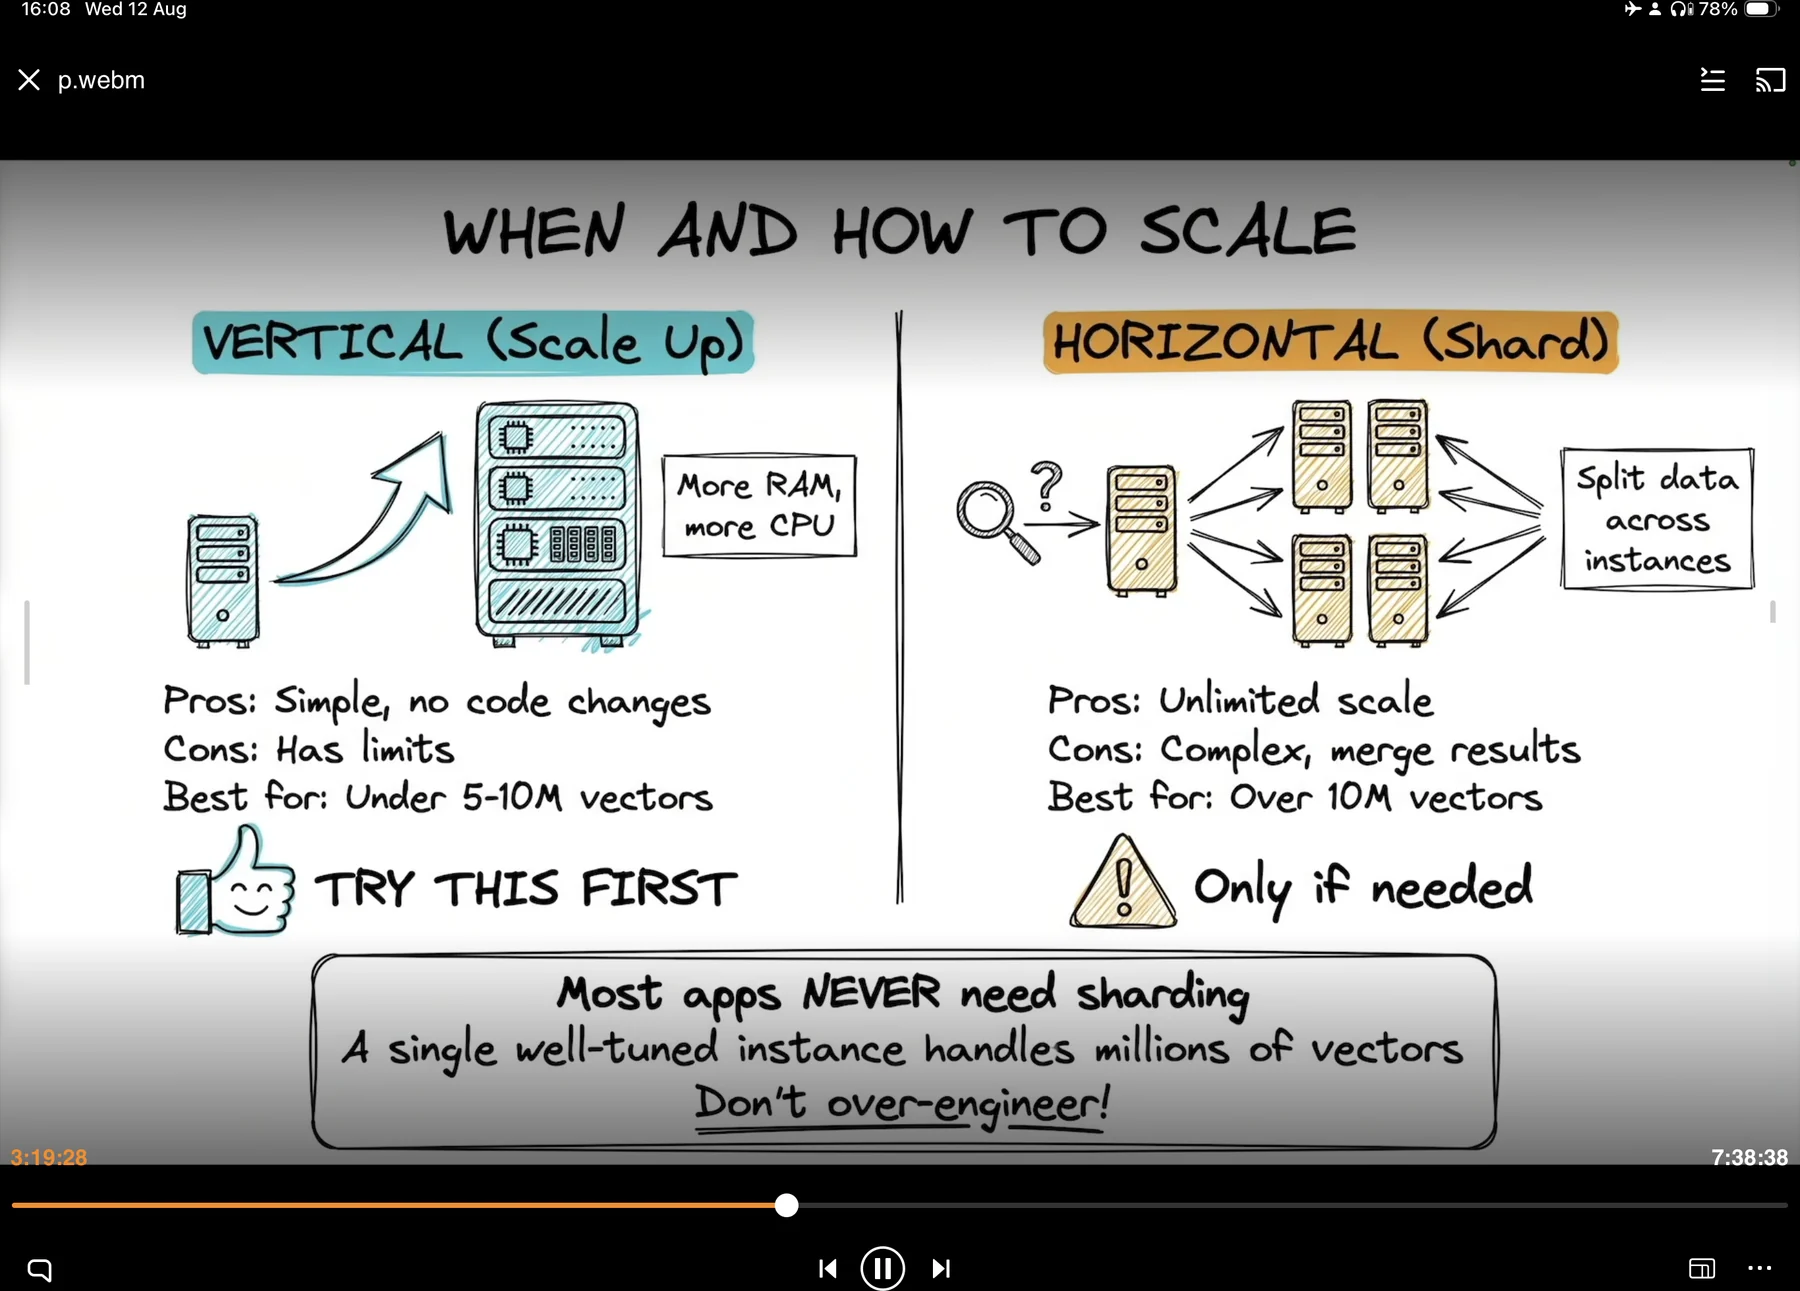
Escalat vertical: compra RAM, no canviïs res
Definició: «simplement aconsegueix una màquina més gran, més RAM, més CPU» 03:20:08. L'exemple resolt:
| RAM | Vectors | Latència de consulta | |
|---|---|---|---|
| Abans | 8 GB | 100 K | ~50 ms |
| Després | 32 GB | 100 K | ~10 ms |
Mateixes dades. Mateix índex. Mateix codi. 5× més ràpid. El mecanisme s'expressa en una frase breu:
«Això vol dir que l'índex cap a la memòria.» 03:20:08
Aquesta frase és la física de tota aquesta part. El rendiment de la cerca vectorial és, primer de tot, una qüestió de si l'índex cap a la RAM. Tota la resta —M, ef, distribució en shards, tria de proveïdor— depèn d'aquesta única condició binària. Quan l'índex desborda la memòria, el recorregut del graf comença a tocar disc amb patrons d'accés aleatori, que és el pitjor que pots fer a un dispositiu d'emmagatzematge.
Les tres condicions que l'instructor associa a l'escalat vertical 03:20:08: tens menys de 5–10 M vectors, el pressupost arriba a una instància més gran i —la que la gent se salta— la simplicitat t'importa més que el cost. Aquesta tercera condició és una decisió real, no farciment: una màquina més gran sovint és la resposta cara i continua sent l'adequada, perquè totes les respostes més barates costen temps d'enginyeria.
La targeta de l'escalat vertical de la diapositiva 13: Avantatges «Simple, sense canvis de codi» · Inconvenients «Té límits» · Més adequat per a «Menys de 5-10M vectors» · distintiu «PROVA AIXÒ PRIMER».
«l'escalat vertical és el més fàcil, el més ràpid. Per tant, sempre provaríeu això primer.» 03:20:08
Escalat horitzontal: divideix les dades, hereta un problema de fusió
Definició: dividir les dades entre múltiples instàncies, cadascuna amb una porció 03:20:08–03:21:10. Avantatges: escala il·limitada. Inconvenients: complexitat, «perquè fusiones resultats i tot això» 03:21:10. Més adequat per a: més de 10 milions de vectors. Distintiu: «Només si cal».
El cost de distribuir en shards no són els servidors. És la correcció. Ara cada consulta es distribueix a N shards i alguna cosa ha de fusionar N conjunts de resultats en una sola ordenació, cosa que introdueix modes de fallada que simplement no existeixen en una sola instància:
- Cada shard ha de retornar més que el
kfinal (normalmentkper shard, i després fusionar i
truncar), o perds documents top-k reals que casualment s'hagin concentrat en un shard.
- Les puntuacions han de ser comparables entre shards. Amb distància del cosinus acostumen a ser-ho; amb qualsevol
normalització de puntuacions, fusió híbrida (l'RRF de la part 6) o reranking per shard, sovint no ho són.
- L'exhaustivitat deixa de ser uniforme: un shard amb una porció casualment més densa té un problema de cerca més difícil
amb el mateix ef.
- Un shard lent o que es reinicia degrada totes les consultes, no una de cada N.
Aquest desenvolupament és meu; la font només expressa el cost com «fusionar resultats i tot això». Però és on hi ha els errors, i és el motiu pel qual la frase contra l'exageració té força:
«la majoria d'aplicacions no necessiten realment shards… en la majoria de casos això és simplement sobreenginyeria.» 03:21:10
El titular inferior de la diapositiva 13 és tota la tesi del capítol, i jo el penjaria a la paret:
«La majoria d'aplicacions no necessiten MAI shards. Una sola instància ben ajustada gestiona milions de vectors. No compliquis el disseny innecessàriament!»
L'ordre de progressió
- Ajusta primer l'índex. ef costa un canvi de configuració. M costa una reconstrucció. El maquinari costa diners
cada mes, per sempre.
- Escala verticalment. Màquina més gran, més RAM/CPU. Sense canvis de codi. Adequat fins a aproximadament
5–10 M vectors.
- Distribueix en shards. Només per sobre de ~10 M vectors, només quan el pas 2 estigui esgotat i només amb plena consciència
de la distribució de consultes i la fusió.
Gestionat o autoallotjat
La mateixa lògica de «tria'n 2», desplaçada una capa amunt dels paràmetres d'índex a la infraestructura. Els quatre factors del curs, amb Pinecone com a exemple gestionat i pgvector autoallotjat com a exemple d'autogestió 03:21:10–03:22:13:
| Factor | Gestionat (Pinecone) | Autoallotjat (pgvector) |
|---|---|---|
| Infraestructura | automàtica, te la gestionen | ho gestiones tot tu |
| Càrrega operativa | zero | molt significativa: «has d'assumir la càrrega» |
| Cost a escala | «força car» | «no tan car… les coses estan controlades» |
| Control | «molt limitat perquè és gestionat» | total |
El compromís és simètric i honest: intercanvies diners per càrrega operativa, i control per comoditat. Aquí tampoc no hi ha cap vèrtex gratuït.
El diagrama de decisió 03:22:13–03:23:14:
ASCII original
Under 1 million vectors?
├── YES → a single pgvector instance is just fine.  (stop here)
└── NO  → Do you have a DevOps team?
          ├── NO  → use Pinecone (easy, managed, nothing to worry about)
          └── YES → Is cost a primary concern?
                    ├── NO  → stick with Pinecone for convenience
                    └── YES → self-host pgvector
Observa quina és la primera pregunta: la mida del corpus, no les funcionalitats del proveïdor. Per sota d'un milió de vectors, tot el debat entre gestionat i autoallotjat és irrellevant, i el temps que hi dediquis és temps que no dediques al chunking, que, segons l'invariant 1, és d'on prové realment la qualitat. Condensat en dues frases:
«si no voleu ocupar-vos d'operacions, aneu directament a un servei gestionat. Si el cost importa a escala, aleshores autoallotgeu…» 03:23:14
Què deixa obert deliberadament aquest capítol
Exposa els buits en lloc de fingir que s'han cobert:
- L'algoritme HNSW mateix: mai no s'explica més enllà de la imatge del graf. Expressament.
- Dòlars. Aquest capítol només diu «car» i «no tan car». La part 9 té les
factures reals, i divergeixen per un factor de 5× entre 500 K i 5 M vectors.
- Quantització i reducció de dimensions com a alternatives a comprar RAM: directament rellevants
per a «l'índex cap a la memòria?», i aquí no s'esmenten gens. Part 9.
- «Escala les escriptures per separat»: anomenat com la solució als pics de latència d'inserció i mai
desenvolupat en un disseny.
- Mesurar els quatre símptomes: depèn completament de les parts 7 i 13.
- Qdrant: anomenat una vegada en tot el curs, no s'hi torna mai.
- IVF/IVFFlat, quantització de producte i DiskANN: les altres famílies d'índexs que ofereixen pgvector i
l'ecosistema més ampli. Fora de l'abast de la font; convé saber que existeixen quan l'índex realment no cap a la RAM a cap preu.
Decisions que cal prendre
Recorre aquesta llista per ordre. Atura't tan bon punt les xifres siguin acceptables: qualsevol pas per sota del punt on t'atures és sobreenginyeria.
- Confirma quina propietat falla. El fragment adequat falta per l'embedding
(geometria incorrecta) o per l'índex (geometria correcta, la cerca aproximada no l'ha trobat)? Executa un recorregut per força bruta sobre una mostra i compara'l amb el resultat ANN: la funció auxiliar recall_at_k anterior és aquesta prova. Si tots dos no troben el fragment, el problema és en una etapa anterior: torna a la part 3.
- Escriu explícitament els paràmetres d'índex, encara que siguin els predeterminats, i comprova'ls
amb una asserció a l'arrencada tornant a llegir la configuració. Un collection_metadata sense establir és una decisió que no has pres. Comença amb M = 16, ef_construction = 100, ef_search = 100 i estableix explícitament la mètrica de distància.
- Estableix
ef_searchon realment tingui efecte. A pgvector darrere d'un pool, això vol dir per
connexió obtinguda o SET LOCAL dins de la transacció de cerca, no una sola vegada a l'arrencada. A Chroma vol dir en crear la col·lecció o amb modify(configuration=…) després.
- Comprova
ef_search ≥ k, amb marge. Multiplica pel factor d'obtenció de candidats del reranker si en tens
un. Una recuperació amb k=100 per fer reranking amb ef_search=100 està mal configurada.
- Instrumenta la latència de recuperació per separat de la de generació i conserva el p95, no
la mitjana. Alerta a 100 ms. Dona a les insercions una sèrie pròpia.
- Programa una comprovació de regressió de recall@k amb un conjunt fix de consultes. És l'única manera de
veure el decaïment de precisió a mesura que creix el corpus: la fallada que no té missatge d'error.
- Quan falti precisió, augmenta primer ef. 100 → 200. Mesura. Sense reconstrucció, sense regenerar embeddings.
- Només aleshores augmenta M (16 → 32), acceptant una reconstrucció i més RAM permanent.
- Abans de comprar maquinari, comprova si l'índex cap a la RAM. Si no hi cap, compara el
cost de la RAM amb el de vectors més curts (1536 → 512) o quantització (float32 → int8): part 9.
- Escala verticalment. Sense canvis de codi. Adequat fins a 5–10 M vectors.
- Tria gestionat o autoallotjat segons la desigualtat, no el recompte de vectors: autoallotja quan
estalvi mensual > cost operatiu, i no autoallotgis mai sense algú que tingui com a feina operar-ho.
- Distribueix en shards al final, per sobre de ~10 M vectors, i només després d'escriure com fusionaràs i
ordenaràs els resultats entre shards. Si no pots escriure aquest paràgraf, no estàs preparat per distribuir en shards.
El resum d'una línia de tota aquesta part: ajusta ef, compra RAM, no distribueixis en shards.