
Observabilitat: traces, mètriques i avaluacions
Traces, mètriques i avaluacions: el marc que envolta el pipeline i en revela el comportament.
Totes les altres parts d'aquesta guia canvien una casella dins del pipeline. Aquesta construeix el marc que l'envolta.
En el model mental de la part 1, l'observabilitat és la franja dibuixada al voltant de totes dues fases:
ASCII original
        ┌──────────────────────────────────────────────────────────┐
        │  OBSERVABILITY  (traces · metrics · evals · JSON logs)    │
        │  wraps everything, changes nothing            ch12,13,19  │
        └──────────────────────────────────────────────────────────┘
Se situa deliberadament aquí, abans de les parts d'escalat i cost, i aquest ordre corregeix el curs d'origen, que l'ensenya més tard. El motiu és senzill: tots els criteris d'activació de les parts següents són mesures. «Escala quan la latència p95 de recuperació superi els 100 ms.» «Encamina cap a un model més barat quan la pregunta sigui trivial.» «Afegeix una memòria cau quan la taxa d'encerts superaria X.» Cap d'aquestes frases no significa res per a un equip que no pot veure un p95, un cost per consulta o una taxa d'encerts. Ensenyar optimització abans de la instrumentació dona al lector llindars que no té manera d'avaluar.
Aquesta part també és on l'invariant 4 (les fallades són silencioses) i l'invariant 6 (la monitorització observa i no ha de canviar mai el comportament) reben un tractament complet. Són la mateixa idea vista des de dos extrems: com que res no llança excepcions, has d'afegir-hi tu mateix els ulls, i com que els ulls són un afegit, no han de formar part mai del flux de control.
Una nota de context abans de començar. El material d'origen narra tot aquest mòdul en termes d'un sistema de recerca multiagent amb LangGraph —supervisors, traspassos, agents paral·lels, equips jeràrquics, bucles de qualitat—, no d'un recuperador. Aquest segment prové del material de LangChain/LangGraph de l'instructor i s'ha inserit en un curs de RAG. Tots els arguments continuen sent vàlids, perquè recuperar → filtrar → aplicar reranking → muntar → generar és simplement un altre graf de múltiples passos amb les mateixes propietats: diversos punts de fallada possibles, cap excepció, corrupció en cascada. Però quan la font diu «quin agent ha fallat», llegeix «quina etapa ha fallat», i els exemples d'aquesta part tradueixen el vocabulari d'agents al de RAG allà on importa.
La caixa negra que acabes de publicar
L'escenari amb què comença la font deliberadament no és «el codi està espatllat» 02:21:11. El codi funciona. El graf s'executa de principi a fi. Els supervisors assignen tasques, els agents retornen resultats i s'escriu l'informe. I encara no pots explicar ni una sola resposta incorrecta.
L'instructor planteja una pregunta de responsabilitat amb tres opcions: quan la sortida és incorrecta, ha estat l'investigador que ha trobat dades dolentes, el redactor que les ha interpretat malament o el supervisor que ha encaminat la tasca al departament equivocat? No ho pots saber a partir de la sortida. Aquest és tot el problema, exposat en una frase:
«El teu sistema és una caixa negra. Hi poses una pregunta, en surt una resposta i, si alguna cosa va malament, estàs fent suposicions.» 02:21:11
Compara-ho amb el cicle de depuració que ja coneixes. Programari tradicional: error → traça de pila → «la línia 47 és el problema» → corregir → acabat. La font ho anomena «un camí clar». El programari amb LLM et dona un paràgraf dolent i res més.
«No hi ha cap traça de pila per a les respostes dolentes.» 02:22:12
I «simplement llegeix el codi» no escala, perquè el nombre de punts de fallada possibles creix amb el graf. El sistema d'exemple té 5+ nodes, 3 agents paral·lels, bucles de qualitat i 8+ crides a l'LLM per execució 02:22:12. Quan l'informe final és incorrecte, quina d'aquestes vuit crides o més ha produït el primer token incorrecte? Cap no s'anuncia.
La traducció a RAG és exacta. Una sola consulta de producció toca el reescriptor de consultes, la crida d'embeddings, la cerca vectorial, la branca BM25, el pas de fusió, el filtre de metadades, el reranker, el muntador de context i el generador. Són nou llocs on pot néixer una resposta incorrecta, i vuit retornaran sense problemes un resultat sintàcticament perfecte però semànticament incorrecte.
Sense instrumentació, el procediment diagnòstic que tens disponible és aquest, i la font l'anomena per ordre expressament perquè t'hi reconeguis:
- Llegeix la sortida final.
- Decideix que és incorrecta.
- Endevina quin component l'ha causada.
- Torna a executar i espera que es reprodueixi.
«Això no és enginyeria. És només esperança.» 02:24:17
Per què és difícil depurar LLM: els quatre motius estructurals
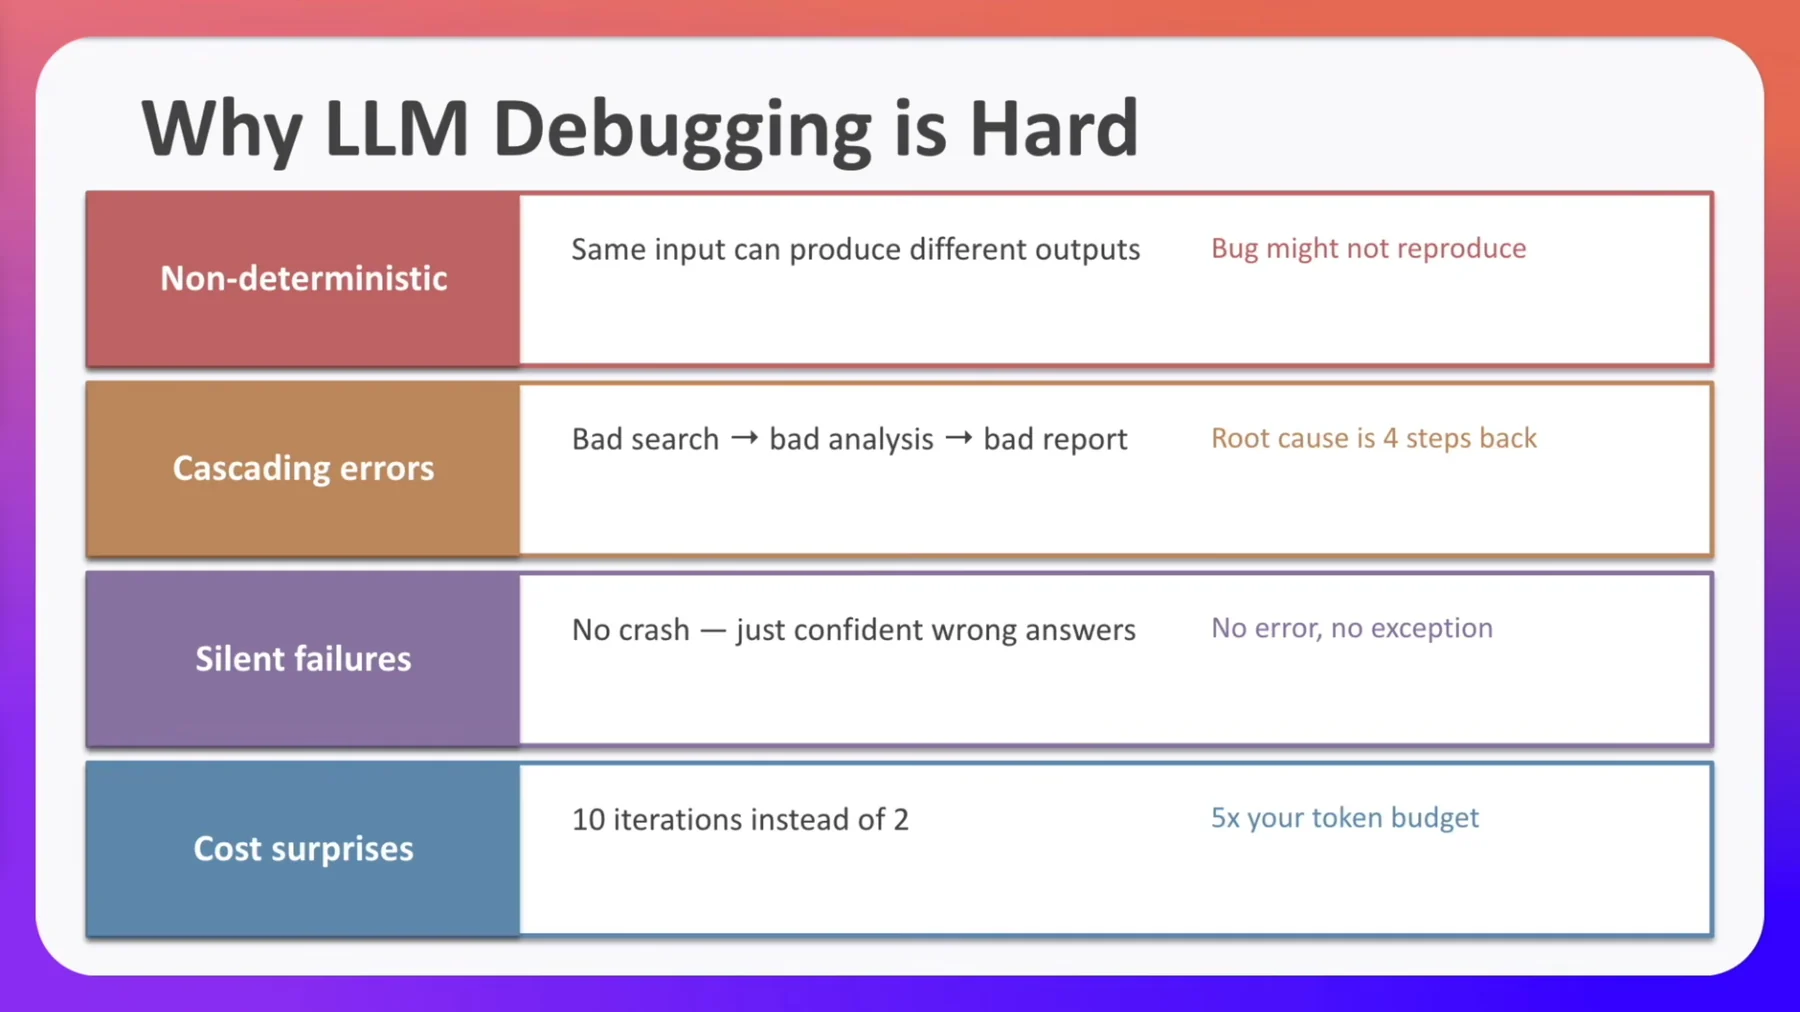
La diapositiva és l'eix conceptual d'aquesta part 02:22:12–02:24:17. Aquí la tens amb la traducció a RAG afegida, perquè la font només dona la versió d'agents.
| Motiu | Plantejament de la font | Conseqüència (diapositiva) | Com es manifesta a RAG |
|---|---|---|---|
| No determinista | La mateixa entrada pot produir sortides diferents | «L'error podria no reproduir-se» | Dues preguntes idèntiques retornen respostes diferents; un fragment que ahir era a la posició 3 avui és a la 11 després de reconstruir l'índex |
| Errors en cascada | Cerca dolenta → anàlisi dolenta → informe dolent | «La causa arrel és 4 passos enrere» | Chunking inadequat → embedding dolent → top-k equivocats → resposta incorrecta amb confiança. Sembla que falli el generador; falla el segmentador |
| Fallades silencioses | Cap fallada d'execució: només respostes incorrectes amb confiança | «Cap error, cap excepció» | similarity_search retorna 5 documents, tots irrellevants, HTTP 200, zero excepcions |
| Sorpreses de cost | 10 iteracions en lloc de 2 | «5x el pressupost de tokens» | Un recuperador que retorna 20 fragments en lloc de 5 quadruplica els tokens del prompt en cada petició, per sempre |
Dos d'aquests motius mereixen un desenvolupament més enllà de la diapositiva.
El no-determinisme elimina la teva eina principal. La font és explícita que tornar a preguntar no és una tècnica de depuració: la variació és la funció del model, de manera que una segona execució no et diu res de la primera:
«Aquest no és l'objectiu dels grans models de llenguatge.» 02:23:14
El no-determinisme és una característica del mitjà i alhora allò que destrueix el flux de reproduir i després corregir. Establir temperature=0 redueix la variància —per això ho estableixen tots dos fitxers d'observabilitat d'aquesta part, langsmith_setup.py i monitoring.py—, però no fa que el sistema sigui determinista de principi a fi, perquè la recuperació, la resolució d'empats, l'estat de l'índex i l'encaminament del proveïdor canvien sota els teus peus.
Les sorpreses de cost són errors de flux de control disfressats de facturació. Un bucle de supervisor que fa 10 iteracions en lloc de 2 crema 5× el pressupost de tokens esperat 02:24:17. Res no dona error, res no és prou lent perquè es noti i l'excés de despesa és proporcional al trànsit: per tant, com millor funciona la funcionalitat, més gran és la factura que acaba fent aflorar el problema.
Què és realment l'observabilitat
La definició que dona la font 02:24:17 és la clàssica de la teoria de control, sense canvis:
«L'observabilitat és la capacitat d'entendre què fa internament el sistema mirant-ne les sortides.» 02:24:17
El matís específic dels LLM és al qualificatiu que afegeix la diapositiva: tot el recorregut, no només la resposta final. Les «sortides» que instrumentes són registres per pas, no el cos de la resposta. Si l'única sortida que pots veure és allò que veu l'usuari, no tens observabilitat: només llegeixes el mateix paràgraf del qual l'usuari ja s'ha queixat.
El capítol 19 dona una versió més directa i operativa de la mateixa definició 04:04:43: l'observabilitat és «una manera de mirar atentament dins dels fluxos de treball i veure els registres i tot això». Mateixa idea, començant per la infraestructura. I comença amb la fallada que existeix per detectar: es veu que les crides a l'API s'estan fent, el trànsit circula, tornen respostes 200, i això no et diu res de si les respostes són correctes, si la recuperació realment recupera o si el model al·lucina. Disponibilitat no és correcció.
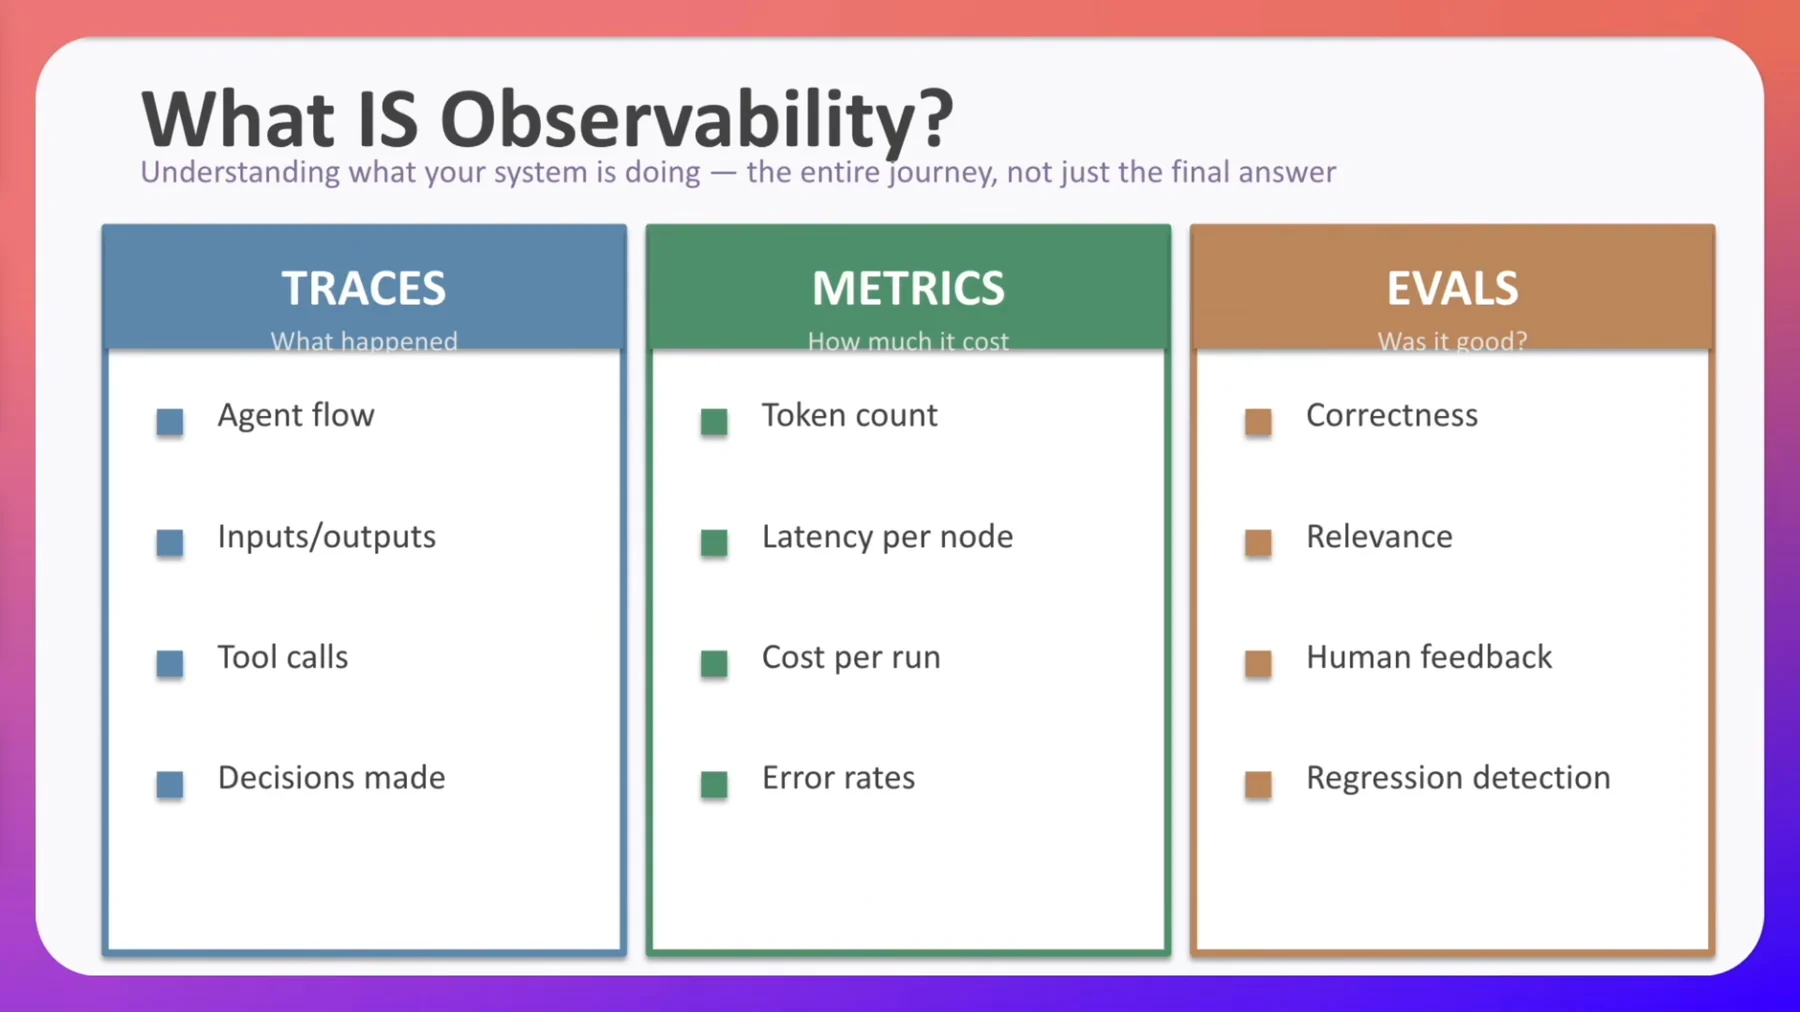
| Pilar | La pregunta que respon | Què conté (literalment de la diapositiva) |
|---|---|---|
| TRACES | «Què ha passat» | Flux d'agents · Entrades/sortides · Crides a eines · Decisions preses |
| MÈTRIQUES | «Quant ha costat» | Recompte de tokens · Latència per node · Cost per execució · Taxes d'error |
| AVALUACIONS | «Ha estat bo?» | Correcció · Rellevància · Retorn humà · Detecció de regressions |
Els tres pilars no són intercanviables, i la manera més clara de veure-ho és relacionar-los amb els quatre motius de fallada anteriors:
| Motiu de fallada | Pilar que el detecta | Per què els altres dos no |
|---|---|---|
| Errors en cascada | Traces | Les mètriques mostren un cost normal de l'execució; les avaluacions mostren que la resposta era dolenta, però no on |
| Sorpreses de cost | Mètriques | Les traces mostren un bucle d'aparença vàlida; les avaluacions fins i tot poden puntuar bé la sortida |
| Fallades silencioses | Avaluacions | Les traces i les mètriques semblen perfectament saludables: aquesta és la definició de silenciós |
| No-determinisme | Tots tres, al llarg del temps | Una sola execució no et diu res; necessites la distribució |
Què captura realment una traça
Una traça examina «cada pas, cada entrada, cada sortida, cada mil·lisegon» de l'execució 02:25:18. La font en recorre una de completa per al pipeline de recerca multiagent:
- El supervisor planifica 3 consultes
- Cerca 1 → 3 troballes
- Cerca 2 → 2 troballes
- Cerca 3 → 3 troballes
- L'analista sintetitza
- El redactor prepara l'esborrany
- Puntuació de qualitat = 0.6 → s'activa la revisió
- Puntuació revisada = 0.88 → aprovat, acaba l'execució
Aquesta és l'estructura de multi_agent_research_system.py del repositori, node per node, i la correspondència es pot comprovar, no és una simple afirmació: el fitxer registra exactament cinc nodes (supervisor, search_agent, analyst, report_writer, quality_checker), el prompt del supervisor demana «exactament 3» consultes de cerca, les distribueix mitjançant l'API Send de LangGraph perquè les tres cerques funcionin en paral·lel i es demana a cada agent de cerca que retorni «2-3 troballes clau». La traça narrada és aquest graf executant-se una vegada.
Després la font s'apropa a un node —«Search Agent 1»— i llegeix el tram camp per camp 02:26:20:
| Camp del tram | Valor mostrat |
|---|---|
| Entrada | la consulta de cerca |
| Eina | s'ha cridat web_search |
| Latència | 1.2 segons per a la crida a l'eina |
| Sortida | 3 resultats amb resum |
| Tokens | entrada 45, sortida 890 |
| Cost | mostrat en pantalla, no llegit en veu alta |
Dues notes d'honestedat sobre aquesta taula, perquè la font no n'assenyala cap.
L'argument del benefici és breu i correcte 02:26:20. Quan tens entrada, eina, latència, tokens i cost per node, pots (1) estalviar diners, (2) confiar en el teu sistema i (3) saber exactament quan intervenir.
«No voles a cegues. Voles amb dades.» 02:26:20
Com llegir una traça quan alguna cosa va malament. Aquest és el procediment que substitueix la traça de pila, i val la pena memoritzar-lo perquè no és evident:
- Obre l'execució de nivell superior (tot el graf / tota la petició).
- Desplega-la node per node en ordre d'execució.
- Per a cada node llegeix: entrada, eina cridada, latència, sortida, tokens d'entrada, tokens de sortida, cost.
- Compara la sortida de cada node amb el que necessitava el node següent.
- El primer desajust és el defecte. Atura't aquí. No continuïs fins al node que
ha produït el símptoma visible: amb errors en cascada, aquest node és quatre passos després de l'error real i es comporta correctament amb l'entrada inútil que ha rebut.
Per a una petició RAG, el pas 4 té una forma concreta. Això és el que has de mirar etapa per etapa: és la traducció a RAG del recorregut node per node de la font, i és el més útil que pots interioritzar d'aquesta secció:
| Etapa | La pregunta que fas al seu tram | Com es manifesta «aquí ja és incorrecte» |
|---|---|---|
| Reescriptura / expansió de consultes | La consulta reescrita encara significa el que ha preguntat l'usuari? | «Com ho cancel·lo?» s'ha convertit silenciosament en «Com elimino el meu compte?» |
| Embedding de consulta | És el mateix model i versió que s'ha fet servir en indexar? | Res de visible: és la fallada que no té cap símptoma fins que cau l'exhaustivitat (invariant 2) |
| Cerca vectorial | Quins són els identificadors i les puntuacions top-k? | La millor puntuació és 1.34 i la tractes com una similitud (el parany de distància contra similitud de la part 4) |
| Filtre de metadades | Quants han sobreviscut al filtre? | S'ha demanat k=5 i en tornen 4, o zero. k és un màxim, no una quota, i el codi posterior que assumeixi el contrari falla |
| Fusió / reranking | El fragment correcte ha pujat o ha baixat? | El fragment adequat era a la posició 7 abans del reranking i a la 9 després: el reranker t'està perjudicant |
| Muntatge del context | Quants tokens han entrat al prompt i s'ha truncat alguna cosa? | El fragment que contenia la resposta és el que s'ha retallat |
| Generació | La resposta està sustentada pel context que té a sobre? | Fluida, segura i absent del context: al·lucinació |
Si la traça no et permet respondre totes set preguntes, encara no està instrumentada amb prou profunditat.
Per què ara i no després de l'incendi
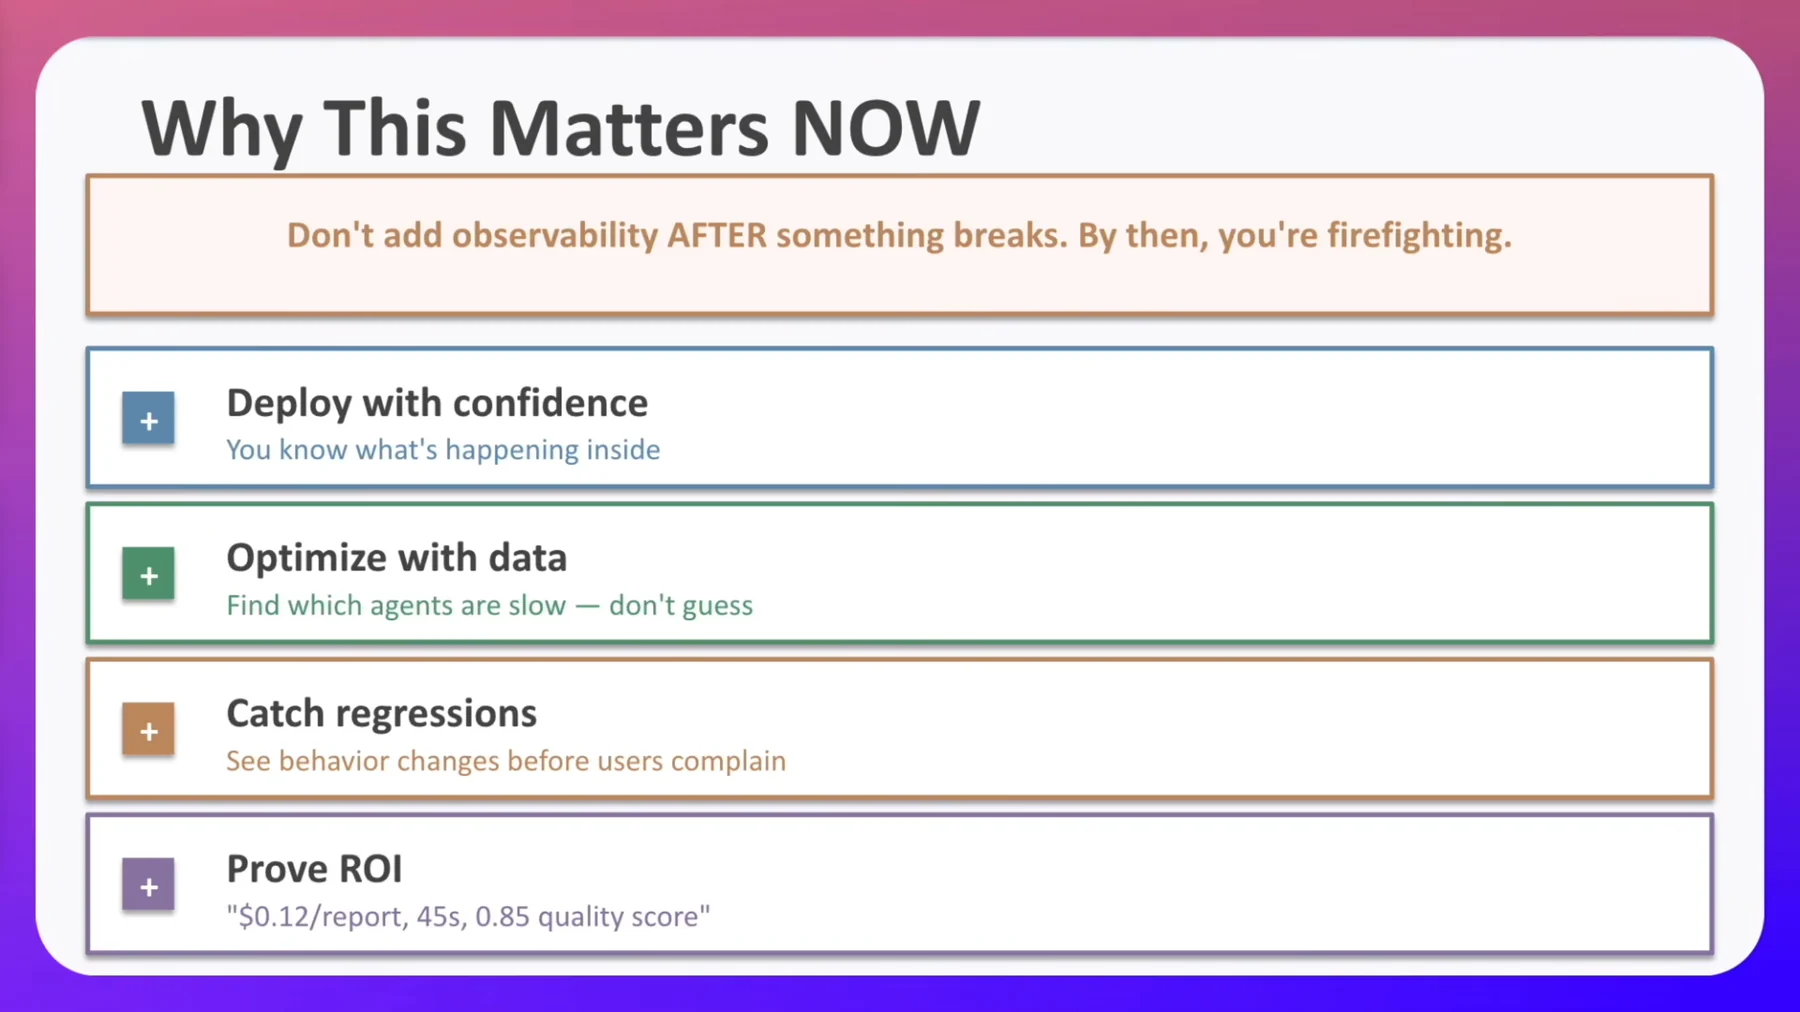
L'error que anomena la font 02:27:22 és que la majoria de desenvolupadors pensen que l'observabilitat és una cosa que afegeixes després que alguna cosa es trenqui. Aleshores:
«Estàs apagant focs. Només apagues incendis. No estàs fent realment enginyeria.» 02:27:22
Els quatre beneficis de la diapositiva, amb les xifres intactes:
- Desplega amb confiança: «saps què passa a dins».
- Optimitza amb dades, «no amb esperances o pensaments». En concret: troba quines etapes
són lentes i després elimina-les o corregeix-les. La formulació de la diapositiva és «Troba quins agents són lents: no ho endevinis.»
- Detecta regressions: «Observa els canvis de comportament abans que els usuaris es queixin.»
- Demostra el retorn de la inversió: cita
$0.12/report, 45s, 0.85 quality scorea la direcció. L'
instructor és explícit sobre el públic: «ho podeu donar als vostres responsables o superiors».
Els enginyers infravaloren aquest quart benefici, i és el motiu pel qual l'observabilitat supera la revisió pressupostària. Una funcionalitat amb LLM sense instrumentació no pot respondre «quant costa això per unitat de valor?», i una funcionalitat que no pot respondre aquesta pregunta és una funcionalitat que es retalla quan arriba la factura de l'API.
El bucle de les sorpreses de cost, en codi
L'advertiment «10 iteracions en lloc de 2 = 5× el pressupost de tokens» no és hipotètic, i la solució és una clàusula addicional al mateix sistema de recerca del repositori. Així és un bucle acotat:
# /home/oriol/lab/rag/code/production-course-main-code/multi_agent_research_system.py
def quality_gate(state: ResearchState) -> Literal["report_writer", "end"]:
    """Route back to writer if quality is insufficient."""
    if state["quality_score"] >= 0.7 or state["iteration"] >= 2:
        return "end"
    return "report_writer"
Dues condicions de sortida independents: un llindar de qualitat de 0.7 i un límit estricte de 2 iteracions. El llindar és el que vols que s'activi; el límit és el que et salva quan el llindar no s'activa mai. El mateix fitxer ho reforça dins del mateix node de comprovació:
# /home/oriol/lab/rag/code/production-course-main-code/multi_agent_research_system.py
# Force approve after 2 iterations to prevent infinite loops
approved = review.approved or state["iteration"] >= 2
Aquest és tot el contingut de la lliçó de sorpreses de cost expressat com a codi, i es generalitza directament a RAG: qualsevol bucle de recuperació amb autocorrecció (recuperar → avaluar → reescriure → tornar a recuperar, el patró RAG agèntic de la part 15) necessita la mateixa segona condició de sortida. La sortida basada en qualitat és una heurística i les heurístiques fallen; el comptador no pot fallar.
LangSmith: traces amb (gairebé) zero canvis de codi
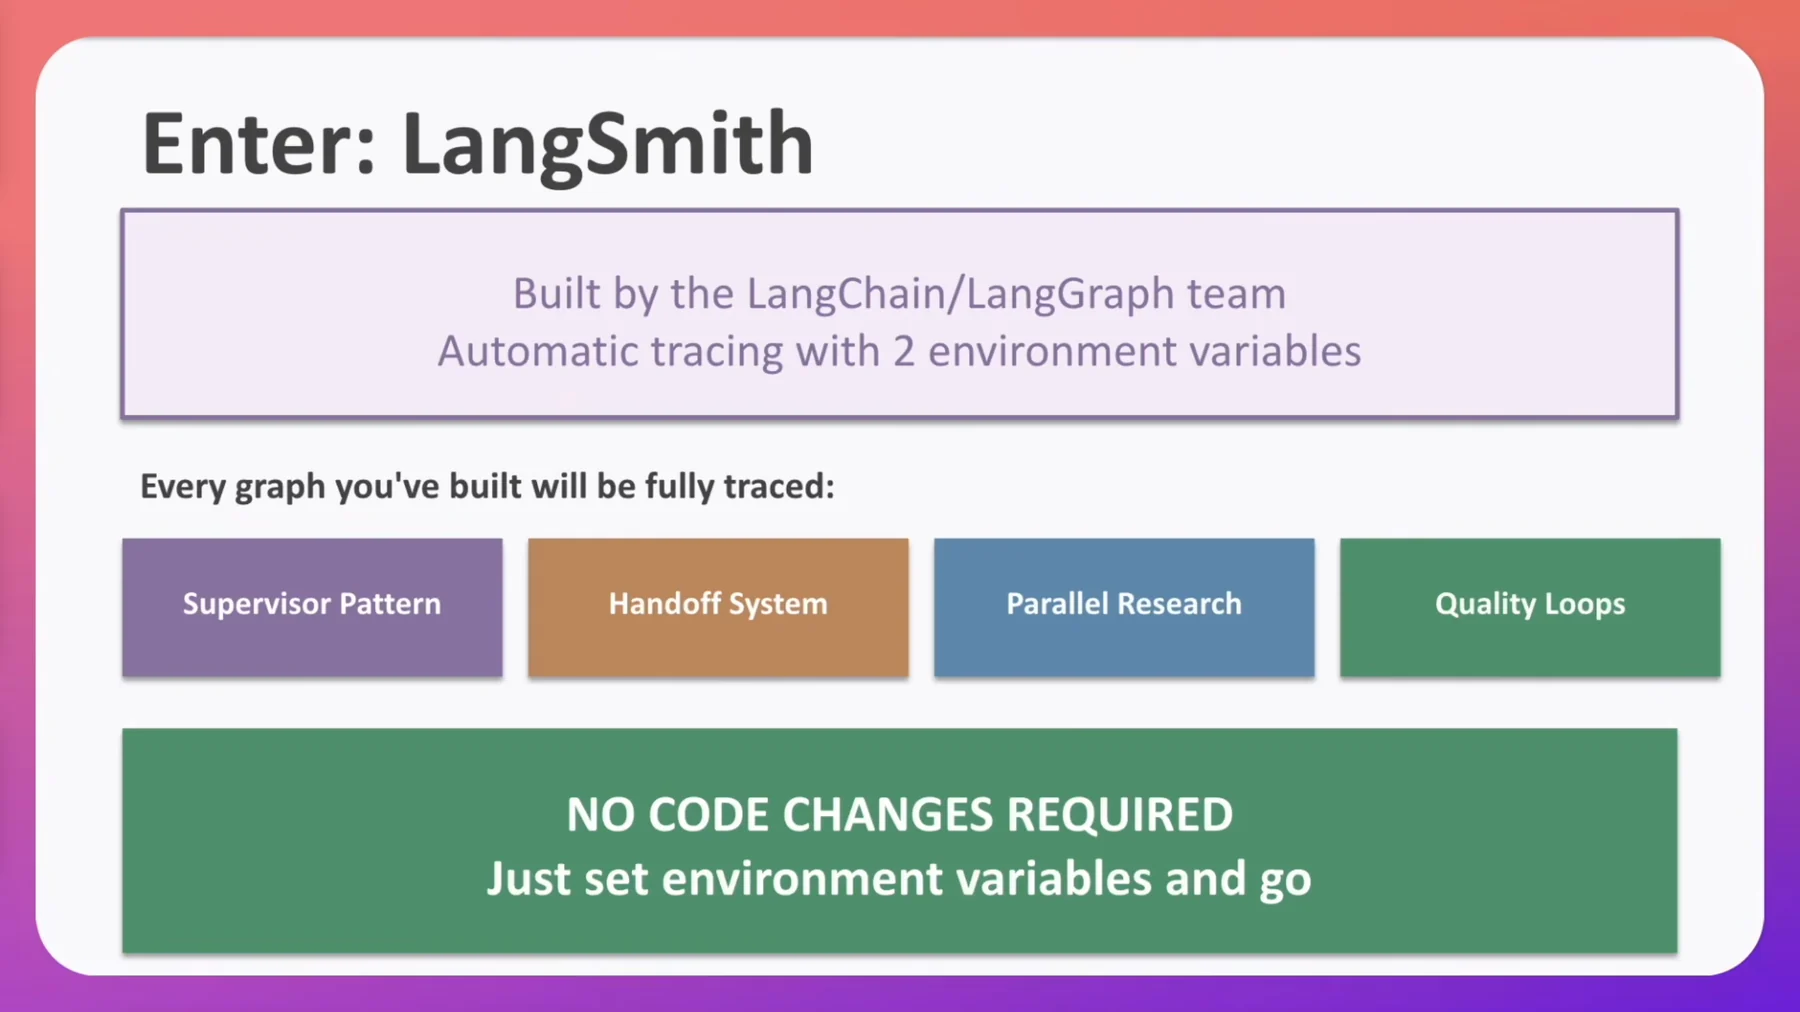
@traceable. Totes dues meitats de la distinció importen quan pressupostes la feina.Hi ha moltes eines d'observabilitat. La font tria LangSmith per tres motius declarats 02:28:22: és més fàcil, el construeix l'equip de LangChain/LangGraph i pot traçar sistemes sencers amb dues variables d'entorn. El capítol 13 afegeix el posicionament del mateix proveïdor: LangSmith és «una plataforma independent del framework per desenvolupar, depurar i desplegar agents d'IA i aplicacions amb LLM» 02:29:56; no cal que facis servir LangChain per utilitzar-lo, simplement hi tens el camí més còmode si ho fas, i la pàgina d'inici es bifurca per framework perquè triïs la integració que coincideix amb la pila que ja executes.
La diapositiva dimensiona el benefici amb quatre caselles sota la capçalera «Tots els grafs que has construït tindran traces completes»: Patró de supervisor, Sistema de traspassos, Recerca paral·lela, Bucles de qualitat. Llegeix-ne l'equivalent RAG: cada cadena LCEL, cada recuperador i cada node LangGraph que ja has escrit comença a emetre trams sense reescriure'l. Aquesta afirmació és real i és específica dels objectes del framework, no de les teves funcions.
Les dues capacitats principals són traçar peticions i avaluar sortides. El curs només exercita la primera. Convé assenyalar-ho ara en lloc de descobrir-ho després: les avaluacions s'anomenen com a pilar i no es demostren enlloc.
El que obtens tan bon punt s'activen les traces, segons el resum del mateix capítol 02:28:22–02:29:23:
- el prompt exacte enviat (no la plantilla: la cadena renderitzada, amb el context
recuperat interpolat a dins)
- la resposta del model
- el recompte de tokens i el cost a què correspon
- un desglossament de latència per pas
- la capacitat de seguir tots els passos d'una execució
L'avanç de la interfície ho concreta 02:29:23: entrada «quin temps fa», un node de crida a l'LLM que es desplega per mostrar el model GPT-4o, durada ~0.8 segons i després la sortida. «Ara ja no vas a cegues.» (Tant GPT-4o com 0.8 són reconstruccions d'un subtítol automàtic malmès —la transcripció diu «GPT40» i «about8 seconds»— i el repositori fa servir gpt-4o-mini a tot arreu; per tant, considera que el sufix exacte del model no està confirmat.)
Obtenir un compte i una clau 02:29:56–02:30:59:
- Ves a
smith.langchain.com. No cal targeta de crèdit. - Inicia sessió amb GitHub, correu electrònic o Google.
- Preveu un quadre de comandament buit. *«En el vostre cas probablement no veureu gaire res si és
la primera vegada: és perfectament normal.»* Una vista Tracing buida no és una configuració espatllada.
- Ves a Settings → API keys (no a la vista del projecte).
- Crea una clau d'accés personal al teu espai de treball personal default. Amb això n'hi ha prou;
no necessites claus amb abast de servei o d'organització per a això.
- La descripció és obligatòria: el formulari et bloqueja fins que n'escrius una. L'instructor
fa servir «My testing playground».
- Copia la clau immediatament. Es mostra una sola vegada. No la pots recuperar després, només crear-ne
una de nova, i les claus són il·limitades («sempre podeu tornar aquí i crear-ne tantes com necessiteu»); per tant, crea'n una per màquina o projecte en lloc de reutilitzar-ne una a tot arreu. L'instructor diu que «hauríeu d'obtenir, crec, dos» valors en crear-la; ho diu amb dubtes evidents i el diàleg modern mostra una clau més el context de l'espai de treball: no tractis «dues claus» com un fet, simplement desa tot el que et mostri el diàleg.
Instal·lar i configurar:
uv add langsmith
Una nota de precisió si ho vas a buscar: el pyproject.toml distribuït no arriba a incloure mai una línia de langsmith; el paquet arriba transitivament a través de langchain-core i uv.lock el fixa a 0.6.6 amb Python ≥3.12. Executar igualment uv add langsmith és el correcte, perquè converteix una dependència que ara importes directament (from langsmith import traceable) en una d'explícita, en lloc de deixar-la a mercè d'una actualització de LangChain.
# .env — never commit this file
OPENAI_API_KEY=sk-...
ANTHROPIC_API_KEY=sk-ant-...        # unused here; harmless to keep
LANGSMITH_API_KEY=lsv2_pt_...
LANGSMITH_TRACING=false             # the source ships false and overrides it in code
                                    # — set it to true here and delete the override
LANGSMITH_PROJECT=multi-agent research
| Variable | Obligatòria? | Què fa |
|---|---|---|
LANGSMITH_API_KEY | Sí | Autentica l'SDK al teu espai de treball |
LANGSMITH_TRACING | Sí | L'interruptor general d'activació. "true" activa les traces globals; amb qualsevol altra cosa, les funcions decorades s'executen igualment però no emeten res |
LANGSMITH_PROJECT | Opcional | El contenidor on s'escriuen les traces. Molt recomanable: sense això tot acaba en una pila indiferenciada |
El .gitignore del repositori comença amb el comentari adequat precisament per aquest motiu: # Environment variables — NEVER commit these.
@traceable: tota l'API d'instrumentació
La lliçó més important del capítol pràctic és que instrumentar consisteix a posar un decorador en una funció ordinària 02:33:02.
«Observeu que tot això són simplement funcions. Només hi afegim
@traceable.» 02:33:02
Aquesta és la línia d'activació i la primera demostració, literalment del repositori:
# /home/oriol/lab/rag/code/production-course-main-code/langsmith_setup.py
import os
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langsmith import traceable
from langsmith.run_trees import RunTree
from dotenv import load_dotenv

load_dotenv()

# Enable tracing
os.environ["LANGSMITH_TRACING"] = "true"


@traceable(name="basic_chaining")
def demo_basic_tracing():
    """Basic LangSmith tracing."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    prompt = ChatPromptTemplate.from_template("Explain {topic} in one sentence.")

    chain = prompt | llm | StrOutputParser()

    print("Basic Tracing Demo:\n")
    print("Running chain with LangSmith tracing enabled...")

    result = chain.invoke({"topic": "machine learning"})

    print(f"Result: {result}")
    print("\nCheck LangSmith dashboard for trace details.")
Tres propietats d'aquest decorador fan tota la feina:
- Funciona amb funcions simples de Python, no només amb runnables de LangChain. Pots instrumentar
qualsevol lògica de negoci: el segmentador, l'embolcall del reranker, el formatador de citacions.
- La imbricació és automàtica. Un cop la funció externa és traçable, el prompt, la crida a l'LLM i
l'analitzador de sortida que conté es recullen com a execucions filles. No decores tu mateix les crides internes. (L'instructor anomena «LangGraph» allò que fa la captura a 02:33:02; és l'SDK de LangSmith. No propaguïs el lapsus.)
name=dona a l'execució una identitat llegible. Sense això obtens el nom original de la funció
de Python. Les execucions amb nom són la manera de trobar qualsevol cosa després.
Un detall inactiu que convé conèixer per no perseguir-lo: RunTree s'importa i no es fa servir mai al fitxer distribuït. No forma part de la lliçó.
L'escala didàctica són tres funcions en tres nivells d'instrumentació:
| Nivell | Decorador | Què hi guanyes |
|---|---|---|
| 1 | @traceable(name="basic_chaining") | Una execució amb nom al quadre de comandament |
| 2 | @traceable(name="named_runs_demo", tags=["production", "summarization"]) | Filtratge per entorn i tipus de càrrega de treball |
| 3 | @traceable(name="trace_with_metadata_demo", tags=["metadata", "filtering"]) sobre una funció que rep user_id / request_type | Atribució per usuari i per tipus de petició: els arguments es converteixen automàticament en metadades de la traça |
El nivell 3 és el que importa en producció, i el mecanisme és agradablement barat: la manera d'introduir l'atribució d'usuari a LangSmith és simplement passar aquests valors com a arguments a la funció traçada. La demostració ho deixa gairebé massa clar: request_type es declara, no es referencia mai al cos i existeix només perquè aparegui a l'execució. Aquest és el patró: un argument que no fas servir continua sent un filtre amb què pots segmentar el quadre de comandament.
L'altra cara és una restricció de privadesa que hauries de decidir deliberadament. Si els arguments es converteixen automàticament en metadades de traça, tot el que passis a una funció traçada surt del procés i acaba al magatzem d'un proveïdor, incloent-hi la pregunta original de l'usuari i, en un sistema RAG, els fragments recuperats. Passa un user_id opac, no un correu electrònic; aplica l'emmascarament de dades personals (part 12) abans del límit traçat, no després.
# /home/oriol/lab/rag/code/production-course-main-code/langsmith_setup.py
@traceable(name="trace_with_metadata_demo", tags=["metadata", "filtering"])
def demo_trace_with_metadata(user_id: str, request_type: str):
    """Add metadata to traces for filtering."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    # Metadata is automatically captured
    result = llm.invoke(f"Hello from user {user_id}")

    return result.content
El langsmith_setup.py complet, les 74 línies
"""
LangSmith Setup and Observability
Production monitoring for LangChain/LangGraph
"""

import os
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langsmith import traceable
from langsmith.run_trees import RunTree
from dotenv import load_dotenv

load_dotenv()

# Enable tracing
os.environ["LANGSMITH_TRACING"] = "true"


@traceable(name="basic_chaining")
def demo_basic_tracing():
    """Basic LangSmith tracing."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    prompt = ChatPromptTemplate.from_template("Explain {topic} in one sentence.")

    chain = prompt | llm | StrOutputParser()

    print("Basic Tracing Demo:\n")
    print("Running chain with LangSmith tracing enabled...")

    result = chain.invoke({"topic": "machine learning"})

    print(f"Result: {result}")
    print("\nCheck LangSmith dashboard for trace details.")


@traceable(name="named_runs_demo", tags=["production", "summarization"])
def demo_named_runs():
    """Name your runs for easier identification."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    prompt = ChatPromptTemplate.from_template("Summarize: {text}")

    chain = prompt | llm | StrOutputParser()

    print("\nNamed Runs Demo:\n")

    result = chain.invoke(
        {"text": "LangSmith provides observability for LLM applications."}
    )

    print(f"Result: {result}")
    print("Run tagged with 'production', 'summarization'")


@traceable(name="trace_with_metadata_demo", tags=["metadata", "filtering"])
def demo_trace_with_metadata(user_id: str, request_type: str):
    """Add metadata to traces for filtering."""

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    # Metadata is automatically captured
    result = llm.invoke(f"Hello from user {user_id}")

    return result.content


if __name__ == "__main__":
    demo_basic_tracing()
    demo_named_runs()
    demo_trace_with_metadata(user_id="user_123", request_type="greeting")
Llegir el quadre de comandament
Executa les tres demostracions i el projecte mostra recompte de traces = 3 amb columnes de latència, tokens totals i cost 02:34:02. Clicar l'execució de metadades dona el registre complet 02:35:02:
| Camp | Valor a la demostració |
|---|---|
| Nom de l'execució | trace_with_metadata_demo |
| Metadades | user_id: user_123, request_type: greeting |
| Entrada / Sortida | el prompt d'entrada, «hola usuari, com et puc ajudar avui» de sortida |
| Estat | èxit |
| Tokens totals | 26, passa-hi el cursor per veure el desglossament: 20% entrada / 80% sortida |
| Latència | 1.15 s |
| Tipus | chain: «el tipus és chain perquè fem servir cadenes» |
| Etiquetes | metadata, filtering |
Dins d'aquesta execució pare hi ha un tram fill de la invocació del model que mostra l'entrada literal human i la sortida ai. És la promesa de «veure el prompt exacte enviat, veure la resposta exacta del model» feta concreta, i en un sistema RAG és la vista més valuosa que tens, perquè és l'únic lloc on pots llegir el context completament muntat que el model ha vist realment, en lloc del context que creus que el codi ha muntat.
El tipus d'execució s'infereix, i t'ha d'importar quin obtens. L'explicació de l'instructor és una frase —«el tipus és chain perquè fem servir cadenes» 02:35:02—, però la classificació és essencial quan comences a filtrar. LangSmith agrupa les execucions per classe: un pipeline LCEL es registra com chain, una crida a model com llm i un recuperador com retriever. Aquest últim és el motiu pel qual un servei RAG es beneficia d'embolcallar la recuperació en un objecte recuperador de LangChain en lloc d'una funció simple: obtens un tipus d'execució de primer ordre sobre el qual pots filtrar i agregar, en lloc d'un tram chain anònim que has de reconèixer pel nom. Cada execució també porta les marques de temps d'inici i final juntament amb el cost i les etiquetes; per tant, les preguntes d'ordre («el reranking ha passat abans o després del filtre?») es poden respondre només amb la traça.
Tres paranys del quadre de comandament de la mateixa explicació:
- Una funció traçada que retorna
Noneregistraoutput: null. Dues de les tres demostracions només
fan print; les traces mostren una entrada buida i una sortida nul·la 02:36:04 i semblen espatllades, però no ho estan. @traceable registra els arguments d'entrada i el valor retornat de sortida. Si vols una traça útil, rep arguments i retorna un valor: és una restricció de disseny de les funcions instrumentades, no una peculiaritat de la interfície.
- La interfície no és en directe: actualitza-la. Camps que semblaven buits es van emplenar després d'actualitzar el
navegador 02:36:04. No comencis a depurar la instrumentació per això.
- La segona execució informa d'una latència de
135sense dir la unitat; gairebé segur que són 135 ms,
atès que l'execució germana era d'1.15 s. Assenyalat com a reconstrucció.
LangSmith té més funcionalitats que les traces: la font assenyala Monitoring (quadres de comandament), Automations, Evaluators i Threads sense ensenyar-ne cap 02:37:05, i observa amb honestedat que la pestanya Monitoring no mostra pràcticament res quan tens tres traces. Tres traces no són un conjunt de dades de monitorització. No jutgis la funcionalitat amb una execució de joguina.
Tres pilars de visibilitat en producció
Tot el que hem vist fins ara era una eina allotjada fent la feina. La resta d'aquesta part és el que construeixes tu mateix, dins del teu procés, i existeix perquè un magatzem de traces allotjat no és un agregador de logs ni un backend de mètriques.
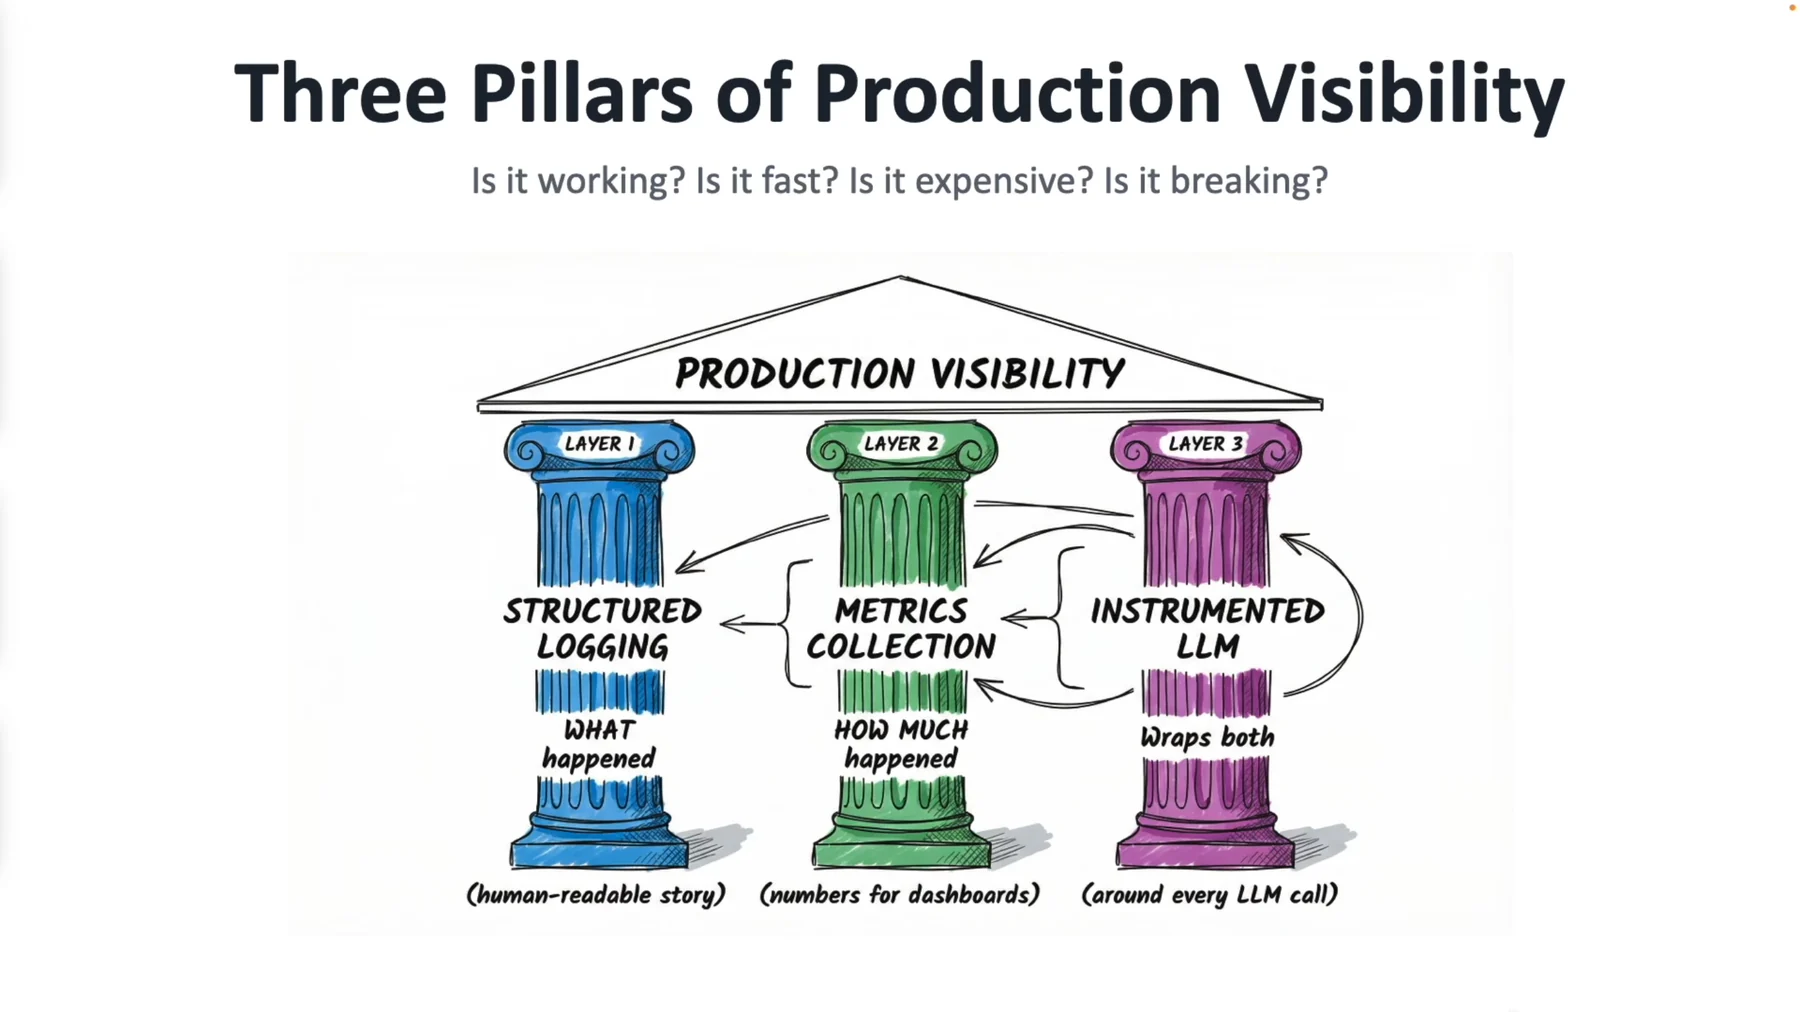
El subtítol és el millor resum de visibilitat en producció en quatre preguntes de tota la font:
«Funciona? És ràpid? És car? S'està trencant?» 04:04:43
| Pregunta | La respon | En concret |
|---|---|---|
| Funciona? | Registre estructurat + traces | Una línia JSON per petició i un tram per etapa |
| És ràpid? | Mètriques de latència | latency_sum / latency_count |
| És car? | Comptadors de tokens + taxa d'encerts de memòria cau | tokens_input, tokens_output, cache_hits |
| S'està trencant? | Comptadors d'errors | errors_total / requests_total |
I les tres capes mateixes:
| Capa | Nom | Respon | Peu de la diapositiva |
|---|---|---|---|
| 1 | Registre estructurat | QUÈ ha passat | (relat llegible per a humans) |
| 2 | Recollida de mètriques | QUANT ha passat | (xifres per als quadres de comandament) |
| 3 | LLM instrumentat | embolcalla totes dues | (al voltant de cada crida a l'LLM) |
«…és el que ens permetrà respondre això i veure-ho en la realitat, no només imaginar-ho esperant que les coses funcionin internament.» 04:04:43
On se situa la monitorització: la jerarquia de capes
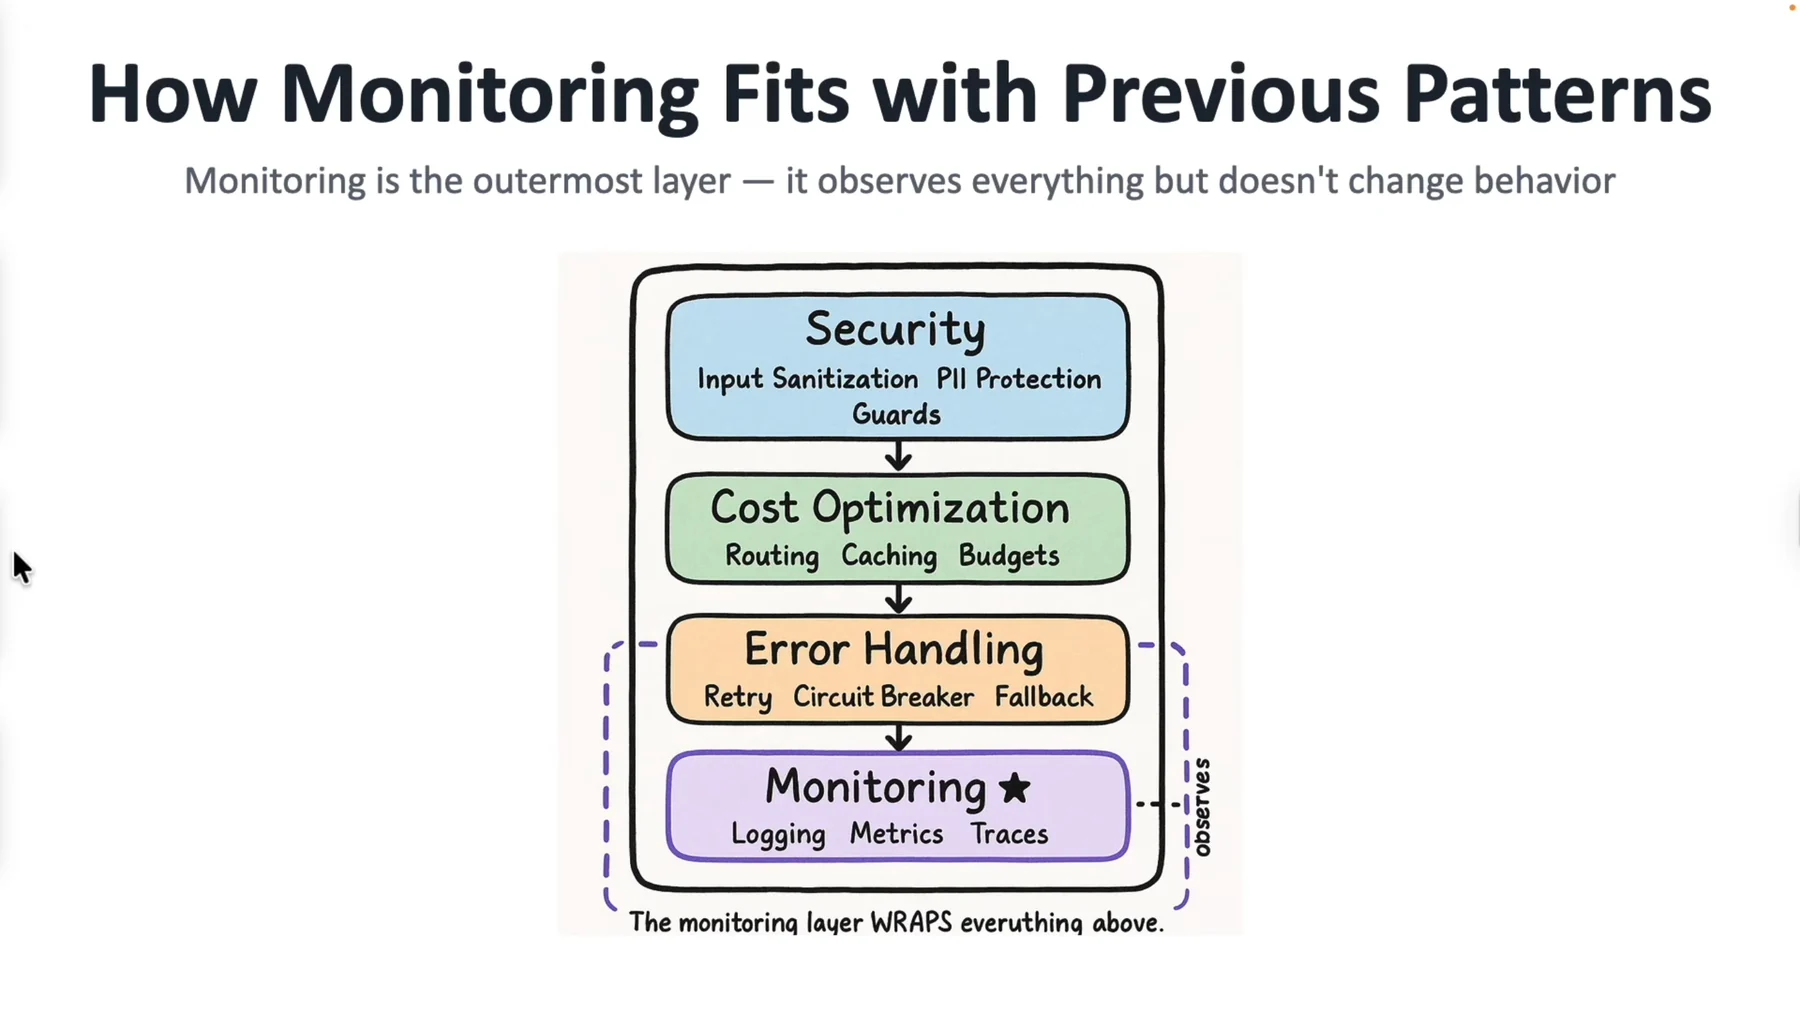
| Ordre | Capa | Subtècniques de la diapositiva | Canvia el comportament? |
|---|---|---|---|
| 1 (primera a executar-se) | Seguretat | Sanejament d'entrada · Protecció de dades personals · Controls | Sí: bloqueja o reescriu l'entrada |
| 2 | Optimització de costos | Encaminament · Memòria cau · Pressupostos | Sí: encamina cap a un model més barat, serveix des de la memòria cau |
| 3 | Gestió d'errors | Reintent · Circuit breaker · Alternativa | Sí: reintenta, activa el circuit breaker, recorre a una alternativa |
| 4 (més externa) | Monitorització ★ | Registre · Mètriques · Traces | No: i aquesta és la qüestió |
La diapositiva ho diu dues vegades —una al subtítol, una al peu del dibuix— i és l'invariant 6 d'aquesta guia:
«La monitorització és la capa més externa: ho observa tot, però no canvia el comportament.» 04:06:43
«La capa de monitorització EMBOLCALLA tot el que hi ha a sobre.» 04:06:43
Aquesta és la propietat distintiva. Les altres tres capes fan alguna cosa: bloquegen, reencaminen, reintenten, recorren a alternatives. La monitorització és l'única amb un criteri de correcció que exigeix que eliminar-la no canviï res del que retorna el sistema. La font és inequívoca que l'ordre no és opcional 04:07:44: «per a aplicacions amb LLM en producció, heu de tenir aquesta jerarquia: seguretat a dalt, optimització de costos, gestió d'errors i, sobretot, monitorització».
És la mateixa imatge que el pipeline de peticions de producció de la part 1 —Client → Limitador de freqüència → Seguretat → Memòria cau → Model (+reintent +alternativa) → Validació de sortida → Mètriques/registre → Resposta JSON— amb les capes anomenades en lloc de seqüenciades. Primer els rebutjos barats, al final la inferència cara i un enregistrador al voltant de tot.
Pilar 1 — Registre estructurat
L'objecció s'anticipa amb honestedat 04:07:44: «podem fer servir logs normals i prou, oi?» La resposta és un argument d'escala, no de puresa, i és la millor frase del capítol:
«Està bé fer servir logs quan els llegeixes al terminal. I és totalment inútil quan tens 10,000 peticions per hora.» 04:07:44
Tres consultes concretes que els logs de text pla no poden respondre:
- *Mostra'm totes les peticions de més d'1 segon.*
- Mostra'm tots els errors de l'agent de facturació. (filtrar per mòdul/component)
- Mostra'm totes les peticions d'un usuari concret. (filtrar per identificador d'usuari)
El registre estructurat consisteix a emetre cada línia de log com un objecte JSON amb camps tipats en lloc d'una frase en prosa, perquè un agregador de logs pugui indexar i consultar els camps. Datadog, Elasticsearch i CloudWatch ho ingereixen directament 04:09:48. Les dues consultes d'exemple que ho fan possible són «mostra'm tots els logs on latency_ms era superior a 1,000» i «compta errors per mòdul»: totes dues trivials sobre camps JSON i, com diu la font, impossibles sobre text pla 04:09:48. La distinció no és cosmètica: una frase en prosa registra que ha passat alguna cosa, un objecte JSON registra quins eren els valors, i només el segon es pot comptar.
«Per tant, cada línia de log és un objecte JSON.» 04:09:48
Tot aquest pilar i els dos següents es troben en un fitxer de 212 línies. Les importacions et diuen de què està fet: biblioteca estàndard més dues peces de LangChain més el decorador de LangSmith:
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
import logging
import json
import time
from datetime import datetime, timezone
from functools import wraps
from typing import Any, Callable
from langchain_openai import ChatOpenAI
from langchain_core.callbacks import BaseCallbackHandler
from langchain_core.messages import HumanMessage
from langsmith import traceable
from dotenv import load_dotenv

load_dotenv()
wraps, Any, Callable, HumanMessage i BaseCallbackHandler s'importen i no es fan servir mai. L'últim és l'interessant, perquè anomena el camí que aquest fitxer no segueix: LangChain exposa una interfície de callbacks (BaseCallbackHandler, amb punts d'extensió on_llm_start / on_llm_end / on_llm_error) que permet adjuntar instrumentació a cada crida de model d'una cadena sense embolcallar el model en una classe pròpia. L'enfocament amb embolcall que es mostra aquí és més fàcil de llegir i et dona un punt de crida explícit; el de callbacks es compon millor quan l'LLM és enterrat tres capes endins d'una cadena LCEL que no has escrit. Tingues present que existeixen tots dos.
Aquesta és tota la implementació del pilar 1. És una subclasse de logging.Formatter que redefineix un mètode:
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
class JSONFormatter(logging.Formatter):
    """Format logs as JSON for log aggregation."""

    def format(self, record):
        log_obj = {
            "timestamp": datetime.now(timezone.utc).isoformat(),
            "level": record.levelname,
            "message": record.getMessage(),
            "module": record.module,
            "function": record.funcName,
        }

        if hasattr(record, "extra_data"):
            log_obj.update(record.extra_data)

        return json.dumps(log_obj)


def setup_logging():
    """Setup structured JSON logging."""

    logger = logging.getLogger("langgraph_app")
    logger.setLevel(logging.INFO)

    handler = logging.StreamHandler()
    handler.setFormatter(JSONFormatter())
    logger.addHandler(handler)

    return logger
El veredicte de l'instructor —«molt simple però útil» 04:08:46— és just. Cinc camps bàsics a cada línia i una via d'extensió. Convé llegir deliberadament dues decisions de configuració de setup_logging(). El logger té nom ("langgraph_app") en lloc de ser el logger arrel, cosa correcta: donar format JSON al logger arrel reescriuria cada línia emesa per cada biblioteca de tercers. I el gestor és un simple StreamHandler a nivell INFO, que escriu a stderr, perquè és el valor predeterminat de StreamHandler quan no li passes cap flux. Si el desplegament espera els logs d'aplicació a stdout (la majoria de controladors de logs de contenidors tracten stderr com el canal d'errors i poden etiquetar cada línia com un error), és una correcció d'un argument que hauries de fer abans de publicar: logging.StreamHandler(sys.stdout).
| Camp | Origen |
|---|---|
timestamp | datetime.now(timezone.utc).isoformat(): ISO-8601, UTC, amb informació de zona horària |
level | record.levelname |
message | record.getMessage() |
module | record.module |
function | record.funcName |
La via d'extensió extra_data és el mecanisme que fa útil tot el conjunt. Qui crida passa extra={"extra_data": {...}} a logger.info(...), i aquestes claus es fusionen al nivell superior de l'objecte JSON: així latency_ms, input_tokens i output_tokens es converteixen en camps consultables de primer ordre en lloc d'interpolar-se en una frase.
La prova bàsica de funcionament (distribuïda comentada al final del fitxer):
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py  (lines 210-211)
logger = setup_logging()
logger.info("Logging setup complete", extra={"extra_data": {"app": "langgraph"}})
produeix una línia amb timestamp, level: INFO, message: "Logging setup complete", module: monitoring, function: <module> i app: langgraph. Aquest <module> és un detall incidental però instructiu: funcName és real i dinàmic, i aquí diu <module> només perquè la crida es fa a nivell de mòdul. A la demostració en directe, el mateix camp diu invoke.
Pilar 2 — Recollida de mètriques
El contrast més clar de la font 04:10:48:
- Un log és un esdeveniment individual: *«la petició X ha trigat 453 mil·lisegons».*
- Una mètrica és un agregat: *«la latència mitjana ha estat de 320 mil·lisegons».*
«Els logs i les mètriques són coses diferents, però junts expliquen millor la història.» 04:10:48
Necessites tots dos perquè responen preguntes diferents. El log et parla d'aquella petició: quin usuari, quina consulta, quins identificadors de document. La mètrica et parla de la població: si avui és pitjor que ahir. Cap no substitueix l'altre, i un sistema amb només mètriques et pot dir que alguna cosa s'ha tornat més lenta sense dir-te mai quina petició has de mirar.
Els vuit comptadors. L'instructor els compta en veu alta durant l'enregistrament i els presenta com «tot el que necessites per entendre la salut de l'aplicació amb LLM», tot afegint «i tots els que vulguem afegir». Llegeix-ho com un mínim, no com un màxim.
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
class MetricsCollector:
    """Collect and aggregate metrics."""

    def __init__(self):
        self.metrics = {
            "requests_total": 0,
            "errors_total": 0,
            "latency_sum": 0,
            "latency_count": 0,
            "tokens_input": 0,
            "tokens_output": 0,
            "cache_hits": 0,
            "cache_misses": 0,
        }

    def record_request(
        self,
        latency_ms: float,
        input_tokens: int,
        output_tokens: int,
        error: bool = False,
        cache_hit: bool = False,
    ):
        self.metrics["requests_total"] += 1
        self.metrics["latency_sum"] += latency_ms
        self.metrics["latency_count"] += 1
        self.metrics["tokens_input"] += input_tokens
        self.metrics["tokens_output"] += output_tokens

        if error:
            self.metrics["errors_total"] += 1

        if cache_hit:
            self.metrics["cache_hits"] += 1
        else:
            self.metrics["cache_misses"] += 1
| # | Comptador | Significat |
|---|---|---|
| 1 | requests_total | quantes crides |
| 2 | errors_total | quantes han fallat |
| 3 | latency_sum | suma acumulada de mil·lisegons |
| 4 | latency_count | recompte acumulat de mesures |
| 5 | tokens_input | tokens de prompt acumulats |
| 6 | tokens_output | tokens de generació acumulats |
| 7 | cache_hits | encerts acumulats |
| 8 | cache_misses | fallades de memòria cau acumulades |
Cinc coses per crida a l'LLM, un sol mètode 04:11:49: quant ha trigat, quants tokens d'entrada, quants de sortida, si ha fallat, si era a la memòria cau.
«Per tant, una crida de mètode ho captura tot.» 04:11:49
És una regla de disseny que convé explicitar: no escampis cinc increments de comptador pel codi. Canalitza'ls en un sol record_request, perquè afegir una novena mètrica sigui un canvi en lloc d'un exercici d'arqueologia. Observa també que cache_hits i cache_misses són mútuament excloents i incondicionals, de manera que encerts + fallades de memòria cau sempre és igual a peticions: un invariant gratuït que pots comprovar amb assercions a les proves.
Dos límits d'aquesta classe que la font no diu i que trobaràs el dia que la posis darrere d'un servidor web. self.metrics[k] += 1 és una lectura-modificació-escriptura, no una operació atòmica; per tant, en un servidor amb fils, les peticions concurrents perdran de tant en tant un increment. A més, els comptadors són en un diccionari simple, de manera que es reinicien en cada arrencada i no es poden sumar entre rèpliques. Cap de les dues coses no importa en una demostració. Totes dues importen tan bon punt la xifra es fa servir per prendre una decisió, i per això la resposta de producció és un client de mètriques real —comptadors de Prometheus o l'equivalent de la plataforma— mantenint record_request com a únic punt de crida al davant.
get_summary() és on es fa la derivació, amb una protecció a cada divisió perquè un col·lector acabat d'iniciar retorni 0 en lloc de llançar un ZeroDivisionError:
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
    def get_summary(self) -> dict:
        avg_latency = (
            self.metrics["latency_sum"] / self.metrics["latency_count"]
            if self.metrics["latency_count"] > 0
            else 0
        )
        error_rate = (
            self.metrics["errors_total"] / self.metrics["requests_total"]
            if self.metrics["requests_total"] > 0
            else 0
        )
        cache_hit_rate = (
            self.metrics["cache_hits"]
            / (self.metrics["cache_hits"] + self.metrics["cache_misses"])
            if (self.metrics["cache_hits"] + self.metrics["cache_misses"]) > 0
            else 0
        )

        return {
            "total_requests": self.metrics["requests_total"],
            "total_errors": self.metrics["errors_total"],
            "error_rate": f"{error_rate:.2%}",
            "avg_latency_ms": round(avg_latency, 2),
            "total_input_tokens": self.metrics["tokens_input"],
            "total_output_tokens": self.metrics["tokens_output"],
            "cache_hit_rate": f"{cache_hit_rate:.2%}",
        }
| Clau del resum | Format |
|---|---|
total_requests | int |
total_errors | int |
error_rate | f"{error_rate:.2%}": cadena de percentatge, 2 decimals |
avg_latency_ms | round(avg_latency, 2): nombre de coma flotant, 2 decimals |
total_input_tokens | int |
total_output_tokens | int |
cache_hit_rate | f"{cache_hit_rate:.2%}": cadena de percentatge, 2 decimals |
Observa el canvi deliberat de nom entre emmagatzematge i presentació: requests_total es converteix en total_requests. Els noms interns dels comptadors i la forma externa de l'informe poden diferir, i mantenir-los separats permet canviar-ne un sense trencar l'altre.
Pilar 3 — L'LLM instrumentat
La capa 3 és l'embolcall que automatitza les capes 1 i 2. Un invoke, tres senyals: una fila de mètriques, una línia de log JSON i un tram de LangSmith.
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
class InstrumentedLLM:
    """LLM with full instrumentation."""

    def __init__(self):
        self.llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
        self.metrics = MetricsCollector()
        self.logger = setup_logging()

    @traceable(name="instrumented_invoke")
    def invoke(self, query: str) -> str:
        start_time = time.time()
        error = False

        try:
            response = self.llm.invoke(query)
            result = response.content

            # Estimate tokens
            input_tokens = len(query.split()) * 4 // 3
            output_tokens = len(result.split()) * 4 // 3

            self.metrics.record_request(
                latency_ms=(time.time() - start_time) * 1000,
                input_tokens=input_tokens,
                output_tokens=output_tokens,
                error=False,
                cache_hit=False,
            )

            self.logger.info(
                "LLM request completed",
                extra={
                    "extra_data": {
                        "latency_ms": (time.time() - start_time) * 1000,
                        "input_tokens": input_tokens,
                        "output_tokens": output_tokens,
                    }
                },
            )

            return result

        except Exception as e:
            error = True
            self.metrics.record_request(
                latency_ms=(time.time() - start_time) * 1000,
                input_tokens=0,
                output_tokens=0,
                error=True,
                cache_hit=False,
            )

            self.logger.error(
                f"LLM request failed: {e}", extra={"extra_data": {"error": str(e)}}
            )

            raise
Llegeix amb atenció el camí de fallada, perquè és l'invariant 6 expressat en dotze línies:
- La latència es continua registrant en cas de fallada. La latència d'un temps d'espera esgotat és una dada real: possiblement la
latència més interessant que tens. Ometre-la esbiaixa la mitjana a la baixa precisament quan les coses van malament.
- Els tokens es registren com a 0 en cas de fallada, cosa honesta però que implica que
tokens_inputinfraestima
la despesa real si el proveïdor t'ha facturat una petició que després ha fallat en una etapa posterior.
raisetorna a llançar l'excepció. La monitorització observa; no absorbeix. Unreturn Noneaquí
convertiria una fallada evident en una de silenciosa: exactament el problema que aquesta part existeix per tractar.
L'heurística d'estimació de tokens i per què l'has de substituir.
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py  (lines 145-146)
            # Estimate tokens
            input_tokens = len(query.split()) * 4 // 3
            output_tokens = len(result.split()) * 4 // 3
paraules × 4 ÷ 3 ≈ 1.333 tokens per paraula, arrodonit a l'enter inferior. És una comoditat de demostració, no la realitat de la facturació. Es desviarà molt amb codi, text no anglès, paraules llargues, qualsevol cosa amb molta puntuació i —crític per a RAG— amb el context recuperat, que és precisament la part del prompt que domina la factura. La font no ho assenyala; s'hauria d'assenyalar.
La correcció és llegir l'ús real que retorna el proveïdor en lloc d'endevinar-lo a partir de la cadena. LangChain l'exposa al missatge de resposta. Això no és al fitxer distribuït: és el pedaç que hi hauries d'aplicar; per tant, verifica'n la forma exacta amb el proveïdor i la versió de LangChain abans de confiar en les xifres:
# Suggested replacement for the estimate — NOT in the shipped monitoring.py.
# ChatOpenAI returns an AIMessage carrying provider usage; prefer it over a word-count guess.
response = self.llm.invoke(query)
result = response.content

usage = getattr(response, "usage_metadata", None) or {}
input_tokens = usage.get("input_tokens")
output_tokens = usage.get("output_tokens")

if input_tokens is None or output_tokens is None:      # provider didn't report usage
    input_tokens = len(query.split()) * 4 // 3         # fall back to the estimate
    output_tokens = len(result.split()) * 4 // 3
Tres petits indicis de codi millorable al fitxer distribuït, anomenats perquè no els copiïs:
time.time() - start_timees calcula dues vegades al camí d'èxit (una per a mètriques, una
per al log), de manera que les dues xifres difereixen en uns microsegons. Calcula-ho una sola vegada en una variable local.
- La variable local
errors'assigna a totes dues branques i no es llegeix mai. Codi sense efecte. cache_hit=Falseestà fixat al codi a totes dues branques, i per això la demostració sempre informa d'una
taxa d'encerts de memòria cau del 0%. El camp existeix perquè hi connectis la memòria cau semàntica de la part d'aquesta guia dedicada a la memòria cau; la connexió simplement encara no està feta.
L'execució de demostració i què et diuen realment les xifres
# /home/oriol/lab/rag/code/production-course-main-code/monitoring.py
def demo_monitoring():
    """Demonstrate monitoring."""

    llm = InstrumentedLLM()

    print("Monitoring Demo:\n")

    queries = [
        "What is Python?",
        "Explain machine learning.",
        "What is 2 + 2?",
    ]

    for query in queries:
        result = llm.invoke(query)
        print(f"Query: {query[:30]}... -> {result[:30]}...")

    print("\nMetrics Summary:")
    summary = llm.metrics.get_summary()
    for key, value in summary.items():
        print(f"  {key}: {value}")
Per petició obtens una línia JSON amb timestamp, level, message: "LLM request completed", module: monitoring, function: invoke, més els tres camps d'extra_data: latency_ms, input_tokens, output_tokens 04:13:53.
I al final, l'agregat 04:14:54:
| Mètrica | Valor de demostració |
|---|---|
| peticions totals | 3 |
| errors totals | 0 |
| taxa d'errors | 0% |
| latència mitjana | ≈8,000 ms |
| tokens totals d'entrada | 14 |
| tokens totals de sortida | 876 |
| taxa d'encerts de memòria cau | 0% |
Mentrestant, LangSmith mostra 3 execucions anomenades instrumented_invoke, una per consulta, al projecte que l'instructor anomena «multi-agent» (el capítol 13 l'anomenava multi-agent research; la discrepància és seva, no teva: tria un nom i conserva'l), amb la latència visible directament a la llista d'execucions. Una execució ha trigat 17 segons: "Explain machine learning.", perquè ha generat una resposta llarga.
Ara llegeix aquesta taula com llegiries un quadre de comandament real, perquè és una petita lliçó magistral de per què les xifres en brut necessiten interpretació:
- Una taxa d'errors del 0% aquí no significa res. Tres peticions amb èxit. És exactament l'estadística
que es manté en verd mentre les respostes són inútils.
- Una latència mitjana de 8,000 ms és alarmant i és un artefacte de n=3. Fes els càlculs: una
execució de 17 segons més dues d'aproximadament 3.5 s sumen uns 24 s, i 24 / 3 = 8. La mitjana descriu una petició que no ha passat mai. És la germana de la lliçó de «no pots fer la mitjana de les mitjanes»: tampoc no et pots refiar d'una mitjana sense una distribució al darrere, i un p50 de ~3.5 s hauria explicat una història completament diferent i més honesta.
- 14 tokens d'entrada entre tres consultes curtes és exactament el que prediu l'heurística
words × 4 // 3:
3 paraules → 4, 3 paraules → 4, 5 paraules → 6. També és la prova que és un comptador de paraules i no un tokenitzador. No pot veure la sobrecàrrega de la plantilla de xat —marcadors de rol i delimitadors de missatge— que el proveïdor factura en cada crida, per curta que sigui la cadena; per tant, infraestima una quantitat fixa per petició, per sempre.
- La taxa d'encerts de memòria cau del 0% està fixada al codi, no mesurada.
LangSmith no és el teu agregador de logs
Aquest és l'advertiment final del capítol 04:15:57 i el punt operatiu més important d'aquesta part.
«Són dos sistemes separats: dades complementàries.» 04:15:57
| LangSmith | Datadog / CloudWatch / Elasticsearch | |
|---|---|---|
| Rep | Traces / trams | Línies de log JSON estructurades |
| De | (a) el decorador @traceable i (b) la instrumentació incorporada de LangChain | el teu StreamHandler escrivint la sortida de JSONFormatter als fluxos estàndard del procés |
| Punts forts | Estructura causal per execució: trams imbricats, prompts, generacions, tokens/cost per node | Cerca i agregació de tota la flota, alertes, retenció, correlació amb serveis sense LLM |
| Punts febles | Ser el sistema de registre de referència de tota la resta que fa el servei | Reconstruir la forma d'un graf imbricat de crides a l'LLM |
Dues fonts de traces, una destinació de traces; una font de logs, una altra destinació de logs. Posar-ne una en marxa no et dona l'altra. La implicació pràctica per a un servei RAG de producció és que executes tots dos: LangSmith per a «per què aquesta resposta era incorrecta», l'agregador per a «quantes peticions de l'organització client X van superar 1 segon dimarts passat».
Avaluacions: el pilar que la font no demostra mai
Diguem-ho clarament, perquè és el buit més gran del material d'origen. Les avaluacions s'anomenen com un dels tres pilars i no es demostren enlloc. El capítol 12 les defineix (correcció, rellevància, retorn humà, detecció de regressions). El capítol 13 assenyala la pestanya Evaluators de LangSmith en una frase i continua 02:37:05. El capítol 19 no les esmenta gens. Totes les xifres que la font et dona sobre avaluacions —inclosa la 0.85 quality score de la diapositiva de retorn de la inversió— provenen d'un node de comprovació de qualitat dins d'un graf de demostració, no d'un entorn d'avaluació.
Això importa perquè les avaluacions són l'únic pilar que detecta el mode de fallada amb què ha començat tota aquesta part. Les traces mostren una execució d'aparença saludable. Les mètriques mostren un cost i una latència d'aparença saludable. Les fallades silencioses són invisibles per a tots dos per construcció. Un sistema amb traces i mètriques però sense avaluacions és un sistema que et dirà amb confiança que va bé mentre retorna respostes incorrectes, exactament la situació descrita a 04:04:43: les crides a l'API es fan i encara no saps si funciona.
El que necessites realment, exposat com a requisits en lloc de fingir que la font ho cobreix:
- Un conjunt de referència. De cinquanta a uns quants centenars de triples (pregunta, resposta esperada, fragment font esperat)
extrets del corpus real i de les preguntes dels usuaris reals. Aquesta és la part cara i no hi ha manera d'evitar-la.
- Mètriques de recuperació, mesurades per separat de la generació. Recall@k i MRR contra la
columna de fragment font esperat responen «ha tornat el fragment adequat?» És l'invariant 1 fet mesurable: la qualitat s'hereta cap endavant, de manera que mesures primer l'etapa més primerenca, i per això la part 4 insisteix a provar la recuperació per separat abans de culpar el model. Si recall@k és baix, cap canvi de prompt no et salvarà.
- Mètriques de generació. Fonamentació en les fonts (cada afirmació està sustentada pel context recuperat?)
i rellevància (respon la pregunta plantejada?). A la pràctica són puntuacions amb un LLM com a jutge, cosa que vol dir que l'avaluador és alhora un sistema no determinista i necessita les seves pròpies comprovacions puntuals contra etiquetes humanes.
- Captura de retorn humà. Un vot positiu/negatiu a cada resposta, escrit al mateix magatzem que
les traces perquè puguis saltar d'una queixa a l'execució exacta.
- Un control de regressió. La bateria d'avaluació s'executa en CI amb cada canvi de prompt, segmentador, model d'embeddings o
k, i fa fallar la construcció si hi ha una caiguda. Sense aquest pas, els altres quatre són un projecte científic, perquè la promesa de la diapositiva —«veure canvis de comportament abans que els usuaris es queixin»— és el control, no el conjunt de dades.
Els patrons d'implementació de la meitat de CI es troben a la part de proves d'aquesta guia; els patrons d'LLM com a jutge i de recuperació amb autocorrecció, a la part de RAG agèntic. El que pertany aquí és el balanç honest: la font resol traces i mètriques; les avaluacions te les deixa a tu.
Què instrumentar en un pipeline RAG, en concret
La font instrumenta un sol llm.invoke. Una petició RAG té més punts d'observació. Aquesta taula n'és la traducció: aplica @traceable a cadascun d'aquests límits i registra aquests camps a extra_data:
| Tram | Registra | Per què ho voldràs a les 3 de la matinada |
|---|---|---|
rag_request (més extern) | user_id, tenant, request_type, latència total, cost total | La clau d'unió de tota la resta; la unitat a què es refereix la xifra de retorn de la inversió |
rewrite_query | consulta original, consulta reescrita | Et diu si una resposta incorrecta responia una pregunta diferent |
embed_query | nom del model i versió, dimensió, latència | Auditoria de l'invariant 2: l'única manera de detectar una deriva de model entre índex i consulta |
vector_search | k, diccionari de filtre, identificadors retornats, puntuacions originals, nom del magatzem | Les puntuacions tenen una polaritat específica de cada magatzem; registra el valor original i la polaritat |
keyword_search | k, identificadors retornats, puntuacions BM25 | Necessari per atribuir un resultat de fusió a una branca |
fuse / rerank | posició abans, posició després, model fet servir | Demostra si el reranker es guanya la latència que costa |
assemble_context | nombre de fragments, tokens de context, si hi ha hagut truncament | El terme dominant de la factura i la causa habitual de «la resposta era allà en algun lloc» |
generate | model, tokens de prompt, tokens de generació, motiu de finalització | Atribució de costos i detecció de truncament |
validate_output | resultat de validació, indicador de rebuig | Distingeix «el model ha rebutjat correctament» de «el model ha fallat» |
Llista de comprovació i decisions que cal prendre
Llista que bloqueja la publicació: res d'això no és opcional abans de tenir usuaris reals:
uv add langsmith;LANGSMITH_API_KEYiLANGSMITH_TRACINGa.env;.enva
.gitignore.
- Decideix qui controla l'interruptor de traces:
.envoos.environal codi, mai tots dos. En
producció hauria de guanyar .env perquè puguis desactivar les traces sense desplegar.
LANGSMITH_PROJECTestablert en un nom significatiu, amb projectes separats per entorn.- Verifica que pots veure les teves traces al quadre de comandament. Una vegada, deliberadament, abans de
continuar. Actualitza el navegador abans de concloure que està espatllat.
@traceableal gestor de peticions més extern i a cada límit d'etapa de la taula
anterior. Totes les funcions traçades reben arguments i retornen un valor; altrament la traça registra una entrada buida i una sortida nul·la.
user_id/tenant/request_typepassats com a arguments perquè es converteixin en metadades
filtrables.
- Registre estructurat JSON (
JSONFormatter) en un logger amb nom, amb la protecció dehandlers
aplicada, un flux explícit (StreamHandler(sys.stdout); el predeterminat és stderr) i una destinació decidida: Datadog, CloudWatch o Elasticsearch.
- Un
MetricsCollector(o l'equivalent de Prometheus) que registra els cinc fets per crida
a través d'un mètode: latència, tokens d'entrada, tokens de sortida, error, encert de memòria cau.
latency_sumilatency_countdesats per separat. Proporcions derivades en llegir, mai
desades amb la mitjana precalculada.
- Ús real de tokens del proveïdor connectat, amb l'heurística
words × 4 // 3relegada a una
alternativa i etiquetada com a estimació allà on aparegui.
- Tots els
exceptdel camí de monitorització acaben enraise. Cerca-ho amb grep; és una revisió d'una línia
que detecta tota la classe de problemes de «la monitorització ha fet caure la producció».
- Tots els bucles tenen un límit estricte d'iteracions a més de la sortida de qualitat, i el nombre d'iteracions es
registra com a mètrica perquè la deriva aparegui abans que la factura.
- Alertes realment connectades, no només mètriques recollides: la docstring del mateix fitxer de la font
promet «registre estructurat, mètriques i alertes» i no inclou cap alerta. Com a mínim: taxa d'errors en una finestra mòbil, latència al percentil triat, cost per petició respecte de la mediana recent i caiguda de la puntuació d'avaluació entre desplegaments.
- Un conjunt de referència d'almenys vint preguntes amb fragments font esperats i un script que
mostra recall@k.
- La prova de passivitat se supera. Elimina la capa de monitorització en una branca, executa la bateria de
proves i confirma que cada resposta és idèntica byte a byte. Si no ho és, la monitorització forma part del flux de control i has publicat un nou mode de fallada en lloc de visibilitat sobre els antics.
Decisions que cal prendre i com prendre-les:
| Decisió | Tria l'opció fàcil quan… | Tria l'opció més difícil quan… |
|---|---|---|
| Traces allotjades (LangSmith) o OTEL autoallotjat | Fas servir LangChain/LangGraph, prototipes o sou un equip petit: dues variables d'entorn superen una setmana de connexions del col·lector | Els prompts o els documents recuperats no poden sortir de la infraestructura, o ja executes una pila OTEL/Grafana amb què has de correlacionar |
| Traçar-ho tot o mostrejar | Desenvolupament i qualsevol volum en què el cost i l'emmagatzematge siguin irrellevants | Volum alt: aleshores mostreja les execucions amb èxit i conserva el 100% dels errors i de les execucions amb puntuació d'avaluació baixa, que és on hi ha la informació |
| Tokens estimats o ús del proveïdor | Mai, si es tracta de diners. Només per a una prova bàsica local de funcionament | Sempre, per a qualsevol cosa a partir de la qual algú prendrà una decisió |
| Latència mitjana o percentils | Primer dia, n és petit, necessites una xifra | Tan bon punt tens trànsit real: una mitjana amb un valor atípic de 17 segons (vegeu la demostració) indueix activament a error |
| Mètriques dins del procés o backend real | Un sol procés, una demostració, un contenidor | Més d'una rèplica: un diccionari dins del procés es reinicia a cada arrencada i no es pot agregar entre instàncies |
| Construir les avaluacions ara o després | Mai «després»: vint preguntes són una tarda | Sempre ara. És l'únic pilar que mesura correcció i és el que la font et deixa construir |