
Chunking: el factor que més influeix en la qualitat
Divisors de text, mida i solapament dels fragments, chunking semàntic i un banc de proves A/B: la decisió que condiciona la resta.
Ets a la fase A, casella 2 del model mental: Load ──► Split ──► Embed ──► Store. Aquesta casella determina si alguna de les que té a la dreta podrà funcionar mai. Tot el que es tracta de les parts 4 a 16 —embeddings millors, cerca híbrida, reranking, compressió, recuperació agèntica— opera sobre les unitats que fabrica aquesta etapa. Si les unitats són inadequades, tota aquesta maquinària està polint l'objecte equivocat.
És l'invariant 1 reformulat de la manera més contundent: la qualitat s'hereta cap endavant i mai no es recupera en les etapes posteriors. L'instructor en diu la «veritat crua» 00:33:37: el millor model d'embeddings, la base de dades vectorial més ràpida i l'LLM més intel·ligent, junts, continuen produint resultats inútils si el chunking és incorrecte. Els diners no resolen un error de chunking.
«El chunking no és preprocessament. És arquitectura.» 00:36:40
Repeteix aquesta frase dues vegades seguides expressament. El fragment és l'àtom del teu sistema: és allò de què es genera l'embedding, allò que s'indexa, allò que es recupera, allò que arriba a la finestra de context i allò sobre el qual es demana al model que raoni. Triar-ne la forma és una decisió arquitectònica tan duradora com triar un esquema i, com concreta la part 4, canviar-la més endavant implica tornar a generar els embeddings i tornar a indexar tot el corpus.
Aquesta part concentra deliberadament la teoria al començament, perquè és la teoria el que et permet interpretar l'experiment final. Aquest experiment és el resultat individual més valuós del curs d'origen, perquè refuta la recomanació del mateix curs: en un document estructurat amb encapçalaments, el chunking semàntic —l'estratègia «prèmium»— perd per 1 a 4 contra el simple chunking recursiu.
On se situa la divisió: el pipeline d'indexació de quatre etapes
La meitat de RAG dedicada a la indexació consta de quatre etapes i res més 00:28:27:
- Càrrega: un carregador de documents extreu el text i normalitza els formats (part 2).
- Divisió: talla el text en fragments d'aproximadament 500 a 1,000 caràcters, respectant
els límits de les frases i afegint solapament perquè el significat es conservi a les unions.
- Generació d'embeddings: converteix cada fragment en un vector (part 4).
- Emmagatzematge: desa els vectors, el text original i les metadades en una base de dades vectorial (part 4).
El sistema només està preparat per rebre consultes després de l'etapa 4. L'etapa 2 és la que mereix un estudi aprofundit, perquè és l'única en què prens una decisió irreversible sobre el significat sense cap senyal de retorn. Les etapes 1, 3 i 4 fallen de manera evident: si falta un analitzador, es llança una excepció; si la dimensió és incorrecta, es llança una excepció; si la connexió falla, es llança una excepció. L'etapa 2 mai no llança cap excepció. Produeix fragments perfectament vàlids de text perfectament inútil i els passa a les etapes següents.
La fallada que no pots veure: el fragment 47 i el fragment 48
Considera l'exemple que el curs fa servir al llarg de tot el capítol: 50 pàgines de documentació d'una API que contenen una secció d'autenticació amb OAuth2 00:29:29.
Divideix-lo en fragments de 500 caràcters fixos. No hi ha cap algoritme darrere d'aquest límit: talles allà on s'esgota el comptador. La secció d'OAuth2 queda a banda i banda del tall, enmig d'una frase:
- El fragment 47 acaba contenint alguna cosa com ara *«per autenticar-te, primer has d'obtenir
l'identificador de client…»*
- El fragment 48 continua amb «…portal de desenvolupadors, i després fer una petició POST…»
Ara un usuari pregunta «com m'autentico amb OAuth2?». El veredicte 00:30:32:
«Quan fem la cerca, cap dels dos fragments no conté la resposta completa.»
En aquest mateix document, el chunking semàntic talla pels límits del significat i tota la secció d'OAuth2 queda intacta en un únic fragment 12. Els mateixos documents, el mateix model d'embeddings, la mateixa base de dades vectorial, la mateixa consulta: «resultats com de la nit al dia» 00:31:34. L'única variable que ha canviat és la manera de tallar el text.
Per què falla el mecanisme
Aquesta és la idea més subtil i útil del capítol, i val la pena aturar-s'hi. Quan generes l'embedding del fragment 47, el model d'embeddings fa la seva feina perfectament. Llegeix credencials de client, alguna cosa sobre desenvolupadors, una idea incompleta, i produeix un vector fidel exactament a això. No té manera de saber que el text és un fragment. La seva feina és generar-ne l'embedding 00:31:34.
«No s'equivoca. Representa amb precisió un fragment incomplet.» 00:32:35
Per tant, el vector resultant és correcte i inútil. El vector de la consulta codifica un concepte complet; els vectors emmagatzemats codifiquen fragments. Aquestes dues coses no es troben a la mateixa zona de l'espai d'embeddings, de manera que la cerca per similitud retorna allò que més s'assembla a mitja idea, que acostuma a ser una altra mitja idea. La diapositiva ho il·lustra amb vidres trencats; l'instructor recorre a una analogia millor 00:32:35:
«Imagina que estripes una fotografia a trossos i demanes a algú que hi trobi la persona que somriu.»
Si el somriure queda repartit entre dos trossos, cap dels dos no mostra un somriure. El tret pel qual vols cercar només existeix en el conjunt. Estripar-lo el destrueix, i cap millora de la cerca no el recupera.
Els tres perjudicis en les etapes posteriors
Un chunking inadequat degrada exactament tres coses 00:33:37, i convé anomenar-les per separat perquè presenten símptomes diferents:
| Perjudici | Símptoma que observes |
|---|---|
| Precisió de la recuperació | El fragment adequat no apareix mai entre els top-k. |
| Eficiència del context | Malbarates la finestra de context amb fragments parcials: has pagat per tokens que no responen res. |
| Qualitat de la resposta | Fins i tot recuperant els fragments adequats, el model no pot sintetitzar a partir de fragments incomplets; necessita una secció completa. |
Observa que el tercer problema persisteix amb un recuperador perfecte. És l'aspecte que sovint passa desapercebut: corregir la recuperació no resol la fragmentació, perquè el model continua rebent text estripat.
Les quatre variables que realment controles
Hi ha exactament quatre paràmetres que pots ajustar 00:33:37: mida del fragment, solapament, límit de divisió i tipus de contingut. Qualsevol estratègia de chunking existent és una configuració concreta d'aquests quatre paràmetres.
Variable 1 — Mida del fragment (una fallada en tots dos extrems)
| Direcció | Què falla | Efecte de segon ordre |
|---|---|---|
| Massa petit | Els fragments perden context: un fragment que només diu «identificador de client» no significa res | Més fragments → més soroll en la recuperació (més candidats competint per entrar als top-k) |
| Massa gran | Els fets concrets es dilueixen en la mitjana: 10 pàgines de text produeixen un embedding molt vague | Malbaratament del pressupost de tokens a la finestra de context |
El punt òptim és al voltant de 200 a 1,000 tokens 00:34:38. El mateix repositori prova exactament aquest interval:
# production-course-main-code/text_splitters.py
def chunk_size_comparison():
    sizes = [200, 500, 1000]

    print("=== Chunk Size Comparison ===")
    for size in sizes:
        splitter = RecursiveCharacterTextSplitter(
            chunk_size=size, chunk_overlap=size // 5
        )  # 20% overlap
        chunks = splitter.split_text(SAMPLE_TEXT)
        print(f" Size {size}: {len(chunks)} chunks")
Variable 2 — Solapament
El solapament duplica una zona de text entre fragments consecutius perquè una idea situada a banda i banda de la unió es conservi completa almenys en un fragment 00:34:38. Sense solapament, una frase que travessa el límit queda desconnectada per totes dues bandes i no es preserva el context.
Regla pràctica: 10–20% de la mida del fragment. El repositori és inconsistent internament a l'hora de triar-ne un valor, i ho has de saber abans de copiar cap xifra:
RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)— 10% — es fa servir a
recursive_splitter(), document_splitter(), rag_pipeline.create_kb() i pràcticament a tot el repositori de producció.
chunk_overlap = size // 5— 20% — es fa servir només achunk_size_comparison().
Tots dos apareixen a menys de 20 línies de distància dins del mateix fitxer. Considera el 10% com el valor predeterminat que es distribueix i el 20% com el «bon solapament» al qual es refereix la regla 80/20.
Val la pena executar una vegada la demostració del solapament, perquè fa visible la unió:
# production-course-main-code/text_splitters.py
def overlap_importance():
    text = "The quick brown fox jumps over the lazy dog. " * 10  # Repeated text

    # without overlap
    no_overlap = RecursiveCharacterTextSplitter(chunk_size=50, chunk_overlap=0)

    # with overlap
    with_overlap = RecursiveCharacterTextSplitter(chunk_size=50, chunk_overlap=20)

    chunks_no_overlap = no_overlap.split_text(text)
    chunks_with_overlap = with_overlap.split_text(text)

    print("Without overlap:")
    print(f"  Chunk 1 end: ...{chunks_no_overlap[0][-20:]}")
    print(f"  Chunk 2 start: {chunks_no_overlap[1][:20]}...")

    print("\nWith overlap:")
    print(f"  Chunk 1 end: ...{chunks_with_overlap[0][-20:]}")
    print(f"  Chunk 2 start: {chunks_with_overlap[1][:20]}...")
Aquesta frase —«The quick brown fox jumps over the lazy dog»— és la mateixa que fa servir la diapositiva de chunking fix per mostrar la destrossa de tallar al mig d'una paraula. La demostració mostra els últims 20 caràcters del fragment 1 al costat dels primers 20 del fragment 2, perquè puguis veure amb els teus propis ulls si la unió s'ha resolt.
Variable 3 — Límit de divisió
Tres mètodes, ordenats de pitjor a millor 00:35:40:
| Mètode | Què determina el tall | Veredicte |
|---|---|---|
| Fix | Cada N caràcters: «en essència, més aviat un tall aleatori» | No ho facis. |
| Recursiu | Separadors estructurals naturals, provats per ordre de preferència | Més intel·ligent. L'opció predeterminada. |
| Semàntic | On canvia el significat: ni aleatòriament ni tan sols als límits dels paràgrafs | Prèmium, segons les condicions. |
Variable 4 — Tipus de contingut
El codi, els documents jurídics i el Markdown són tipus de contingut molt diferents, i cadascun necessita un tractament diferent 00:35:40. El desastre paradigmàtic és el codi: talla un bucle for per la meitat i cap de les dues meitats no serveix de context, perquè en el moment de la consulta el model no té manera de tornar a ajuntar les peces 00:36:40. La regla per al codi és senzilla: mantén les funcions senceres, mantén les classes senceres.
Les quatre estratègies
El curs les presenta com una escala de maduresa 00:37:42: Fix (bàsic) → Recursiu (intermedi) → Semàntic (intermedi) → Chunking tardà (avançat).
«Quan entens el chunking, controles la qualitat de RAG des de l'origen.» 00:37:42
Estratègia 1 — Chunking de mida fixa: mai
Mecanisme: dividir cada N caràcters o tokens, sense tenir gens en compte el contingut. Amb la frase «The quick brown fox jumps over the lazy dog», la diapositiva repassa la destrossa 00:37:42:
- Fragment 1 =
"The quick brown fox jump": tall al mig d'una paraula, incomplet. - Fragment 2 =
"ps over the la": sense context, pèrdua total del sentit del fragment. - Fragment 3 =
"zy dog": massa petit per ser útil.
La llista de perjudicis: destrueix el significat, perd el context, empitjora la recuperació, produeix frases incompletes i text que resulta difícil d'entendre per a un model. L'advertiment de l'instructor és la frase més emfàtica de tot el capítol:
«No ho feu servir en producció. D'acord? Mai. Mai. Mai. Mai de la vida.» 00:39:43
Els usos legítims són molt limitats: implementacions senzilles en què necessites processament ràpid i mides predictibles, prototips ràpids o una restricció externa estricta que imposi finestres fixes. Observa que CharacterTextSplitter —el segmentador de mida fixa— s'importa a text_splitters.py del curs i no es crida mai. Aquest silenci és la recomanació.
Estratègia 2 — Chunking recursiu: l'opció predeterminada fiable
El chunking recursiu és l'opció predeterminada a LangChain i, segons l'instructor, a molts altres frameworks. El seu mecanisme és una escala d'alternatives: intenta dividir pel separador natural de més preferència; si una peça resultant encara supera chunk_size, passa recursivament al separador següent.
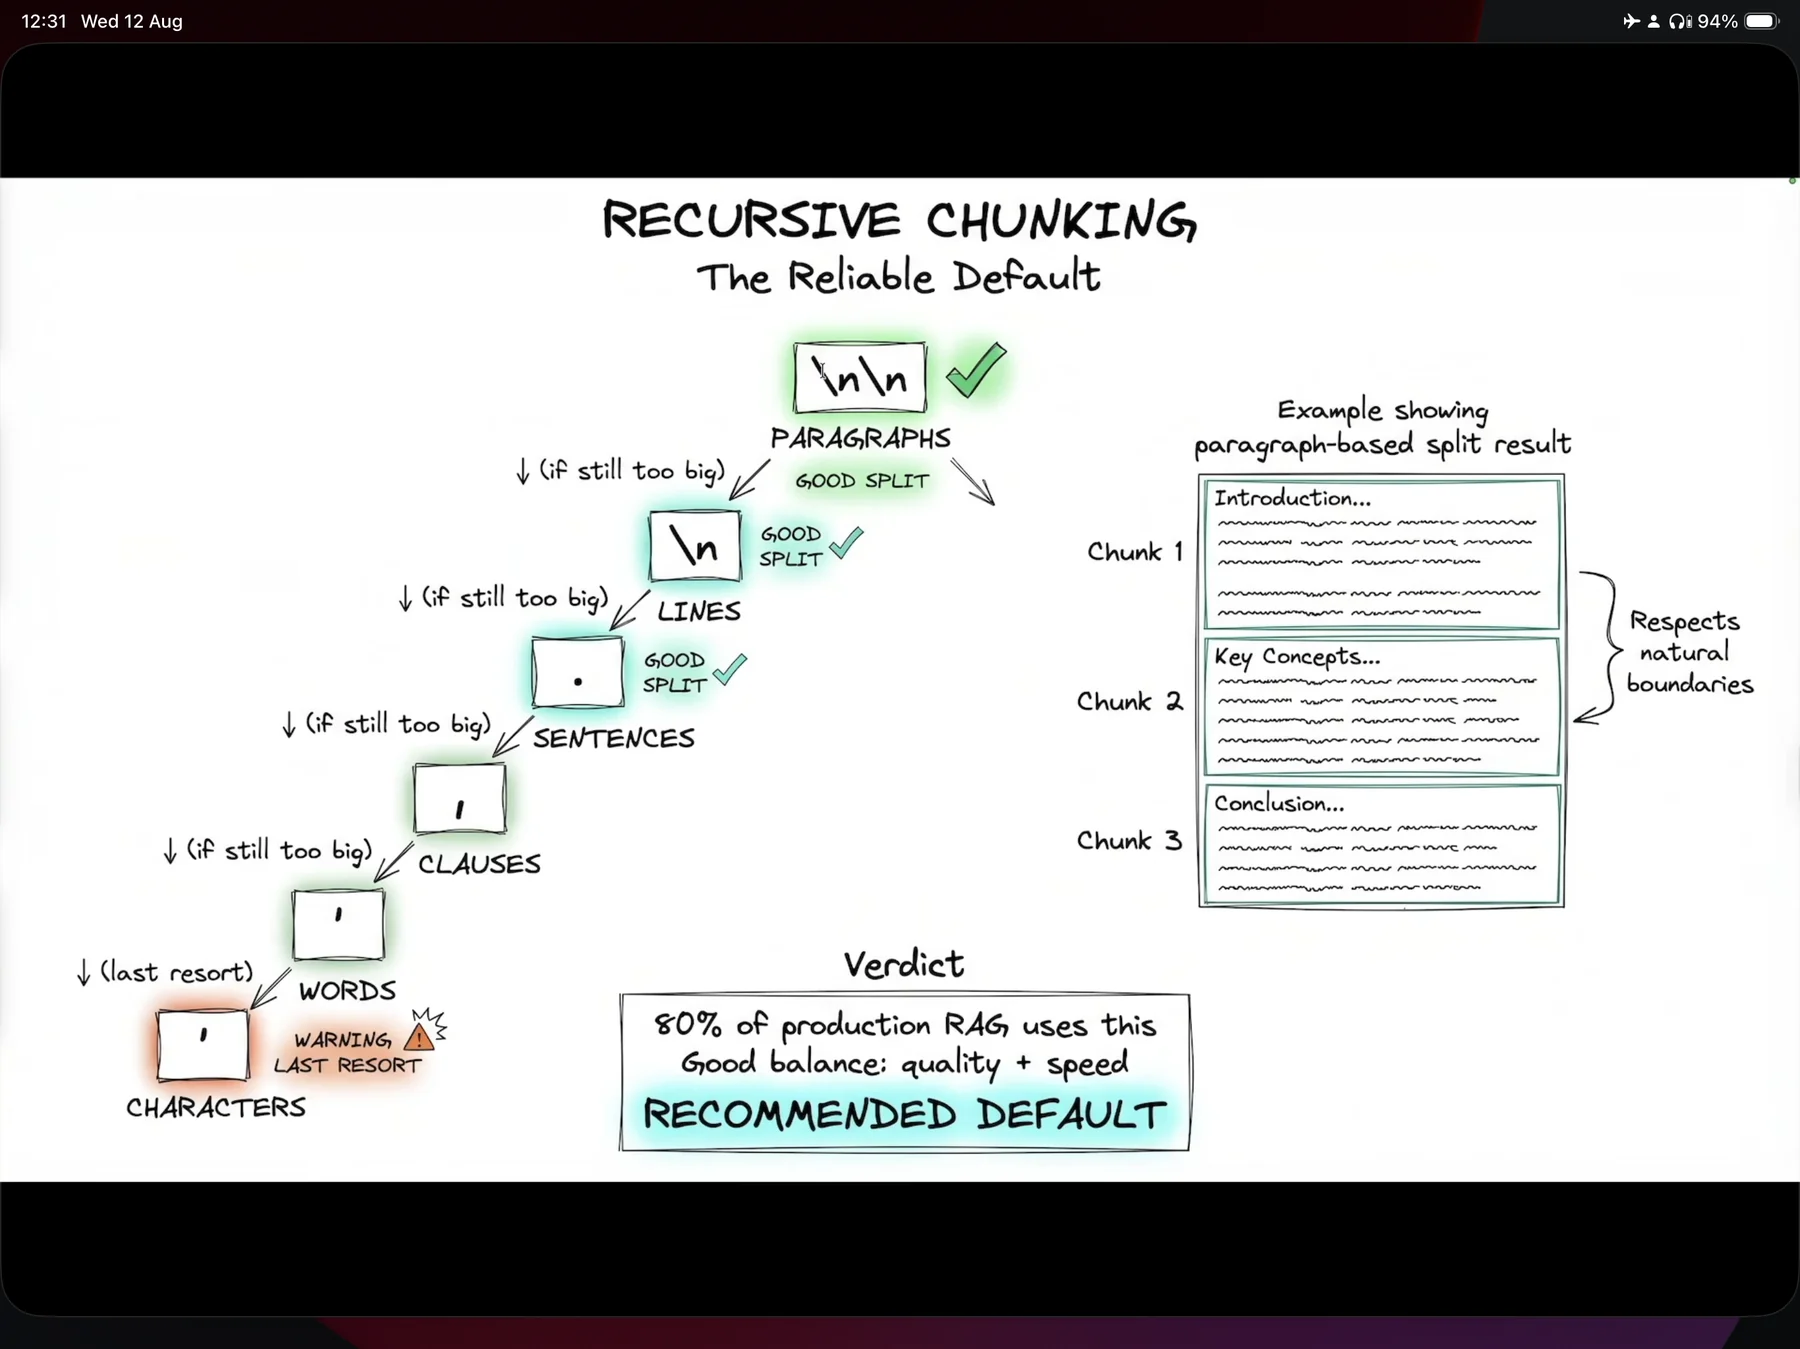
chunk_size; per tant, un document ben format amb salts de paràgraf reals mai no baixa més enllà de \n\n, que és precisament el motiu pel qual el chunking recursiu guanya la prova A/B al final d'aquesta part.La jerarquia, per ordre:
- Paràgrafs —
\n\n✅ bona divisió - Línies —
\n✅ bona divisió - Frases —
.✅ bona divisió - Clàusules —
, - Paraules —
- Caràcters — ⚠ ÚLTIM RECURS
L'exemple resolt de la diapositiva és un document amb tres paràgrafs —Introducció, Conceptes clau, Conclusió— que es converteixen en els fragments 1, 2 i 3 sense modificar-se: l'escala no passa mai del primer esglaó, de manera que els límits establerts per l'autor es conserven intactes.
Darrere d'aquest ordre hi ha una teoria del significat, i és el motiu pel qual l'escala no és arbitrària: un paràgraf és una idea; una frase és una idea; per sota d'això, talles a l'interior d'una idea. Cada descens sacrifica una mica més de significat per ajustar-se una mica més a la mida. Arribar a l'esglaó dels caràcters és possible, però no desitjable 00:40:45.
El requadre de veredicte de la mateixa diapositiva:
El 80% dels sistemes RAG en producció ho fan servir. Bon equilibri: qualitat + velocitat. OPCIÓ PREDETERMINADA RECOMANADA.
Aquesta xifra del 80% no té cap citació: és la impressió de l'instructor sobre el terreny, no una mesura. L'orientació és correcta (el recursiu és l'opció predeterminada del sector), però no citis la xifra com un fet.
Aquesta és la implementació real, amb l'escala passada explícitament:
# production-course-main-code/text_splitters.py
def recursive_splitter():
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=500,
        chunk_overlap=50,
        separators=["\n\n", "\n", " ", ""],
    )
    chunks = splitter.split_text(SAMPLE_TEXT)

    print(f"Original length: {len(SAMPLE_TEXT)} chars")
    print(f"Number of chunks: {len(chunks)}")
    print(f"Chunk sizes: {[len(c) for c in chunks]}")
    print(f"\nFirst chunk preview:\n{chunks[0][:200]}...")
Tres aspectes que cal observar:
separators=["\n\n", "\n", " ", ""]és exactament el valor predeterminat de la biblioteca (character.py
recorre a aquesta llista quan separators és None). Aquí es passa per claredat. Observa també que és més curta que la jerarquia de la diapositiva: la versió del repositori omet els esglaons de frase (.) i clàusula (,) i salta directament de les línies a les paraules. Si vols el comportament de la diapositiva, has de passar tota l'escala tu mateix: separators=["\n\n", "\n", ". ", ", ", " ", ""].
- El
""final és important. És l'esglaó que divideix entre caràcters arbitraris, i
és l'únic que pot garantir que una peça s'ajusti a la mida. Si l'ometes, una seqüència de text indivisible s'emet amb una mida excessiva, amb un simple logging.warning («Created a chunk of size N, which is longer than the specified M») per avisar-te'n. Si no reculls els logs de LangChain, aquest avís és invisible.
split_text()retorna una llista de cadenes de text simples, no objectesDocument. Això té molta
importància: consulta el parany de split_documents més avall.
Estratègia 3 — Chunking semàntic: l'opció prèmium
El chunking semàntic divideix pel significat, no per l'estructura 00:41:45. L'algoritme consta de tres passos:
- Generar l'embedding de cada frase individualment.
- Comparar els embeddings adjacents: similitud entre la frase i i la i+1.
- Dividir allà on cau la similitud. La caiguda és el límit temàtic.
Recorre el gràfic de similitud: mentre les frases consecutives es mantenen dins del tema, la similitud entre frases adjacents es manté alta; quan cau, el significat s'ha acabat i aquell punt es converteix en el límit del fragment. Les frases s'agrupen en seqüències: fragment 1 = S1, S2, S3; fragment 2 = S4, S5, S6: divisions netes, basades en el tema 00:42:46.
En codi:
# Reconstructed from the narration at [02:41:01]; the on-screen file
# chunking/semantic_chunking.py is not present in either published repo.
# Requires a separate install: uv add langchain-experimental
from langchain_experimental.text_splitter import SemanticChunker
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

semantic_splitter = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile",
    breakpoint_threshold_amount=90,
)
semantic_chunks = semantic_splitter.split_text(API_DOCS)
Aquests dos paràmetres constitueixen tota la configuració disponible:
| Paràmetre | Significat |
|---|---|
breakpoint_threshold_type="percentile" | Determina els punts de tall pel percentil de la distribució de dissimilitud observada (les alternatives són la desviació estàndard, l'interval interquartílic i el gradient). |
breakpoint_threshold_amount=90 | Divideix al percentil 90: només el ~10% de salts de significat més grans es converteixen en límits. Més alt = menys fragments i més grans. |
On té sentit: RAG d'alt valor en què la qualitat importa, com ara documents jurídics, manuals tècnics i bases de coneixement 00:41:45. El compromís s'exposa clarament: fes-lo servir quan la precisió importi més que la velocitat, perquè s'està fent més càlcul en segon pla.
Estratègia 4 — Chunking tardà: l'enfocament més recent (referència a una part posterior)
El chunking tradicional (també anomenat primerenc) segueix aquest ordre: document → divisió en fragments 1, 2, 3 → generació de l'embedding de cada fragment per separat. L'embedding de cada fragment es genera de manera aïllada, de manera que es perd el context entre fragments: el fragment 5 no sap què contenen els fragments de l'1 al 4 00:43:47. El símptoma clàssic, en paraules del mateix fitxer del repositori del curs: «Ell va fundar l'empresa»: qui és «ell»? El referent era al fragment anterior.
El chunking tardà inverteix l'ordre: primer genera els embeddings del document complet (produint embeddings a nivell de token) i després divideix aquests embeddings en vectors per fragment, agregant els embeddings dels tokens de cada tram. Com que primer s'han generat els embeddings de tot el document, els fragments tenen informació els uns dels altres.
| Chunking tardà | |
|---|---|
| Resultat | Millora de precisió del +10–12% en tasques de recuperació |
| Avantatges | Es conserva el context del document complet; millor tractament dels límits |
| Inconvenients | Implementació més complexa; compatibilitat limitada dels models |
| Requereix | Un model que exposi embeddings a nivell de token: la família Jina |
El veredicte per al moment actual 00:45:48:
«Aquest és el futur del chunking… però, de moment, el chunking semàntic és la millor opció pràctica.»
La comparació completa entre chunking tardà i primerenc es tracta a la part 14. Encara no t'hi juguis la producció.
Les quatre estratègies, cara a cara
| Estratègia | Regla per als límits | Cost d'indexació | Qualitat | Quan fer-la servir |
|---|---|---|---|---|
| Fix | Cada N caràcters/tokens | Trivial | Destrueix el significat | Mai en producció; només per a prototips i restriccions estrictes |
| Recursiu | Escala ordenada de separadors | Trivial | Bona | Opció predeterminada per a gairebé tot |
| Semàntic | Caiguda de similitud entre frases adjacents | Genera l'embedding de cada frase i després torna a generar el de cada fragment | El millor per a prosa contínua | Text no estructurat, documents jurídics, manuals tècnics |
| Tardà | Divideix després de generar els embeddings del document | Model específic + més complexitat | +10–12% | Cal seguir-ne l'evolució (part 14) |
Triar una estratègia
L'arbre de decisió
Recorre'l per ordre 00:45:48:
- Ha de ser ràpid (prototip) o és acceptable que sigui lent? → ràpid ⇒ recursiu.
- Són documents senzills i estructurats? → sí ⇒ recursiu.
- La qualitat és crítica? → sí ⇒ semàntic.
- Hi ha canvis de tema dins del contingut? → sí ⇒ semàntic; no ⇒ recursiu.
Observa quins resultats pot donar l'arbre: només recursiu o semàntic. El chunking fix i el tardà no són resultats vàlids de l'arbre de decisió per a producció. El fix queda exclòs perquè és inadequat; el tardà, perquè encara no està a punt.
La regla 80/20 i el requisit de mesurar
«El chunking recursiu amb un bon solapament et permet fer el 80% del camí.» 00:46:48
«El chunking semàntic et dona l'últim 20%. Però el problema és que costa més.» 00:46:48
I la disciplina que l'acompanya:
«Comença amb el recursiu i mesura la qualitat de la recuperació.» 00:46:48
Aquesta és la frase important. El pas del recursiu al semàntic està condicionat per una mètrica, no per l'ambició. No pots gastar en chunking semàntic fins que tinguis una xifra de qualitat de recuperació que indiqui que el recursiu és insuficient. (La manera d'obtenir aquesta xifra es tracta a la part 7, observabilitat, i a la part 15, avaluacions. Aquest és un dels motius principals pels quals aquesta guia avança l'observabilitat respecte del curs d'origen.)
Taula de consulta ràpida per tipus de contingut
L'instructor diu explícitament que en facis una captura de pantalla 00:46:48:
| Tipus de contingut | Estratègia | Mida del fragment |
|---|---|---|
| Documents generals | Recursiu: «fes servir el recursiu i prou» | 500–1,000 |
| Contingut tècnic / jurídic | Semàntic: «val la pena» | automàtica |
| Codi | Segmentador de codi | per funció |
| Markdown | Segmentador de MD | per encapçalaments |
«Automàtica» a la fila del semàntic significa que no estableixes cap mida: el llindar dels punts de tall decideix, i les mides dels fragments són variables per construcció. És una diferència operativa real: amb el chunking semàntic no pots garantir un límit superior de longitud dels fragments, i per això smart_chunker en valida les mides després.
Els segmentadors especialitzats
LangChain incorpora els segmentadors específics per tipus de contingut, de manera que no has de programar a mà un segmentador que entengui Python o Markdown 00:47:49.
Codi: no facis servir mai un segmentador genèric
# production-course-main-code/text_splitters.py
def code_splitter():
    python_splitter = RecursiveCharacterTextSplitter.from_language(
        language=Language.PYTHON, chunk_size=500, chunk_overlap=50
    )
    chunks = python_splitter.split_text(SAMPLE_CODE)
    print(f"Code Splitter produced {len(chunks)} chunks.")
    for i, chunk in enumerate(chunks):
        print(f"\nChunk {i} ({len(chunk)} chars):")
        print(chunk[:150] + "..." if len(chunk) > 150 else chunk)
from_language(language=Language.PYTHON, ...) substitueix l'escala de separadors genèrica per una que té en compte la sintaxi. Per a Python, la biblioteca retorna, per ordre: ["\nclass ", "\ndef ", "\n\tdef ", "\n\n", "\n", " ", ""]: primer les definicions de classe, després les funcions de nivell superior, després els mètodes amb sagnat i, només aleshores, els esglaons de la prosa ordinària. Aquest ordre és el que manté senceres les funcions i les classes. Les dades de prova SAMPLE_CODE del curs són dues funcions —quicksort() i binary_search()— triades precisament perquè puguis veure com el límit queda entre totes dues, en lloc de quedar dins d'una.
Markdown: els encapçalaments es converteixen en metadades
# production-course-main-code/text_splitters.py
def markdown_splitter():
    headers_to_consider = [
        ("#", "h1"),
        ("##", "h2"),
        ("###", "h3"),
    ]
    splitter = MarkdownHeaderTextSplitter(headers_to_split_on=headers_to_consider)
    chunks = splitter.split_text(SAMPLE_TEXT)

    print(f"Markdown Splitter produced {len(chunks)} chunks.")
    for i, chunk in enumerate(chunks):
        print(f"--- Chunk {i} ---")
        print(f" Metadata: {chunk.metadata}\n")
        print(f" Content: {chunk.page_content[:200]}...\n")
Les tuples (marker, metadata_key) són la clau. Cada fragment es retorna amb la seva ruta d'encapçalaments a metadata: per a les dades de prova SAMPLE_TEXT del repositori, és {"h1": "Introduction to Machine Learning", "h2": "Types of Machine Learning", "h3": "Supervised Learning"}. Això és el que permet fer citacions a nivell d'encapçalament més endavant («això prové de §Types of Machine Learning → Supervised Learning»), i és un camp filtrable en el moment de la consulta. Com concretarà la part 4, la possibilitat de filtrar es decideix en el moment de la indexació. Si ara no reculls la ruta d'encapçalaments, després no podràs filtrar-hi ni citar-la sense tornar a indexar.
split_documents o split_text: el parany que destrueix les metadades
Aquest és l'error més habitual en tot aquest àmbit, i és invisible fins que les citacions queden buides.
| Mètode | Entrada | Sortida | Metadades |
|---|---|---|---|
split_text(str) | una cadena de text | list[str] | destruïdes: no n'hi havia hagut mai |
split_documents(docs) | una llista de Document | list[Document] | propagades a tots els fragments |
split_documents rep una llista, encara que només hi hagi un document. Aquesta és la connexió real de les etapes 1 + 2 de principi a fi, directament del repositori:
# production-course-main-code/text_splitters.py
def document_splitter():
    from langchain_community.document_loaders import PyPDFLoader
    from langchain_core.documents import Document

    loader = PyPDFLoader("./docs/langchain_demo.pdf")
    docs = loader.load()

    print(f"Loaded {len(docs)} documents from PDF.")

    splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)

    # split the docs
    split_docs = splitter.split_documents(docs)

    print(f"Split into {len(split_docs)} chunks")
    print(f"\nFirst chunk metadata: {split_docs[0].metadata}")
    print(f"First chunk content: {split_docs[0].page_content[:200]}...")
    print(f"\nLast chunk metadata: {split_docs[-1].metadata}")
Mostrar les metadades del primer i de l'últim fragment és un hàbit que val la pena adoptar: demostra que els camps source i page han sobreviscut a la divisió en tot el rang, no només al començament. (La funció torna a importar PyPDFLoader i Document dins del seu propi cos, tot i que Document ja s'importa a nivell de mòdul: és innocu, però no ho reprodueixis com a estil.)
I quan el text no prové d'un carregador, embolcalla'l tu mateix en un Document per poder-hi adjuntar les metadades que voldràs citar: és exactament el que fa el fitxer del pipeline:
# production-course-main-code/rag_pipeline.py
def create_kb():
    """Create a vector store from knowledge base."""

    # split the knowledge base into chunks
    splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
    doc = Document(
        page_content=KNOWLEDGE_BASE, metadata={"source": "langchain_knowledge_base.md"}
    )

    chunks = splitter.split_documents([doc])

    # create a vector store from the chunks
    vector_store = Chroma.from_documents(
        documents=chunks,
        embedding=embeddings_model,
        persist_directory=tempfile.mkdtemp(),
    )
    return vector_store
Aquest és el pipeline complet de quatre etapes en catorze línies: un Document (etapa 1), una divisió recursiva a 500/50 (etapa 2), embeddings_model = OpenAIEmbeddings(model="text-embedding-3-small") declarat una sola vegada a nivell de mòdul (etapa 3) i Chroma.from_documents (etapa 4). Observa split_documents([doc]): els claudàtors de llista al voltant d'un sol document.
La comparació A/B mesurada: el chunking semàntic perd per 1–4
Tot el que hem vist fins ara és teoria, i la teoria diu que el chunking semàntic és l'opció prèmium. Aleshores, el curs fa el que és honest i ho mesura 02:37:58. El resultat contradiu la teoria, i l'instructor el manté al vídeo en lloc de repetir la demostració: «M'alegro que hagi passat per poder-vos mostrar els matisos d'aquestes estratègies diferents» 02:48:09. Aquesta decisió fa que aquests siguin els vint minuts més útils del material d'origen.
«El chunking semàntic funciona realment millor?» 02:37:58
El disseny de l'experiment
L'entorn de proves és la part reutilitzable, més que no pas el resultat:
| Element | Valor |
|---|---|
| Corpus | Un document, quatre temes deliberadament diferents: webhooks, gestió d'errors, limitació de freqüència i autenticació amb OAuth 2.0 |
| Format del document | Essencialment, un fitxer Markdown amb encapçalaments de secció ## |
| Model d'embeddings | text-embedding-3-small: idèntic per a les dues variants |
| Variant A | RecursiveCharacterTextSplitter(chunk_size=400, chunk_overlap=50, separators=["\n\n", "\n", ",", ". "]) |
| Variant B | SemanticChunker(embeddings, breakpoint_threshold_type="percentile", breakpoint_threshold_amount=90) |
| Magatzems | Dues col·leccions Chroma separades, una per variant, amb valors de collection_name diferents |
| Consultes | Les mateixes 4 consultes a totes dues variants |
| Recuperació | similarity_search(query, k=1) |
Els temes es van triar perquè fossin tan diferents com fos possible, precisament perquè la contaminació dels fragments fos visible a l'instant 02:38:58. I es va triar k=1 expressament 02:45:05: amb un únic resultat no hi ha on amagar-se; el primer resultat és correcte o incorrecte. Amb k=4, totes dues variants haurien pogut semblar bones.
Hi ha un detall de la variant A que convé copiar deliberadament o corregir deliberadament: la llista de separadors acaba a ". ", sense l'esglaó " " ni el "". Si una secció hagués superat els 400 caràcters sense cap coma ni cap límit de frase, el segmentador l'hauria emès amb una mida excessiva i només hauria registrat un avís. En aquest corpus no passa mai; en el teu podria passar.
Quin resultat en va sortir
Primer senyal, només d'inspeccionar els fragments [02:42:02–02:43:02]:
| Recursiu | Semàntic | |
|---|---|---|
| Total de fragments | 4 | 3 |
| Fragment 1 | Guia d'autenticació OAuth, 300 caràcters | autenticació |
| Fragment 2 | limitació de freqüència, 283 caràcters | limitació de freqüència + gestió d'errors (barrejades) |
| Fragment 3 | gestió d'errors | webhooks |
| Fragment 4 | webhooks | — |
| Barreja de temes | cap | 1 de 3 fragments |
El quart fragment que falta ho explica tot: el chunking semàntic va fusionar dues seccions en un sol fragment, mentre que el recursiu va mantenir un tema per fragment. Observa que aquí «barreja de temes» és una etiqueta humana que l'instructor va deduir del bolcat dels fragments, no una mètrica calculada: és el primer que cal automatitzar quan adaptis aquest entorn de proves (etiqueta cada fragment amb els encapçalaments de les seccions d'on prové el seu text i després compta els fragments que n'abracen més d'una).
Després, la prova de recuperació, en l'ordre en què l'executa [02:45:05–02:47:07]:
| # | Consulta executada | Recursiu (k=1) | Semàntic (k=1) |
|---|---|---|---|
| 1 | «Com m'autentico amb OAuth 2?» | ✅ guia d'autenticació | ✅ guia d'autenticació |
| 2 | «Què passa quan arribo al límit de freqüència?» | ✅ fragment de limitació de freqüència | ❌ ha retornat el fragment d'OAuth |
| 3 | «Com es protegeixen els webhooks?» | ✅ fragment de webhooks | ❌ ha retornat el fragment barrejat |
| 4 | «En quin format es retornen els errors?» | ✅ fragment de gestió d'errors | ❌ ha retornat el mateix fragment barrejat |
| Puntuació | 4/4 | 1/4 |
Per què va perdre el semàntic
No perquè l'algoritme funcionés malament. Perquè va funcionar 02:43:02:
«Va fer exactament el que havia de fer.»
La limitació de freqüència i la gestió d'errors tracten totes dues de respostes d'API. Els embeddings de les seves frases són propers. Per tant, la dissimilitud entre frases adjacents mai no va arribar al llindar del percentil 90 al límit de secció, de manera que SemanticChunker —correctament, segons la seva pròpia definició— va optar per no tallar allà i va enganxar les dues seccions en un sol fragment. El model d'embeddings no té accés a la taxonomia del document; només veu quines frases s'assemblen.
El chunking recursiu, mentrestant, no tenia cap opinió sobre el significat. Va trobar un \n allà on l'autor havia escrit un encapçalament i va tallar en aquell punt. L'instructor ho explica amb franquesa 02:41:01:
«Els fragments es divideixen en punts arbitraris. Està bé. És millor que res.»
El fragment 2 existeix, assenyala, únicament perquè hi ha un salt de línia. És el separador estructural, i no cap comprensió semàntica, el que va produir un fragment net de limitació de freqüència. L'autor ja havia fet la segmentació temàtica —als encapçalaments— i el chunking recursiu simplement la va respectar.
Observa també l'abast dels efectes. Una fusió inadequada no va perjudicar una consulta, sinó dues: quan dos temes comparteixen un fragment, les consultes sobre qualsevol dels dos retornen el mateix bloc sorollós. Els fragments fusionats contaminen la recuperació de tots els temes que contenen.
La regla que se'n desprèn. En documents ben estructurats amb encapçalaments clars, el chunking estructural recursiu conserva límits lògics que el chunking semàntic destrueix. El chunking semàntic destaca en text continu no estructurat en què els canvis de tema no estan marcats per encapçalaments 02:47:07: reconstrueix límits que l'autor mai no va explicitar. Quan l'autor sí que els va explicitar, respectar-los és estrictament millor que tornar-los a deduir. Dit d'una altra manera: el chunking semàntic és un algoritme de reconstrucció de límits, i reconstruir només té valor quan falta l'original.
La lliçó metodològica: no jutgis mai un segmentador mirant-ne els fragments
Aquesta és la part que has d'interioritzar encara que mai no executis aquest experiment 02:44:04:
- El resum de la inspecció dels fragments indicava que el semàntic era lleugerament pitjor: 3 fragments en lloc de 4, un
amb barreja de temes. Lleugerament.
- La prova de recuperació indicava que el semàntic era catastròficament pitjor: 1/4 contra 4/4.
Examinar els fragments a ull et diu ben poca cosa. Un fragment que sembla prosa raonable encara pot ser una unitat de recuperació inadequada. Mesura la recuperació de principi a fi i informa també d'una columna de barreja de temes: convertir-la en una magnitud mesurada de primer ordre és el veritable recurs pedagògic del capítol.
L'entorn de proves A/B, reconstruït i executable
Els dos fitxers en què treballa l'instructor en pantalla —chunking/semantic_chunking.py i chunking/production_ready.py— no són presents en cap dels dos repositoris publicats. Pertanyen a un repositori «Part 3 — Optimize for Quality» que mai no es va clonar. El que segueix està reconstruït a partir de la transcripció i dels paràmetres que llegeix en veu alta; no és una còpia literal del seu fitxer. Instal·la primer: uv add langchain langchain-openai langchain-chroma chromadb langchain-experimental.
"""A/B one chunking decision: recursive vs semantic, judged on retrieval."""

from dotenv import load_dotenv
from langchain_chroma import Chroma
from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_experimental.text_splitter import SemanticChunker

load_dotenv()
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# One Markdown-shaped string, four `##` sections separated by blank lines.
# Replace the bodies with your own corpus; keep the headings.
API_DOCS = """## OAuth 2.0 Authentication
To authenticate, first obtain a client ID from the developer portal, then make
a POST request to /oauth/token with your client credentials...

## Rate Limiting
The API allows 1000 requests per hour per API key. When you exceed the limit
the API returns 429 with a Retry-After header...

## Error Handling
Always check the HTTP status code before parsing the body. Errors are returned
as JSON with `code`, `message` and `details` fields...

## Webhooks
Register a webhook endpoint to receive event notifications. Verify the
signature header on every delivery before trusting the payload...
"""

# --- Arm A: recursive -------------------------------------------------
recursive = RecursiveCharacterTextSplitter(
    chunk_size=400,
    chunk_overlap=50,
    separators=["\n\n", "\n", ",", ". "],
)
recursive_chunks = recursive.split_text(API_DOCS)

# --- Arm B: semantic --------------------------------------------------
semantic = SemanticChunker(
    embeddings,
    breakpoint_threshold_type="percentile",
    breakpoint_threshold_amount=90,
)
semantic_chunks = semantic.split_text(API_DOCS)


def print_chunks(name, chunks):
    """Diagnostic ergonomics: you cannot compare chunkers by squinting at lists."""
    print(f"\n=== {name}: {len(chunks)} chunks, "
          f"avg {sum(len(c) for c in chunks) // len(chunks)} chars ===")
    for i, c in enumerate(chunks):
        print(f"--- chunk {i} ({len(c)} chars) ---")
        print(c[:200].replace("\n", " "), "...")


print_chunks("RECURSIVE", recursive_chunks)
print_chunks("SEMANTIC", semantic_chunks)

# --- Two stores, one per arm -----------------------------------------
recursive_store = Chroma.from_texts(
    recursive_chunks, embeddings, collection_name="recursive_chunks"
)
semantic_store = Chroma.from_texts(
    semantic_chunks, embeddings, collection_name="semantic_chunks"
)


def test_retrieval(query, vectorstore, name):
    """k=1: the top hit is either right or wrong. Nowhere to hide."""
    results = vectorstore.similarity_search(query, k=1)
    print(f"\n[{name}] {query}")
    print(f"  -> {results[0].page_content[:160]!r}")


QUERIES = [
    "How do I authenticate with OAuth 2?",
    "What happens when I hit the rate limit?",
    "How are webhooks secured?",
    "What format are errors returned in?",
]

for q in QUERIES:
    test_retrieval(q, recursive_store, "recursive")
    test_retrieval(q, semantic_store, "semantic")
Quatre coses que has de conservar quan l'adaptis: dues col·leccions separades (no barregis mai les variants en un sol magatzem), k=1, una funció auxiliar print_chunks i una etiqueta de barreja de temes per fragment. I l'últim pas de la recepta, el que tothom se salta: llegeix l'estructura del document d'origen abans de concloure res; els encapçalaments en són l'explicació 02:48:09.
smart_chunker: la solució de compromís per a producció
Després de demostrar que el chunking semàntic pot fallar, el curs proporciona un embolcall que assumeix que normalment no fallarà, però que sobreviu quan ho fa [02:48:09–02:49:11]. Quatre requisits:
- Semàntic com a opció principal.
- Recursiu com a alternativa si el semàntic falla.
- Validar les mides dels fragments.
- Gestionar els errors de manera controlada: una excepció del segmentador no ha d'aturar mai una ingesta.
La signatura és smart_chunker(text, use_semantic=True), i l'indicador booleà existeix per un motiu concret: fa que el camí alternatiu sigui comprovable amb proves. Pots forçar la branca recursiva en una prova sense espatllar ni simular la branca semàntica.
# Reconstructed from the narration at [02:48:09-02:49:11]; the on-screen file
# chunking/production_ready.py is not present in either published repo.
# MIN_CHUNK / MAX_CHUNK are our values -- the course names requirement 3
# ("validate chunk sizes") without giving thresholds. Pick yours deliberately.
import logging

from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_experimental.text_splitter import SemanticChunker

logger = logging.getLogger(__name__)

MIN_CHUNK = 100
MAX_CHUNK = 2000


def smart_chunker(text: str, use_semantic: bool = True) -> list[str]:
    """Semantic chunking with a recursive fallback and size validation.

    Requirement 1: semantic primary.
    Requirement 2: recursive fallback on any failure.
    Requirement 3: validate chunk sizes.
    Requirement 4: never let a splitter exception kill the ingest.
    """

    def _recursive_fallback(t: str) -> list[str]:
        splitter = RecursiveCharacterTextSplitter(
            chunk_size=500,
            chunk_overlap=50,
            separators=["\n\n", "\n", ". ", ", ", " ", ""],
        )
        return splitter.split_text(t)

    if not use_semantic:
        return _recursive_fallback(text)

    try:
        splitter = SemanticChunker(
            OpenAIEmbeddings(model="text-embedding-3-small"),
            breakpoint_threshold_type="percentile",
            breakpoint_threshold_amount=90,
        )
        chunks = splitter.split_text(text)
    except Exception as exc:  # network, rate limit, experimental-API breakage
        logger.warning("semantic chunking failed (%s); falling back to recursive", exc)
        return _recursive_fallback(text)

    # Requirement 3: semantic chunking gives you no size guarantee at all.
    oversized = [c for c in chunks if len(c) > MAX_CHUNK]
    if oversized:
        logger.warning(
            "%d/%d semantic chunks exceed %d chars; re-splitting those",
            len(oversized), len(chunks), MAX_CHUNK,
        )
        repaired = []
        for c in chunks:
            repaired.extend(_recursive_fallback(c) if len(c) > MAX_CHUNK else [c])
        chunks = repaired

    return [c for c in chunks if len(c.strip()) >= MIN_CHUNK]
L'argument del cost es manté malgrat la demostració fallida, i convé exposar-lo amb equitat: l'afirmació de l'instructor a 02:50:15 és que amb el chunking semàntic el cost és mínim i la implementació, senzilla. Això és cert pel que fa al codi. No ho és pel que fa a la factura de la indexació d'un corpus gran, i per això existeix el requisit de mesurar abans.
Què no pot resoldre el chunking i qui ho resol
El chunking és un problema de partició: cada tros de text acaba exactament en una unitat principal, i qualsevol límit que triïs destrueix alguna cosa. Això és inevitable, i per això diverses tècniques posteriors existeixen només per recuperar el que ha costat la partició:
| Tècnica | Què recupera | On |
|---|---|---|
| Recuperació del document pare | Cerca sobre fragments petits i centrats; lliura a l'LLM el document pare gran | Part 6 |
| Compressió contextual | Elimina els trams irrellevants dels fragments recuperats massa grans | Part 6 |
| Cerca híbrida | Recupera coincidències de termes exactes que un embedding diluït del fragment havia perdut | Part 6 |
| Recuperació contextual | Afegeix context del document generat per un LLM al principi de cada fragment abans de generar-ne l'embedding | Part 14 |
| Chunking tardà | Genera primer els embeddings de tot el document perquè els vectors dels fragments incorporin context entre fragments (+10–12%) | Part 14 |
Totes aquestes tècniques són més cares que situar bé el límit des del primer moment. Recorre-hi després d'haver mesurat que un segmentador recursiu ben configurat és realment insuficient, no en lloc de configurar-lo.
Decisions que cal prendre
Repassa aquesta llista una vegada per corpus, no una vegada per projecte.
- Quin és el meu tipus de contingut, realment? Prosa, Markdown, codi, PDF amb taules o una barreja. Si és
una barreja, on es troba el distribuïdor que n'encamina el tractament?
- Quina estratègia em dona l'arbre de decisió? Prototip ràpid o documents estructurats →
recursiu. Qualitat crítica o canvis de tema no marcats → semàntic. El fix no és mai una resposta.
- Quina mida de fragment, i en quina unitat? Comença amb 500 caràcters; comprova que tingui sentit respecte de
l'interval òptim de 200–1,000 tokens; decideix si estableixes el pressupost en caràcters o en tokens i sigues coherent, perquè la factura és en tokens.
- Quin solapament? 10% (
chunk_overlap=50amb 500) com a valor predeterminat distribuït, 20%
(size // 5) si et pots permetre la duplicació. Mai zero.
- La meva escala de separadors acaba en
""? Sense aquest últim esglaó, una seqüència indivisible s'emet
amb una mida excessiva i només queda registrada als logs. Estàs recollint els avisos de LangChain?
- Estic fent servir
split_documents()? Si algun camí del codi cridasplit_text()sobre documents reals del
corpus, les citacions ja s'han perdut. Comprova-ho mostrant split_docs[0].metadata i split_docs[-1].metadata.
- Quines metadades ha de portar cada fragment? Com a mínim,
source; la ruta d'encapçalaments per a Markdown;
page/page_label per als PDF. Decideix-ho ara: la possibilitat de filtrar queda fixada en el moment de la indexació.
- Si és Markdown: hi ha una segona passada que imposi la mida?
MarkdownHeaderTextSplittertot sol
no limita la mida dels fragments.
- Si és codi: estic fent servir
from_language()? Aplicar un segmentador genèric al codi font és un defecte. - Com mesuraré la qualitat de la recuperació? Defineix l'entorn de proves abans de definir l'estratègia. Dues
col·leccions, les mateixes consultes, k=1 i una etiqueta de barreja de temes.
- He executat realment la prova A/B sobre el meu corpus? El resultat publicat és 4/4 contra 1/4 sobre
un document estructurat amb encapçalaments. El teu serà diferent. L'entorn de proves es transfereix; la xifra, no.
- Si és semàntic: quin és el camí de fallada? Una alternativa a l'estil de
smart_chunker, validació de mides
i una línia de log prou visible perquè es detecti una ingesta parcialment degradada.
- Tinc un pla per tornar a indexar? Canviar la mida dels fragments, el solapament o l'estratègia invalida tots els
vectors que tens emmagatzemats. Pressuposta la regeneració dels embeddings abans d'ajustar els paràmetres, no després.
Llista de comprovació abans de passar a la part 4
- El chunking de mida fixa no apareix enlloc del meu camí d'ingesta.
RecursiveCharacterTextSplitterés la meva opció predeterminada, amb una escala de separadors explícita si vull els esglaons de frase i clàusula, i aquesta escala acaba en"".chunk_overlapés el 10–20% dechunk_size, mai 0.- Totes les crides al segmentador dins del pipeline són
split_documents([...]), nosplit_text(). - Les metadades dels fragments inclouen
sourcei tot allò que pretenc citar o fer servir per filtrar. - El codi passa per
from_language(); el Markdown passa perMarkdownHeaderTextSplittermés una segona passada que imposa la mida. - Tinc un entorn de proves de recuperació amb dues col·leccions i
k=1que puc tornar a executar quan vulgui. - Tinc una xifra de qualitat de recuperació per al recursiu abans de gastar res en el semàntic.
- Si el semàntic està activat, hi ha una alternativa recursiva, validació de mides i un avís als logs.
- La configuració del segmentador es troba en un únic punt del codi, perquè la canviaré i tornaré a indexar.
Enduu-te aquesta frase a la part 4: el model d'embeddings codificarà fidelment tot allò que li lliuris i mai no et dirà que el que li has lliurat era mitja idea.