
RAG amb agents: recuperació amb autocorrecció amb LangGraph
Recuperació que es corregeix: avalua, reformula i reintenta amb una màquina d'estats de LangGraph.
Tots els pipelines que has construït fins ara en aquesta guia són una línia recta. Els documents entren per un extrem, una resposta surt per l'altre i la línia s'executa exactament una vegada per pregunta. La part 3 ha millorat allò que entra a l'índex. La part 6 ha millorat allò que surt del recuperador. La part 14 ha millorat què significa cada fragment abans de generar-ne l'embedding. Tot això continua sent d'un sol intent: tens una recuperació, i allò que et dona és amb el que ha de treballar el generador.
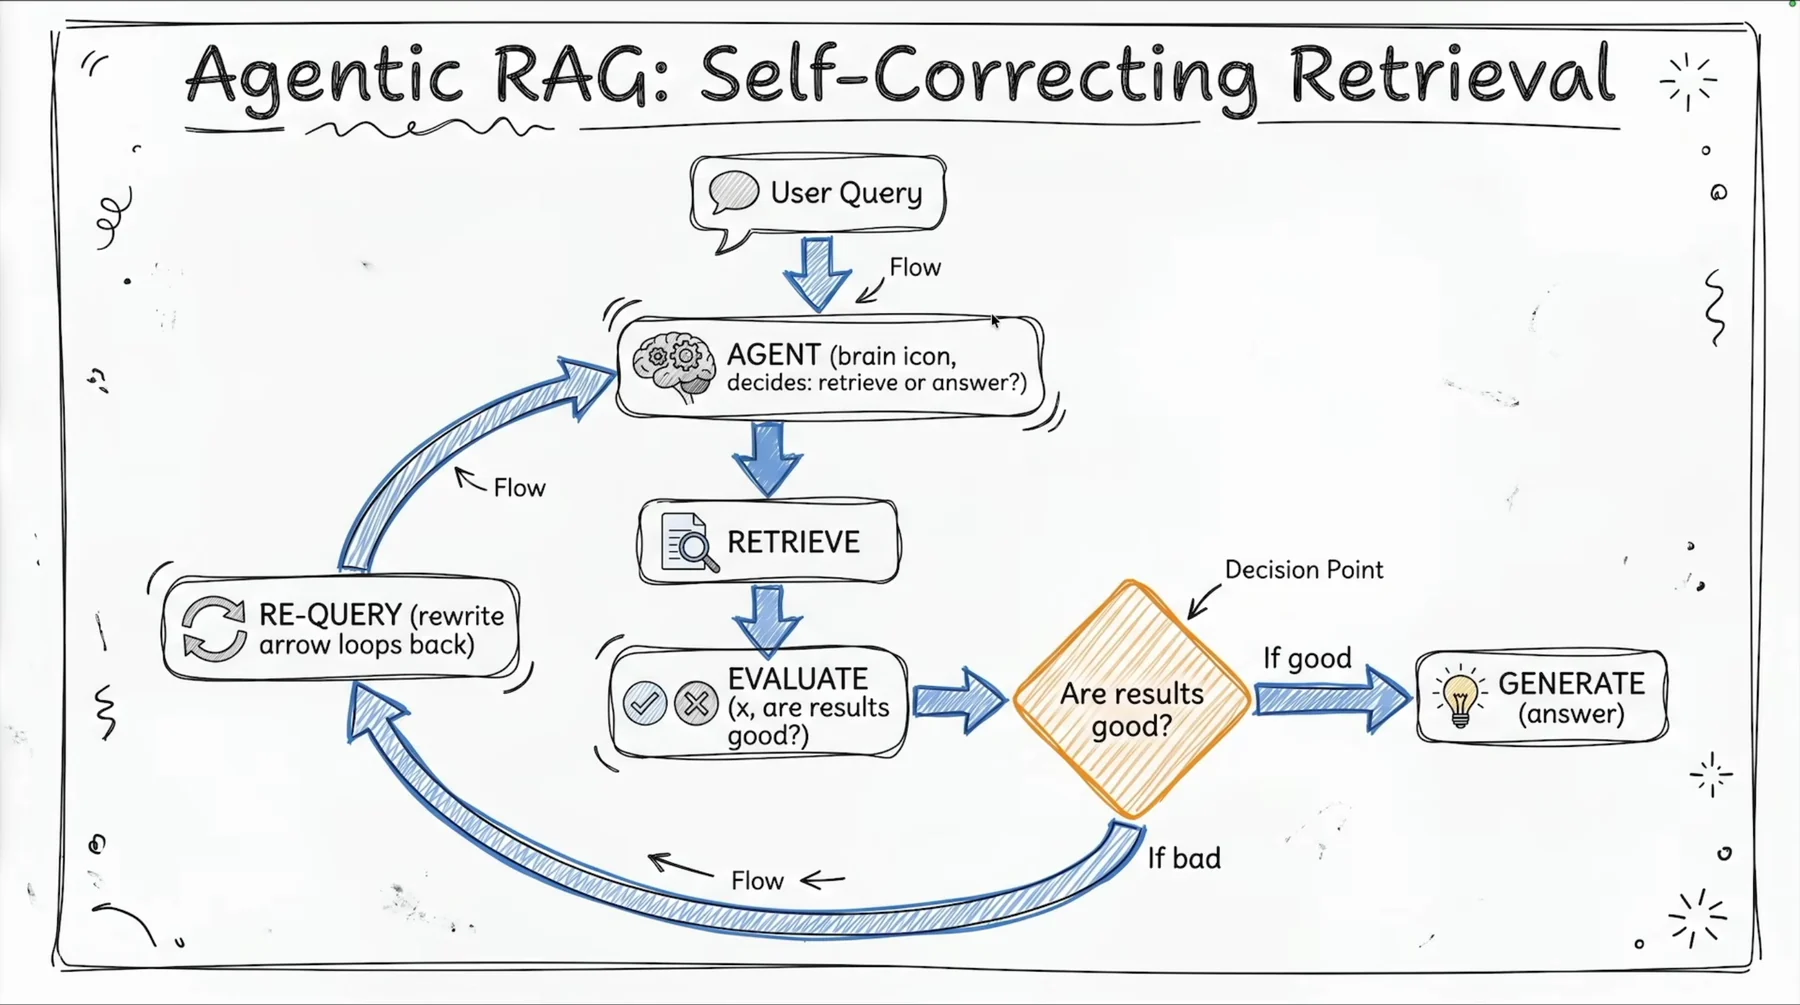
Aquesta part canvia una altra cosa. Canvia el flux de control de la fase B. En lloc de retrieve → generate, tens retrieve → grade → {generate | rewrite → retrieve | give up} — un graf amb un cicle, on el sistema llegeix els seus propis resultats de recuperació, decideix que no són prou bons i ho torna a provar amb una consulta millor.
Aquesta és tota la idea, i ataca directament la invariant 4 del model mental: les fallades són silencioses. El RAG d'un sol intent no pot dir-te que ha fallat, perquè res no mira mai la sortida de recuperació i pregunta «això tracta realment de la pregunta?». El RAG amb agents insereix exactament aquesta pregunta al pipeline i dona al sistema un lloc on anar quan la resposta és no.
També és la cosa més cara d'aquesta guia per consulta, i el capítol que l'ensenya no posa mai una xifra a la factura. Aquesta part sí.
El problema: un resultat no és el mateix que un bon resultat
El formador presenta el RAG tradicional a 06:39:44 — consultar, recuperar, passar a l'LLM — amb una frase que val la pena rumiar:
«Després d'això tens un resultat: sigui bo o no, és un resultat.»
Aquesta és tota l'acusació. Un pipeline RAG d'un sol intent no té noció d'èxit. Si el recuperador retorna tres documents sobre l'historial de versions de Python quan l'usuari ha preguntat com fer pizza, el pipeline no se n'adona. Formata els tres documents en un bloc de context, els dona al model amb una instrucció educada i produeix prosa. Segons com d'estricte sigui el prompt, obtens una al·lucinació o un rebuig confús — i en tots dos casos la taxa d'error és del 0%, perquè res no ha llançat cap excepció.
És el mateix problema que la part 1 anomenava quan separava fluïdesa de correcció, ara amb un mecanisme concret. El pipeline no està avariat; està sense supervisió. No hi ha cap etapa encarregada de jutjar l'anterior.
L'aportació de RAG amb agents és una paraula inserida al pipeline: avaluar. Tota la resta — el graf, l'objecte d'estat, el pressupost de reintents — és la infraestructura necessària per actuar segons el que diu l'avaluació.
La definició de comportament de la recuperació amb autocorrecció, en paraules del formador a 06:43:05:
«D'acord, això no ha funcionat. Tornem enrere i remenem fins a arribar al resultat correcte.»
La versió formal, a 07:01:26: el sistema puntua el que ha retornat el recuperador i comprova si és «realment congruent amb la consulta que ha arribat» — i, si no, incrementa el comptador de reintents i reescriu.
El contrast en una línia del formador, a 06:43:05:
«RAG tradicional: consultar, recuperar i generar — un sol intent. Amb RAG amb agents… avaluem i decidim si cal tornar a recuperar.»
Què significa realment «amb agents» aquí
Abans del graf, el vocabulari. El curs defineix un agent a 06:39:44 com una cosa «més intel·ligent que només un gran model de llenguatge» — que fa servir un LLM com a base, però pot cridar eines i, sobretot, prendre decisions.
D'aquesta definició se'n desprenen quatre patrons, i el capítol els anomena tots quatre:
| # | Patró | Què vol dir | És al codi d'aquest capítol? |
|---|---|---|---|
| 1 | Encaminament | «Si això és bo, ves per aquí. Si no, torna per aquí.» 06:40:44 | Sí — l'aresta condicional |
| 2 | Autocorrecció | Detectar resultats dolents, reescriure la consulta, reintentar 06:41:44 | Sí — el cicle rewrite → retrieve |
| 3 | Diversos passos | Dividir una consulta complexa en subconsultes 06:41:44 | No — afirmat, mai implementat |
| 4 | Ús d'eines | Cridar eines i decidir quan 06:42:04 | No — un únic recuperador connectat de manera fixa |
El patró 4 és on el formador posa l'èmfasi, i l'èmfasi recau a la segona meitat:
06:42:04 *«Els agents també poden cridar eines i decidir quan cridar-les.»*
Decidir quan és la part fonamental. Una cadena que sempre crida la mateixa eina en el mateix ordre no és un agent; és una cadena amb sintaxi addicional. Sigues honest amb tu mateix sobre quina de les dues coses has construït.
L'extensió natural que el capítol descriu però no programa (06:42:04) són diverses eines de recuperació, cadascuna amb una estratègia diferent — cerca vectorial densa, BM25, híbrida, pare-fill, una col·lecció completament diferent. Quan l'eina 1 retorna resultats subòptims, l'agent ve a dir «d'acord, no funciones bé perquè els resultats són subòptims» i passa a l'eina 2. És l'equivalent de la reescriptura de consultes a escala d'estratègia:
Reescriu la consulta o canvia el recuperador. Aquestes són les dues palanques d'un bucle de recuperació amb autocorrecció. La lliçó només implementa la primera; els recuperadors de la segona ja són a la teva caixa d'eines des de la part 6.
Per què LangGraph — el motiu tècnic, no el comercial
A 06:43:05, LangGraph es presenta com la part de LangChain «que permet crear fàcilment agents d'IA» i, de manera més útil, que «permet construir fàcilment aquests bucles de decisió».
El motiu real és més concret i val la pena formular-lo amb precisió, perquè és l'únic que obliga a introduir un marc nou a la pila:
Les cadenes LCEL són acícliques.
prompt | llm | parserés una canonada dirigida; no hi ha manera d'expressar-hi «torna al pas 2». Un bucle de reintents és un cicle.StateGraphés el que afegeix cicles.
Tota la resta que LangGraph et dona aquí — nodes, arestes, un objecte d'estat tipat — la podries aproximar amb un bucle while i un diccionari. El que no podries aproximar fàcilment és la maquinària que l'envolta i que obtens de franc quan el flux de control és un objecte graf: punts de control, transmissió progressiva per node, interrupcions amb intervenció humana i traçat per node. Res d'això no s'utilitza en aquesta lliçó, però explica per què construeixes el bucle com un graf en lloc d'un while.
La documentació interna del fitxer és taxativa: «LangGraph 1.x és l'estàndard de producció per construir aquests fluxos de treball.» Pren «estàndard de producció» com l'opinió del formador a l'abril de 2026, no com un fet — ell mateix en remarca la data a 07:02:28: «aquest és el patró de producció que heu de fer servir el 2026 i en endavant. Les coses poden canviar més endavant».
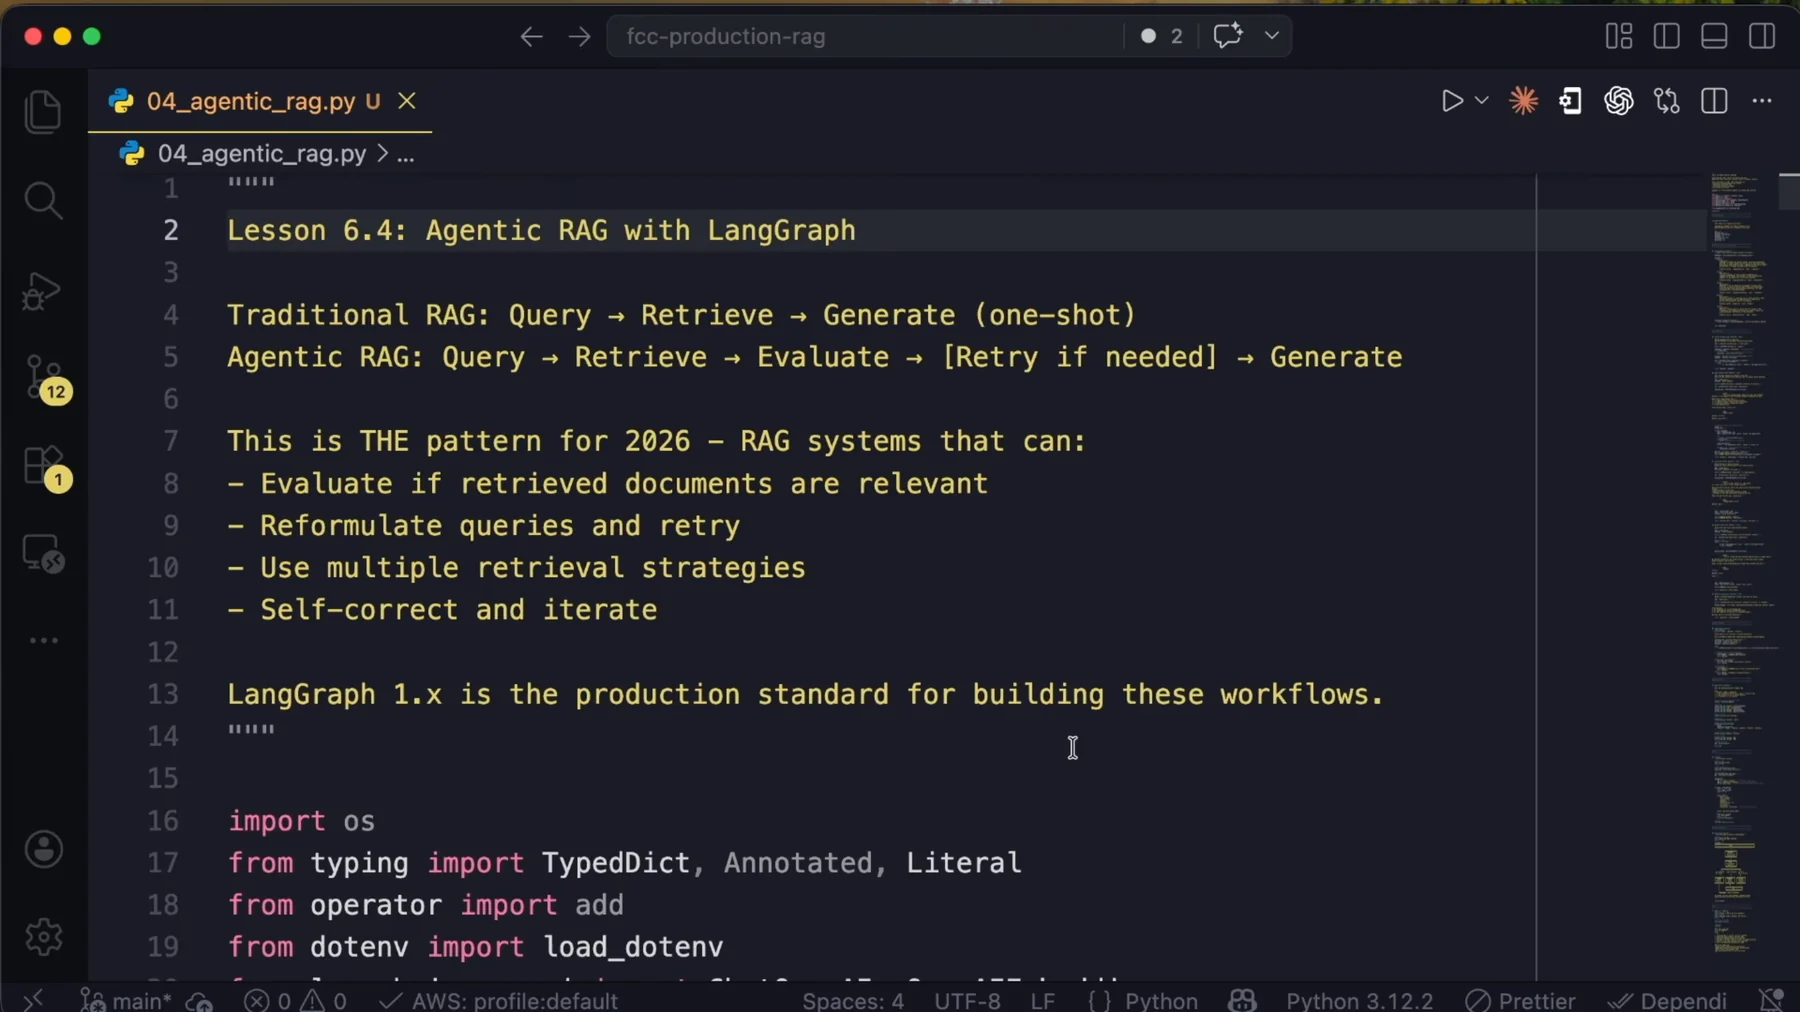
04_agentic_rag.py («Lliçó 6.4: RAG amb agents amb LangGraph»), Python 3.12.2 a l'execució enregistrada. Els quatre punts són el contracte del capítol: avaluar la rellevància, reformular i reintentar, fer servir diverses estratègies de recuperació, autocorregir-se i iterar. El codi distribuït compleix el primer, el segon i el quart; «diverses estratègies de recuperació» és una aspiració.Entorn, importacions i versions fixades — amb una contradicció que val la pena conèixer
El fitxer és 04_agentic_rag.py al repositori de la part 6 del curs (fcc-production-rag en pantalla, descarregat localment com a fcc-production-rag-part-6). El seu requirements.txt porta la capçalera «Part 6: RAG avançat - Dependències (abril de 2026)»; les versions fixades que importen aquí:
langchain>=1.2.0,<2.0.0
langchain-core>=1.3.0,<2.0.0
langchain-openai>=1.1.0,<2.0.0
langchain-chroma>=1.1.0,<2.0.0
chromadb>=1.5.0,<2.0.0
langgraph>=1.1.0,<2.0.0
langchain-classic>=1.0.0
El bloc d'importacions del fitxer de la lliçó, literal — fixa't en les línies 21–22:
import os
from typing import TypedDict, Annotated, Literal
from operator import add
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_chroma import Chroma
from langchain_chroma import Chroma
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.documents import Document

from langgraph.graph import StateGraph, END

load_dotenv()
os, Annotated i add s'importen i no es fan servir mai, i Chroma s'importa dues vegades. També cal observar que aquest fitxer pren TypedDict de typing, mentre que tots els fitxers de LangGraph del repositori germà (langgraph_core.py, conditional_edges.py, cycles_loops.py) el prenen de typing_extensions. Dos repositoris del mateix curs, dues convencions; tria'n una deliberadament.
La font es contradiu sobre la versió de Python. pyproject.toml exigeix Python >= 3.13, .python-version diu 3.13 i la barra d'estat de VS Code a l'execució enregistrada diu Python 3.12.2. L'enregistrament és anterior a l'increment de la versió fixada. Confia en la versió fixada, no en el vídeo. (La línia «requereix Python 3.10 o superior» que veuràs al corpus de demostració és text de document d'exemple escrit perquè el puntuï l'avaluador, no una versió fixada del repositori — no la interpretis així.)
Parany dels subtítols. Els subtítols automàtics d'aquest capítol transcriuen agentic_rag_demo com «a gent demo», ChatOpenAI com «shadow openi», StateGraph com «site graph» i «grader» com «greater». Comprova sempre el codi abans de citar un identificador d'aquest curs.
L'objecte d'estat és la memòria de l'agent
Tot en un flux de LangGraph passa per un únic diccionari compartit. Els nodes no es criden entre si ni es passen arguments; cada node llegeix l'estat i retorna un diccionari parcial que LangGraph fusiona de nou amb l'estat.
06:44:06 «Pensa en l'estat com en la memòria» — «una memòria persistent on tots aquests nodes… podran escriure i llegir».
Més endavant, a 06:47:09, torna a la mateixa idea: l'estat és «la font de referència on totes les peces són congruents». No és decoració — explica per què l'encaminador del final del graf no necessita arguments. Tot el que ha de saber ja ho han escrit a l'estat els nodes executats abans.
L'esquema és un simple TypedDict, i el fitxer explica per què:
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 35-49)
class RAGState(TypedDict):
    """
    State schema for our agentic RAG workflow.

    LangGraph uses TypedDict for state (not Pydantic in 1.x).
    The Annotated[list, add] tells LangGraph to merge lists.
    """

    query: str
    rewritten_query: str
    documents: list[Document]
    generation: str
    relevance_score: float
    retry_count: int
    max_retries: int
Set camps, cadascun amb una feina diferent:
| Camp | Qui l'escriu | Qui el llegeix | Per què existeix |
|---|---|---|---|
query | qui fa la crida (mai no se sobreescriu) | grade, rewrite, generate, fallback | La intenció real de l'usuari, conservada a través de tots els reintents |
rewritten_query | rewrite | retrieve | El que realment fa servir la recuperació un cop hi ha hagut una reescriptura |
documents | retrieve, després sobreescrit per grade | grade, encaminador, generate | El conjunt de treball; reduït als supervivents després de puntuar-lo |
generation | generate o fallback | qui fa la crida | La resposta, real o de fallada honesta |
relevance_score | grade | encaminador | Mitjana de les puntuacions per document |
retry_count | rewrite (incrementa) | encaminador, fallback | Quantes voltes hem fet |
max_retries | qui fa la crida | encaminador | El límit que el manté lligat |
Els dos últims són els que més importen en producció, i el capítol hi insisteix:
Semàntica de fusió, i el reductor que el fitxer documenta però no fa servir mai
Un node retorna {"documents": [...]} i LangGraph fusiona aquesta clau amb l'estat, deixant intactes les altres sis. Per defecte, la fusió és una substitució. Si vols que un camp s'acumuli entre iteracions del bucle — una traça d'auditoria de cada intent, per exemple —, l'anotes amb una funció reductora. A això es refereix Annotated[list, add] de la documentació interna. El fitxer de la lliçó importa tant Annotated com add i després no fa servir cap dels dos; cap camp de RAGState no porta reductor, de manera que cada escriptura és una substitució.
L'exemple funcional és al repositori germà:
# production-course-main-code/langgraph_core.py  (lines 64-67)
class AccumulatingState(TypedDict):
    messages: Annotated[list[str], operator.add]  # lists concatenate when merged
    count: Annotated[int, operator.add]  # counts sum when merged
I al generador de codi amb autocorrecció es fa servir el mateix patró exactament per a la finalitat que hauria de copiar un bucle RAG amb agents — conservar tots els errors de tots els intents:
# production-course-main-code/cycles_loops.py  (lines 19-26)
class CodeGenState(TypedDict):
    task: str
    code: str
    errors: Annotated[list[str], operator.add]
    iteration: int
    max_iterations: int
    success: bool
Els cinc nodes
Tots els nodes tenen la mateixa signatura: f(state: RAGState) -> dict, i cadascun retorna només els camps que ha canviat. Dos dels cinc (retrieve, fallback) no fan cap crida a l'LLM; els altres tres construeixen cadascun el seu client ChatOpenAI dins del node — còmode per a una lliçó, un malbaratament en un servidor, on els traslladaries a escala de mòdul o els injectaries.
| Node | Crides a l'LLM | Llegeix de l'estat | Escriu a l'estat |
|---|---|---|---|
retrieve | 0 (1 embedding) | rewritten_query, query | documents |
grade | una per document | query, documents | documents (filtrats), relevance_score |
rewrite | 1 | query, retry_count | rewritten_query, retry_count |
generate | 1 | query, documents | generation |
fallback | 0 | query, retry_count | generation |
1. retrieve — l'únic node que toca el magatzem vectorial
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 119-142)
def retrieve_documents(state: RAGState) -> dict:
    """
    Retrieve documents based on the query.
    Uses rewritten_query if available, otherwise original query.
    """
    query = state.get("rewritten_query") or state["query"]

    print(f"\n[RETRIEVE] Searching for: '{query}'")

    vectorstore = state.get("_vectorstore")  # Injected at runtime
    if not vectorstore:
        # Fallback - create new (in production, pass via config)
        vectorstore = create_sample_vectorstore()

    retriever = vectorstore.as_retriever(search_kwargs={"k": 3})
    documents = retriever.invoke(query)

    print(f"[RETRIEVE] Found {len(documents)} documents")
    for i, doc in enumerate(documents, 1):
        print(
            f"  {i}. {doc.metadata.get('source', 'unknown')}: {doc.page_content[:50]}..."
        )

    return {"documents": documents}
Tres coses que cal observar.
La primera línia és tot el mecanisme del bucle. state.get("rewritten_query") or state["query"] vol dir: fes servir la reescriptura si existeix; altrament, l'original. A la primera passada, rewritten_query és "" (avaluat com a fals), de manera que es fa servir la consulta original. Després d'una reescriptura, la recuperació passa silenciosament a la formulació nova. Una expressió, i el node funciona igual a l'intent 0 que al 3.
k=3 està fixat al codi i és el multiplicador de cost. L'avaluador farà una crida a l'LLM per cada document retornat aquí. k ja no és només un paràmetre de recuperació; és un multiplicador directe de la factura d'avaluació.
El registre no és decoratiu. Imprimir metadata["source"] més els primers 50 caràcters de cada coincidència, a cada intent, és el que permet depurar el bucle — i és el mateix hàbit que la part 4 t'ha dit d'adoptar. En producció, substitueix print pel logger JSON estructurat de la part 7, amb un identificador de petició com a clau, perquè puguis reconstruir una execució de cinc nodes i tres intents només a partir dels registres.
2. grade — el node que el converteix en un sistema amb agents
Aquesta és l'etapa nova. El comentari del mateix fitxer ho diu: «Aquesta és la diferència CLAU respecte del RAG tradicional: avaluem abans de generar.»
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 145-206)
def grade_documents(state: RAGState) -> dict:
    """
    Grade retrieved documents for relevance to the query.
    This is the KEY difference from traditional RAG - we evaluate before generating.
    """
    query = state["query"]
    documents = state["documents"]

    print(f"\n[GRADE] Evaluating {len(documents)} documents for relevance...")

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    grading_prompt = ChatPromptTemplate.from_messages(
        [
            (
                "system",
                """You are a relevance grader. Given a user query and a document,
determine if the document contains information relevant to answering the query.

Output ONLY a number between 0 and 1:
- 1.0 = Highly relevant, directly answers the query
- 0.7 = Somewhat relevant, contains related information
- 0.3 = Marginally relevant, tangentially related
- 0.0 = Not relevant at all

Output ONLY the number, nothing else.""",
            ),
            (
                "human",
                """Query: {query}

Document: {document}

Relevance score (0-1):""",
            ),
        ]
    )

    # Grade each document and calculate average
    scores = []
    relevant_docs = []

    for doc in documents:
        chain = grading_prompt | llm
        result = chain.invoke({"query": query, "document": doc.page_content})

        try:
            score = float(result.content.strip())
        except ValueError:
            score = 0.5  # Default if parsing fails

        scores.append(score)
        print(f"  - {doc.metadata.get('source', 'unknown')}: {score:.2f}")

        if score >= 0.5:  # Keep documents with score >= 0.5
            relevant_docs.append(doc)

    avg_score = sum(scores) / len(scores) if scores else 0
    print(f"[GRADE] Average relevance: {avg_score:.2f}")
    print(f"[GRADE] Keeping {len(relevant_docs)}/{len(documents)} documents")

    return {"documents": relevant_docs, "relevance_score": avg_score}
06:47:09 «Puntuar és simplement donar instruccions al nostre gran model de llenguatge perquè es converteixi en un avaluador.»
Aquesta és la desmitificació que val la pena retenir. No hi ha classificador, ni fine-tuning, ni model cross-encoder. És un prompt de sistema amb una rúbrica de quatre punts — 1.0 / 0.7 / 0.3 / 0.0 —, una instrucció per emetre només un número i un float() sobre el resultat. temperature=0, perquè un avaluador que dona respostes diferents a la mateixa parella no és un avaluador.
Una puntuació, dues feines diferents. El float retornat s'utilitza dues vegades amb el mateix llindar 0.5, però amb semàntiques completament diferents, i confondre-les és un error habitual:
- Filtratge (per document):
if score >= 0.5: relevant_docs.append(doc). El context a partir del qual
acabes generant només conté els supervivents. És un filtre de precisió — la manera de fallar #3 de la part 6, el soroll de recuperació, resolt en temps de consulta en lloc d'indexació.
- Encaminament (agregat):
avg_scorede tots els documents es converteix enrelevance_score, i l'
encaminador compara aquest valor amb 0.5. És un senyal de salut de l'intent de recuperació en conjunt.
El formador narra el filtre en directe a 06:56:20: «aquests dos són molt alts, aquest és zero; per tant, no me'ls quedaré tots tres».
3. rewrite — «el cervell»
06:47:09 «Aquest és el cervell… d'acord, alguna cosa no va bé. Tornem enrere i reescrivim.»
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 209-252)
def rewrite_query(state: RAGState) -> dict:
    """
    Rewrite the query to improve retrieval.
    Called when initial retrieval doesn't find relevant documents.
    """
    query = state["query"]
    retry_count = state.get("retry_count", 0)

    print(f"\n[REWRITE] Attempt {retry_count + 1}: Improving query...")

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.3)

    rewrite_prompt = ChatPromptTemplate.from_messages(
        [
            (
                "system",
                """You are a query rewriter for a RAG system.
The original query didn't retrieve relevant documents.

Rewrite the query to be more specific and likely to match relevant documents.
Consider:
- Adding synonyms or related terms
- Being more specific about what information is needed
- Rephrasing to match how documentation is typically written

Output ONLY the rewritten query, nothing else.""",
            ),
            (
                "human",
                """Original query: {query}

Rewritten query:""",
            ),
        ]
    )

    chain = rewrite_prompt | llm
    result = chain.invoke({"query": query})
    rewritten = result.content.strip()

    print(f"[REWRITE] Original: '{query}'")
    print(f"[REWRITE] Rewritten: '{rewritten}'")

    return {"rewritten_query": rewritten, "retry_count": retry_count + 1}
temperature=0.3 — l'única temperatura no nul·la de tot el fitxer. L'avaluació i la generació són deterministes; la reescriptura deliberadament no ho és, perquè una reescriptura idèntica cada vegada és un reintent que no pot trobar res de nou.
La rúbrica té tres clàusules, i la tercera és la interessant: «Reformular perquè coincideixi amb la manera com s'escriu habitualment la documentació.» És un atac directe i deliberat a la fallada de desajust d'embeddings — la manera de fallar #2 de la part 1, analitzada a la part 5: l'usuari escriu «com ho cancel·lo», el document diu «política de rescissió» i els vectors no es troben mai. Reescriure és un intent de traduir del llenguatge de les preguntes al dels documents.
Aquest node també controla la condició de terminació: retry_count + 1. Si oblides aquest increment, el graf entra en un bucle infinit — fins que el límit de recursió de LangGraph avorta l'execució amb un error que hauràs d'entendre llegint-ne la traça.
4. generate — generació RAG ordinària al final d'un bucle
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 255-302, prints elided)
def generate_answer(state: RAGState) -> dict:
    """
    Generate the final answer using retrieved documents.
    """
    query = state["query"]
    documents = state["documents"]

    llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

    # Format documents
    context = "\n\n".join(
        [
            f"Source: {doc.metadata.get('source', 'unknown')}\n{doc.page_content}"
            for doc in documents
        ]
    )

    generate_prompt = ChatPromptTemplate.from_messages(
        [
            (
                "system",
                """You are a helpful assistant answering questions based on provided context.

Use ONLY the information in the context to answer. If the context doesn't contain
enough information, say so clearly.

Always cite your sources by mentioning which document the information came from.""",
            ),
            (
                "human",
                """Context:
{context}

Question: {query}

Answer:""",
            ),
        ]
    )

    chain = generate_prompt | llm
    result = chain.invoke({"context": context, "query": query})

    return {"generation": result.content}
Aquí no hi ha res d'agents — és el patró de prompt contra al·lucinacions de la part 1 fent la seva feina al final d'un pipeline més llarg. Hi ha dos detalls fonamentals:
- S'anteposa
Source: <source>a cada bloc de context. Només és possible citar si
els noms de les fonts són físicament dins del text que llegeix el model. Les fonts viatgen dins de la cadena de context, mai per un canal separat — la mateixa regla de la part 1.
- «Fes servir NOMÉS la informació del context» + «Cita sempre les fonts.» La clàusula de
restricció i la instrucció de citació. A l'execució enregistrada funcionen: la resposta final de la consulta 1 acaba amb (source: langgraph_install.md).
Fixa't que aquest node genera a partir de state["documents"] — que l'avaluador ja ha substituït pels supervivents filtrats. generate no veu mai els documents rebutjats.
5. fallback — fallada deliberada i controlada
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 305-322)
def generate_fallback(state: RAGState) -> dict:
    """
    Generate a fallback response when retrieval fails after all retries.
    """
    query = state["query"]

    print(f"\n[FALLBACK] Retrieval failed after {state.get('retry_count', 0)} attempts")

    fallback_message = f"""I couldn't find relevant information to answer your question: "{query}"

This could mean:
1. The information isn't in my knowledge base
2. Try rephrasing your question with different terms
3. The topic might not be covered in the available documents

Would you like to try a different question?"""

    return {"generation": fallback_message}
06:55:20 «Estem fallant de manera controlada. Això és molt important.»
La propietat més important d'aquest node: no és una crida a l'LLM. És una f-string. Això vol dir que no costa res, no afegeix latència i — críticament — no pot al·lucinar. L'únic camí on has establert definitivament que no tens fonamentació en les fonts és l'últim lloc on vols un model de llenguatge improvisant.
També fa dues coses bé com a experiència d'usuari: diu per què (no és a la base de coneixement) i què fer (reformular). Compara-ho amb l'alternativa que hauria produït la demostració de pizza — una resposta sobre pizza sintetitzada a partir de tres documents sobre Guido van Rossum.
L'encaminador: la cruïlla
06:49:13 «Ah, aquesta és la cruïlla.»
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 330-363)
def should_retry_or_generate(
    state: RAGState,
) -> Literal["rewrite", "generate", "fallback"]:
    """
    Decide whether to retry retrieval or proceed to generation.

    This is the BRAIN of agentic RAG - making decisions based on retrieval quality.
    """
    relevance_score = state.get("relevance_score", 0)
    retry_count = state.get("retry_count", 0)
    max_retries = state.get("max_retries", 2)
    documents = state.get("documents", [])

    print(
        f"\n[ROUTER] Evaluating: score={relevance_score:.2f}, retries={retry_count}/{max_retries}, docs={len(documents)}"
    )

    # If we have relevant documents, generate
    if relevance_score >= 0.5 and len(documents) > 0:
        print("[ROUTER] -> GENERATE (good relevance)")
        return "generate"

    # If we can retry, rewrite query
    if retry_count < max_retries:
        print("[ROUTER] -> REWRITE (low relevance, retrying)")
        return "rewrite"

    # Out of retries
    if len(documents) > 0:
        print("[ROUTER] -> GENERATE (out of retries, using available docs)")
        return "generate"
    else:
        print("[ROUTER] -> FALLBACK (no relevant documents)")
        return "fallback"
Les quatre branques, en ordre de prioritat:
| # | Condició | Destí | Raonament |
|---|---|---|---|
| 1 | relevance_score >= 0.5 i len(documents) > 0 | generate | Bona recuperació — respon |
| 2 | retry_count < max_retries | rewrite | Mala recuperació, encara queda pressupost — prova una consulta millor |
| 3 | len(documents) > 0 | generate | Pressupost esgotat, però alguna cosa ha superat el filtre |
| 4 | altrament | fallback | Pressupost esgotat sense res — digues-ho honestament |
La branca 3 és la subtil, i el formador l'assenyala a 06:50:13: «sense reintents, anem directament a generar perquè no podem reintentar més».
Degrada abans de desistir. Una resposta mediocre a partir de documents mediocres però supervivents és millor que cap resposta — però només després d'esgotar el pressupost de reintents, mai abans. La branca 3 té menys prioritat que la 2 exactament per aquest motiu.
Dues observacions que el capítol no fa explícitament però que importen enormement en producció:
L'encaminador és Python pur, no un LLM. El capítol continua anomenant-lo «el cervell», i el comentari del codi diu «Aquest és el CERVELL del RAG amb agents.» Però el judici viu a grade (un LLM); la decisió és lògica if determinista sobre l'estat. Aquesta separació és precisament el que fa el bucle depurable, comprovable i acotat. Pots fer proves unitàries de should_retry_or_generate amb un diccionari i sense clau d'API. Mantén-ho així — tan bon punt un model decideix el flux de control, el flux esdevé irreproduïble.
Tot el que necessita l'encaminador ja és a l'estat. 06:50:13 «tot això s'ha desat en aquest cervell que queda aquí i on tots aquests nodes poden… accedir directament». L'encaminador no pren cap argument més enllà de l'estat ni crida res. Aquest és el benefici del disseny d'estat com a memòria.
Connectar el graf
Els nodes existeixen aïllats fins que els connectes. 06:51:14 «Un cop tenim aquests nodes, encara no estan connectats. Els hem de connectar.»
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 371-415)
def build_agentic_rag_graph():
    """
    Build the LangGraph workflow for agentic RAG.

    Flow:
    1. retrieve -> grade -> [decision]
    2. If low relevance and retries left: rewrite -> retrieve (loop)
    3. If good relevance or out of retries: generate
    4. If no documents at all: fallback
    """

    # Create the graph with our state schema
    workflow = StateGraph(RAGState)

    # Add nodes
    workflow.add_node("retrieve", retrieve_documents)
    workflow.add_node("grade", grade_documents)
    workflow.add_node("rewrite", rewrite_query)
    workflow.add_node("generate", generate_answer)
    workflow.add_node("fallback", generate_fallback)

    # Set entry point
    workflow.set_entry_point("retrieve")

    # Add edges
    workflow.add_edge("retrieve", "grade")

    # Conditional edge from grade
    workflow.add_conditional_edges(
        "grade",
        should_retry_or_generate,
        {"rewrite": "rewrite", "generate": "generate", "fallback": "fallback"},
    )

    # After rewrite, go back to retrieve
    workflow.add_edge("rewrite", "retrieve")

    # Terminal nodes
    workflow.add_edge("generate", END)
    workflow.add_edge("fallback", END)

    # Compile the graph
    app = workflow.compile()

    return app
Els onze passos, com a procediment que pots traslladar a qualsevol graf amb autocorrecció:
- Defineix l'esquema d'estat com un
TypedDictamb tots els camps que qualsevol node llegirà o escriurà. - Escriu cada node com a
f(state) -> dict, retornant només el que ha canviat. - Escriu l'encaminador com una funció simple que retorni un
Literal[...]de claus de destí. workflow = StateGraph(RAGState)— passa la classe, no una instància.add_node(name, fn)per a cada node. Encara no hi ha res connectat.set_entry_point("retrieve")— el graf no té cap inici per defecte.add_edge("retrieve", "grade")— un salt incondicional.add_conditional_edges(source, router_fn, {returned_string: destination_node}).add_edge("rewrite", "retrieve")— aquesta única línia crea el cicle.add_edge("generate", END)iadd_edge("fallback", END).app = workflow.compile(), desprésapp.invoke(initial_state).
El pas 9 és tota la lliçó comprimida en una línia:
El cicle és una aresta ordinària. No hi ha cap construcció especial de «bucle».
add_edge("rewrite", "retrieve")converteix un DAG en un graf amb un cicle, i tota la resta — l'estat, els comptadors, l'encaminador — és la comptabilitat necessària perquè el cicle acabi.
compile() retorna un Runnable amb la mateixa interfície que qualsevol cadena LCEL, cosa que significa que el graf compilat s'integra a la resta de la pila (gestor FastAPI, embolcall de reintents, callbacks de traçat) sense tractament especial.
El graf ASCII que imprimeix l'script (línies 485-525) — val la pena conservar-lo als teus grafs
ASCII original
    ┌─────────────────────────────────────────────────────────────┐
    │                      START                                  │
    └─────────────────────────┬───────────────────────────────────┘
                              │
                              ▼
                    ┌─────────────────┐
                    │    RETRIEVE     │
                    │  (get docs from │
                    │   vectorstore)  │
                    └────────┬────────┘
                             │
                             ▼
                    ┌─────────────────┐
                    │     GRADE       │
                    │ (LLM evaluates  │
                    │   relevance)    │
                    └────────┬────────┘
                             │
              ┌──────────────┼──────────────┐
              │              │              │
     (low relevance,   (good relevance)  (no docs,
      can retry)                         out of retries)
              │              │              │
              ▼              ▼              ▼
    ┌─────────────┐  ┌─────────────┐  ┌─────────────┐
    │   REWRITE   │  │  GENERATE   │  │  FALLBACK   │
    │ (improve    │  │  (create    │  │  (graceful  │
    │   query)    │  │   answer)   │  │   failure)  │
    └──────┬──────┘  └──────┬──────┘  └──────┬──────┘
           │                │                │
           │                ▼                ▼
           │         ┌─────────────────────────┐
           │         │          END            │
           │         └─────────────────────────┘
           │
           └──────────► (back to RETRIEVE)

    KEY INSIGHT: The loop between REWRITE → RETRIEVE → GRADE
    allows the system to self-correct and improve retrieval!
LangGraph també el pot generar: app.get_graph().draw_mermaid() imprimeix codi Mermaid, i app.get_graph().draw_mermaid_png() retorna bytes PNG — tots dos s'utilitzen al llarg de langgraph_core.py, conditional_edges.py i cycles_loops.py. Representa el graf real a la CI i compara'n els canvis; un diagrama fet a mà queda desactualitzat, un de generat no pot.
El resum d'aquell requadre del formador, a 06:56:20:
«Entre reescriure, recuperar i puntuar — això és el que fa que el sistema sigui realment un sistema amb autocorrecció.»
Executar-lo
# fcc-production-rag-part-6/04_agentic_rag.py  (lines 445-467)
    for query in test_queries:
        print("\n" + "=" * 60)
        print(f"QUERY: {query}")
        print("=" * 60)

        # Run the graph
        initial_state = {
            "query": query,
            "rewritten_query": "",
            "documents": [],
            "generation": "",
            "relevance_score": 0.0,
            "retry_count": 0,
            "max_retries": 2,
            "_vectorstore": vectorstore,  # Pass vectorstore via state
        }

        result = app.invoke(initial_state)

        print("\n" + "-" * 60)
        print("FINAL ANSWER:")
        print("-" * 60)
        print(result["generation"])
Inicialitza tots els camps. rewritten_query: "", documents: [], generation: "", relevance_score: 0.0, retry_count: 0, max_retries: 2. Els nodes que fan servir state["x"] en lloc de state.get("x") provocaran un KeyError amb un estat parcialment omplert, i TypedDict no imposa la presència dels camps — les claus absents simplement no hi són durant l'execució. Construeix el graf una sola vegada i reutilitza'l entre consultes; només l'estat és per petició.
El corpus de demostració té cinc documents, triats perquè tres tractin del tema i dos siguin purs distractors:
source | topic | Contingut |
|---|---|---|
langgraph_docs.md | langgraph | LangGraph = aplicacions amb LLM, estat i diversos actors; amplia LangChain amb grafs cíclics; persistència integrada, transmissió progressiva i intervenció humana |
langgraph_install.md | installation | pip install langgraph>=1.1.0; requereix Python 3.10 o superior; funciona amb LangChain 1.x; síncron i asíncron |
langgraph_concepts.md | stategraph | StateGraph = abstracció central; els nodes processen l'estat, les arestes són transicions; les arestes condicionals bifurquen segons valors d'estat; el graf es compila en un flux executable |
weather.md | weather | Seattle: hivern plujós, estiu suau; 40°F al gener i 75°F al juliol; unes 37 polzades de pluja anual |
python_history.md | python | Python creat per Guido van Rossum, publicat per primer cop el 1991 |
Embeddings generats amb text-embedding-3-small en una col·lecció Chroma anomenada agentic_rag_demo. Els tres rols d'LLM fan servir gpt-4o-mini.
Tres consultes de prova, triades deliberadament per exercitar les tres sortides:
    test_queries = [
        "How do I install LangGraph?",  # Should find relevant docs
        "What is StateGraph in LangGraph?",  # Should find relevant docs
        "How do I make pizza?",  # Should NOT find relevant docs (tests fallback)
    ]
06:57:22 «Com faig pizza? Això ho desbaratarà tot, que és el que necessitem veure.»
Consulta 1 — camí correcte amb un filtre parcial.
[RETRIEVE] Found 3 documents
  1. langgraph_install.md   2. langgraph_install.md   3. langgraph_docs.md
[GRADE] langgraph_install.md: 1.00 | langgraph_install.md: 1.00 | langgraph_docs.md: 0.00
[GRADE] Average relevance: 0.67
[GRADE] Keeping 2/3 documents
[ROUTER] Evaluating: score=0.67, retries=0/2, docs=2
[ROUTER] -> GENERATE (good relevance)
[GENERATE] Creating answer from 2 documents...
La resposta final anomena pip install langgraph>=1.1.0, Python 3.10+, LangChain 1.x i acaba amb (source: langgraph_install.md) — la instrucció de citació ha funcionat.
La xifra interessant és langgraph_docs.md: 0.00. Aquest document tracta de LangGraph. Ha obtingut zero per a una pregunta d'instal·lació perquè l'avaluador puntua la rellevància per respondre, no la rellevància temàtica — pregunta «conté informació que respon aquesta consulta?», no «tracta del mateix tema?». És exactament el comportament que vols d'un avaluador, i és una prova més afinada que la similitud de cosinus que ha recuperat el document inicialment.
L'avaluador és un segon filtre, semànticament més estricte, aplicat després del filtre lax del magatzem vectorial. Per això detecta soroll que el reranking també detectaria — i per això, si ja executes un reordenador cross-encoder de la part 6, t'hauries de preguntar si els necessites tots dos.
Consulta 2 — tot és rellevant. Les tres coincidències són langgraph_concepts.md, totes obtenen 1.00, no es filtra res i l'encaminador genera a la primera passada:
[GRADE] langgraph_concepts.md: 1.00 ×3
[GRADE] Average relevance: 1.00 | Keeping 3/3 documents
[ROUTER] Evaluating: score=1.00, retries=0/2, docs=3  ->  GENERATE (good relevance)
La resposta parafraseja fidelment aquell document — nodes com a funcions que processen l'estat, arestes com a transicions, arestes condicionals que bifurquen segons valors d'estat.
Consulta 3 — el camí de fallada complet.
attempt 0: [RETRIEVE] Found 3 documents → python_history.md ×3
           [GRADE] 0.00, 0.00, 0.00 | Average relevance: 0.00 | Keeping 0/3
           [ROUTER] score=0.00, retries=0/2, docs=0  ->  REWRITE (low relevance, retrying)
[REWRITE] Attempt 1: Original: 'How do I make pizza?'
          Rewritten: 'What are the step-by-step instructions for making homemade pizza,
                      including dough preparation, sauce recipes, and topping suggestions?'
attempt 1: same 3 docs, 0.00 each, Keeping 0/3
           [ROUTER] score=0.00, retries=1/2, docs=0  ->  REWRITE (low relevance, retrying)
[REWRITE] Attempt 2: Original: 'How do I make pizza?'
          Rewritten: 'What are the step-by-step instructions and essential ingredients for
                      making homemade pizza from scratch?'
attempt 2: same 3 docs, 0.00 each, Keeping 0/3
           [ROUTER] score=0.00, retries=2/2, docs=0  ->  FALLBACK (no relevant documents)
[FALLBACK] Retrieval failed after 2 attempts
FINAL ANSWER: I couldn't find relevant information to answer your question: "How do I make pizza?"
Llegeix les reescriptures amb cura. Són bones consultes. Si existís un corpus de pizza, qualsevol de les dues hi recuperaria informació. El bucle funciona exactament com s'ha dissenyat — i encara falla, perquè la base de coneixement no conté pizza. 06:59:23 «Aquesta és l'autocorrecció de què parlem.»
I res d'aquella traça no s'ha orquestrat a mà. 07:01:26 «Això és automàtic, autònom, perquè l'agent pot gestionar tot això.» Tres recuperacions, dues reescriptures, nou avaluacions i una sortida controlada han sorgit d'una sola crida app.invoke(initial_state).
El cost de l'execució completa d'aquesta única pregunta sense resposta: 3 recuperacions, 9 crides d'avaluació a l'LLM, 2 crides de reescriptura a l'LLM, 3 embeddings de consulta — per produir una cadena fixa. I això ens porta a la factura.
La factura: latència i cost, exposats honestament
El capítol reconeix que el bucle costa diners — 07:01:26 «cada vegada que es fan aquestes crides, recordeu que crideu els embeddings i un gran model de llenguatge» —, però no ho quantifica mai. Aquesta és la comptabilitat, deduïda del codi en lloc d'afirmada sense més.
Siguin k el k del recuperador (3 aquí) i R el nombre de reintents realment executats (de 0 a max_retries, per defecte 2).
| Unitat de feina | RAG d'un sol intent | Aquest graf amb agents |
|---|---|---|
| Embeddings de consulta | 1 | 1 + R |
| Cerques vectorials | 1 | 1 + R |
| Crides d'avaluació a l'LLM | 0 | k × (1 + R) |
| Crides de reescriptura a l'LLM | 0 | R |
| Crides de generació a l'LLM | 1 | 1 (o 0 al camí alternatiu) |
| Total de crides a l'LLM | 1 | k(1+R) + R + 1 (una menys al camí alternatiu) |
Substituint-hi els valors per defecte k=3, max_retries=2:
| Escenari | Crides a l'LLM | Anades i tornades seqüencials abans del primer token de resposta |
|---|---|---|
Camí correcte (R=0) | 3 avaluacions + 1 generació = 4 | 1 recuperació + 3 avaluacions en sèrie (1 si les agrupes) + generació |
Un reintent (R=1) | 6 avaluacions + 1 reescriptura + 1 generació = 8 | 2 recuperacions + 2 rondes d'avaluació + 1 reescriptura + generació |
Fallada completa (R=2) | 9 avaluacions + 2 reescriptures + 0 generacions = 11 | 3 recuperacions + 3 rondes d'avaluació + 2 reescriptures |
Tres conseqüències que hauries d'interioritzar:
- El camí correcte ja fa 4× les crides a l'LLM del RAG d'un sol intent, abans de cap reintent.
Totes les consultes paguen avaluació, fins i tot «hola».
- El camí de fallada és el més car. Això inverteix l'economia habitual: en un
sistema d'un sol intent, una recuperació fallida costa el mateix que una de correcta. Aquí, les consultes que el sistema no pot respondre són les que més costen. Si una proporció significativa del trànsit queda fora del corpus, pressuposta-ho.
- Les crides d'avaluació d'aquesta implementació són en sèrie. El bucle
for doc in documentsfa
k anades i tornades bloquejants. Aplica-hi la latència per crida que hagis mesurat: sigui quin sigui el cost temporal d'una avaluació amb gpt-4o-mini, el camí correcte el paga tres vegades abans de començar la generació, i el camí de fallada arriba a onze anades i tornades en sèrie a l'LLM abans que l'usuari vegi una cadena fixa. Mesura-ho al teu entorn abans de decidir si és tolerable.
L'error del codi distribuït
Aquest és el defecte més instructiu de tot el repositori original; per això té una secció pròpia.
Torna a mirar aquestes dues línies de retrieve_documents:
    vectorstore = state.get("_vectorstore")  # Injected at runtime
    if not vectorstore:
        # Fallback - create new (in production, pass via config)
        vectorstore = create_sample_vectorstore()
i l'estat inicial:
"_vectorstore": vectorstore, # Pass vectorstore via state
_vectorstore no està declarat al TypedDict RAGState. LangGraph construeix els canals d'estat a partir de l'esquema; per tant, una clau que no és a l'esquema es descarta. En conseqüència, state.get("_vectorstore") retorna None a cada crida, la branca «alternativa» s'activa cada vegada i create_sample_vectorstore() regenera els embeddings i torna a inserir els cinc documents d'exemple. Com que el client efímer de Chroma dins del procés es desa en memòria cau segons la configuració, totes aquestes insercions van a la mateixa col·lecció agentic_rag_demo, que creix monòtonament durant la vida del procés.
L'execució enregistrada ho demostra, i aquest és el detall que fa el diagnòstic irrefutable:
- Els primers 3 resultats de la consulta 1:
langgraph_install.md,langgraph_install.md,langgraph_docs.md— el
document d'instal·lació dues vegades.
- Els primers 3 resultats de la consulta 2:
langgraph_concepts.mdtres vegades. - Els primers 3 resultats de la consulta 3:
python_history.mdtres vegades.
El corpus conté cadascun d'aquests fitxers exactament una vegada. El nombre de duplicats creix en un per crida a retrieve, perquè cada crida insereix una altra còpia.
Conseqüències, en ordre creixent de gravetat:
k=3retorna un únic document diferent disfressat de tres.- Pagues per generar els embeddings de cinc documents a cada recuperació, un cost ocult per volta que la
taula de costos anterior ni tan sols inclou.
relevance_scoreés una mitjana sobre duplicats. Tres còpies d'un document perfecte
fan una mitjana d'1.00; un document perfecte més dos distractors fan 0.33. L'error distorsiona l'encaminament, és a dir, les mateixes decisions que el capítol ensenya.
La solució és una de dues coses, i el comentari del codi diu quina és la correcta:
# Option A (minimal): declare it, so LangGraph keeps it.
class RAGState(TypedDict):
    ...
    _vectorstore: object   # or a proper VectorStore type

# Option B (better, and what the comment "in production, pass via config" means):
# don't put a live client in state at all. Close over it, or pass it through
# RunnableConfig, and delete the create-new fallback so a missing store fails LOUDLY.
def make_retrieve_node(vectorstore, k: int = 3):
    def retrieve_documents(state: RAGState) -> dict:
        query = state.get("rewritten_query") or state["query"]
        retriever = vectorstore.as_retriever(search_kwargs={"k": k})
        return {"documents": retriever.invoke(query)}

    return retrieve_documents
L'estat és per a dades, no per a identificadors de recursos actius. Els gestors de punts de control serialitzen l'estat, els traçadors en comparen els canvis i els nodes se'l copien entre si. Un client de base de dades actiu no hi té lloc. Injecta els clients mitjançant clausura o configuració; limita l'estat a coses que no et faria res veure en un registre JSON.
I la lliçó general, més gran que aquest error: una alternativa silenciosa ha amagat una injecció defectuosa durant tota una lliçó enregistrada. if not vectorstore: build one és exactament el tipus de branca defensiva que converteix un AttributeError sorollós en una resposta equivocada silenciosa. Torna a ser la invariant 4, aquest cop dins del teu propi codi d'orquestració.
La resta de paranys
| # | Parany | Per què fa mal | Què fer |
|---|---|---|---|
| G2 | rewrite sempre reescriu state["query"], mai la reescriptura anterior | L'intent 2 és una nova tirada independent, no un refinament | Dona al prompt les reescriptures anteriors + les seves puntuacions |
| G3 | Una crida d'avaluació a l'LLM per document i intent | k=3, R=2 → 9 crides d'avaluació per a una fallada | Agrupar, paral·lelitzar, interrompre anticipadament o fer servir un reordenador |
| G4 | except ValueError: score = 0.5 | Una puntuació mal formada cau exactament al llindar de conservació | Rebutja per defecte amb 0.0; registra la resposta en brut |
| G5 | grade sobreescriu documents amb la llista filtrada | Els documents rebutjats desapareixen de l'estat per sempre | Escriu els supervivents en una clau nova; conserva el conjunt en brut per depurar |
| G6 | L'avaluació sempre fa servir la consulta original, fins i tot després d'una reescriptura | Una reescriptura que troba documents coincidents amb la formulació nova encara pot obtenir un 0 respecte de l'antiga | Totes dues opcions són defensables — decideix-ho deliberadament i comenta-ho |
| G7 | set_entry_point("retrieve") implica que totes les consultes recuperen | «hola» costa una recuperació + k crides d'avaluació | Afegeix un primer node de decisió real o un control barat (part 11) davant del graf |
| G12 | Codi mort al fitxer de la lliçó: import os sense ús, Annotated i from operator import add sense ús, from langchain_chroma import Chroma duplicat a les línies 21–22 | Inofensiu, però són restes de copiar i enganxar | No ho copiïs sense entendre-ho |
| G13 | vectorstore.delete_collection() només s'executa en cas d'èxit | Una excepció a mitja demostració deixa la col·lecció poblada per a l'execució següent | try/finally o un persist_directory nou per execució |
Dues coses més que el capítol no planteja però que trobaràs:
- El graf no té temps d'espera màxim global.
max_retriesacota el nombre de voltes, no el temps
real. Un LLM lent converteix un bucle acotat en una latència sense límit. Posa un termini a tot app.invoke i degrada a la cadena alternativa quan se superi.
- Ningú no avalua l'avaluador. Res del capítol no comprova si les puntuacions de
gpt-4o-mini
0/0.3/0.7/1.0 estan calibrades amb el judici humà. Tota la lògica d'encaminament es basa en l'opinió d'aquell model. Mostreja cinquanta parelles (consulta, document), etiqueta-les tu i mesura l'acord abans de confiar un llindar de 0.5 al trànsit de producció.
El mateix bucle, generalitzat
La versió RAG és un cas d'un patró que apareix pertot arreu un cop tens un StateGraph. El repositori germà en té dos més, i comparar-los ensenya una cosa que la versió RAG tota sola no pot.
Un bucle de refinament de qualitat — mateixa estructura, avaluador LLM, llindar de puntuació més límit d'iteracions:
# production-course-main-code/conditional_edges.py  (lines 131-152)
    def should_continue(state: QualityState) -> Literal["improve", "finalize"]:
        if state["quality_score"] >= 7:
            return "finalize"
        elif state["iteration"] >= 3:
            return "finalize"  # Max iterations
        else:
            return "improve"

    graph = StateGraph(QualityState)

    graph.add_node("evaluate", evaluate_quality)
    graph.add_node("improve", improve_content)
    graph.add_node("finalize", finalize_content)

    graph.add_edge(START, "evaluate")

    graph.add_conditional_edges(
        "evaluate", should_continue, {"improve": "improve", "finalize": "finalize"}
    )

    graph.add_edge("improve", "evaluate")  # Loop back!
    graph.add_edge("finalize", END)
Esquelet idèntic: avaluar → encaminar → {millorar i repetir | finalitzar}. Fixa't que té la mateixa sortida d'emergència de dues condicions — qualitat assolida o pressupost esgotat —, i també que iteration només s'incrementa a improve; per tant, evaluate repeteix la crida a l'LLM a cada passada. La mateixa estructura de cost que el nostre avaluador.
Un generador de codi amb autocorrecció — i aquest és més interessant, perquè l'avaluador no és un LLM:
# production-course-main-code/cycles_loops.py  (lines 54-93, abridged)
    def validate_code(state: CodeGenState) -> dict:
        code = state["code"]

        # Step 1: Does it compile?
        try:
            compile(code, "<string>", "exec")
        except SyntaxError as e:
            return {"errors": [f"SyntaxError: {e}"], "success": False}

        # Step 2: Does it RUN and produce correct results?
        test_cases = [
            ([3, 1, 4, 1, 5, 9], 5),  # normal case
            ([1, 1, 1], None),  # all same → no second largest
            ([7], None),  # single element
            ([3, -1, 3, 5, 5], 3),  # duplicates at top
        ]
        ...
        return {"success": True}
I, crucialment, el node generador llegeix l'error anterior:
# production-course-main-code/cycles_loops.py  (lines 31-52, abridged)
    def generate_code(state: CodeGenState) -> dict:
        if state["iteration"] == 0:
            # First attempt
            prompt = f"Write Python code for: {state['task']}\nReturn only the code."
        else:
            # Correction attempt
            prompt = (
                f"Fix this Python code:\n{state['code']}\n\n"
                f"Errors:\n{state['errors'][-1]}\n\n"
                "Return only the corrected code."
            )
        ...
        return {"code": code, "iteration": state["iteration"] + 1}
Això és el que falta al node rewrite de RAG (parany G2). El reintent del bucle de codi és informat: sap exactament què ha fallat abans i se li diu que ho corregeixi. El reintent del bucle RAG és cec: torna a tirar els daus amb la consulta original i espera tenir sort.
Un matís abans de copiar aquest fitxer sencer: les dades de prova han divergit. La tasca que invoca és «una funció que calcula el factorial recursivament», mentre que validate_code busca una funció anomenada solve i verifica el comportament del segon element més gran — un entorn de proves que no pot passar mai. demo_self_correcting_code() està comentat a __main__; per tant, ningú no se n'ha adonat. Un avaluador determinista només és tan bo com la seva concordança amb la tasca; aquesta concordança també és una cosa que has de provar.
D'aquesta comparació se'n desprenen dues regles, i són el més transferible d'aquesta part: 1. Prefereix un avaluador determinista sempre que n'hi hagi un.
compile()més un grapat de casos de prova no costa res, no al·lucina mai i no necessita calibratge. Un avaluador LLM és el que fas servir quan — com en el judici de rellevància — no hi ha cap comprovació determinista barata. 2. Retorna la fallada al reintent. Un reintent que no sap per què ha fallat l'intent anterior és una màquina escurabutxaques amb un comptador de tokens connectat.
Què deixa fora aquesta lliçó, i què necessita producció
El mateix corpus de demostració anuncia tres funcionalitats de LangGraph que després la lliçó no fa servir mai — persistència, transmissió progressiva i intervenció humana. No és una casualitat de redacció; són les funcionalitats que converteixen aquest graf en un producte.
| Peça absent | Per què la necessites | On és |
|---|---|---|
| Punts de control | Reprendre un bucle llarg després d'una caiguda; memòria per conversa; depuració d'un reintent viatjant pels estats anteriors | graph.compile(checkpointer=MemorySaver()) o SqliteSaver.from_conn_string(db_path), amb config={"configurable": {"thread_id": "user-123"}} — production-course-main-code/checkpointing.py |
| Intervenció humana | Interrompre abans d'un node car o irreversible i preguntar a una persona | production-course-main-code/human_in_loop.py |
| Transmissió progressiva per node | L'usuari veu «cercant… avaluant… reescrivint…» en lloc d'un silenci llarg — la millor mitigació de la latència que afegeix aquest patró | API de transmissió progressiva de LangGraph (no cobertes al curs) |
| Traçat del bucle | Veure quina branca ha seguit cada consulta i quants reintents ha fet | LangSmith, part 7 |
| Diverses eines de recuperació | Patró 4 — canviar d'estratègia, no només de formulació | production-course-main-code/advanced_rag.py: recuperadors MultiQuery, ContextualCompression, Ensemble(BM25), ParentDocument |
| Descomposició en diversos passos | Patró 3 — dividir una pregunta composta en subconsultes i recuperar per a cadascuna | Afirmat a 06:41:44, implementat enlloc |
| Avaluacions de l'avaluador | Ningú no valida el calibratge de l'avaluador | El pilar d'avaluacions, part 7 |
D'aquestes peces, la transmissió progressiva per node mereix un èmfasi especial. El cost honest de RAG amb agents és la latència, i la manera més barata de fer tolerable una resposta lenta és mostrar a l'usuari que el bucle treballa. LangGraph dona transmissió progressiva per node de franc un cop el flux de control és un graf — cosa que, circularment, és un dels millors motius per haver-lo construït com a graf.
Quan fer-lo servir — i quan no
L'script imprimeix les seves sis idees clau a 07:02:28, i són un resum just de tot l'anterior:
- El RAG tradicional és d'un sol intent: recuperar → generar
- RAG amb agents afegeix avaluació i bucles de reintents
- El
StateGraphde LangGraph permet fluxos de treball cíclics - Patró clau: recuperar → puntuar → [reescriure si cal] → generar
- Alternativa controlada quan la recuperació falla del tot
- Aquest és EL patró RAG de producció de 2026
Sobre el #3, l'explicació del mateix formador a 07:02:28: els fluxos cíclics volen dir que el graf «pot reintentar, anar endavant i enrere fins que es compleixi alguna cosa — i llavors surt del bucle». El «fins que es compleixi alguna cosa» és la part decisiva de la frase, i és el que garanteix max_retries.
L'script mateix imprimeix els quatre criteris a 07:03:30, amb l'explicació del formador:
| Criteri | Què significa a la pràctica |
|---|---|
| Consultes complexes que poden necessitar reformulació | Els usuaris escriuen preguntes amb el seu propi vocabulari i els documents en fan servir un altre |
| Aplicacions crítiques on importa la qualitat de la resposta | «Posem que construïu sobre documents legals o coses que han de ser específiques» — àmbits jurídic, de compliment i mèdic |
| Quan tens tipus de documents diversos | «Documents legals, guies d'alguna mena, instruccions — tots aquests tipus de documents» — una sola estratègia de recuperació no s'ajusta a tots |
| Aplicacions de cara a l'usuari (enfront de processament per lots) | Una persona espera i jutjarà la resposta; en un lot, ningú no veu la fallada en temps real i pots reintentar fora de línia de franc |
I el cas contrari, exposat amb la mateixa claredat 07:03:30: «Si construïu una cosa molt simple — evidentment aquí només fem proves —, no necessiteu realment RAG amb agents.»
Una matriu de decisió que uneix les dues coses:
| La teva situació | Veredicte |
|---|---|
| Corpus homogeni, usuaris amb el mateix vocabulari, qualitat de recuperació ja mesurada com a bona | Un sol intent. El bucle gairebé no s'activarà mai i, igualment, pagaràs avaluació a cada consulta |
| Sensible a la latència (xat amb p95 estricte, autocompleció, veu) | Un sol intent, o amb agents, transmissió progressiva per node i max_retries=1 |
| Pipelines per lots / fora de línia | Un sol intent per passada; reintenta a escala de tasca, on els reintents són barats |
| Les fallades són buits de cobertura (la resposta realment no és al corpus) | Arregla el corpus. El bucle encareix aquestes fallades, no les redueix |
| Les fallades són desajustos de vocabulari (la resposta hi és, formulada d'una altra manera) | Amb agents — això és exactament el que resol |
| Aplicació crítica, de cara a l'usuari, amb documents de tipus diversos | Amb agents, amb un pressupost estricte i una alternativa |
| Necessites que «no ho sé» sigui fiable | Amb agents — la parella d'avaluació + alternativa és la manera més neta de construir un rebuig fiable |
El capítol acaba amb la lliçó general repetida durant tot el curs, i és la nota correcta per acabar:
07:03:30 «Sempre es tracta de saber quan fer-ho servir i quan no.»
Ho reformula una última vegada a 07:04:31, just abans que el curs passi a GraphRAG (part 16): si ets en producció, mira el cas d'ús i decideix si realment ho necessita.
Llista de comprovació — decisions abans de publicar un bucle amb autocorrecció
Arquitectura
- La teva manera de fallar és de vocabulari o de cobertura? Mostreja 30 consultes fallides i etiqueta-les. Si la majoria són buits de cobertura, omple'ls i salta't tota aquesta part.
- D'on surt el senyal d'avaluació — un avaluador LLM, la puntuació d'un reordenador cross-encoder o una comprovació determinista? Prefereix determinisme; prefereix baix cost; fes servir un LLM com a última opció.
- El graf recupera incondicionalment (
set_entry_point("retrieve")) o té una primera decisió real? Com a mínim, filtra les entrades trivials abans del graf. - Encamines segons la mitjana de les puntuacions, el màxim o «almenys un document ≥ X»? Decideix-ho i escriu per què. La mitjana del curs és una elecció, no una llei.
Pressupostos
- Defineix
max_retriesexplícitament, per petició, a l'estat. Per defecte2. Mai sense límit. - Defineix un termini de temps real per a tot
app.invoke, independent del nombre de reintents. - Calcula el nombre de crides en el pitjor cas:
k(1+max_retries) + max_retries + 1crides a l'LLM. Ambk=3imax_retries=2són 12. Multiplica-ho pel trànsit. Decideix si et pots permetre el camí de fallada, perquè és el més car. - Agrupa o paral·lelitza les crides d'avaluació abans de publicar. Fer
kanades i tornades d'avaluació en sèrie a cada consulta és el valor per defecte, i és equivocat.
Correcció
- Declara tots els camps que poses a l'estat — incloses les referències a recursos injectats — o injecta'ls mitjançant clausura o configuració. Elimina les alternatives de «crea'l si falta»; falla de manera explícita.
- Fes que l'analitzador de puntuacions rebutgi per defecte (
0.0), no que permeti (0.5), i registra totes les respostes que no es puguin interpretar. - Conserva a l'estat el conjunt de recuperació en brut al costat del filtrat per poder depurar què s'ha descartat.
- Dona la reescriptura anterior i la seva puntuació al prompt de reescriptura següent. Un reintent cec és una moneda a l'aire que has pagat.
- Decideix si l'avaluació utilitza la consulta original o la reescrita i comenta la decisió al codi. Totes dues són defensables; el silenci no.
Operacions
- Construeix el graf una vegada a l'arrencada; només l'estat és per petició.
- Emet registres estructurats des de cada node amb un identificador de petició perquè una execució de tres intents es pugui reconstruir només amb registres. Substitueix les instruccions
print. - Segueix la taxa de reintents, la d'abandonament, les crides d'avaluació per consulta i la latència p95 de principi a fi. Si la taxa de reintents és gairebé zero, pagues un bucle que no s'activa mai — torna a un sol intent.
- Transmet les transicions de node a l'usuari. És la solució més barata per a la latència que costa aquest patró.
- Prova el camí de fallada a la CI: una consulta que el corpus no pot respondre ha d'arribar a
fallbacki no ha d'arribar mai agenerate. - Calibra l'avaluador amb etiquetes humanes abans de confiar en el llindar
0.5. - Representa el graf (
app.get_graph().draw_mermaid()) a la CI i compara'n els canvis. Els diagrames generats no poden quedar desactualitzats.
La versió en una frase
Un bucle de recuperació amb autocorrecció compensa la factura exactament quan les fallades del sistema es poden resoldre fent una pregunta millor. Primer mesura-ho; després construeix el graf.