
Qualitat de la recuperació: cerca híbrida, reranking i citacions
Cerca híbrida BM25 i vectorial amb fusió RRF, reranking, compressió i cites.
Les parts 3 a 5 t'han donat un sistema que recupera alguna cosa i hi respon. Aquesta part tracta de la distància entre alguna cosa i la cosa adequada. Totes les tècniques d'aquí modifiquen exactament dues caselles del pipeline de fase B de la part 1 —Recuperació → Fusió/Filtratge → Compressió/Reranking— i cap no toca l'índex. És deliberat: les millores de qualitat més barates que pots posar en producció són les que no obliguen a tornar a generar els embeddings.
Dos dels cinc modes de fallada de la part 1 es tracten aquí:
- Mode de fallada #2, desajust d'embeddings. L'usuari escriu
SKU-7742XoE_CONN_REFUSEDi el model d'embeddings, que només coneix significats, no té cap significat amb què treballar. Solució: cerca híbrida; afegir un recuperador al qual no importi gens el significat. - Mode de fallada #3, soroll en la recuperació. Tornen deu documents, dos són rellevants i els vuit distractors es mengen la finestra de context i l'atenció del model. Solucions: reranking, compressió i recuperació del document pare.
Totes dues fallades són silencioses (invariant 4). Res no llança cap excepció. La taxa d'errors es manté al 0% mentre les respostes empitjoren sense fer soroll, i per això totes les tècniques d'aquesta part s'acompanyen d'un entorn de mesura en lloc d'una impressió subjectiva.
Condensada en una frase, aquesta part diu: recupera amb amplitud i després restringeix deliberadament. Cada tècnica següent és una manera diferent d'ampliar o de restringir, i l'habilitat és saber quina demana cada fallada.
On s'ensorra la cerca vectorial pura
El superpoder de la cerca vectorial és que fa coincidir significats en lloc de caràcters. Aquest també és precisament el seu punt cec: les cadenes que no porten significat no tenen cap posició a l'espai semàntic 01:53:47. L'instructor té cura de plantejar-les com a fallades totals, no com a degradacions: el document correcte queda intacte a la base de dades mentre el recuperador retorna amb confiança quatre documents equivocats.
Hi ha quatre classes, i val la pena memoritzar-les perquè et permetran reconèixer el problema als teus logs.
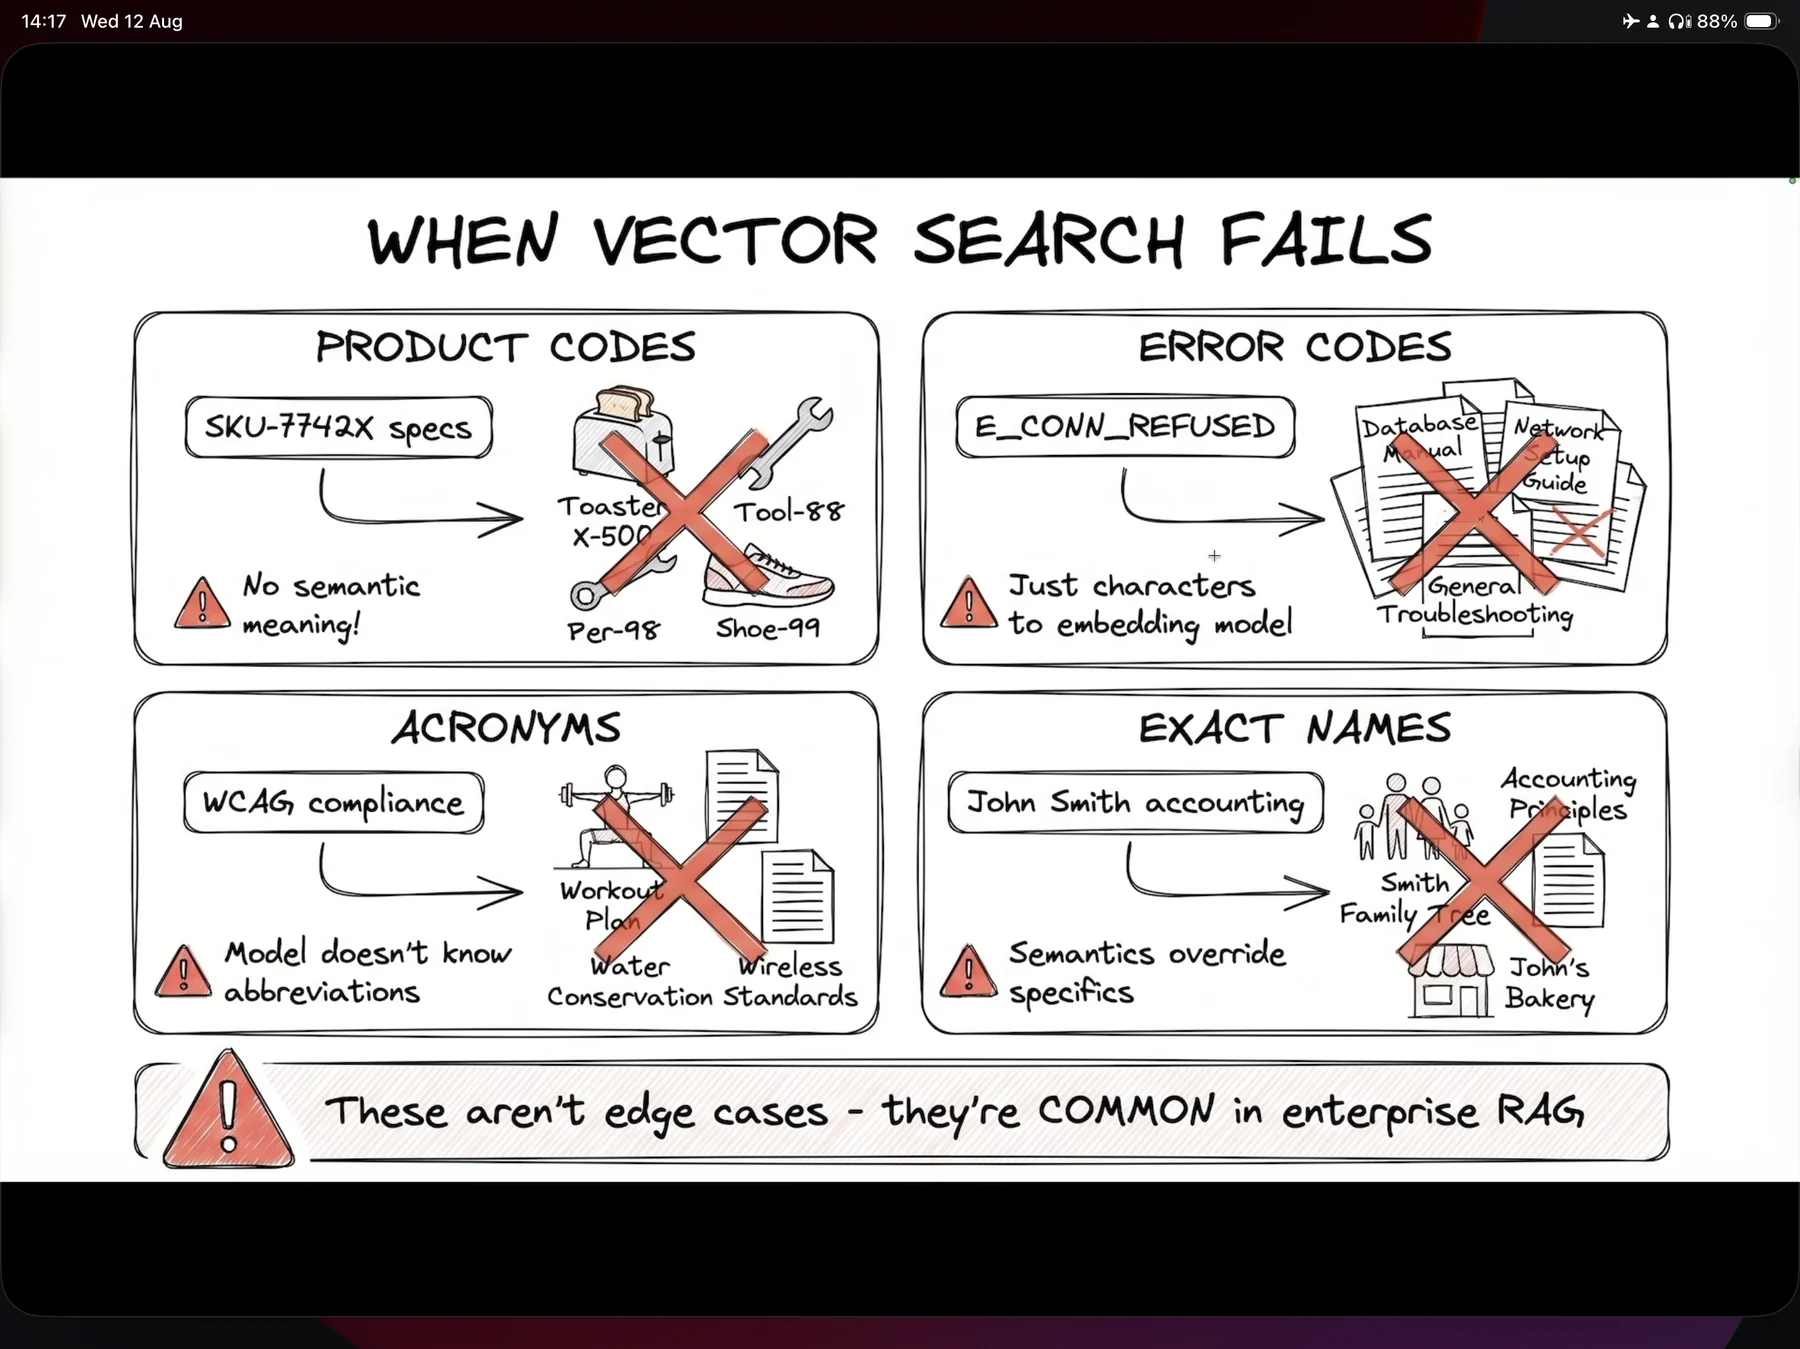
| Classe de fallada | Consulta d'exemple | Què retorna la cerca vectorial en lloc del resultat correcte | Causa arrel |
|---|---|---|---|
| Codis de producte / SKU | SKU-7742X specs | Toaster X-500, Tool-88, Per-98, Shoe-99 | Cap significat semàntic: només caràcters |
| Codis d'error / identificadors | E_CONN_REFUSED | Manual de bases de dades, guia de configuració de xarxa, resolució general de problemes | Només caràcters per al model d'embeddings |
| Acrònims / abreviacions | WCAG compliance | Workout Plan, Water Conservation Standards, Wireless Standards | El model no sap que l'abreviació es desenvolupa com Web Content Accessibility Guidelines |
| Noms exactes | John Smith accounting | Smith Family Tree, Accounting Principles, John's Bakery | La semàntica s'imposa als detalls concrets |
Mira amb atenció la fila dels acrònims, perquè és la més instructiva. El recuperador no ha retornat soroll aleatori. Ha retornat documents amb inicials o aire general que encaixen: Workout, Water Conservation, Wireless. L'embedding ha codificat «alguna cosa amb W i relacionada amb estàndards» i ha trobat les coses més properes d'aquest tipus. S'ha comportat perfectament. Simplement no tenia res sobre què comportar-se perfectament.
La fila dels noms exactes té el diagnòstic més precís de tota la diapositiva: la semàntica s'imposa als detalls concrets. La consulta «John Smith accounting» es descompon, a l'espai d'embeddings, en una direcció de «persona» i una de «comptabilitat». Els documents que tenen fortament un d'aquests trets superen el document que els té tots dos de manera feble. El tema general ofega l'entitat concreta.
Dues fallades relacionades però diferents que no has de confondre amb aquestes, perquè les solucions es troben en altres parts:
- El fragment mai no ha estat coherent des del principi (la resposta queda dividida entre el fragment 47 i el 48): això és la part 3, i cap recuperador no ho resol.
- El nom de l'entitat que fa de pont no és a la consulta («l'assistent del director general» contra «Sarah Johnson treballa al departament de direcció»): cap quantitat de BM25, reranking o ajust de k no ajuda, perquè cap branca no té una cadena o un concepte on agafar-se. És el problema de múltiples salts i es tracta a la part 16.
BM25: l'invers exacte de la cerca vectorial
BM25 («Best Matching 25») és una funció d'ordenació lèxica: puntua un document segons les estadístiques dels termes de consulta que conté —freqüència del terme, normalització per longitud del document i freqüència inversa de document perquè els termes rars comptin més que els comuns. Sense model d'embeddings, sense xarxa neuronal, sense semàntica.
«BM25 és l'oposat de la cerca vectorial. No entén gens el significat. Només compta paraules.» 01:56:52
Això sembla una limitació fins que els poses l'un al costat de l'altre.
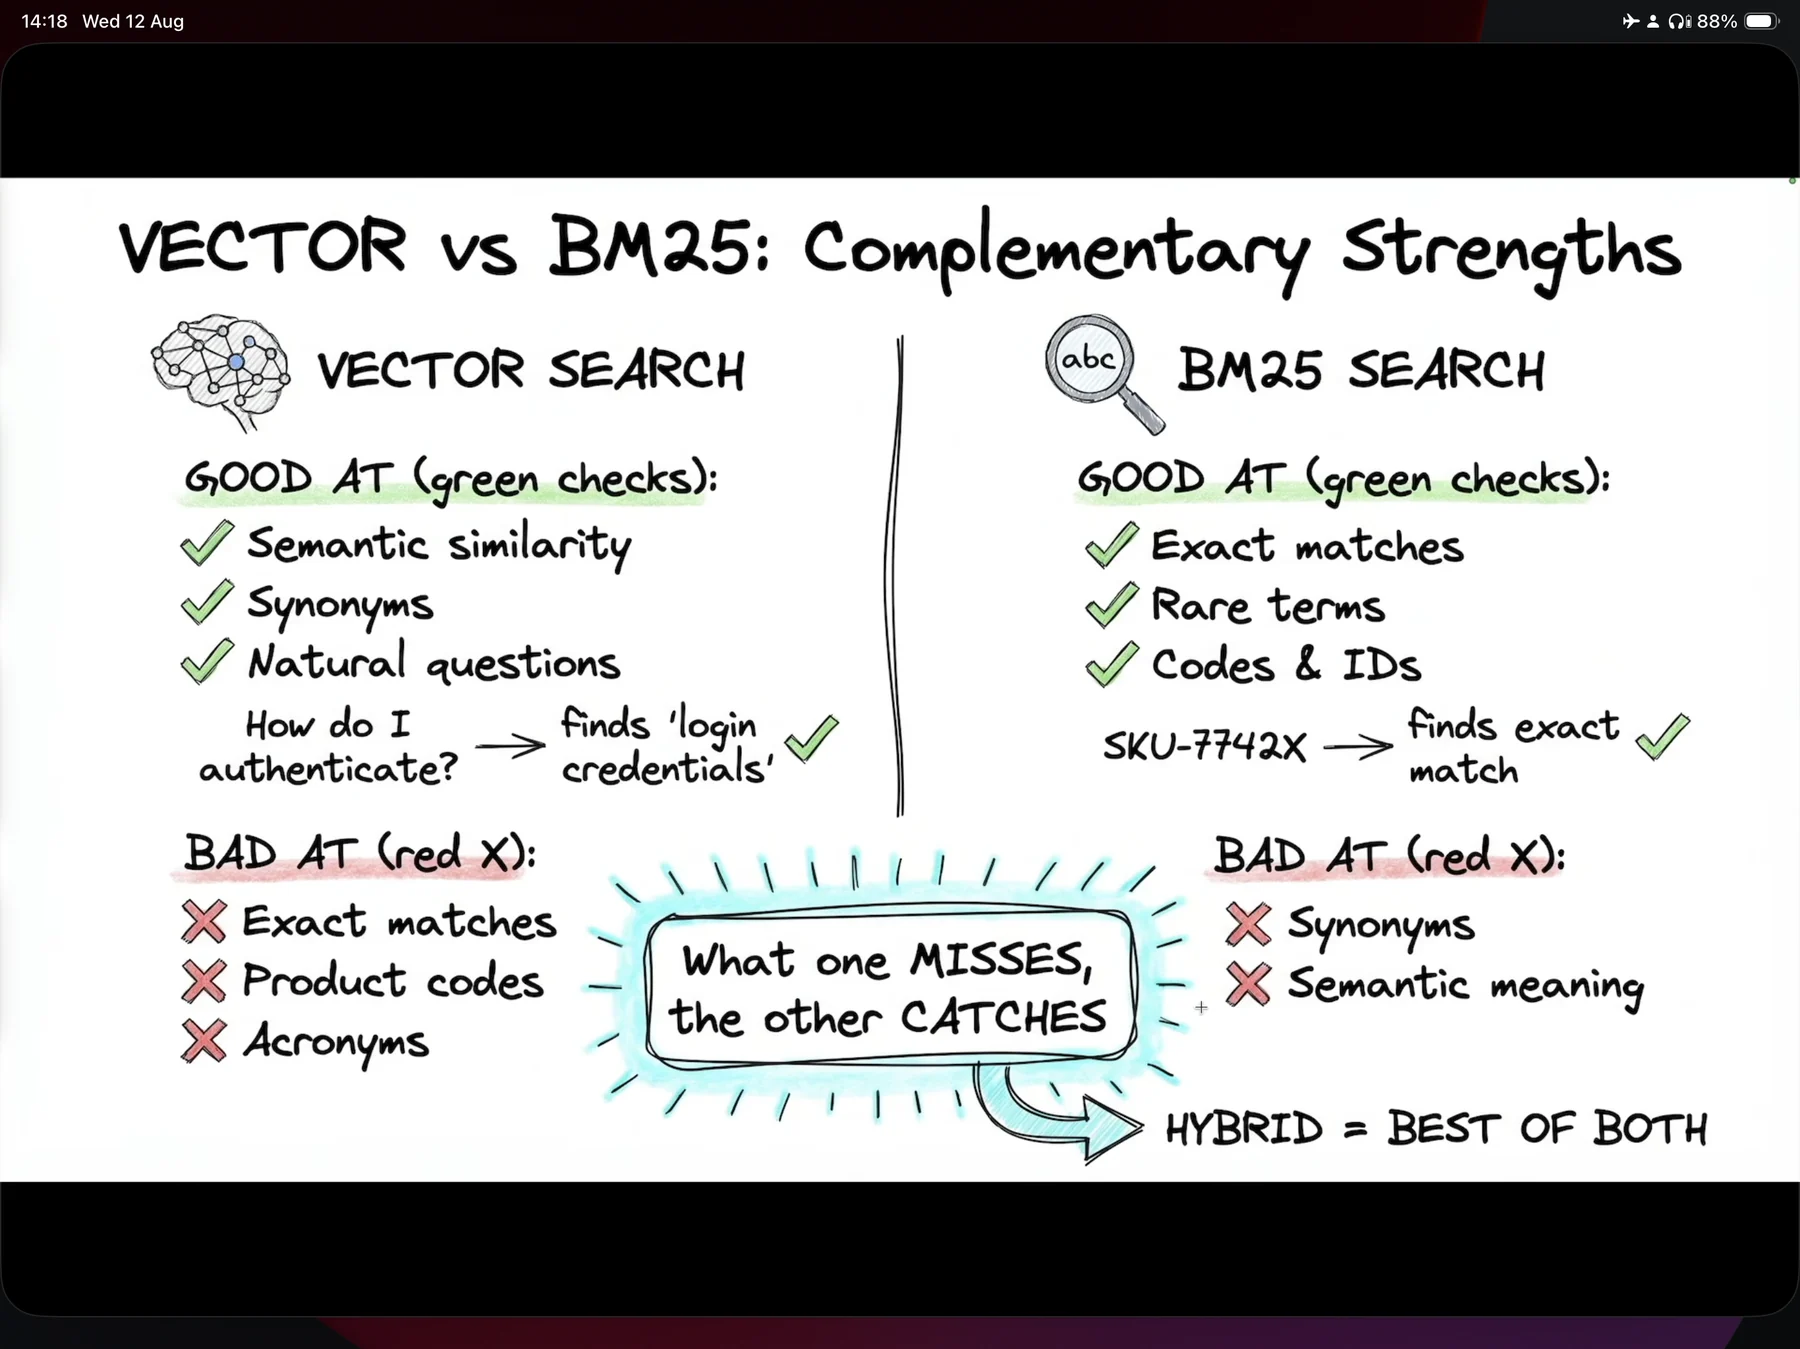
| Cerca vectorial | Cerca BM25 | |
|---|---|---|
| Punts forts | similitud semàntica · sinònims · preguntes naturals | coincidències exactes · termes rars · codis & identificadors |
| Exemple | «Com m'autentico?» → troba 'credencials d'inici de sessió' | SKU-7742X → troba la coincidència exacta |
| Punts febles | coincidències exactes · codis de producte · acrònims | sinònims · significat semàntic |
| Necessita un model d'embeddings | Sí, en indexar i en consultar | No |
| Cost d'actualització de l'índex | Incremental (upsert) | Reconstrucció completa |
| On s'executa | Base de dades vectorial | Dins del procés (rank_bm25) o al teu motor de cerca |
Les tres primeres files són de la diapositiva; les tres últimes són el que afegeix el codi distribuït, i són les que decideixen l'arquitectura. La frase sobre la qual gira tota la lliçó és de la mateixa diapositiva: «El que un NO TROBA, l'altre HO CAPTURA», que es resol en «HÍBRID = EL MILLOR DE TOTS DOS» 01:57:53. Pren la primera meitat com l'afirmació d'enginyeria i la segona com el màrqueting: els resultats mesurats més endavant en aquesta part avalen «poques vegades pitjor, de vegades molt millor», una afirmació més feble i més útil que «el millor de tots dos».
Què fa realment BM25Retriever
No tractis BM25 com una caixa negra. L'embolcall de LangChain amb prou feines té un centenar de línies, està instal·lat a l'entorn amb versions fixades i dos dels seus valors predeterminats et poden causar problemes.
# .venv/.../langchain_community/retrievers/bm25.py — the shipped implementation (abridged)
def default_preprocessing_func(text: str) -> List[str]:
    return text.split()


class BM25Retriever(BaseRetriever):
    """`BM25` retriever without Elasticsearch."""

    vectorizer: Any = None
    docs: List[Document] = Field(repr=False)
    k: int = 4
    """ Number of documents to return."""
    preprocess_func: Callable[[str], List[str]] = default_preprocessing_func

    @classmethod
    def from_texts(cls, texts, metadatas=None, ids=None, bm25_params=None,
                   preprocess_func=default_preprocessing_func, **kwargs):
        from rank_bm25 import BM25Okapi

        texts_processed = [preprocess_func(t) for t in texts]
        vectorizer = BM25Okapi(texts_processed, **(bm25_params or {}))
        ...
        return cls(vectorizer=vectorizer, docs=docs,
                   preprocess_func=preprocess_func, **kwargs)

    def _get_relevant_documents(self, query, *, run_manager):
        processed_query = self.preprocess_func(query)
        return self.vectorizer.get_top_n(processed_query, self.docs, n=self.k)
D'aquestes línies es desprenen quatre coses:
- El tokenitzador predeterminat és
str.split(). Només espais en blanc. Sense conversió a minúscules, eliminació de puntuació ni reducció a l'arrel. Per tant,E_CONN_REFUSED.al final d'una frase és un token diferent deE_CONN_REFUSED, iWCAGno coincideix ambwcag. Una branca BM25 que rendeix poc silenciosament just amb els codis per als quals l'has afegida acostuma a tenir aquest problema, i cap altre. - Passa
preprocess_funcen construir, mai després. Mira on es fa servir:from_textsl'aplica a tot el corpus abans de construir el vectoritzador, i_get_relevant_documentsl'aplica a la consulta. Assignarretriever.preprocess_func = my_funca posteriori només canvia el costat de consulta, de manera que consulta i índex es tokenitzen amb regles diferents i l'exhaustivitat cau sense avisar. Passa'l com a argument amb nom afrom_documents(...)perquè tots dos costats coincideixin. kté un valor predeterminat de 4, no de 3, que casualment coincideix amb el consell de producció de la diapositiva 06. La demostració estableix desprésbm25_retriever.k = 3a la instància; això funciona, però tambéBM25Retriever.from_documents(docs, k=3), perquèfrom_documentstransmet**kwargsa través defrom_textsfins al constructor. Prioritza l'argument amb nom: manté la configuració del recuperador en una sola expressió.docsés tot el corpus, mantingut en memòria, iget_top_npuntua cada document en cada consulta. ElBM25Okapiderank_bm25s'instancia ambk1=1.5, b=0.75, epsilon=0.25i fa un recorregut lineal ambnp.argsortsobre totes les puntuacions: correcte amb milers de documents, un problema real amb milions. A aquesta escala, trasllades la branca de paraules clau a la cerca de text complet de Postgres, OpenSearch/Elasticsearch o el mode híbrid natiu de la base de dades vectorial (part 10).
I l'advertiment obligatori en l'altre sentit: no posis mai BM25 sol en producció. A la demostració en directe, «Com m'autentico?» va situar el document de compliment de WCAG 2.1 a la posició #1: «ha fallat completament» 02:09:05. Fins i tot en consultes en què BM25 encertava a la posició 1, les posicions 2 i 3 eren documents sense relació 02:07:04. La precisió top-1 no implica una llista neta.
Bifurcar i després fusionar: el pipeline híbrid
La cerca híbrida no és «cerca vectorial amb un filtre de paraules clau». La consulta passa per totes dues branques simultàniament i un algoritme de fusió combina les dues llistes ordenades 01:58:56.
ASCII original
                    ┌──────────────────────┐
                    │  "SKU-7742X specs"   │
                    └──────────┬───────────┘
                               │  (the same query string, unmodified)
              ┌────────────────┴────────────────┐
              ▼                                 ▼
      ┌───────────────┐                 ┌───────────────┐
      │ VECTOR branch │                 │  BM25 branch  │
      │ embed → ANN   │                 │  term stats   │
      └───────┬───────┘                 └───────┬───────┘
              │ doc3, doc7, doc1                │ doc1, doc9, doc3
              └────────────────┬────────────────┘
                               ▼
                 ┌──────────────────────────┐
                 │  Reciprocal Rank Fusion  │   weights=[w_bm25, w_vector]
                 │  score += w / (rank + c) │   c = 60
                 └────────────┬─────────────┘
                              ▼
                     doc1, doc3, doc7  ← one fused ranking
Observa què no passa: la consulta no es reescriu, divideix ni encamina. La mateixa cadena va a totes dues branques. Això importa perquè vol dir que la cerca híbrida no et costa cap crida a l'LLM, a diferència de la multiconsulta més endavant en aquesta part, que fa exactament el compromís contrari.
RRF i per què guanya el consens
La fusió recíproca de rangs descarta les puntuacions. Aquesta és la qüestió: una distància del cosinus de 0.31 i una puntuació BM25 de 14.2 no són a la mateixa escala ni ho seran mai, de manera que RRF fa servir l'única cosa que comparteixen les dues llistes: la posició. Aquesta és la implementació distribuïda, que val la pena llegir perquè de vegades hauràs de tornar a deduir-ne el comportament des dels principis bàsics quan la sortida fusionada et sorprengui.
# .venv/.../langchain_classic/retrievers/ensemble.py — EnsembleRetriever (abridged)
class EnsembleRetriever(BaseRetriever):
    retrievers: list[RetrieverLike]
    weights: list[float]
    c: int = 60
    id_key: str | None = None

    @model_validator(mode="before")
    @classmethod
    def _set_weights(cls, values: dict[str, Any]) -> Any:
        if not values.get("weights"):
            n_retrievers = len(values["retrievers"])
            values["weights"] = [1 / n_retrievers] * n_retrievers
        return values

    def weighted_reciprocal_rank(
        self, doc_lists: list[list[Document]]
    ) -> list[Document]:
        if len(doc_lists) != len(self.weights):
            msg = "Number of rank lists must be equal to the number of weights."
            raise ValueError(msg)

        rrf_score: dict[str, float] = defaultdict(float)
        for doc_list, weight in zip(doc_lists, self.weights, strict=False):
            for rank, doc in enumerate(doc_list, start=1):
                rrf_score[
                    doc.page_content
                    if self.id_key is None
                    else doc.metadata[self.id_key]
                ] += weight / (rank + self.c)

        all_docs = chain.from_iterable(doc_lists)
        # `_key` below stands for the same page_content-or-id_key ternary, which the
        # source inlines a third and fourth time here.
        return sorted(
            unique_by_key(all_docs, _key),
            reverse=True,
            key=lambda doc: rrf_score[_key(doc)],
        )
Dues coses que cal retenir abans de l'aritmètica. Primer, _set_weights: ometre completament weights no llança cap excepció; dona silenciosament 1/n a cada recuperador. És un bon valor predeterminat i una sorpresa terrible si et pensaves que havies configurat una preferència. Segon, la constant c = 60 és el terme d'amortiment, i és el motiu pel qual l'algoritme es comporta com ho fa. Amb c = 60, la posició 1 aporta w/61 i la posició 3 aporta w/63: una diferència d'aproximadament el 3%. Les posicions es tracten com si fossin gairebé igual de bones, de manera que ser present a totes dues llistes importa molt més que ser primer en una.
Fes els càlculs per al cas 50/50:
| Document | Posició BM25 | Posició vectorial | Puntuació RRF | Posició fusionada |
|---|---|---|---|---|
| doc A | 1 | absent | 0.5/61 = 0.00820 | empatat en 2a posició |
| doc B | 3 | 3 | 0.5/63 + 0.5/63 = 0.01587 | 1a |
| doc C | absent | 1 | 0.5/61 = 0.00820 | empatat en 2a posició |
Un document que és #3 a totes dues llistes supera un document que és #1 en una i falta a l'altra 01:59:58. És la propietat emergent a què es refereix la gent quan diu que l'híbrid «equilibra de manera natural la rellevància semàntica amb la precisió de paraules clau». No és màgia: és c = 60 fent que l'acord sigui barat i el desacord, car. (Els empats es resolen segons l'ordre en què sorted els troba: sorted és estable, i chain.from_iterable recorre les llistes de recuperadors per ordre de declaració; per tant, en un empat exacte guanya el primer recuperador de la llista. Un altre motiu pel qual l'ordre dels recuperadors no és cosmètic.)
Un parany subtil amagat en aquest codi: la clau de deduplicació predeterminada és doc.page_content, tot el text. Dos fragments amb text idèntic de fitxers font diferents es redueixen a un i les seves puntuacions se sumen. En canvi, si has passat els fragments per recuperació contextual (part 14) i cadascun porta un preàmbul lleugerament diferent escrit per un LLM, dues còpies del mateix fragment no es deduplicaran. Estableix id_key en un camp d'identificador de document estable de les metadades sempre que el corpus tingui identificadors reals, i observa que id_key es llegeix com doc.metadata[id_key], un accés directe per índex: per tant, un sol document sense aquest camp llança un KeyError a mitja fusió.
Construir-ho: tres components, tres línies
La construcció és realment petita 02:01:59: un recuperador vectorial que ja tens («el nucli de la comprensió semàntica»), un recuperador BM25 d'una línia i un conjunt que els fusiona. Instal·la primer el motor de paraules clau 02:02:59:
uv add rank-bm25
Les versions amb què s'ha verificat aquesta part, directament del pyproject.toml del repositori:
| Paquet | Versió fixada |
|---|---|
python | >=3.12 |
langchain | >=1.2.7 |
langchain-openai | >=1.1.7 |
langchain-chroma | >=1.1.0 |
langchain-community | >=0.4.1 |
rank-bm25 | >=0.2.2 |
langgraph | >=1.0.7 |
Ara el corpus, i aquí has de separar dues coses que la font difumina. El vídeo demostra la cerca híbrida sobre un corpus deliberadament adversari que barreja SKU, codis d'error, prosa sobre OAuth, configuració d'encaminadors i adreces IP, «per emular un cas d'ús real en què tens documents d'aquesta naturalesa» 02:02:59: aquest és el corpus darrere de la taula de resultats de cinc consultes següent, i el seu fitxer no és en cap repositori publicat. La demostració versionada s'executa sobre TECH_DOCS, vuit paràgrafs nets sobre Python, JavaScript, aprenentatge automàtic, LangChain, LangGraph, Docker, PostgreSQL i bases de dades vectorials, sense cap SKU ni codi d'error enlloc.
Construeix el teu com el del vídeo, no com el del repositori. Un corpus de prosa neta et dirà que la cerca híbrida no fa res, i t'estarà mentint: és el mateix parany que fa que la demostració de compressió sembli espatllada més endavant en aquesta part.
# production-course-main-code/advanced_rag.py — demo_ensemble_hybrid_search() (abridged)
from langchain_classic.retrievers import EnsembleRetriever
from langchain_community.retrievers import BM25Retriever


def demo_ensemble_hybrid_search():
    """Hybrid search combining keyword (BM25) and semantic search."""

    vectorstore = create_base_vectorstore()

    # BM25 keyword retriever
    bm25_retriever = BM25Retriever.from_documents(TECH_DOCS)
    bm25_retriever.k = 3

    # Semantic retriever
    semantic_retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

    # Ensemble combines both
    ensemble_retriever = EnsembleRetriever(
        retrievers=[bm25_retriever, semantic_retriever],
        weights=[0.4, 0.6],  # 40% keyword, 60% semantic
    )

    queries = [
        "ACID transactions",                                    # Keyword-heavy (BM25 helps)
        "How do I store AI model outputs for later retrieval?", # Semantic (vectors help)
        "fast similarity lookup for embeddings",                # Mixed
    ]

    for query in queries:
        bm25_results = bm25_retriever.invoke(query)
        semantic_results = semantic_retriever.invoke(query)
        ensemble_results = ensemble_retriever.invoke(query)

        print(f"BM25 top result: {bm25_results[0].page_content[:60]}...")
        print(f"Semantic top result: {semantic_results[0].page_content[:60]}...")
        print(f"Ensemble top result: {ensemble_results[0].page_content[:60]}...")
Observa la disciplina d'aquesta llista de consultes: cada consulta de prova està anotada amb la categoria que comprova. Predomini de paraules clau, semàntica, mixta. Aquest comentari no és decoratiu: és l'única manera de llegir la sortida i saber quin recuperador hauria d'haver guanyat, el requisit previ per ajustar pesos amb proves en lloc de gustos.
L'alternativa sense dependències
Com que la ruta d'importació és inestable i potser vols la fusió completament fora de LangChain, conserva un RRF de 20 línies al teu codi. És una reimplementació fidel de langchain_classic/retrievers/ensemble.py::weighted_reciprocal_rank: mateixa constant, mateixa acumulació, mateixa regla de deduplicació, sense dependència de cap framework.
RRF ponderat fet a mà (sense dependències)
# Reimplementation of langchain_classic/retrievers/ensemble.py::weighted_reciprocal_rank
# Same algorithm, same c=60. Use when the import path moves or you are not on LangChain.
from collections import defaultdict
from itertools import chain


def weighted_rrf(doc_lists, weights, c=60, id_key=None):
    """Fuse N ranked lists of Documents into one ranking.

    doc_lists: list of ranked lists, best-first.
    weights:   one float per list, positionally matched.
    c:         rank damping constant; larger => ranks matter less, consensus more.
    id_key:    metadata field to dedupe on; falls back to page_content.
    """
    if len(doc_lists) != len(weights):
        raise ValueError("Number of rank lists must equal the number of weights.")

    def key(doc):
        return doc.page_content if id_key is None else doc.metadata[id_key]

    scores = defaultdict(float)
    for doc_list, weight in zip(doc_lists, weights):
        for rank, doc in enumerate(doc_list, start=1):
            scores[key(doc)] += weight / (rank + c)

    seen, unique = set(), []
    for doc in chain.from_iterable(doc_lists):
        k = key(doc)
        if k not in seen:
            seen.add(k)
            unique.append(doc)

    return sorted(unique, key=lambda d: scores[key(d)], reverse=True)


# Usage — the ensemble is a LIST, not a pair. N retrievers, N weights.
fused = weighted_rrf(
    [bm25_retriever.invoke(q), vector_retriever.invoke(q)],
    weights=[0.5, 0.5],
)
El conjunt es generalitza a N branques, no només a dues:
«Si tinguéssim 10 recuperadors, això és una llista. Els hi podríem haver posat tots.» 02:05:03
Una tercera branca —un recuperador amb filtre de metadades, un segon model d'embeddings, un recuperador de grafs— costa una entrada més a retrievers i un nombre de coma flotant més a weights. L'única restricció que imposa el codi és que les dues llistes tinguin la mateixa longitud; tota la resta depèn del teu criteri.
Ajustar els pesos
weights és un control lliscant entre dos pols, i es correspon per posició amb retrievers.
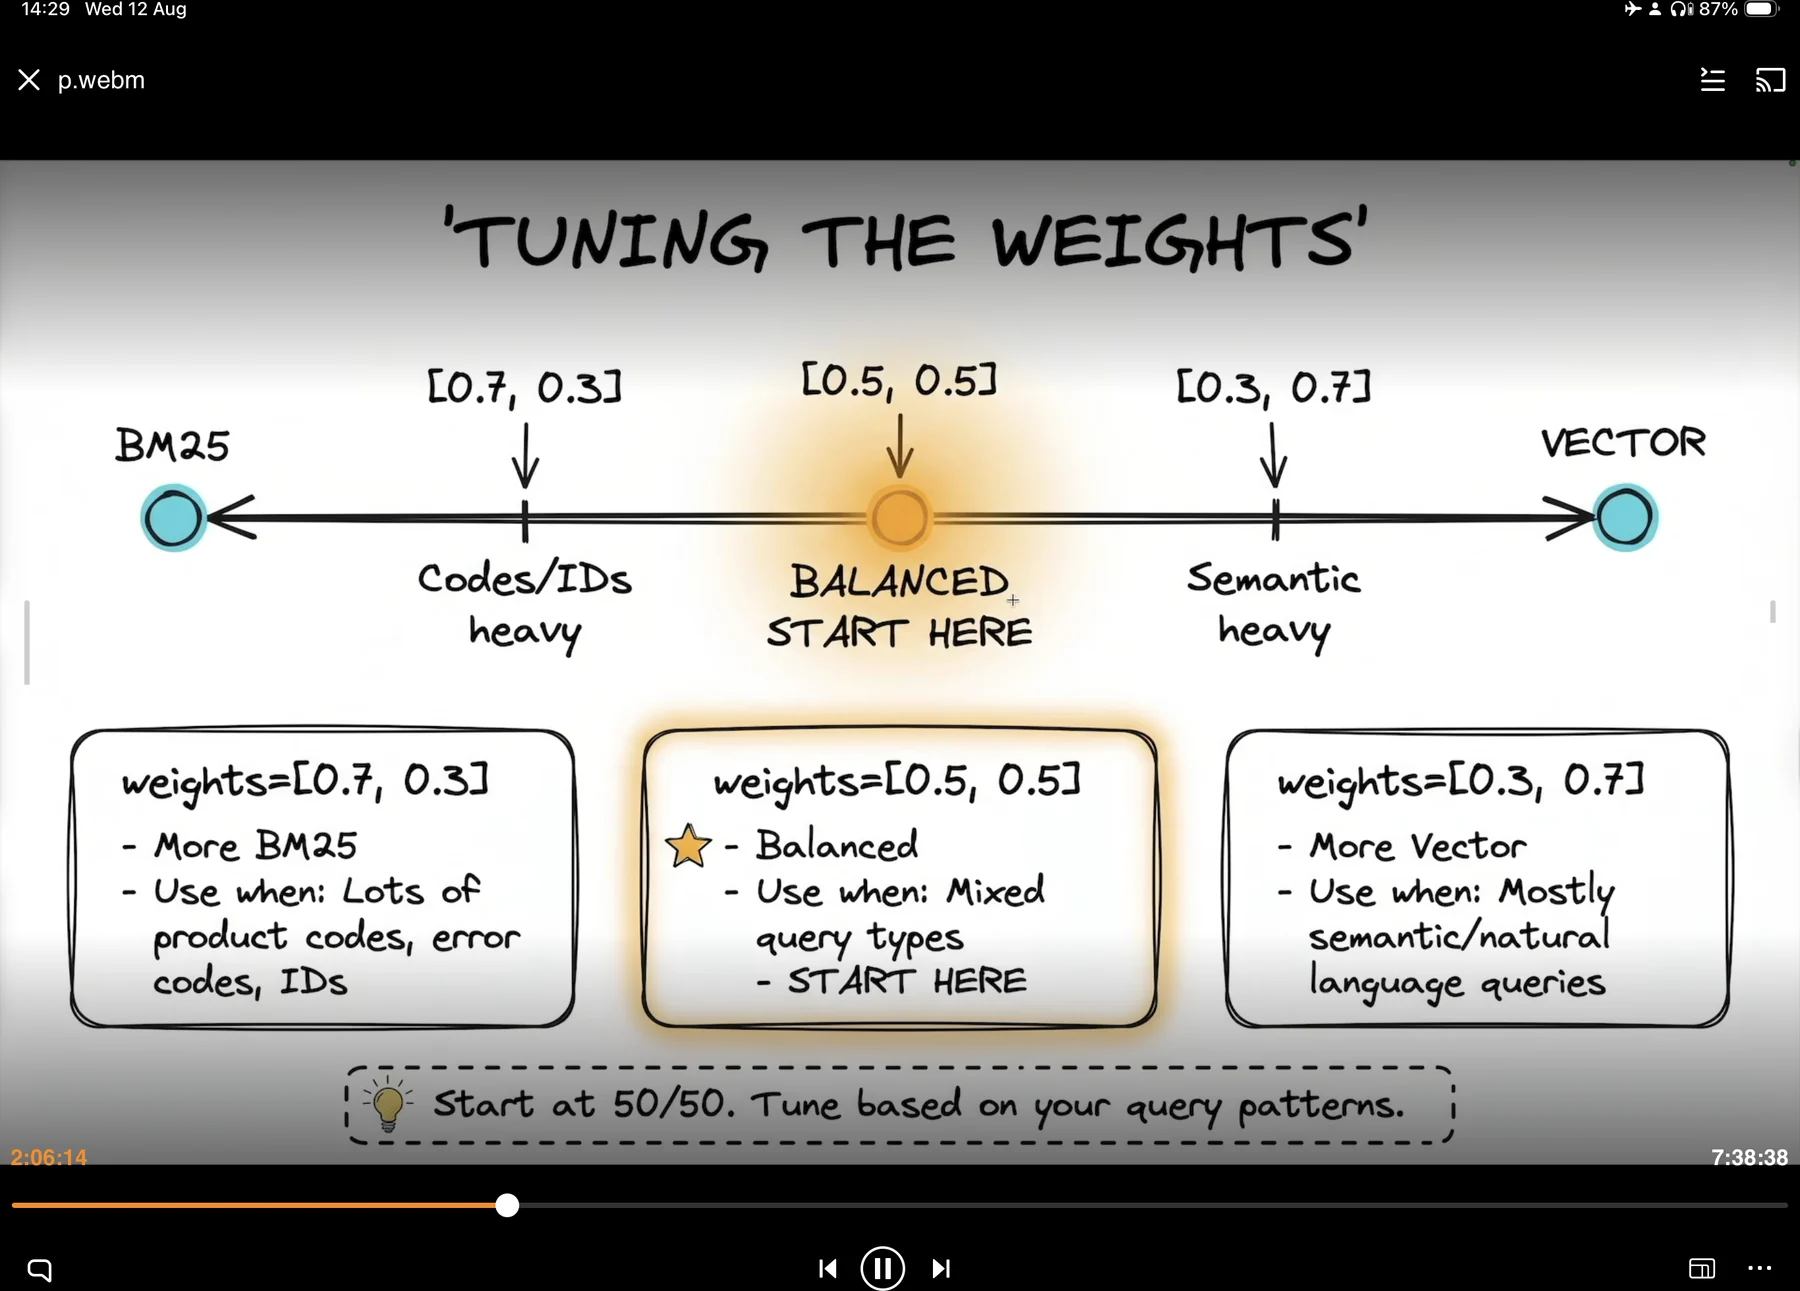
Pesos [bm25, vector] | Afavoreix | Quan fer-ho servir |
|---|---|---|
[0.7, 0.3] | Més BM25 | Molts codis de producte, codis d'error i identificadors |
[0.5, 0.5] | Equilibrat: COMENÇA AQUÍ ★ | Tipus de consulta barrejats; encara no has mesurat |
[0.3, 0.7] | Més vectorial | Sobretot consultes semàntiques / en llenguatge natural |
«Comença amb 50/50. Ajusta-ho segons els patrons de consulta.» — diapositiva 05
La font es contradiu sobre el valor inicial, i has de saber quin seguir. La diapositiva 05 i l'explicació diuen totes dues que comencis amb [0.5, 0.5] 02:05:03, 02:12:09. El advanced_rag.py versionat inclou [0.4, 0.6], que afavoreix la semàntica. Cap no és incorrecte: la diapositiva és el valor predeterminat pedagògic i el repositori és el resultat ajustat per un desenvolupador per a un corpus de vuit documents en prosa on BM25 té poc on agafar-se. Comença amb 50/50 i després modifica-ho.
Observa també què no fan els pesos. Són multiplicadors de w/(rank + 60), un terme que varia ~3% entre les primeres posicions d'una llista. Passar de [0.5, 0.5] a [0.7, 0.3] és una pertorbació molt més gran que moure un document de la posició 1 a la 3. Els pesos són una eina d'ajust gruixut; si el document adequat no és al conjunt de candidats de cap branca, cap pes no el rescata. Això és un problema de k, no de pesos.
L'entorn de comparació directa
No ajustes els pesos raonant. Els ajustes passant la mateixa consulta pels tres recuperadors i llegint quin situa el document adequat a la posició 1 02:06:04. Escriu això una vegada i reutilitza-ho per a tots els canvis de recuperació que facis:
# RECONSTRUCTED — the on-screen harness file is not in either published repo. The shape,
# the five queries and their category labels are transcribed from the walkthrough; the
# retriever APIs are the verified ones above. Bind the three retrievers however your code
# names them (in `advanced_rag.py` the vector branch is called `semantic_retriever`).
def test_query(retriever, query, name, n=3):
    docs = retriever.invoke(query)
    print(f"\n[{name}] {query}")
    for i, doc in enumerate(docs[:n], start=1):
        src = doc.metadata.get("source", "?")
        print(f"  {i}. ({src}) {doc.page_content[:80]}...")


QUERIES = [
    ("SKU-7742X specifications",  "product code"),
    ("E_CONN_REFUSED error",      "error code"),
    ("How do I authenticate?",    "semantic question"),
    ("WCAG compliance",           "acronym"),
    ("router configuration",      "config lookup"),
]

for query, category in QUERIES:
    print(f"\n===== {category.upper()} =====")
    test_query(bm25_retriever,     query, "BM25")
    test_query(vector_retriever,   query, "VECTOR")
    test_query(ensemble_retriever, query, "HYBRID")
El resultat d'executar exactament això al curs, sobre el corpus adversari del vídeo, amb cinc consultes en tres recuperadors 02:07:04–02:10:05:
| # | Consulta | Categoria | Vectorial | BM25 | Híbrid | Veredicte de l'instructor |
|---|---|---|---|---|---|---|
| 1 | SKU-7742X specifications | codi de producte | #1 correcte, #2/#3 relacionats | #1 correcte, després soroll (WCAG, document de l'encaminador) | #1 correcte | «el vectorial i l'híbrid han guanyat, més o menys» |
| 2 | error E_CONN_REFUSED | codi d'error | #1 correcte, #2 també bo, #3 una mica de soroll | #1 correcte, soroll de WCAG més avall | #1 correcte | «el guanyador clar… és el vectorial» |
| 3 | «Com m'autentico?» | pregunta semàntica | #1 correcte | ha fallat: el #1 era compliment de WCAG 2.1 | #1 correcte | «el vectorial i l'híbrid han guanyat» |
| 4 | WCAG compliance | acrònim | correcte | correcte (les paraules clau l'han encertat de ple) | correcte | «tots» |
| 5 | router configuration | consulta de configuració | #1 correcte | #1 correcte + un document de xarxes relacionat | #1 correcte | tots bé |
«El vectorial tendeix a entendre el significat, BM25 fa coincidir termes exactes i l'híbrid et dona el millor dels dos mons.» 02:10:05
Ara torna a llegir les consultes 1 i 2, perquè contenen la lliçó menys evident de la taula. Són les consultes de codi de producte i codi d'error —els casos exactes per als quals existeix l'híbrid—, i la cerca vectorial pura ha resolt totes dues. Per què? Perquè el corpus de demostració és un grapat de documents, de manera que SKU-7742X gairebé no tenia res amb què confondre's. El valor de la branca BM25 creix amb la mida del corpus, perquè la fallada que evita és que els veïns plausibles superin el document adequat en l'ordenació, i els veïns plausibles són precisament el que et dona l'escala (el precipici de 10 → 10,000 documents de la part 1). Una prova A/B híbrida sobre un corpus de joguina infraestimarà el benefici; executa-la amb dades de mida de producció abans de concloure res.
Quan afegir l'híbrid i quan no
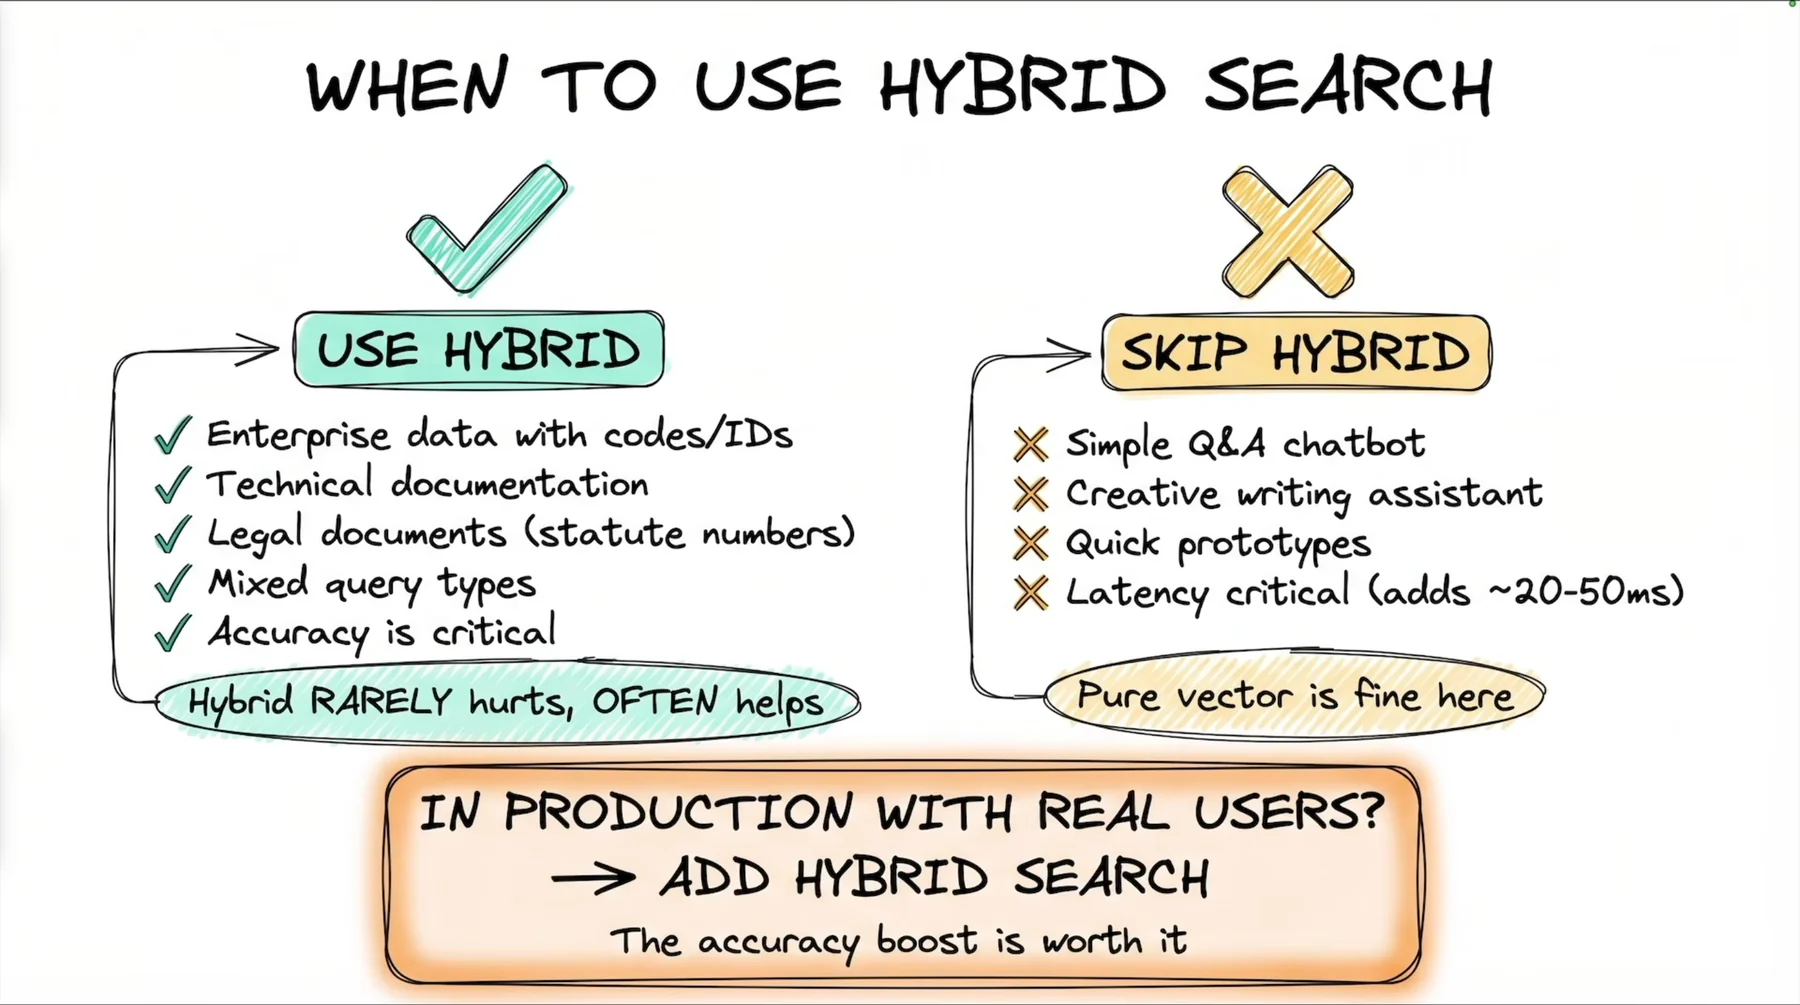
| Afegeix l'híbrid | Omet l'híbrid |
|---|---|
| Dades empresarials amb codis / identificadors | Xatbot senzill de preguntes i respostes (Q&A) |
| Documentació tècnica | Assistent d'escriptura creativa |
| Documents jurídics (números de normes) | Prototips ràpids |
| Tipus de consulta barrejats | Camins crítics de latència (afegeix ~20–50 ms) |
| La precisió és crítica | |
| «L'híbrid POQUES VEGADES perjudica, SOVINT ajuda» | «Aquí el vectorial pur ja està bé» |
«En producció amb usuaris reals? → Afegeix cerca híbrida. La millora de precisió val la pena.» — diapositiva 04, reiterat a 02:00:59
El cost de l'híbrid és temps, no correcció 02:00:59. Executes dues recuperacions en lloc d'una. Pressuposta ~20–50 ms i observa que això se suma a la crida d'embeddings, la cerca vectorial i, si les afegeixes, les crides de compressió i generació: els tres pressupostos de la part 1 sempre estan en tensió, i aquest gasta latència per comprar qualitat.
Consideracions de producció per a l'híbrid
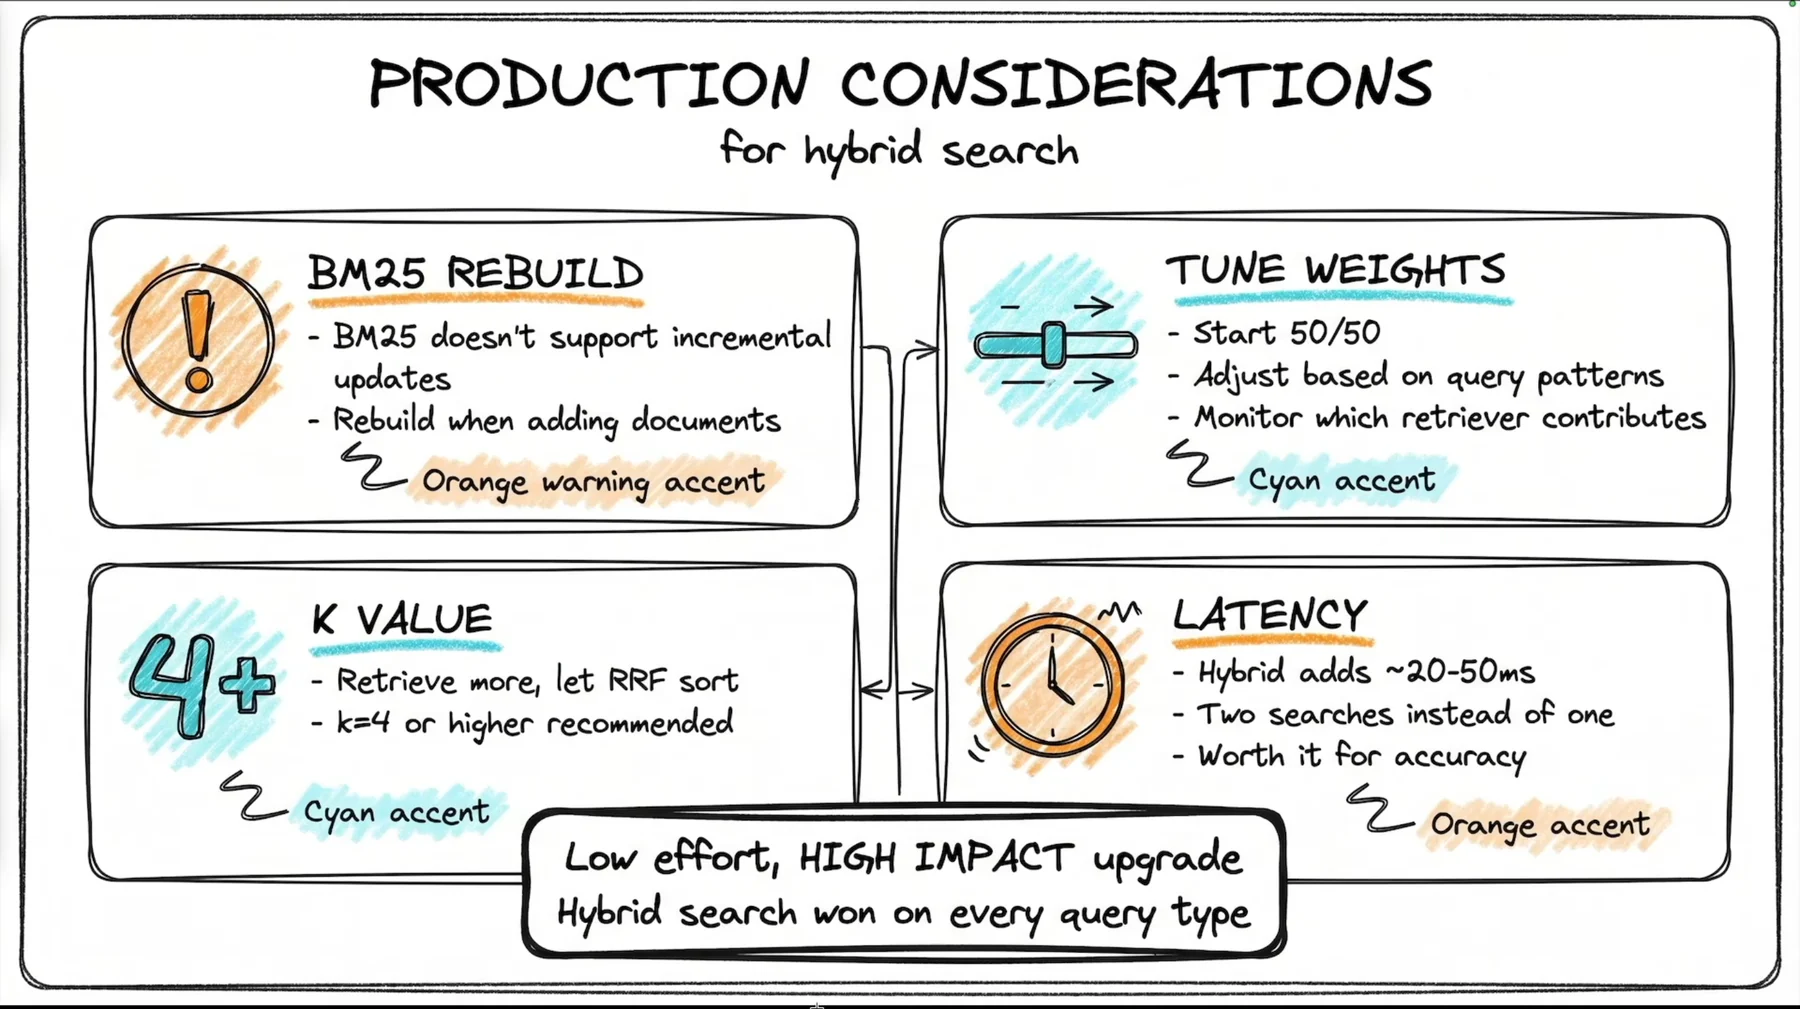
1. BM25 no té actualitzacions incrementals: aquest és el parany
L'instructor ho assenyala dues vegades, amb un minut de diferència, i ho precedeix de «molt, molt, molt important» 02:11:06, 02:12:09. No pots afegir elements a un índex BM25. El vectoritzador BM25Okapi calcula estadístiques de tot el corpus (freqüències de document, longitud mitjana de document, mínim d'idf) en el moment de la construcció. Afegir un document les invalida totes.
Per tant, la fallada té aquest aspecte: crides vector_store.add_documents(new_docs), tot té èxit, no es llança cap excepció i els documents nous són invisibles per a la branca de paraules clau per sempre. El recuperador híbrid es degrada lentament fins a ser un recuperador vectorial amb latència addicional, i la degradació és proporcional a quina part del corpus ha arribat després de l'arrencada. És l'exemple més pur de l'invariant 4 de tota aquesta guia.
La solució és estructural: fes impossible oblidar la reconstrucció posant totes dues escriptures darrere d'un sol mètode.
# The production skeleton described at [02:10:05]-[02:11:06]. The class name and method
# names are as spoken; the file shown on screen (hybrid_search/prod_hybrid_search.py) is
# NOT present in either published repo, so this is reconstructed from the walkthrough
# plus the verified APIs above. `weighted_rrf` is the fallback function from the toggle.
from langchain_chroma import Chroma
from langchain_openai import OpenAIEmbeddings
from langchain_community.retrievers import BM25Retriever


class HybridRetriever:
    def __init__(self, documents, collection_name="hybrid", k=4,
                 weights=(0.5, 0.5), embeddings=None):
        # Swappable: "you can change that to whatever you need"
        self.embeddings = embeddings or OpenAIEmbeddings(model="text-embedding-3-small")
        self.documents = list(documents)
        self.k = k
        self.weights = weights

        # No persist_directory => this Chroma collection is in-memory and dies with the
        # process, re-embedding the whole corpus on every boot. Pass one in production.
        self.vector_store = Chroma.from_documents(
            documents=self.documents,
            embedding=self.embeddings,
            collection_name=collection_name,
        )
        self.vector_retriever = self.vector_store.as_retriever(
            search_kwargs={"k": self.k}
        )
        self._build_bm25()

    def _build_bm25(self):
        """BM25 has no incremental update path — it is always rebuilt from scratch."""
        if not self.documents:          # from_documents unpacks a zip(*...) and
            self.bm25_retriever = None  # raises ValueError on an empty corpus
            return
        self.bm25_retriever = BM25Retriever.from_documents(self.documents, k=self.k)

    def search(self, query):
        if self.bm25_retriever is None:
            return self.vector_retriever.invoke(query)
        return weighted_rrf(
            [self.bm25_retriever.invoke(query), self.vector_retriever.invoke(query)],
            weights=list(self.weights),
        )

    def add_documents(self, docs):
        # Give every Document a stable `id`: langchain-chroma calls collection.upsert(),
        # so ids make a replayed ingest idempotent. Without them it mints a fresh UUID
        # per call and a re-run silently duplicates your corpus (the Part 4 rule).
        self.vector_store.add_documents(docs)   # incremental — cheap
        self.documents.extend(docs)
        self._build_bm25()                      # MANDATORY full rebuild — not cheap
L'asimetria d'add_documents és tota la lliçó, i és l'invariant 3 amb el signe invertit: l'escriptura del magatzem vectorial és incremental i barata, la de BM25 és O(corpus) i es repeteix en cada ingesta. Amb 1,000 documents ningú no se n'adona. Amb 500,000 documents, una ingesta que es dispara una vegada per minut passarà la major part de la vida tornant a tokenitzar el corpus, i self.documents és una còpia completa del text en memòria a més de la còpia del magatzem vectorial.
El camí de progressió, per ordre:
- Agrupa les reconstruccions. Acumula documents nous i reconstrueix BM25 de manera programada (cada N minuts / N documents) en lloc de fer-ho a cada crida. Accepta una finestra limitada de desactualització a la branca de paraules clau i deixa-la per escrit: és un contracte de correcció, no un detall d'implementació.
- Fes servir doble búfer. Construeix el nou
BM25Retrieveren una variable local i reassigna l'atribut només quan estigui complet, perquè les consultes concurrents mai no vegin un índex a mig construir. - Trasllada la cerca per paraules clau a la base de dades.
tsvector+ts_rankde Postgres, o el mode híbrid natiu de la base de dades vectorial, et dona un índex de paraules clau realment incremental i elimina tot aquest problema. És la millora de la part 10 (pgvector / Supabase), i aquest parany és el motiu principal per adoptar-la.
2. Valor de k: recupera amb amplitud, deixa que RRF restringeixi
k = 4 o superior és la recomanació, «i deixa que RRF ordeni tot això» 02:12:09; la diapositiva 06 ho condensa en «Recupera més, deixa que RRF ordeni.» La intuïció és mecànica: la fusió necessita candidats per conciliar. Amb k=1 o k=2 gairebé no hi ha res per fusionar i has pagat 20–50 ms per un efecte insignificant. Observa que a la demostració totes dues branques funcionen amb k=3, per sota del consell de la mateixa diapositiva: és acceptable amb vuit documents, però no amb vuitanta mil.
Una configuració raonable de producció: k=10–20 per branca cap a la fusió, i després conserva els 3–5 primers després de fusionar (i després del reranking, més avall). L'etapa de fusió és gairebé gratuïta; és la de generació la que et cobra per token.
3. Monitoritza quin recuperador contribueix
El panell «AJUSTA ELS PESOS» de la diapositiva 06 diu monitoritza quin recuperador contribueix, i aquest és l'únic element de la diapositiva sense codi enlloc del curs. Implementa'l tu mateix: són unes sis línies, i sense això «ajusta-ho segons els patrons de consulta» no es pot posar en pràctica:
# Attribution: for each query, log which branch supplied each surviving document.
def attribute(fused, bm25_docs, vector_docs, id_key=None):
    def key(d):
        return d.page_content if id_key is None else d.metadata[id_key]

    bm25_keys = {key(d) for d in bm25_docs}
    vector_keys = {key(d) for d in vector_docs}
    return [
        {
            "rank": i,
            "in_bm25": key(d) in bm25_keys,
            "in_vector": key(d) in vector_keys,
            "source": d.metadata.get("source"),
        }
        for i, d in enumerate(fused, start=1)
    ]
Incorpora-ho als logs estructurats (part 7) i podràs respondre cada setmana: quina fracció dels documents top-3 prové només de BM25? Si és ~0%, la branca de paraules clau és pes mort: o bé els pesos són incorrectes, o bé el tokenitzador es menja els codis, o bé realment no necessites l'híbrid. Si és el 30%, has quantificat la millora i tens les proves que justifiquen moure els pesos.
4. Latència
~20–50 ms, perquè fas dues cerques en lloc d'una. Les dues branques són independents i haurien de funcionar concurrentment: EnsembleRetriever.arank_fusion fa exactament això amb asyncio.gather, mentre que el rank_fusion síncron les executa en una simple comprensió de llista. Al camí síncron pagues la suma; a l'asíncron pagues el màxim. Fes servir ainvoke en qualsevol servei sensible a la latència.
«Millora de poc esforç i GRAN IMPACTE.» — diapositiva 06
Aquest distintiu és just. De tot el que hi ha en aquesta part, la cerca híbrida té la millor proporció entre línies de codi i qualitat recuperada —tres components, cap crida a l'LLM, cap regeneració d'embeddings—, sempre que facis bé la reconstrucció. Salta-te-la i l'esforç continuarà sent baix mentre l'impacte es torna negatiu.
Reranking: què promet la font i què proporciona
És hora de parlar clar. El curs anomena el reranking com a solució per al mode de fallada #3 a la taula inicial, i el README complementari l'inclou a «Part 3 — Optimize for Quality». Però no hi ha cap reranker enlloc de cap dels dos repositoris publicats. Cap cross-encoder, cap Cohere Rerank, cap CrossEncoderReranker: ni un sol punt de crida. El més a prop que hi arriba la font és una lliçó veïna que recomana combinar la recuperació contextual (part 14) amb la cerca híbrida BM25 «per obtenir els millors resultats». Tracta l'absència com un buit de la font, no com un senyal que el reranking sigui opcional: aquesta part et dona un entorn de mesura i un conjunt de candidats, i el reranking n'és la segona etapa estàndard.
És important que entenguis la distinció, perquè sovint es diu, erròniament, que RRF és reranking:
| Fusió de rangs (RRF) | Reranking (cross-encoder) | |
|---|---|---|
| Entrada | N llistes ordenades | 1 llista de candidats + la consulta |
| Veu la consulta? | No: només les posicions | Sí, conjuntament amb cada document |
| Model | Cap; aritmètica pura | Un model de rellevància entrenat |
| Cost | Microsegons | Una passada del model per candidat |
| Resol | Una branca no ha trobat el document | El document adequat s'ha recuperat, però ha quedat a la posició #7 |
Un bi-encoder (el teu model d'embeddings) codifica la consulta i el document per separat i compara els dos vectors: ràpid, indexable i amb pèrdua d'informació, perquè el vector del document s'ha calculat sense veure mai la consulta. Un cross-encoder introdueix (query, document) al model conjuntament i produeix una puntuació de rellevància. No es pot indexar; per tant, mai no pot ser el recuperador de primera etapa: és exclusivament una segona etapa sobre un conjunt petit de candidats.
L'entorn amb versions fixades ja inclou la maquinària, encara que el curs no la toqui mai:
# .venv/.../langchain_classic/retrievers/document_compressors/__init__.py
__all__ = [
    "CohereRerank",
    "CrossEncoderReranker",
    "DocumentCompressorPipeline",
    "EmbeddingsFilter",
    "FlashrankRerank",
    "LLMChainExtractor",
    "LLMChainFilter",
    "LLMListwiseRerank",
]
I el reranker són quatre línies de feina real: no té cap misteri:
# .venv/.../langchain_classic/retrievers/document_compressors/cross_encoder_rerank.py
class CrossEncoderReranker(BaseDocumentCompressor):
    """Document compressor that uses CrossEncoder for reranking."""

    model: BaseCrossEncoder
    top_n: int = 3

    def compress_documents(self, documents, query, callbacks=None):
        scores = self.model.score([(query, doc.page_content) for doc in documents])
        docs_with_scores = list(zip(documents, scores, strict=False))
        result = sorted(docs_with_scores, key=operator.itemgetter(1), reverse=True)
        return [doc for doc, _ in result[: self.top_n]]
Observa'n la forma: un reranker a LangChain és un BaseDocumentCompressor, de manera que encaixa en el mateix embolcall ContextualCompressionRetriever que l'extractor següent. És el truc de composició que fa intercanviable tota la família, i vol dir que afegir un reranker al pipeline híbrid que acabes de construir és un embolcall, no una reescriptura:
# Wiring a reranker over the hybrid retriever. NOTE: `HuggingFaceCrossEncoder` needs
# `sentence-transformers`, which the course's pinned environment does NOT install —
# `uv add sentence-transformers` first, and expect a model download on first run.
from langchain_classic.retrievers import ContextualCompressionRetriever
from langchain_classic.retrievers.document_compressors import CrossEncoderReranker
from langchain_community.cross_encoders import HuggingFaceCrossEncoder

reranked = ContextualCompressionRetriever(
    base_compressor=CrossEncoderReranker(
        model=HuggingFaceCrossEncoder(model_name="BAAI/bge-reranker-base"),  # the default
        top_n=3,
    ),
    base_retriever=ensemble_retriever,   # wide first stage: k=10-20 per branch
)
Dues coses que aquest fragment no amaga. El cross-encoder s'executa localment a la CPU tret que li proporcionis una GPU, de manera que el cost per candidat és latència que assumeixes tu en lloc d'una factura d'API: precisament per això importa el pressupost de k d'ampliar i després restringir. I CrossEncoderReranker es declara amb extra="forbid", de manera que un nom de camp mal escrit llança una excepció en construir-lo en lloc de ser ignorat silenciosament.
Com que el curs no et dona xifres de reranking, no n'inventis cap, i desconfia de qui te'n citi una sense anomenar el conjunt de dades. El que el curs sí que et dona és una aproximació més barata, basada en un LLM, de la mateixa idea, i això és dues seccions més avall.
Recuperació del document pare: cerca petit, retorna gran
Aquesta és la resposta del capítol a un dilema real que has trobat a la part 3 i no has pogut resoldre allà, perquè no es pot resoldre en el moment del chunking.
| Precisió de la cerca | Completesa del context de l'LLM | |
|---|---|---|
| Només fragments petits (200 caràcters) | Alta: embedding centrat, coincidència precisa | Baixa: fragmentat; «la resposta pot fer referència a alguna cosa del paràgraf anterior o següent» 02:53:17 |
| Només fragments grans (2,000 caràcters) | Baixa: embedding diluït; «coincidència menys precisa i pot passar per alt la millor coincidència» 02:54:18 | Alta |
| Document pare | Alta | Alta |
«Fragments petits per a la cerca i context gran, perquè els fragments petits estaran connectats al pare, que és un fragment gran.» 02:50:15
L'instructor ho introdueix amb el suport més contundent del capítol: «si et prens seriosament la qualitat de RAG, aquesta és la millora que més importa» 02:50:15. Pren-ho com a entusiasme més que com una mesura: a diferència de la prova A/B de chunking de la part 3, aquest patró no es compara mai amb un benchmark a la font. El que sí que es demostra és el mecanisme, i el mecanisme és sòlid.
El mecanisme són dos segmentadors i dos magatzems. Només es generen els embeddings dels fills i s'indexen aquests; els pares són en un magatzem simple clau→document i s'obtenen per identificador després de la cerca. La feina del fill és que es pugui trobar; la del pare és que es pugui llegir.
# production-course-main-code/advanced_rag.py — demo_parent_document_retriever() (abridged)
from langchain_classic.retrievers import ParentDocumentRetriever
from langchain_classic.storage import InMemoryStore

# Splitters
parent_splitter = RecursiveCharacterTextSplitter(chunk_size=800, chunk_overlap=100)
child_splitter = RecursiveCharacterTextSplitter(chunk_size=200, chunk_overlap=20)

# Storage
vectorstore = Chroma(
    collection_name="parent_child_demo",
    embedding_function=OpenAIEmbeddings(model="text-embedding-3-small"),
)
store = InMemoryStore()

# Create retriever
retriever = ParentDocumentRetriever(
    vectorstore=vectorstore,
    docstore=store,
    child_splitter=child_splitter,
    parent_splitter=parent_splitter,
)

# Add document — this does the splitting AND both writes
retriever.add_documents([long_doc])

query = "What is LangGraph used for?"

# Regular retrieval (would get small chunks)
child_docs = vectorstore.similarity_search(query, k=1)
print("\n--- Child Chunk (what search found) ---")
print(f"Length: {len(child_docs[0].page_content)} chars")

# Parent retrieval (gets full context)
parent_docs = retriever.invoke(query)
print("\n--- Parent Chunk (what's returned) ---")
print(f"Length: {len(parent_docs[0].page_content)} chars")
Sobre el document de demostració (ai_agents_guide.md, una guia Markdown amb capítols ##) i la consulta «Per a què es fa servir LangGraph?», el fragment fill amb què ha coincidit la cerca tenia 173 caràcters i el pare retornat a l'LLM en tenia 675 02:52:16– 02:53:17. Mostrar-los tots dos de costat és el que fa comprensible el mecanisme: fes-ho una vegada al teu pipeline i no els tornaràs a confondre mai més.
Tres coses més que et diu el codi distribuït i que l'explicació no et diu:
- L'enllaç és un camp de metadades.
ParentDocumentRetrieveresténMultiVectorRetriever, amb unid_keypredeterminat de"doc_id", iadd_documentsestampa_doc.metadata[self.id_key] = _ida cada fill abans d'indexar. Per tant, la recuperació és: cercar fills → recollir-ne elsdoc_id→docstore.mget(ids). Aquest camp també és el teuid_keynatural per a la deduplicació RRF si poses la recuperació de documents pare darrere d'un conjunt híbrid. parent_splitterés opcional. Omet-lo i, segons la docstring del mateix camp, «els documents pare seran els documents originals que s'hagin passat»: és a dir, l'LLM rep tot el document font. És una bona tria per a documents curts i una catàstrofe per a la finestra de context amb documents llargs.InMemoryStoreés una drecera de demostració 02:51:15, triada, en paraules de l'instructor, «per no haver de complicar-nos gaire». Els pares desapareixen en sortir del procés mentre una col·lecció Chroma persistent es conserva, cosa que et deixa un índex ple de fills orfes ambdoc_idque no apunten a res. En producció cal un magatzem de documents durador (un magatzem de fitxers, Redis o una tauladocumentsamb claudoc_id).
El cost del patró és l'emmagatzematge: conserves els pares i els fills. La taula comparativa de tècniques d'un capítol posterior (fcc-production-rag-part-6/03_late_chunking.py:351) puntua pare-fill amb ★★★ en qualitat de context i ★★☆ en emmagatzematge, explicitant la penalització com 2× magatzem vectorial. L'exercici que assigna l'instructor és l'adequat: «busqueu documents potser més grans i proveu-ho» 02:54:18; amb el document diminut de demostració, el benefici només és indicatiu, i no hauries d'adoptar un cost d'emmagatzematge de 2× sobre la base d'un indici.
Compressió contextual: pagar en recuperar per estalviar en generar
La recuperació del document pare fa el context més gran. La compressió el fa més petit. No són contradictòries: actuen sobre problemes diferents. El document pare resol fragments incomplets; la compressió resol el farciment.
La compressió contextual és extracció, no resum 02:55:18. Cada fragment recuperat s'envia a un LLM amb la consulta, i el model retorna només els trams que la responen. Pots llegir el prompt exacte al paquet instal·lat, i resol definitivament la pregunta de «parafraseja?»:
# .venv/.../langchain_classic/retrievers/document_compressors/chain_extract_prompt.py
# (the first paragraph is one long line in the source; wrapped here to fit the page)
prompt_template = """Given the following question and context, extract any part of the
context *AS IS* that is relevant to answer the question. If none of the context is
relevant return {no_output_str}.

Remember, *DO NOT* edit the extracted parts of the context.

> Question: {{question}}
> Context:
>>>
{{context}}
>>>
Extracted relevant parts:"""
{no_output_str} s'emplena amb NoOutputParser.no_output_str, la cadena literal "NO_OUTPUT"; l'analitzador converteix aquesta resposta en una cadena buida i LLMChainExtractor.compress_documents omet qualsevol document amb una sortida de longitud zero. Per tant, la compressió és alhora un extractor i un filtre: els fragments irrellevants no tornen més curts, sinó que no tornen.
La connexió és un decorador sobre qualsevol recuperador:
# production-course-main-code/advanced_rag.py — demo_contextual_compression() (abridged)
from langchain_classic.retrievers import ContextualCompressionRetriever
from langchain_classic.retrievers.document_compressors import LLMChainExtractor

vectorstore = create_base_vectorstore()
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# Create compressor
compressor = LLMChainExtractor.from_llm(llm)

# Wrap retriever with compression
compression_retriever = ContextualCompressionRetriever(
    base_compressor=compressor,
    base_retriever=vectorstore.as_retriever(search_kwargs={"k": 4}),
)

query = "What frameworks exist for building LLM applications?"

# Without compression
base_docs = vectorstore.as_retriever(search_kwargs={"k": 2}).invoke(query)
for doc in base_docs:
    print(f"Length: {len(doc.page_content)} chars")

# With compression
compressed_docs = compression_retriever.invoke(query)
for doc in compressed_docs:
    print(f"Length: {len(doc.page_content)} chars")
És fàcil passar per alt dues asimetries d'aquest fragment, i totes dues importen. La base funciona amb k=2 i el camí comprimit amb k=4, de manera que les llistes d'«abans» i «després» no són els mateixos documents: és una demostració, no una comparació controlada. I com que rep un base_retriever, ContextualCompressionRetriever es compon sobre qualsevol cosa: conjunts híbrids, multiconsulta, document pare. Aquesta única decisió de disseny és el motiu pel qual el reranker anterior té la mateixa interfície.
La demostració que semblava espatllada i per què aquesta lliçó és la valuosa
Primera execució, sobre el corpus net TECH_DOCS: 203 → 203 caràcters i 245 → 243 caràcters 02:57:22. Pràcticament no ha passat res.
«Pot semblar que no ha funcionat. Sí que ha funcionat… les dades de prova que tenim ja són força netes i rellevants.» 02:57:22–02:58:24
Si cada fragment recuperat ja és 100% pertinent, no hi ha res per comprimir. És el resultat negatiu més útil del capítol, perquè et diu exactament quan la compressió es guanya el seu cost i quan és pur cost. Els fragments curts i temàticament purs —la sortida natural d'un bon chunking recursiu sobre documentació ben estructurada— no tenen farciment per eliminar.
Observa el volum de crides mentre ho executes. La demostració fa dues crides al recuperador —la base k=2 i el camí comprimit k=4—, per tant dos embeddings de consulta, i després una generació per fragment retornat pel recuperador comprimit. L'instructor les compta al terminal a 02:56:20, però els subtítols en desfiguren el recompte; per tant, extreu-lo del codi i no de l'àudio: compress_documents recorre la llista de candidats exactament una vegada, un invoke per document. La compressió és la primera tècnica d'aquesta guia en què el recuperador deixa de ser matemàtica vectorial pura i comença a costar inferència.
Per fer-ho visible, va escriure INFO_BURIED: dos documents llargs —acme_company_overview.pdf i technical_docs_v2.4.pdf— on un parell de paràgrafs rellevants queden enterrats en història de l'empresa (fundada el 2018, garatge de Palo Alto, oficines a Austin i Seattle, ingressos de $2M → $45M, sèrie B amb una valoració de $500M, assegurança mèdica Aetna) i detalls d'infraestructura (AWS EKS, Istio, DataDog, RTO de 4 hores, RPO d'1 hora). Dos paràgrafs —un sobre LangChain, un sobre LangGraph— responen realment la consulta. Després va apuntar la fàbrica del magatzem vectorial a INFO_BURIED en lloc de TECH_DOCS i no va canviar res més.
Segona execució: 1,703 caràcters → 214 caràcters, i un segon document de «més de 1,500» caràcters es redueix de manera semblant. Ho anomena «aproximadament del 87 al 82% de reducció» 03:00:26, citant l'interval al revés; 1,703→214 és ≈87.4%, i el segon és ≈82%. Després ho resumeix com «85% menys tokens al prompt final» 03:01:29. Totes tres xifres són la mateixa mesura sobre un document de demostració construït a mà, no un benchmark: considera-les orientatives.
El que ha desaparegut és tan instructiu com el percentatge: abans de comprimir, el context contenia la història fundacional, les ubicacions de les oficines i tot el capítol d'arquitectura AWS; després només han sobreviscut els paràgrafs de LangChain i LangGraph 03:00:26. L'extractor s'ha comportat exactament com indiquen les instruccions del prompt: ha llegit cada fragment, s'ha preguntat «què hi ha aquí que respongui quins frameworks existeixen per construir aplicacions amb LLM?» i ha retornat aquells trams literalment.
Els tres beneficis declarats 03:01:29–03:02:31, amb un balanç honest de cadascun:
| Benefici | Mecanisme | La contrapartida |
|---|---|---|
| Menys cost | ~85% menys tokens de context al prompt de generació | Gastes tokens d'LLM en recuperar per estalviar-ne en generar |
| Respostes millors | Menys soroll; «cap risc que l'LLM es distregui amb la història de l'empresa o els detalls d'infraestructura» | Només és cert quan hi havia soroll |
| Més ràpid | Context més petit → inferència més ràpida, «especialment perceptible amb documents més grans» | Has afegit un intercanvi amb l'LLM per fragment recuperat abans de generar |
Aquesta última contrapartida és tot el compromís, exposat clarament a 03:02:31: «crides addicionals a la generació… cosa que significa cost d'LLM en el moment de la recuperació.» Amb k=4 fas quatre crides addicionals a l'LLM per consulta d'usuari. compress_documents les executa en un bucle for en sèrie al camí síncron; acompress_documents fa servir llm_chain.abatch, de manera que el camí asíncron és molt més ràpid amb la mateixa despesa. Fes servir ainvoke.
Les tres condicions en què la compressió val la pena 03:02:31:
- Els documents són grans i amb contingut barrejat.
- Necessites una recuperació precisa i centrada.
- Els costos de tokens importen a escala.
Inverteix-ho i obtindràs la regla per ometre-la: fragments petits i nets, camí sensible a la latència, poc volum → no comprimeixis.
Un mode de fallada del qual t'has de protegir: si l'extractor retorna NO_OUTPUT per a tots els candidats, el recuperador retorna zero documents i la cadena formata una cadena de context buida. L'LLM respon aleshores des de la memòria paramètrica tret que el prompt tingui la clàusula de reserva de la part 1. Prova sempre el camí de context buit.
Multiconsulta: corregeix la consulta, no l'índex
La cerca híbrida resol consultes amb tokens inadequats per a un índex vectorial. La multiconsulta resol consultes amb una formulació inadequada: una pregunta d'usuari es converteix en N reformulacions, es recuperen resultats per a cadascuna i es deduplica la unió 03:06:38. La deduplicació no és gestió administrativa: és on apareix el valor, perquè un document que aflora per a tres formulacions diferents de la pregunta és un document en què coincideixen tres comprovacions independents.
Això també respon la pregunta que tothom fa quan veu el constructor: per què un *recuperador* necessita un argument llm=? 03:07:39 Perquè generar les variacions és una crida a l'LLM. La multiconsulta és el primer recuperador d'aquesta part que costa una generació abans de tocar l'índex.
El prompt de generació tampoc no és cap misteri: és una constant del paquet:
# .venv/.../langchain_classic/retrievers/multi_query.py
DEFAULT_QUERY_PROMPT = PromptTemplate(
    input_variables=["question"],
    template="""You are an AI language model assistant. Your task is
    to generate 3 different versions of the given user
    question to retrieve relevant documents from a vector  database.
    By generating multiple perspectives on the user question,
    your goal is to help the user overcome some of the limitations
    of distance-based similarity search. Provide these alternative
    questions separated by newlines. Original question: {question}""",
)
Tres variacions, fixades al codi de la plantilla predeterminada: d'aquí ve el «3» de l'explicació, no d'un paràmetre. Passa el teu propi prompt= per canviar-ho. La sortida s'analitza amb LineListOutputParser, que divideix per salts de línia i elimina línies buides; per tant, un model que respongui amb una llista numerada et donarà variacions amb prefixos 1. , 2. : innocu per a la recuperació, lleig als logs.
# production-course-main-code/advanced_rag.py — demo_multi_query_retriever() (abridged)
from langchain_classic.retrievers.multi_query import MultiQueryRetriever

# Enable logging to see multi-query generation  (module top, lines 25-27)
logging.basicConfig(level=logging.INFO, format="%(name)s - %(message)s")
logging.getLogger("langchain.retrievers.multi_query").setLevel(logging.INFO)

vectorstore = create_base_vectorstore()
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.3)

# Create multi-query retriever
retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(search_kwargs={"k": 2}), llm=llm
)

query = "What tools can I use to build AI applications?"
print("(Check INFO logs above for generated queries)\n")

docs = retriever.invoke(query)
print(f"Retrieved {len(docs)} unique documents:")
Punts que convé interioritzar:
temperature=0.3, no 0. Vols variació a les reformulacions. És un dels pocs llocs de tota la guia on una temperatura diferent de zero és el valor predeterminat correcte.- Has d'activar el registre INFO per veure les reescriptures 03:04:38. Per defecte són invisibles, cosa que vol dir que pagues per l'expansió de consultes sense poder veure si les expansions són raonables. Això és inacceptable en producció.
- El cost és de N crides d'embeddings més una generació per consulta d'usuari. Amb tres variacions, l'execució ha fet tres crides a l'endpoint d'embeddings i ha retornat 3 documents únics 03:08:40. El
k=2per variació implica fins a 6 resultats reduïts a 3 després de deduplicar. - La deduplicació és igualtat exacta d'objectes.
_unique_documentsés[doc for i, doc in enumerate(documents) if doc not in documents[:i]]: una comparació deDocument, de manera que text idèntic amb metadades diferents es conserva com dues entrades. Combina-ho amb documents pare o un carregador que afegeixi metadades i pots acabar amb gairebé duplicats al context. include_originalté un valor predeterminat deFalse. La pregunta literal de l'usuari no és entre les consultes per a les quals es recuperen resultats tret que ho demanis. Si els usuaris escriuen consultes tècniques precises, estableixinclude_original=True; altrament hauràs substituït la seva formulació exacta per una paràfrasi d'un LLM, que és precisament el queRunnablePassthroughexisteix per evitar a la meitat de generació de la cadena.
La multiconsulta és una eina d'exhaustivitat: existeix per fer entrar el document adequat al conjunt de candidats. Combina-la amb una eina de precisió (compressió o un reranker) o simplement hauràs fet el context més sorollós.
Compondre la pila
Totes les tècniques d'aquesta part reben un BaseRetriever i retornen un BaseRetriever, de manera que es poden imbricar. La demostració més avançada del repositori n'apila dues:
# production-course-main-code/advanced_rag.py — demo_advanced_rag_chain() (abridged)
vectorstore = create_base_vectorstore()
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# Multi-query for better recall
multi_retriever = MultiQueryRetriever.from_llm(
    retriever=vectorstore.as_retriever(search_kwargs={"k": 3}), llm=llm
)

# Compression to focus on relevant info
compressor = LLMChainExtractor.from_llm(llm)
advanced_retriever = ContextualCompressionRetriever(
    base_compressor=compressor, base_retriever=multi_retriever
)

prompt = ChatPromptTemplate.from_template(
    """
Answer the question based on the following context. Be specific and cite which technologies you're referring to.

Context:
{context}

Question: {question}

Answer:"""
)

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

rag_chain = (
    {"context": advanced_retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
Primer exhaustivitat, precisió al final. La multiconsulta amplia (3 variacions × k=3 → fins a 9 candidats), la compressió restringeix. Invertir l'ordre comprimiria documents que estàs a punt de descartar: malbaratament pur.
Fes els càlculs abans de posar això en producció, perquè la composició és on marxen els diners. Una pregunta d'usuari que passa per aquesta cadena costa: 1 generació (generació de consultes) + 3 crides d'embeddings + 3 cerques vectorials + fins a 9 generacions (una per candidat supervivent, en sèrie) + 1 generació (la resposta). Són fins a 11 intercanvis amb l'LLM per una pregunta. És una arquitectura legítima per a una eina interna de poc volum i alt valor, i una d'òbviament equivocada per a un xatbot públic. La part 9 —que tracta tant el pressupost de tokens que rebutja una petició abans de gastar tot això com les memòries cau que impedeixen pagar dues vegades— existeix exactament per a aquesta cadena.
Aquesta és la regla d'ordre generalitzada:
| Etapa | Tècnica | Direcció | Cost |
|---|---|---|---|
| 1 | Expansió de consultes (multiconsulta) | Ampliar | 1 crida a l'LLM + N embeddings |
| 2 | Recuperació híbrida (vectorial + BM25 → RRF) | Ampliar | ~20–50 ms, 1 embedding |
| 3 | Filtre de metadades | Restringir | Gratuït (al costat de l'índex) |
| 4 | Reranking (cross-encoder) | Restringir | 1 passada del model per candidat |
| 5 | Compressió / extracció | Restringir | 1 crida a l'LLM per fragment supervivent |
| 6 | Expansió al pare (consulta al magatzem de documents) | Ampliar (deliberadament) | 1 lectura clau-valor per resultat |
L'expansió al pare va al final expressament: vols seleccionar sobre fills centrats i després lliurar a l'LLM pares sencers. Seleccionar sobre els pares anul·la tot el patró.
Citacions: fer que la resposta es pugui auditar
Una qualitat de recuperació que l'usuari no pot verificar és una afirmació, no un resultat. La cadena de confiança de la part 1 —fonts → citacions → verificabilitat → confiança— reformula la precisió com a auditabilitat: la feina del sistema és fer que comprovar sigui barat, no que se'l creguin.
El que sorprèn és el poc codi que cal. Comparades amb la cadena RAG bàsica, les citacions són un canvi de prompt i un canvi de formatador, res més 03:09:42–03:11:49.
L'acompanya una petita refactorització, feta en directe i conservada al repositori: l'LLM es treu de les funcions de demostració i es porta a nivell de mòdul —llm = init_chat_model(model="gpt-4o-mini", temperature=0.2) a la línia 58— perquè totes les cadenes del fitxer comparteixin un client 03:09:42. És menor, però és la forma que vols: una declaració de model per mòdul, la mateixa disciplina que l'invariant 2 exigeix al model d'embeddings.
# production-course-main-code/rag_pipeline.py — demo_rag_with_sources()
def demo_rag_with_sources():

    vectorstore = create_kb()
    retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

    prompt = ChatPromptTemplate.from_template(
        """
Answer the question based on the context below. Include which sources you used.

Context:
{context}

Question: {question}

Answer (include sources):"""
    )

    def format_docs_with_sources(docs):
        formatted = []
        for i, doc in enumerate(docs):
            source = doc.metadata.get("source", "unknown")
            formatted.append(f"[{i+1}] {source}:\n{doc.page_content}")
        return "\n\n".join(formatted)

    rag_chain = (
        {
            "context": retriever | format_docs_with_sources,
            "question": RunnablePassthrough(),
        }
        | prompt
        | llm
        | StrOutputParser()
    )

    answer = rag_chain.invoke("What are the core components of LangChain?")
Tres detalls sostenen tot el patró:
- Les fonts viatgen *dins* de la cadena de context.
format_docs_with_sourcesafegeix a cada fragment el prefix[n] <source>:abans del text. El model no rep mai metadades per un canal separat: llegeix l'etiqueta de citació com a part del document, i per això la pot reproduir.doc.metadata.get("source", "unknown")és la forma defensiva; unKeyErroraquí faria fallar la petició per una etiqueta absent. - L'espai de sortida fa la petició.
Answer (include sources):fa tanta feina com la frase d'instrucció que té a sobre. Els models completen la forma que els dones. - L'esquelet de la cadena no canvia.
{"context": retriever | formatter, "question": RunnablePassthrough()} | prompt | llm | StrOutputParser(): idèntic a la cadena bàsica de la part 5, idèntic a la cadena avançada anterior.
«La mecànica sempre és la mateixa. El que canvia són potser algunes coses.» 03:11:49
Aquesta és la lliçó estructural de tota aquesta part. L'híbrid, la multiconsulta, la compressió, el document pare i les citacions són cinc modificacions diferents d'una de les sis posicions d'aquesta expressió. Res més no es mou.
A l'execució, la resposta ha tornat amb els cinc components principals de LangChain —models, prompts, cadenes, agents i memòria— citant langchain_knowledge_base.md, el source estampat al document a create_kb():
# production-course-main-code/rag_pipeline.py — create_kb()
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
doc = Document(
    page_content=KNOWLEDGE_BASE, metadata={"source": "langchain_knowledge_base.md"}
)
chunks = splitter.split_documents([doc])
split_documents propaga aquestes metadades a tots els fragments. Si el codi hagués fet servir split_text, la font s'hauria destruït durant el chunking i cap enginyeria de prompts no l'hauria pogut recuperar. La possibilitat de citar es decideix en el moment de la indexació: la mateixa regla que la possibilitat de filtrar de la part 4.
«Si construïu un bot de preguntes i respostes (Q&A), tenir aquesta citació aquí és molt important.» 03:11:49
El motiu que dona és de producte: una citació permet a l'usuari clicar-hi i veure d'on prové realment la informació.
Els límits de les citacions basades en el prompt
Tingues clar què has construït: la citació és text generat. El model copia una etiqueta que ha llegit al prompt, i els models copien malament, fusionen i inventen etiquetes. Res d'aquest patró no imposa que [2] correspongui al document que realment sustentava la frase.
Dues maneres de reforçar-ho, totes dues amb codi que ja tens:
- Retorna els documents recuperats juntament amb la resposta, perquè la interfície enllaci als objectes reals dels fragments en lloc d'analitzar la prosa del model. Construeix la cadena amb
RunnableParallel—ja importat arag_pipeline.py— i conserva la brancadocs. - Demana estructura en lloc de prosa. El mateix fitxer del repositori ja ho fa, i el camp
sources_usedes pot comprovar automàticament: pots verificar amb una asserció que cada font retornada apareix al conjunt recuperat i marcar la petició quan no sigui així:
# production-course-main-code/rag_pipeline.py — demo_structured_rag()
# (RAGResponse is declared inside the demo function in the repo)
class RAGResponse(BaseModel):
    """Structured RAG response."""

    answer: str = Field(description="The answer to the question")
    confidence: str = Field(description="high, medium, or low")
    sources_used: List[str] = Field(description="List of sources referenced")
    follow_up: str = Field(description="Suggested follow-up question")

structured_llm = llm.with_structured_output(RAGResponse)
Observa que confidence és l'autodeclaració del model tipada com una cadena lliure, no una probabilitat calibrada ni tan sols una enumeració restringida. És un senyal útil per ordenar la revisió humana i no val res com a garantia de correcció: continua vigent la regla de la part 1, coherència no és correcció, i confiança tampoc.
Dos paranys de citació que arrosseguem de la part 2 i que aquí tenen més impacte:
pages'indexa des de 0,page_labelés una cadena indexada des d'1. Citapagei totes les citacions del producte tindran un desfasament d'una pàgina.- Els documents carregats des de rutes
tempfileporten metadadessourceinútils.create_kb()fa servirtempfile.mkdtemp()per al directori de persistència de Chroma (correcte, és emmagatzematge), però si mai carregues documents des de rutes temporals, la font que cites és una ruta que ja no existeix. Carrega des de rutes estables sempre que vulguis citar.
Procedència: què està verificat i què no
Aquesta part es basa en un capítol amb subtítols generats automàticament i un repositori que no coincideix amb el vídeo en diversos punts. Tot el que hi ha més amunt s'ha contrastat amb el codi distribuït quan aquest existeix. Això és el que no ho està.
Discrepàncies assenyalades i detalls no verificats
hybrid_search/prod_hybrid_search.py: el fitxer en pantalla durant tota l'explicació de l'híbrid 02:02:59 no existeix en cap dels dos repositoris publicats (production-course-main-code,fcc-production-rag-part-6). El codi real més proper, i la font de tots els fragments híbrids anteriors, ésproduction-course-main-code/advanced_rag.py::demo_ensemble_hybrid_search(). El corpus de SKU / codis d'error i la taula de resultats de cinc consultes provenen d'aquest fitxer absent, no delTECH_DOCSdel repositori.- La classe
HybridRetriever02:10:05 s'esmenta oralment i no es mostra mai. Els noms de mètodesearch()iadd_documents()són tal com es narren; l'esquelet anterior és una reconstrucció basada en API verificades, no una transcripció. chunking/semantic_chunking.pyichunking/production_ready.py: també en pantalla, també absents de tots dos repositoris. Pertanyen a un tercer repositori («Part 3 — Optimize for Quality»). Rellevant per a la part 3, no per a aquesta, però és el mateix patró d'artefactes absents.XR9000: s'esmenta una vegada com a segon codi de producte 01:53:47, sense corroboració a cap diapositiva; la diapositiva 02 mostra distractors diferents (Toaster X-500, Tool-88, Per-98, Shoe-99). Només il·lustratiu.[0.5, 0.5]o[0.4, 0.6]: la diapositiva i l'explicació diuen el primer; el codi versionat inclou el segon. Conciliat més amunt: comença amb 50/50.- «L'híbrid ha guanyat en tots els tipus de consulta» (diapositiva 06) contra l'explicació, on es declara repetidament el vectorial com a guanyador clar i l'híbrid empata. Conciliat més amunt: l'híbrid no ha estat mai pitjor.
- «Del 87 al 82% de reducció» 03:00:26 es cita de més a menys; les mesures subjacents són 1,703→214 (≈87%) i ~1,500→~270 (≈82%, el segon valor no es diu mai en veu alta). El «85% menys tokens» de 03:01:29 és la mateixa mesura arrodonida un altre cop.
- El nombre de crides a l'LLM per consulta durant la compressió 02:56:20 no es pot reconstruir a partir dels subtítols («1 2 3 4 cinc crides a embeddings i també a la generació»). L'afirmació anterior —una generació per fragment recuperat— s'ha extret de
LLMChainExtractor.compress_documents, no de l'àudio. - L'entorn d'avaluació de cinc consultes és una reconstrucció. Les consultes i les etiquetes de categoria es transcriuen de 02:06:04–02:10:05; el nom i la signatura exactes de la funció auxiliar
test_query, no, i el fitxer font és l'absentprod_hybrid_search.py. - La docstring d'
advanced_rag.pyanuncia «self-query» i l'instructor ho inclou a l'agenda del capítol 03:03:34, però no hi ha capSelfQueryRetrieverenlloc de cap dels dos repositoris i no es demostra mai. Aquesta part no ho cobreix, i el curs tampoc. - El fragment de connexió del reranker anterior es compon a partir d'API verificades (
CrossEncoderRerankeralangchain_classic,HuggingFaceCrossEncoderalangchain_community), no es copia del curs, isentence-transformers, queHuggingFaceCrossEncoderimporta en construir-se, no és a l'entorn amb versions fixades. - La constant RRF
c = 60no es diu mai oralment. Es llegeix directament delangchain_classic/retrievers/ensemble.py:70, és a dir, l'algoritme que l'instructor ha reimplementat a mà. - No existeix cap reranker al material d'origen. El fragment de
CrossEncoderRerankeranterior s'ha extret del paquetlangchain_classicinstal·lat, no del curs, i el curs no cita cap benchmark de reranking. La xifra de recuperació contextual d'Anthropic que el curs sí que cita —67% menys fallades de recuperació— s'atribueix al repositori a la recuperació contextual i pertany a la part 14, no aquí. - El nom del logger de multiconsulta del repositori (
langchain.retrievers.multi_query) no coincideix amb el logger real del mòdul (langchain_classic.retrievers.multi_query), verificat llegintmulti_query.pyi confirmant que el paquetlangchainamb versió fixada no té cap submòdulretrievers. - La consulta de citacions del repositori és
"What are the core components of LangChain?"; el vídeo diu «components comuns». Mateixa pregunta, paraula diferent.
On cedeix el pas aquesta part
- Pressupost de tokens: la segona meitat del mateix marcador de capítol 02:13:12–02:21:10 passa a
TokenBudget/BudgetedLLM. Compressió, multiconsulta i híbrid són precisament les funcionalitats que fan necessari un control previ de tokens. Part 9. - Cerca híbrida al costat de la base de dades. Tot el que hi ha aquí s'executa dins del procés. pgvector/Supabase pot fer la meitat de paraules clau dins de la base de dades amb un índex incremental i eliminar completament el problema de reconstruir BM25. Part 10.
- Recuperació contextual. Afegir context escrit per un LLM al principi de cada fragment en indexar és una tècnica diferent de la compressió contextual: no confonguis els noms. La frase de conclusions del mateix curs és «combina-ho amb cerca híbrida BM25 per obtenir els millors resultats» (
fcc-production-rag-part-6/02_contextual_retrieval.py:473), és a dir, totes dues es poden apilar. Part 14. - Balanç de costos pare-fill —la valoració de ★★★ en context / ★★☆ en emmagatzematge i 2× de magatzem vectorial— i l'alternativa de chunking tardà que intenta obtenir la mateixa qualitat de context sense la segona còpia. Part 14.
- Recuperació agèntica: avaluar el conjunt recuperat amb un avaluador LLM i tornar a consultar quan és dolent, que és al que recorres quan el reranking i la compressió encara no són suficients. Part 15.
- Preguntes de múltiples salts, on l'entitat que fa de pont no apareix mai a la consulta. Cap branca d'un recuperador híbrid no hi pot ajudar. Part 16.
La matriu de tècniques
| Tècnica | Resol | Fase | Cost afegit per consulta | Afegeix-la quan |
|---|---|---|---|---|
| Híbrid (BM25 + RRF) | Codis, identificadors, acrònims, noms exactes | Recuperació | ~20–50 ms, sense LLM | Ets en producció amb usuaris reals i el corpus té identificadors |
| Ajust de pesos | Predomina la branca equivocada | Fusió | Gratuït | Després de tenir dades de categories de consulta |
| Reranking (cross-encoder) | Document adequat recuperat, a la posició #7 | Reranking | 1 passada del model per candidat | L'exhaustivitat és bona, però precision@3 no |
| Document pare | Context fragmentat; embeddings diluïts | Recuperació | 1 lectura del magatzem de documents per resultat; 2× d'emmagatzematge | Els fragments són precisos, però les respostes fan referència als veïns |
| Compressió contextual | Farciment que desplaça el senyal | Compressió | 1 crida a l'LLM per fragment recuperat | Documents grans i barrejats i costos de tokens rellevants |
EmbeddingsFilter | El mateix, a baix cost | Compressió | 1 embedding de consulta + N embeddings de candidats, sense LLM | Vols el filtratge de la compressió sense la seva factura |
| Multiconsulta | Desajust de formulació | Consulta | 1 crida a l'LLM + N embeddings | Els usuaris pregunten el mateix de moltes maneres |
| Citacions | Respostes no verificables | Muntatge | ~0 | Sempre |
Decisions que cal prendre
- Necessites realment l'híbrid? La regla de la font és qualitativa: codis, identificadors, números de normes, tipus de consulta barrejats, precisió crítica. Fes-la quantitativa: pren una mostra de 200 consultes reals i compta quantes contenen un codi, un identificador, un acrònim, un nom propi o una expressió exacta entre cometes. Aquesta fracció és la taxa d'encert esperada per a la branca BM25 i és la xifra que després compararàs amb els logs d'atribució. (Un llindar d'activació de ~10% és una regla pràctica d'aquesta guia, no del curs; el que importa és haver mesurat la fracció.)
- BM25 dins del procés o cerca per paraules clau a la base de dades?
rank_bm25és en memòria, O(corpus) per consulta i només admet reconstrucció. És adequat fins a aproximadament desenes de milers de documents i inadequat més enllà. Decideix-ho ara, perquè migrar després implica redissenyar la ingesta. - Quin és el teu tokenitzador de BM25? El predeterminat és
str.split(). Si els identificadors porten puntuació —i en porten—, escriu unapreprocess_func, passa-la afrom_documents(no a la instància després) i fes-ne una prova unitària contra deu codis reals del corpus. - Quins són els dos valors de k? k per branca cap a la fusió (comença amb 10–20; el mínim del curs és 4 o superior) i k després de la fusió cap al prompt (3–5). Són xifres diferents i confondre-les és l'error d'ajust més habitual.
- On comencen els pesos?
[0.5, 0.5], escrit explícitament: ometreweightsdona silenciosament pesos uniformes, que sembla el mateix fins que algú afegeix un tercer recuperador. Mantén la llista de recuperadors i la de pesos en línies adjacents amb els percentatges en un comentari i modifica'ls només amb dades d'atribució. - Com reconstruiràs BM25? Per escriptura, per lots o amb doble búfer, i quina és la finestra de desactualització documentada per a la branca de paraules clau?
- Reranking o compressió? Resolen meitats diferents del problema del soroll. El reranking reordena (barat per candidat, sense canviar el text). La compressió redueix (cara, reescriu contingut, pot retornar zero documents). La majoria de sistemes volen primer un reranker i només afegeixen compressió si els fragments supervivents encara estan inflats.
- La demostració de compressió és honesta? Si el corpus de prova és net, la compressió semblarà espatllada. Construeix un document de l'estil d'
INFO_BURIEDamb farciment real abans de decidir que no fa res. - On es troba el pare?
InMemoryStoreés una demostració. Defineix el magatzem de documents durador i la claudoc_idabans d'indexar res, perquè els fills orfes són irrecuperables sense tornar a indexar. - Es conserva la pregunta literal de l'usuari? La multiconsulta amb
include_original=Falsevol dir que no. Decideix-ho deliberadament. - Com verifiques les citacions? Les citacions en prosa són generades pel model i no verificades. Retorna els objectes document juntament amb la resposta o fes servir sortida estructurada amb un camp
sources_usedque puguis comprovar contra el conjunt recuperat.
Llista de comprovació abans de donar la recuperació per «acabada»
Cada línia està escrita perquè se superi o no: cap no queda satisfeta amb una opinió.
- Existeix un entorn de proves
test_query(retriever, query, name), està versionat i passa la mateixa consulta per totes les variants de recuperador de costat. Executar-lo requereix una ordre. - Les consultes de prova estan anotades per categoria (codi de producte, codi d'error, semàntica, acrònim, consulta de configuració) i el corpus de prova és adversari: conté codis, identificadors i acrònims reals del teu domini, no vuit paràgrafs de prosa neta.
- La recuperació es mesura per separat de la generació: pots respondre «ha tornat el fragment adequat?» sense llegir una resposta.
- Hi ha una prova que crida
add_documents()amb un document que conté un token únic i després comprova amb una asserció que la branca BM25 sola el retorna. És la prova que detecta la degradació silenciosa de l'híbrid a vectorial. - La
preprocess_funcde BM25 es passa afrom_documents(...)en construir (mai no s'assigna a la instància) i té una prova unitària amb deu identificadors reals del corpus, incloent-ne un amb puntuació final i un altre amb majúscules/minúscules diferents. - Els
weightsdel conjunt s'escriuen explícitament a la línia sotaretrievers, en el mateix ordre, amb els percentatges en un comentari. Ningú no confia en el valor predeterminat silenciós1/n. id_keys'estableix en un identificador real de document si dos fragments del corpus poden compartir text; altrament has confirmat que la clau de deduplicaciópage_contentés segura i que cada document porta el campid_key(si en falta un, es llança unKeyErrora mitja fusió).- Els dos valors de k són diferents i estan escrits: k per branca cap a la fusió, k després de la fusió cap al prompt.
- L'atribució del recuperador (només BM25 / només vectorial / tots dos) és als logs estructurats (part 7), i algú ha llegit les xifres de la setmana passada i pot dir de memòria el percentatge de només BM25.
- Es fan servir camins asíncrons (
ainvoke) allà on s'executen dues recuperacions o N compressions; el camí síncron paga la suma en lloc del màxim. - Les variacions generades de multiconsulta es registren com a camps estructurats, no mitjançant un nom de logger copiat d'un tutorial que, a l'entorn amb versions fixades, configura un logger que no existeix.
- El camí de context buit està provat: la compressió que retorna zero documents ha de produir un rebuig, no una resposta al·lucinada.
- Els documents pare són en un magatzem de documents durador, no a
InMemoryStore, i hi ha una comprovació que cadadoc_idde fill indexat apunti a un pare. - Les metadades
sourcees conserven del carregador al fragment i al prompt (split_documents, nosplit_text), i les citacions fan servirpage_label, nopage. - Les fonts citades es validen contra el conjunt recuperat, retornant els objectes
Documentjuntament amb la resposta o comprovant amb una asserciósources_used ⊆ retrieved sourcessobre la sortida estructurada. - Tota millora de qualitat té un abans/després mesurat sobre el teu corpus. Totes les xifres d'aquesta part —~20–50 ms, 87%, 85%, 173 → 675 caràcters— són una demostració sobre un document, en una execució, feta per una persona. Cap no és la teva xifra fins que l'hagis mesurada.